Tarantool

Picodata: что это на самом деле, а не «Tarantool с кластером»

Picodata: что это на самом деле, а не «Tarantool с кластером»

Picodata выросла из форка Tarantool, но это самостоятельная СУБД: свой планировщик распределённых запросов, свой кластер-менеджер на Raft, PostgreSQL как основной протокол и расширение плагинами на Rust. Разбор устройства на живом кластере — репликасеты, бакеты, тиры — и что происходит с ответами на запросы, когда узлы выходят из строя
Нагрузочный стенд и карта выбора in-memory систем

Нагрузочный стенд и карта выбора in-memory систем

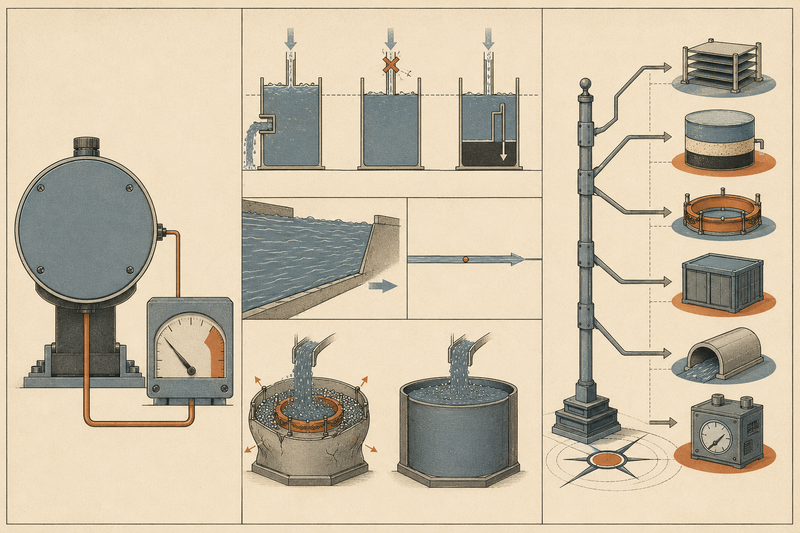
Финал серии: три сценария, которые переживают оверхед платформы, — рабочий набор за границей RAM (Redis против двух конфигураций Aerospike), цена выноса вычислений к данным (Tarantool против Ignite) и etcd под несвойственной нагрузкой. Почему абсолютной latency здесь нет и почему это делает выводы прочнее — и итоговая карта выбора «задача → система → способ ускорения»

Tarantool и Picodata: данные и вычисления рядом

Tarantool и Picodata: данные и вычисления рядом

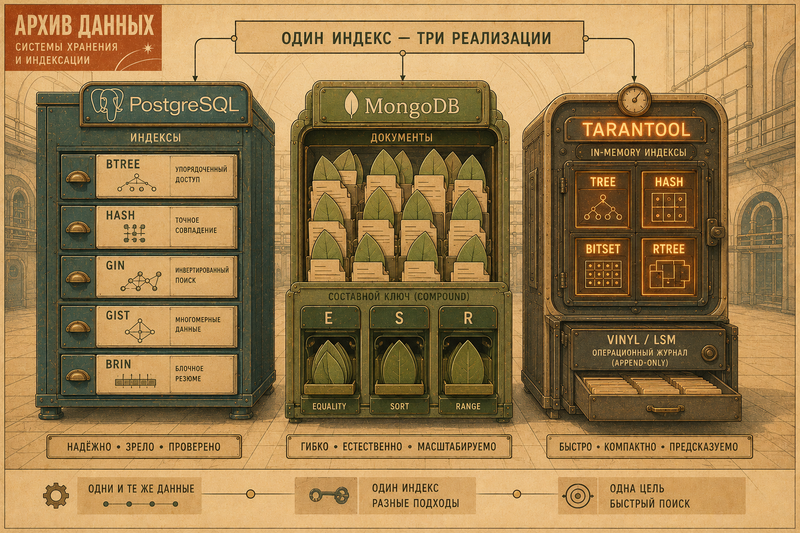
Tarantool как in-memory DB со встроенным Lua application server: stored procedures выполняются рядом с данными — перенос вычислений к данным, а не наоборот. Движки memtx и vinyl, persistence через WAL и snapshot. И Picodata — самостоятельная СУБД на форке того же ядра, где вычисления рядом с данными живут иначе: PostgreSQL-протокол снаружи, плагины на Rust внутри, метрики Prometheus и веб-интерфейс из коробки

Вычисления в оперативной памяти: зачем, какой ценой и таксономия систем

Вычисления в оперативной памяти: зачем, какой ценой и таксономия систем

С чего начинается in-memory computing: почему память ускоряет (иерархия памяти, latency RAM vs SSD vs сеть), главные трейдофы (durability, стоимость RAM, консистентность, объём) и карта шести систем по ролям — от кэша до координации