Sharding

Distributed SQL и NewSQL: CockroachDB, YugabyteDB, TiDB и OceanBase

Distributed SQL и NewSQL: CockroachDB, YugabyteDB, TiDB и OceanBase

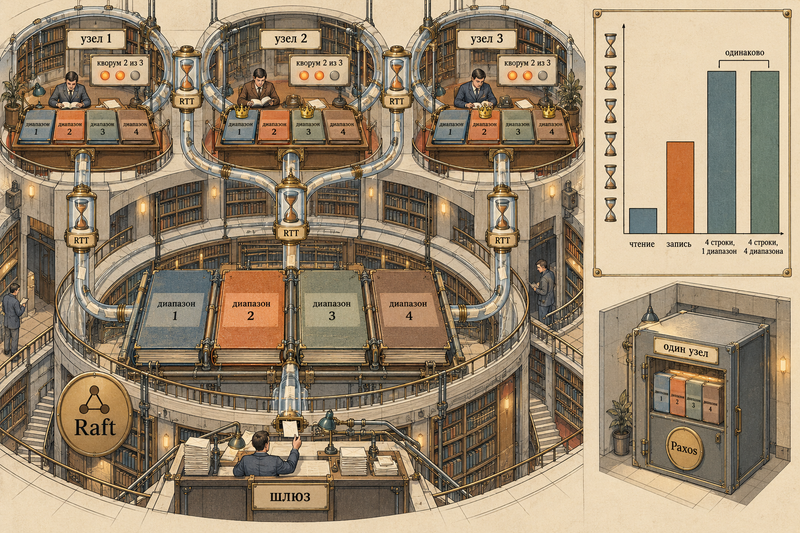
Зачем нужен distributed SQL — горизонтальный масштаб с сохранением SQL и ACID-транзакций, как под капотом работают шардинг и консенсус (Raft у трёх движков, Paxos у OceanBase), чем платим латентностью распределённых транзакций и когда это оправдано против одиночного PostgreSQL с репликами. Все числа сняты на одном стенде: четыре движка, одинаковые замеры, назначенная задержка между узлами

Шардирование на практике: цена распределённых данных

Шардирование на практике: цена распределённых данных

Разложить данные по узлам — самая простая часть. Дальше начинается счёт: запрос без ключа шардирования идёт во все шарды, join между по-разному распределёнными таблицами Citus по умолчанию вообще отказывается планировать, глубокая страница тащит с шардов сотни тысяч строк ради двадцати, а добавленный узел сам по себе не берёт на себя ни одного шарда. Всё — замерами на живом кластере Citus

Распределённый ClickHouse: шардирование, репликация, Keeper

Распределённый ClickHouse: шардирование, репликация, Keeper

Как ClickHouse масштабируется горизонтально: шардирование и репликация через ClickHouse Keeper, ReplicatedMergeTree и Distributed-таблицы, что ломается при падении узла — реплика недоступна против шард недоступен. Живой кластер 2 шарда × 2 реплики