Resilience

Планирование подов вглубь: taints, affinity, topology и приоритеты

Планирование подов вглубь: taints, affinity, topology и приоритеты

requests/limits говорят «сколько», но не «куда» — а раскладку подов по узлам определяют другие рычаги: taints/tolerations (узел отталкивает поды), node/pod affinity и anti-affinity (тянуть к или разводить), topology spread (равномерно по зонам), priority и preemption (кого выселить под важный под). Как управлять размещением осознанно и не собрать все реплики в одной стойке
Инциденты и постмортемы: как надёжность делают процессом

Инциденты и постмортемы: как надёжность делают процессом

Технические паттерны устойчивости не работают без процесса вокруг них: как устроен инцидент-менеджмент (роли, severity, коммуникация), почему постмортемы должны быть блеймлесс (иначе люди прячут причины), как из инцидента рождаются action items и runbooks, и как политика error budget превращает надёжность из лозунга в решения о релизах. SRE-сторона отказоустойчивости

Disaster Recovery: RTO/RPO, стратегия бэкапов и restore-тесты

Disaster Recovery: RTO/RPO, стратегия бэкапов и restore-тесты

Отказоустойчивость — это не только про «не упасть», но и про «восстановиться». RTO и RPO как язык договорённостей о потерях, стратегия бэкапов (3-2-1, полные/инкрементальные, PITR), почему бэкап без regular restore-теста — это не бэкап, мульти-регион failover (active-passive vs active-active), DR-runbook и учения. Дисциплина, которая проверяется только реальным восстановлением

Backpressure и load shedding: как система защищает себя

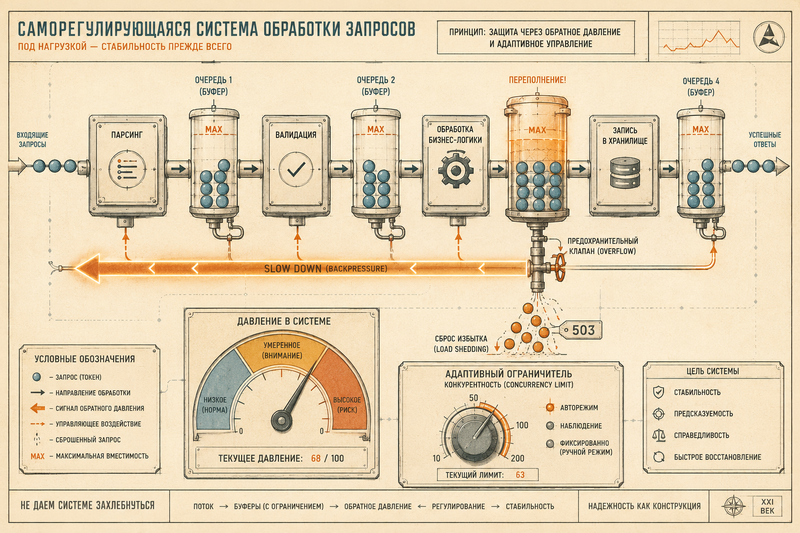
Backpressure и load shedding: как система защищает себя

Rate limiting ограничивает клиента, но что делать, когда система сама не тянет? Backpressure (распространить «притормози» вверх по цепочке через bounded queues) и load shedding (сознательно отбросить часть нагрузки, чтобы не упасть целиком) — механика самозащиты: почему неограниченные очереди убивают, adaptive concurrency, приоритезация и деградация, и чем это отличается от rate limiting и circuit breaker

Защита от перегрузки: карта

Защита от перегрузки: карта

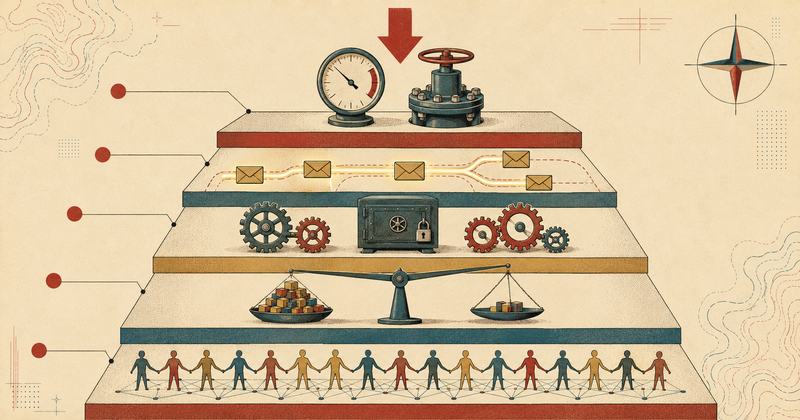
Перегрузка — это не одна проблема и не один механизм. Лимит частоты, backpressure, сброс нагрузки, предохранители, автоскейл и наблюдаемость решают разные части задачи и стоят на разных рубежах. Карта показывает, что за что отвечает, в каком порядке срабатывает и куда идти за деталями

Надёжность распределённых систем: карта

Надёжность распределённых систем: карта

Навигатор по надёжности распределённых систем: консенсус, согласованность, атомарность и транзакции, гарантии доставки сообщений и устойчивость под нагрузкой — как это связано и в каком порядке разбираться