Redis

Память и вытеснение: как Redis живёт под давлением памяти

Память и вытеснение: как Redis живёт под давлением памяти

Redis держит данные в оперативной памяти — значит, память рано или поздно закончится. Разбираем, что происходит на границе: как устроен аллокатор и откуда берётся фрагментация, какие есть политики вытеснения (LRU/LFU/по TTL/noeviction), что значит upper bound через maxmemory и что делает Redis при OOM. Плюс инструменты диагностики: MEMORY DOCTOR, INFO memory.

Репликация, Cluster и Sentinel: Redis как распределённая система

Репликация, Cluster и Sentinel: Redis как распределённая система

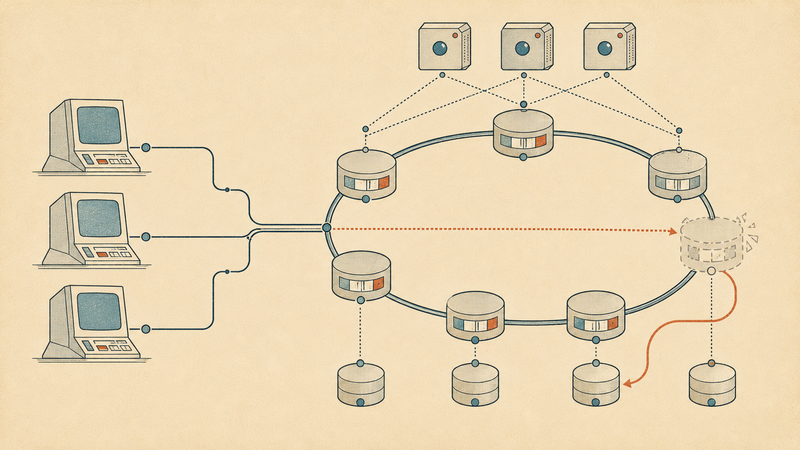
Один Redis — это одно ядро и один узел отказа. Разбираем, как из него собирают распределённую систему: асинхронная репликация, автоматический failover через Sentinel, шардирование по hash slots в Cluster. И честно про цену: асинхронность означает возможную потерю подтверждённых записей, split-brain реален, а Sentinel — не консенсус-протокол уровня Raft. Команда WAIT смещает границу, но не отменяет её.

Персистентность Redis: RDB, AOF и границы надёжности

Персистентность Redis: RDB, AOF и границы надёжности

Redis умеет переживать перезапуск — но насколько надёжно? Разбираем два механизма персистентности честно: RDB-снимки, AOF-журнал, гибридный режим и политики fsync. Главный вопрос статьи — что именно теряется при сбое и почему Redis по умолчанию ближе к кэшу, чем к источнику истины. Проводим границу durability явно, а не на ощущениях.

Один поток и событийный цикл: откуда у Redis скорость

Один поток и событийный цикл: откуда у Redis скорость

Redis обрабатывает команды в одном потоке — и при этом отдаёт сотни тысяч операций в секунду. Разбираем, почему single-threaded не значит медленно: событийный цикл, I/O-мультиплексирование, threaded I/O в новых версиях, пайплайнинг. И честно про обратную сторону: где один поток становится узким местом и откуда берётся хвостовая latency.

Redis вглубь: структуры данных и их внутренние кодировки

Redis вглубь: структуры данных и их внутренние кодировки

Redis — не «строковый кэш», а сервер структур данных. Разбираем strings/hashes/lists/sets/zsets/streams и то, что скрыто под ними: внутренние кодировки (listpack, intset, skiplist, quicklist) и правила переключения между компактным и «большим» представлением. Честно: когда какая структура уместна и во что она обходится по памяти и по времени.

Мульти-хранилищный стенд: один сценарий по всем БД и карта выбора

Мульти-хранилищный стенд: один сценарий по всем БД и карта выбора

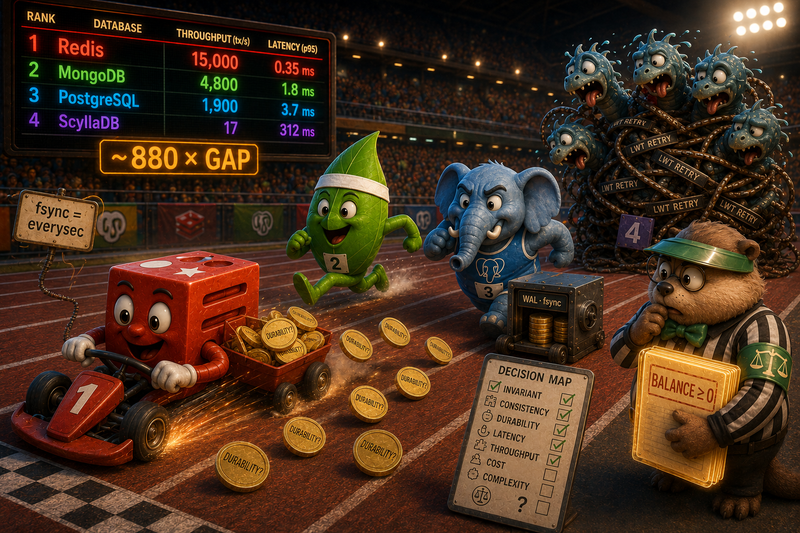
Финал серии: единый сценарий (списание с инвариантом «баланс не в минус») реализован поверх PostgreSQL, Redis, MongoDB и ScyllaDB и прогнан одним нагрузчиком. Что каждая система гарантирует из коробки, что ломается под конкуренцией, цена корректности — и итоговая карта выбора

KV и документные: «транзакций» почти нет — Redis, MongoDB, ScyllaDB

KV и документные: «транзакций» почти нет — Redis, MongoDB, ScyllaDB

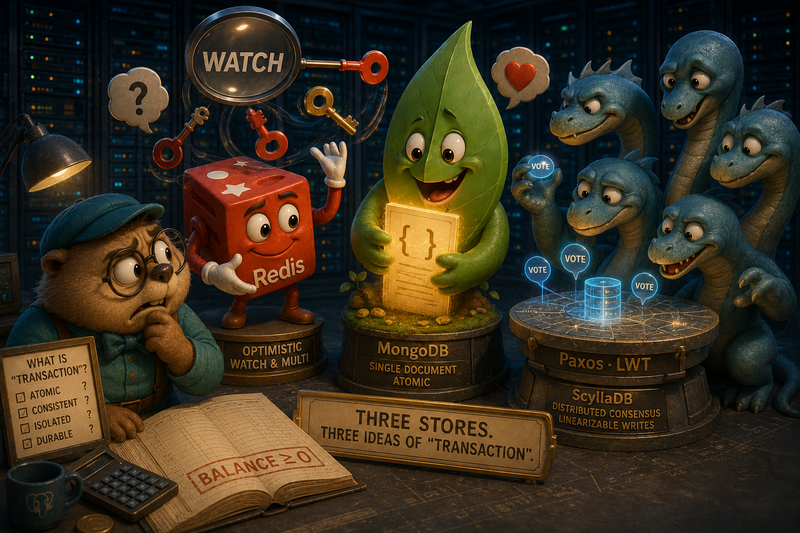
Что означает «транзакция» там, где нет классического ACID-движка: Redis MULTI/EXEC без rollback и WATCH-CAS, multi-document транзакции MongoDB поверх snapshot, LWT на Paxos в ScyllaDB и почему BATCH — это не транзакция. Примеры на Go и Java