Redis

Сложный путь: выделенный auth, JWT и refresh в Redis

Сложный путь: выделенный auth, JWT и refresh в Redis

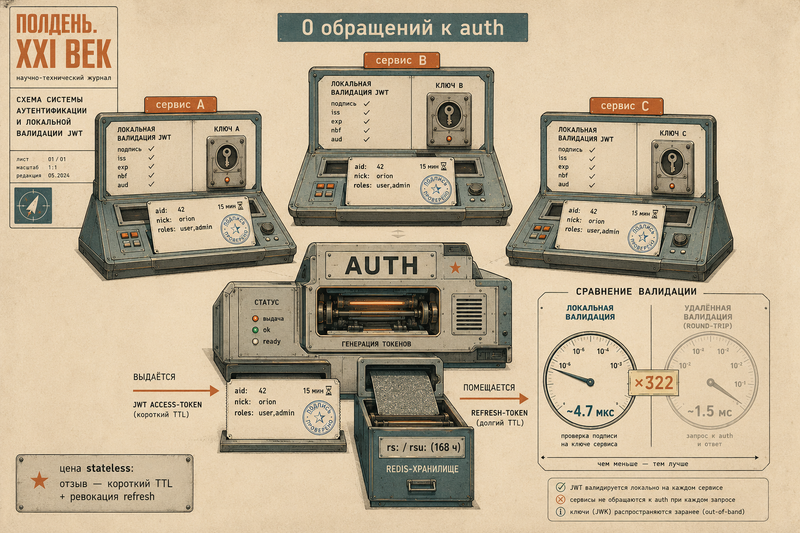
Авторизация для многих микросервисов без общей БД сессий в горячем пути: выделенный auth-сервис выпускает JWT access + opaque refresh, сервисы валидируют JWT локально общим middleware, refresh-сессии в Redis, роли в claims, глобальный logout — и честная цена stateless: отзыв только через короткий TTL access и ревокацию refresh
Модели сессий: opaque vs JWT, один сервис против многих

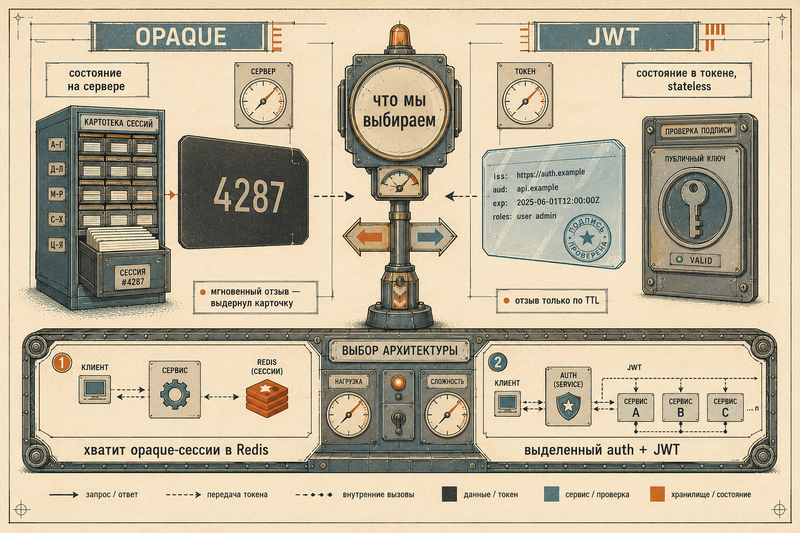
Модели сессий: opaque vs JWT, один сервис против многих

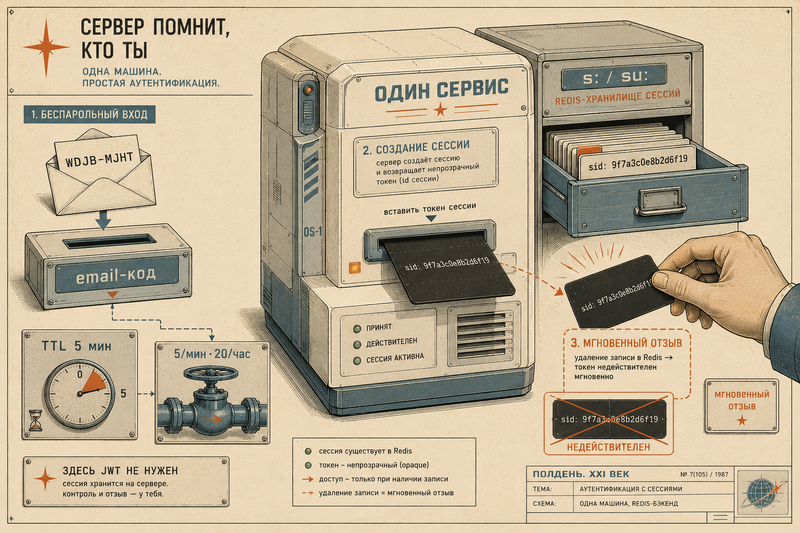
С чего начинается авторизация: серверные opaque-сессии против stateless JWT, stateful vs stateless, отзыв и ревокация, access и refresh, где хранить токены на клиенте — и когда достаточно сессии в Redis, а когда нужен выделенный auth

Нагрузочный стенд и карта выбора in-memory систем

Нагрузочный стенд и карта выбора in-memory систем

Финал серии: три сценария, которые переживают оверхед платформы, — рабочий набор за границей RAM (Redis против двух конфигураций Aerospike), цена выноса вычислений к данным (Tarantool против Ignite) и etcd под несвойственной нагрузкой. Почему абсолютной latency здесь нет и почему это делает выводы прочнее — и итоговая карта выбора «задача → система → способ ускорения»

Tarantool и Picodata: данные и вычисления рядом

Tarantool и Picodata: данные и вычисления рядом

Tarantool как in-memory DB со встроенным Lua application server: stored procedures выполняются рядом с данными — перенос вычислений к данным, а не наоборот. Движки memtx и vinyl, persistence через WAL и snapshot. И Picodata — самостоятельная СУБД на форке того же ядра, где вычисления рядом с данными живут иначе: PostgreSQL-протокол снаружи, плагины на Rust внутри, метрики Prometheus и веб-интерфейс из коробки

Redis: кэш и структуры данных в памяти как ускоритель

Redis: кэш и структуры данных в памяти как ускоритель

Redis под углом ускорения: паттерны кэширования (cache-aside, write-through, TTL, инвалидация, защита от cache stampede) и структуры данных под задачи (sorted set для leaderboard и rate-limit, HyperLogLog) — и честные трейдофы кэша. Внутреннее устройство Redis сюда намеренно не входит: оно разобрано в отдельной серии deep-dive

Вычисления в оперативной памяти: зачем, какой ценой и таксономия систем

Вычисления в оперативной памяти: зачем, какой ценой и таксономия систем

С чего начинается in-memory computing: почему память ускоряет (иерархия памяти, latency RAM vs SSD vs сеть), главные трейдофы (durability, стоимость RAM, консистентность, объём) и карта шести систем по ролям — от кэша до координации

Эксплуатация Redis и карта выбора: когда он, а когда нет

Эксплуатация Redis и карта выбора: когда он, а когда нет

Финал серии — про эксплуатацию Redis в бою и про трезвый выбор. Драйверы Go и Java и настройка пула соединений, что и как мониторить, типовые инциденты (latency-спайки, OOM, split-brain, шторм соединений) и их разбор. И главное — карта решений: когда Redis это правильный инструмент, а когда честнее взять полноценную БД, брокер или другое хранилище.

Streams, Lua и функции: программируемость Redis

Streams, Lua и функции: программируемость Redis

Redis умеет не только хранить, но и выполнять логику на сервере. Разбираем три способа программируемости: Streams с consumer groups (журнал сообщений с подтверждениями), Lua-скрипты и Redis Functions (атомарные серверные процедуры), плюс обзор модулей. Честно проводим границу Streams vs Kafka — где Redis Streams достаточно, а где нужна полноценная брокерная платформа.

Память и вытеснение: как Redis живёт под давлением памяти

Память и вытеснение: как Redis живёт под давлением памяти

Redis держит данные в оперативной памяти — значит, память рано или поздно закончится. Разбираем, что происходит на границе: как устроен аллокатор и откуда берётся фрагментация, какие есть политики вытеснения (LRU/LFU/по TTL/noeviction), что значит upper bound через maxmemory и что делает Redis при OOM. Плюс инструменты диагностики: MEMORY DOCTOR, INFO memory.