

Надёжная работа с PostgreSQL из Go, Java и Rust: пулы, реплики, reconnect
Надёжность работы с PostgreSQL из приложения: пулы соединений, timeout, reconnect, чтение с реплик, failover, pgbouncer и аналоги — на Go, Java и Rust
Надёжность работы с PostgreSQL из приложения: пулы соединений, timeout, reconnect, чтение с реплик, failover, pgbouncer и аналоги — на Go, Java и Rust

Слои доступа к данным на JVM: сырой JDBC, ORM (JPA/Hibernate), типобезопасный SQL (jOOQ), Spring Data и Kotlin Exposed — что выбрать под задачу и где ORM создаёт больше проблем, чем решает
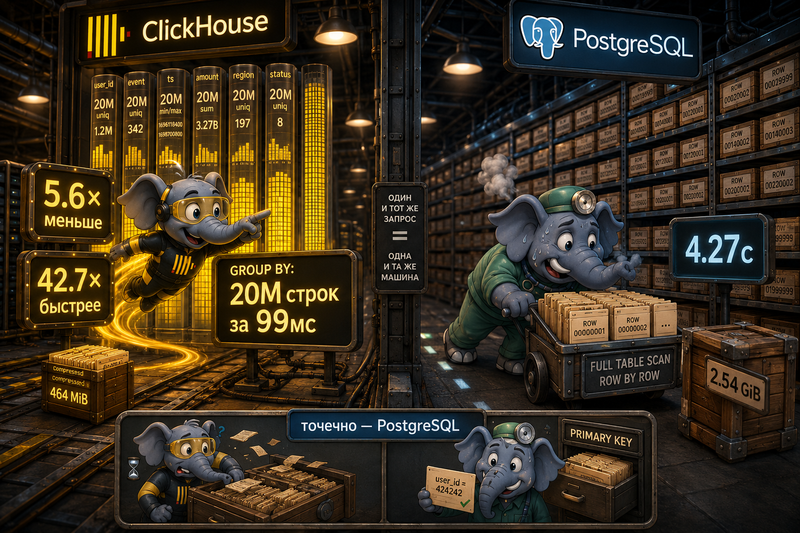
Чем OLAP-нагрузка отличается от OLTP, как колоночное хранение и векторное исполнение делают ClickHouse быстрым на аналитике, в какой момент PostgreSQL перестаёт тянуть агрегаты по большим таблицам — и где ClickHouse категорически не подходит
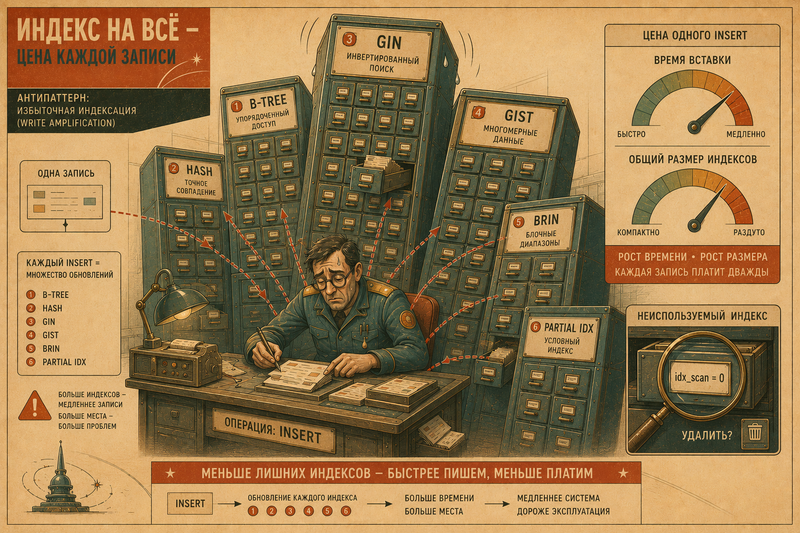
Что делать и чего избегать с индексами: over-indexing и write-amplification, неиспользуемые и дублирующие индексы, bloat и обслуживание, covering под горячие запросы, online-создание без блокировок, индексы под пагинацию — и антипаттерн «индекс на всё»
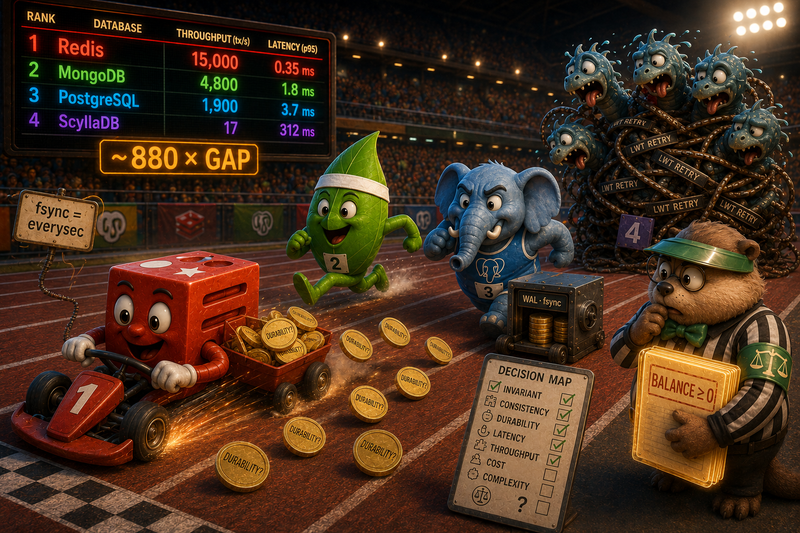
Финал серии: единый сценарий (списание с инвариантом «баланс не в минус») реализован поверх PostgreSQL, Redis, MongoDB и ScyllaDB и прогнан одним нагрузчиком. Что каждая система гарантирует из коробки, что ломается под конкуренцией, цена корректности — и итоговая карта выбора
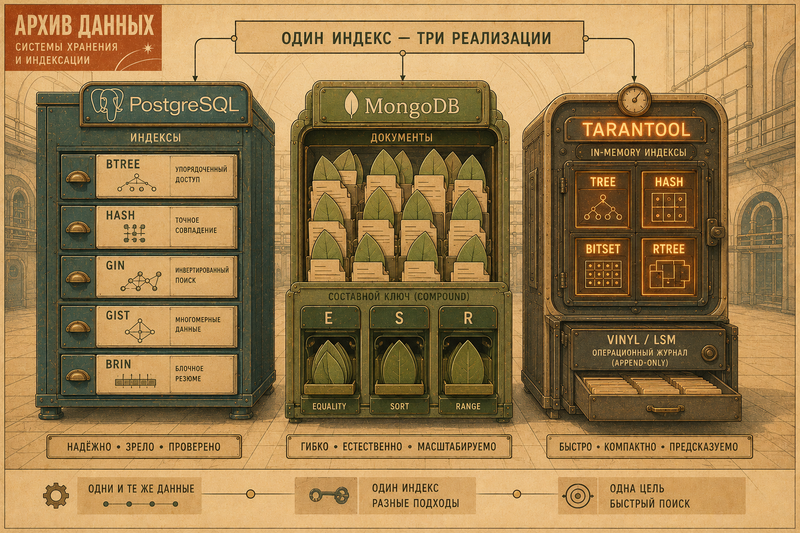
Один принцип, разные реализации: индексы в PostgreSQL (btree/GiN/GiST/BRIN, CONCURRENTLY, partial/expression), MongoDB (compound/multikey/text/2dsphere/TTL/partial/wildcard, правило ESR) и Tarantool (memtx TREE/HASH/BITSET/RTREE и vinyl LSM)
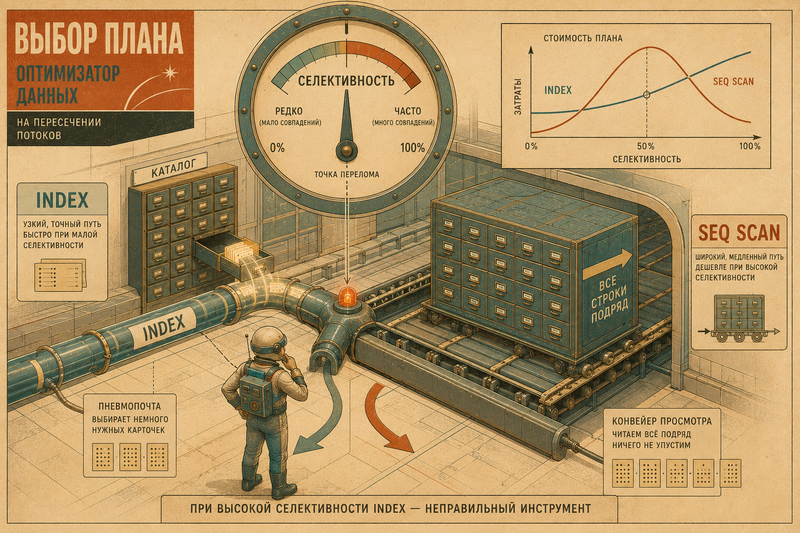
Практика индексов: селективность и кардинальность, покрывающие индексы и index-only scan, составные индексы и порядок колонок, частичные и функциональные, и главное — почему индекс НЕ используется и как это увидеть
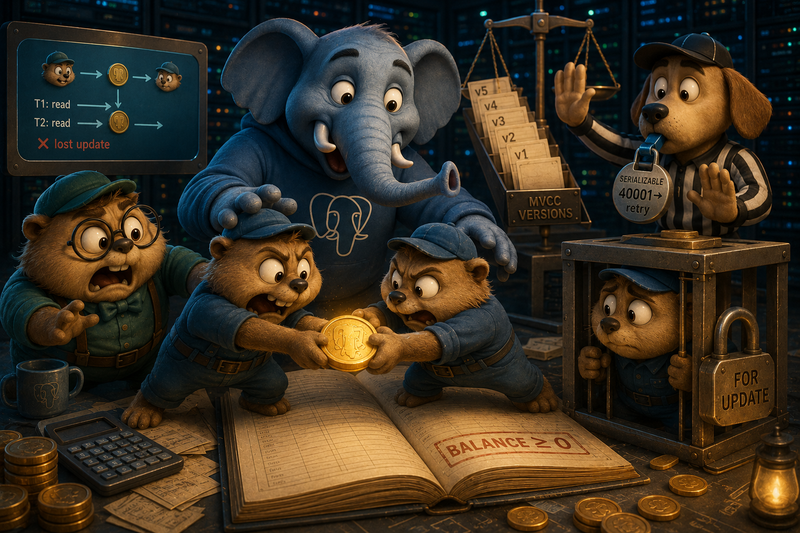
PostgreSQL как эталон управляемой изоляции: уровни в деле, SELECT FOR UPDATE, SERIALIZABLE с retry на 40001, advisory locks. Примеры на Go (pgx) и Java (JDBC) плюс нагрузочный стенд, воспроизводящий lost update и write skew под конкуренцией
Два подхода к работе с SQL в Go без ORM на одном домене: sqlc генерирует типизированный код из SQL, а SQL-builders (squirrel, goqu) конструируют запросы программно. Где каждый силён, где кусается и как их комбинировать
ORM в Go: где такой подход оправдан, чем GORM отличается от EF/Hibernate, когда практичнее SQL-first go-jet, и какие есть альтернативы (sqlc, ent, bun)