
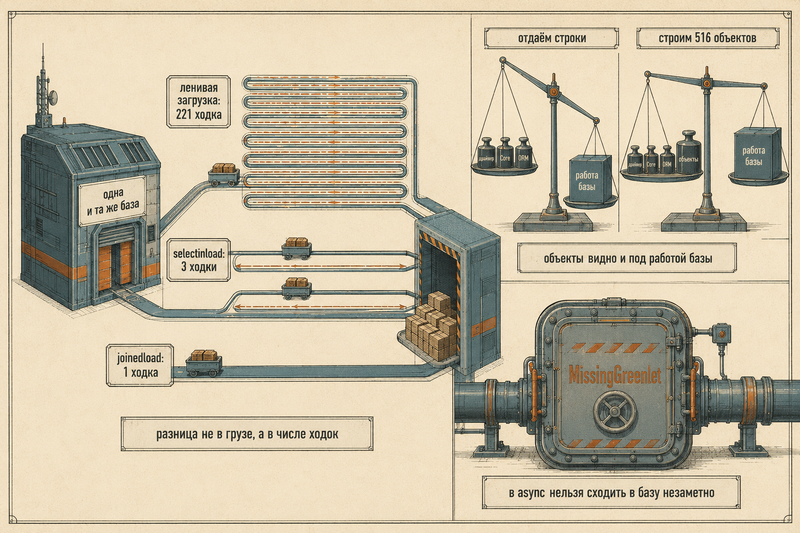
Данные в Python: SQLAlchemy 2.0, asyncpg и миграции через Alembic
Доступ к БД из Python: SQLAlchemy 2.0 (ORM и Core), асинхронный драйвер asyncpg, миграции через Alembic и границы, где ORM создаёт больше проблем, чем решает
Доступ к БД из Python: SQLAlchemy 2.0 (ORM и Core), асинхронный драйвер asyncpg, миграции через Alembic и границы, где ORM создаёт больше проблем, чем решает
Stateful-нагрузки ломают привычную модель «под — расходник». StatefulSet, стабильная идентичность, headless-сервис, PV/PVC/StorageClass и dynamic provisioning — и честный разговор о том, когда БД в кластере оправдана, а когда это боль на ровном месте.
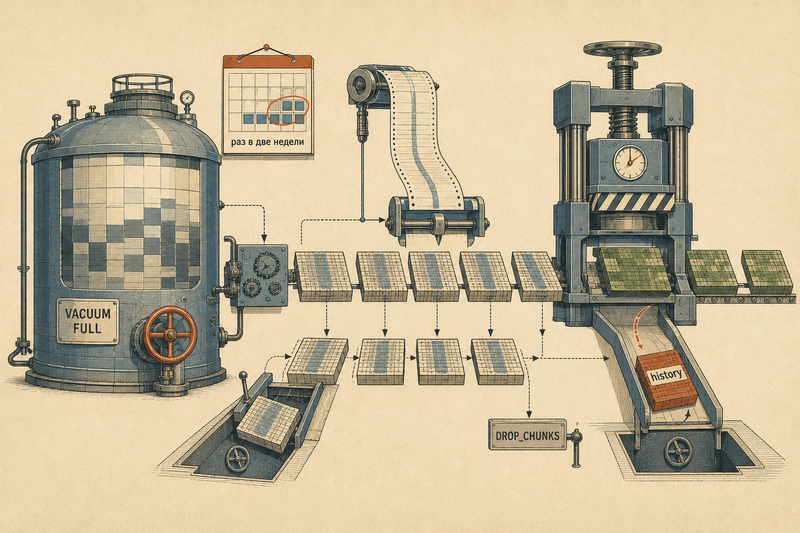
История с прода: мониторинговая БД Zabbix распухала так, что VACUUM FULL приходилось гонять раз в две недели. Перевод history/trends на гипертаблицы TimescaleDB меняет саму модель удаления — построчный DELETE становится drop_chunks, — а нативная компрессия отдаёт место. Плюс неочевидная ловушка: когда порог сжатия совпадает с окном ретеншна, самая большая таблица не сжимается никогда.
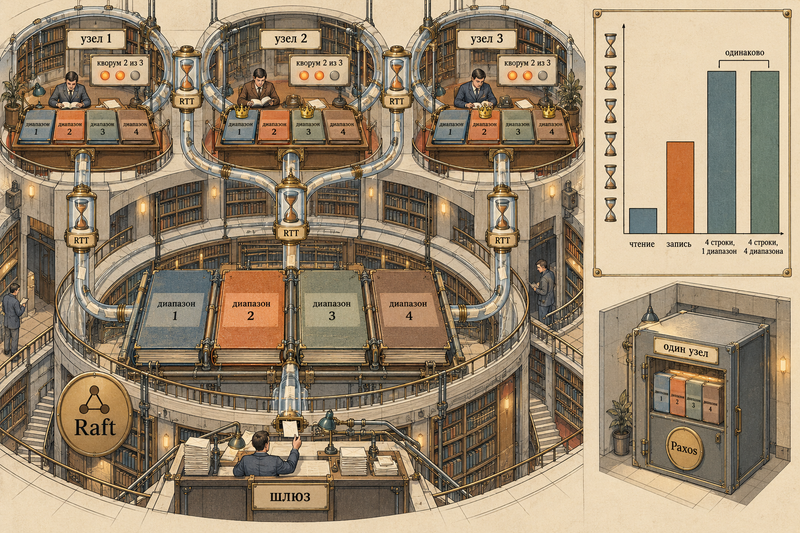
Зачем нужен distributed SQL — горизонтальный масштаб с сохранением SQL и ACID-транзакций, как под капотом работают шардинг и консенсус (Raft у трёх движков, Paxos у OceanBase), чем платим латентностью распределённых транзакций и когда это оправдано против одиночного PostgreSQL с репликами. Все числа сняты на одном стенде: четыре движка, одинаковые замеры, назначенная задержка между узлами
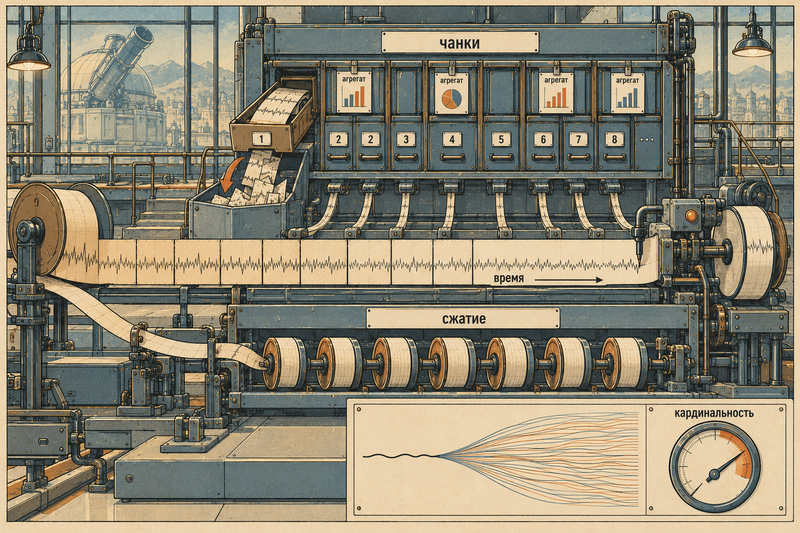
Две школы хранения временных рядов — PostgreSQL с гипертаблицами TimescaleDB и метрические движки Prometheus и VictoriaMetrics — на одном стенде: как continuous aggregate отстаёт от свежих и опоздавших данных и стирает историю после ретеншна, во что обходятся точка и ряд в каждой системе и почему increase() в Prometheus и VictoriaMetrics отвечает по-разному
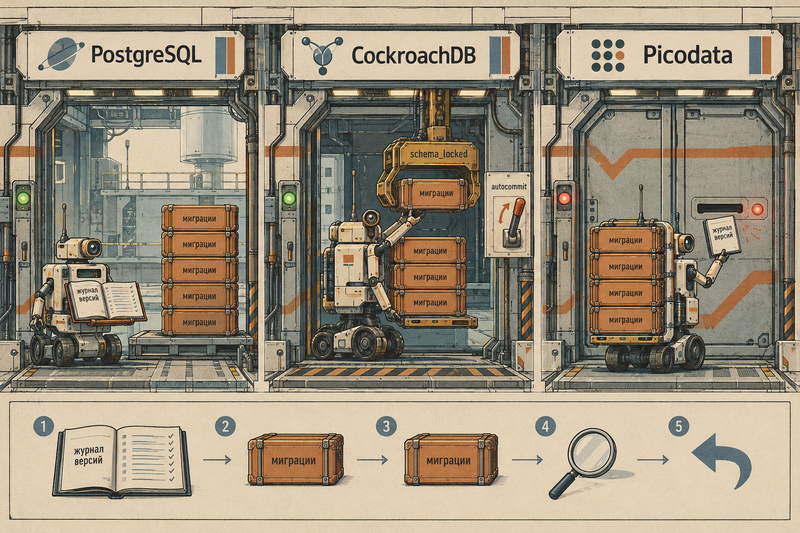
Мигратор — не «скрипты по порядку», а программа со своими требованиями к СУБД: журнал версий, транзакционный DDL, интроспекция каталогов. Живая матрица пяти инструментов (goose, Flyway, Liquibase, Atlas, Alembic) против PostgreSQL, CockroachDB и Picodata: на Picodata ни один не дошёл до первой миграции, на CockroachDB два споткнулись о собственную служебную часть. Плюс декларативный против императивного, привязка к формату и что на самом деле стоит денег в бесплатных редакциях
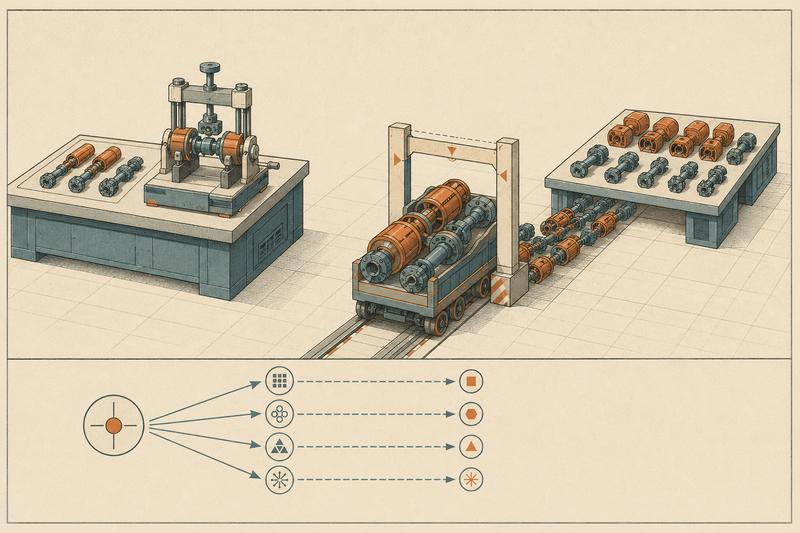
Как Picodata исполняет SQL на кластере: план, адресация к бакетам, двухфазная агрегация и motion — перенос данных между узлами. Почему соединение по ключу шардирования обходится без переноса, а обычное на объёме просто не выполняется, и откуда берутся два лимита, в которые упирается всё
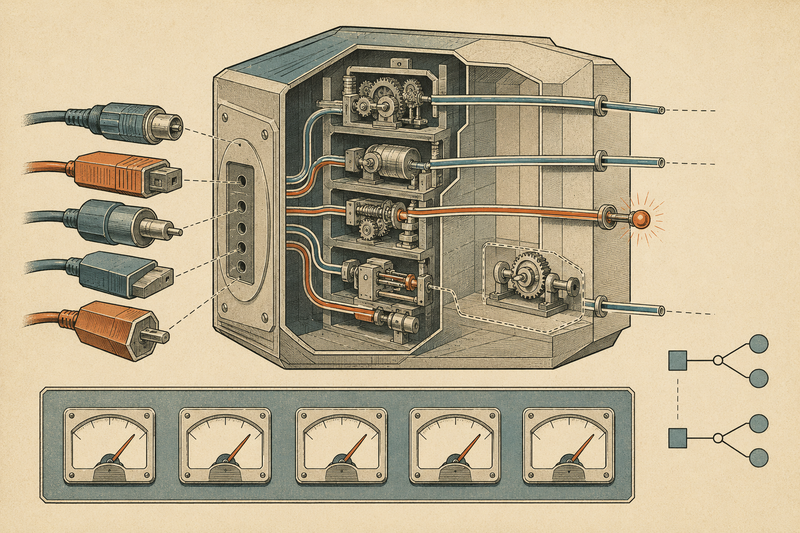
PostgreSQL-протокол — основной способ работы с Picodata: psql, pgx и psycopg подключаются к ней тем же кодом, что к PostgreSQL. Но совместимость частичная, и граница проходит не там, где ожидаешь. Живая матрица пяти клиентов против 59 SQL-конструкций, поведение pg_dump и мигратора, и почему у Picodata собственный JDBC-драйвер
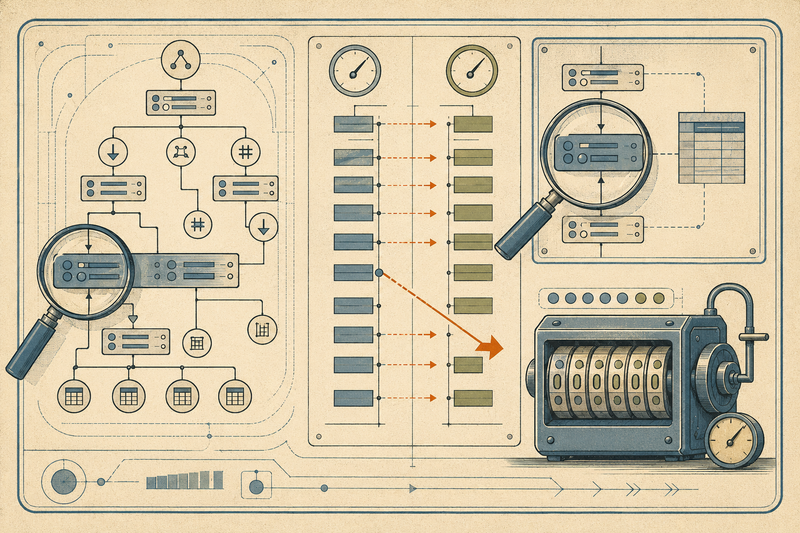
Чтение EXPLAIN (ANALYZE, BUFFERS) на практике: seq scan против index и bitmap scan, типы индексов (btree/GiN/GiST/BRIN), статистика и планировщик, частые антипаттерны (функции по колонке, OR, N+1) и поиск тяжёлых запросов через pg_stat_statements
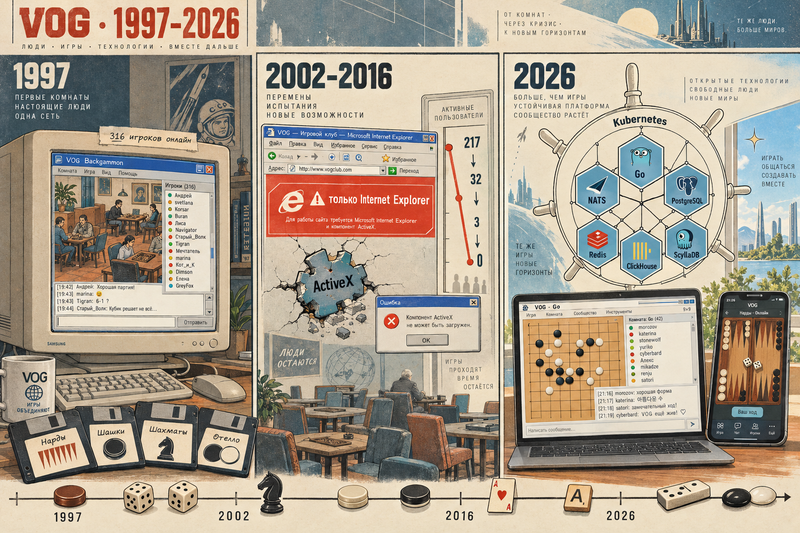
Закулисье vogclub.com от разработчика, который работал над ним в 1999–2003 годах и в 2021-м забрал проект за шаг до закрытия: отдельные Windows-программы на vog.ru, оболочка VOG Shell, ставка на ActiveX, долгая пауза и перезапуск 2026 года на Go и Kubernetes с веб-клиентом. Первая статья серии о технологиях VOG