Operations

Keycloak в production: HA, БД, бэкапы, обновления

Keycloak в production: HA, БД, бэкапы, обновления

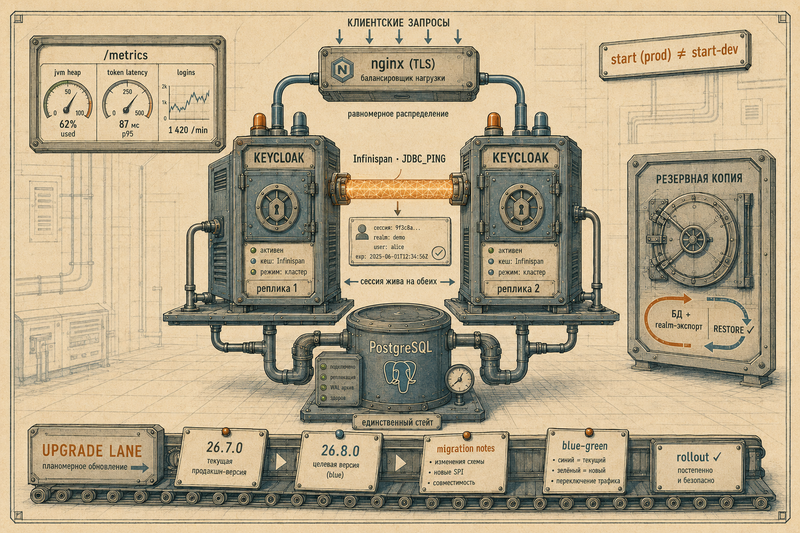
Заключительная статья серии — та самая ops-цена готового IdP в деталях, на отдельном production-стенде (docker-compose.prod.yml, Keycloak 26.7.0). Почему start-dev нельзя в прод и что требует production start; оптимизированный образ через kc.sh build + start –optimized; внешний PostgreSQL как единственный стейт (данные realm + таблица JDBC_PING); HA из двух реплик за nginx-LB — Infinispan-кластер с discovery через JDBC_PING (реальный лог 2-member ISPN view, mTLS JGroups) и распределённой сессией (login на реплике-1 → refresh + userinfo на реплике-2 = HTTP 200); TLS-offload против re-encrypt (реальная тонкость с alert 47); наблюдаемость — /metrics на management-порту 9000 (реальный срез: jvm heap, vendor_statistics кэшей сессий, http_server_requests), тонкость KC_HTTP_MANAGEMENT_SCHEME=http; тюнинг пула БД/кэшей/JVM; обновления мажоров (пиновка, migration notes, тест realm-экспорта, blue-green); бэкапы и DR (единственный стейт — БД + realm-as-code).

Эксплуатация Redis и карта выбора: когда он, а когда нет

Эксплуатация Redis и карта выбора: когда он, а когда нет

Финал серии — про эксплуатацию Redis в бою и про трезвый выбор. Драйверы Go и Java и настройка пула соединений, что и как мониторить, типовые инциденты (latency-спайки, OOM, split-brain, шторм соединений) и их разбор. И главное — карта решений: когда Redis это правильный инструмент, а когда честнее взять полноценную БД, брокер или другое хранилище.

Память и вытеснение: как Redis живёт под давлением памяти

Память и вытеснение: как Redis живёт под давлением памяти

Redis держит данные в оперативной памяти — значит, память рано или поздно закончится. Разбираем, что происходит на границе: как устроен аллокатор и откуда берётся фрагментация, какие есть политики вытеснения (LRU/LFU/по TTL/noeviction), что значит upper bound через maxmemory и что делает Redis при OOM. Плюс инструменты диагностики: MEMORY DOCTOR, INFO memory.

Flink SQL, коннекторы и эксплуатация: от Table API до прода

Flink SQL, коннекторы и эксплуатация: от Table API до прода

Писать Flink-джобы на низкоуровневом API нужно не всегда: Table API и Flink SQL закрывают большую часть задач декларативно, включая стриминговые джойны и агрегации. Плюс то, без чего не выйти в прод: коннекторы (Kafka, CDC, lakehouse), управление параллелизмом, диагностика backpressure, тюнинг чекпоинтов и апгрейд джобы через savepoint без потери состояния. Завершает погружение практикой эксплуатации

Эксплуатация и тюнинг ClickHouse: merges, mutations, мониторинг, backup

Эксплуатация и тюнинг ClickHouse: merges, mutations, мониторинг, backup

Что нужно знать про ClickHouse в проде: parts и фоновые merges, почему mutations (ALTER UPDATE/DELETE) дорогие и асинхронные, мониторинг через system.*-таблицы, backup/restore и тюнинг — codec-сжатие колонок, гранулярность индекса, память запроса. С живыми числами и продакшн-чеклистом