Compression

TimescaleDB под Zabbix: как перестать вручную бороться с bloat

TimescaleDB под Zabbix: как перестать вручную бороться с bloat

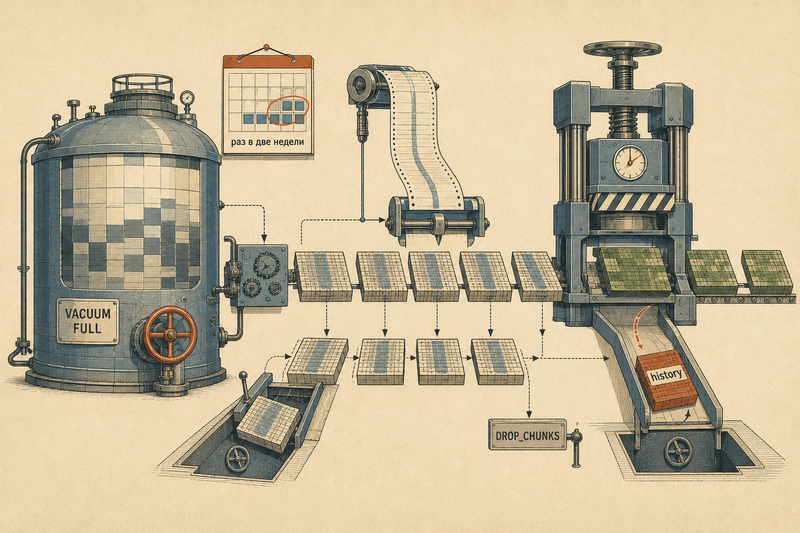
История с прода: мониторинговая БД Zabbix распухала так, что VACUUM FULL приходилось гонять раз в две недели. Перевод history/trends на гипертаблицы TimescaleDB меняет саму модель удаления — построчный DELETE становится drop_chunks, — а нативная компрессия отдаёт место. Плюс неочевидная ловушка: когда порог сжатия совпадает с окном ретеншна, самая большая таблица не сжимается никогда.
Time-series БД: TimescaleDB и VictoriaMetrics

Time-series БД: TimescaleDB и VictoriaMetrics

Две школы хранения временных рядов — PostgreSQL с гипертаблицами TimescaleDB и метрические движки Prometheus и VictoriaMetrics — на одном стенде: как continuous aggregate отстаёт от свежих и опоздавших данных и стирает историю после ретеншна, во что обходятся точка и ряд в каждой системе и почему increase() в Prometheus и VictoriaMetrics отвечает по-разному

Сжатие данных: zstd, lz4, gzip и компромисс CPU ↔ размер

Сжатие данных: zstd, lz4, gzip и компромисс CPU ↔ размер

Матрица zstd/lz4/gzip/brotli по уровням на одном корпусе и три режима выбора, проверенных живым стендом: порог окупаемости на транспорте, точка амортизации по числу перечитываний и поведение разжатия на read-heavy пути. С картой решения и разбором того, что не воспроизвелось