Caching

«Доступна новая версия сайта»: как вкладка узнаёт о выкладке и почему не перезагружается сама

«Доступна новая версия сайта»: как вкладка узнаёт о выкладке и почему не перезагружается сама

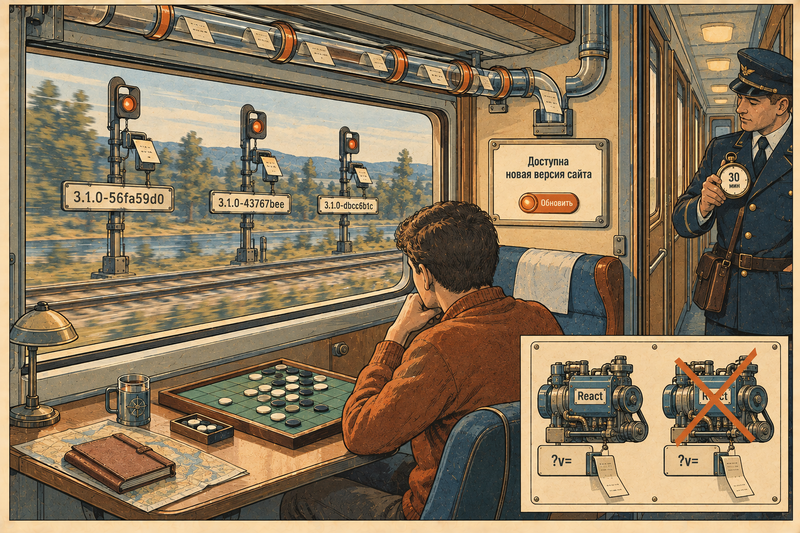
Сайт VOG перестал перезагружать страницу при переходах, и вкладка стала жить часами на коде, загруженном до выкладки. Как вкладка узнаёт о новой сборке почти без лишней нагрузки на сервер — из заголовков обычных ответов и редкого опроса, — почему обновление предлагается кнопкой, а не делается само, и как одна строка ?v= дала на странице две копии React
Нагрузочный стенд и карта выбора in-memory систем

Нагрузочный стенд и карта выбора in-memory систем

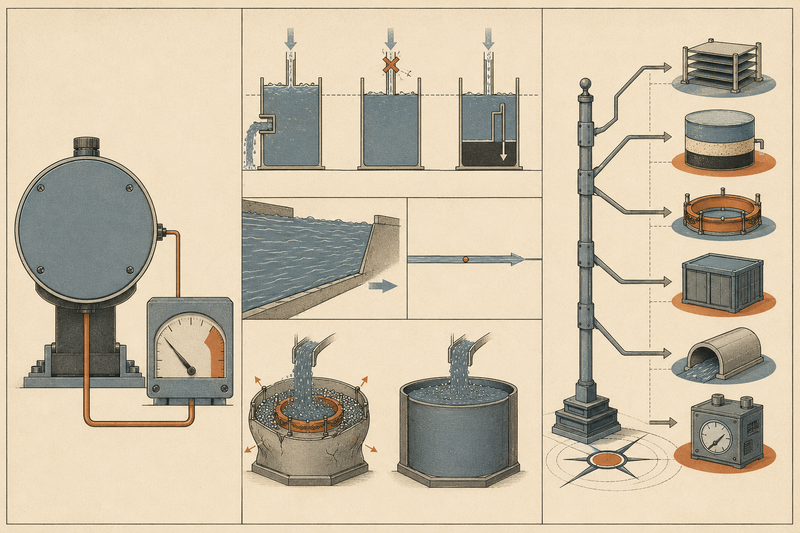
Финал серии: три сценария, которые переживают оверхед платформы, — рабочий набор за границей RAM (Redis против двух конфигураций Aerospike), цена выноса вычислений к данным (Tarantool против Ignite) и etcd под несвойственной нагрузкой. Почему абсолютной latency здесь нет и почему это делает выводы прочнее — и итоговая карта выбора «задача → система → способ ускорения»

etcd: координация ≠ ускорение

etcd: координация ≠ ускорение

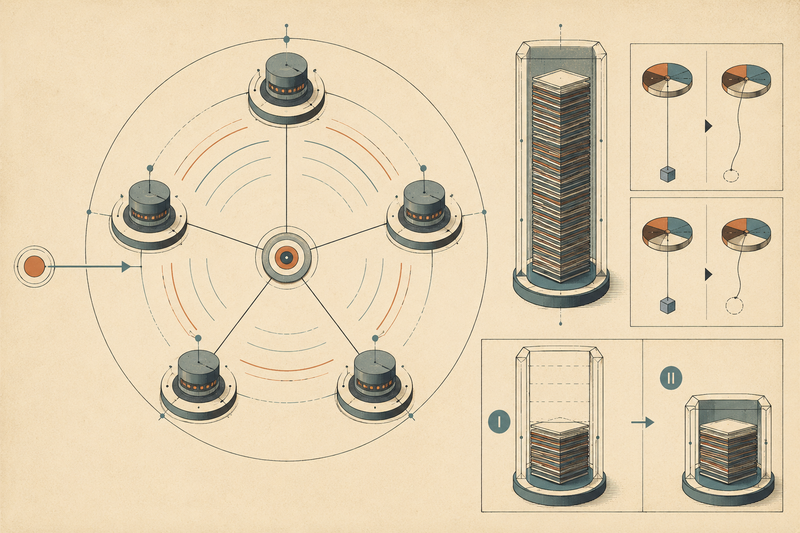
Не всё в памяти — про скорость: физические данные etcd лежат на диске (persistent B+tree), в памяти — только вторичный индекс путей к ним; согласованность обеспечивает Raft, а не резидентность данных. Raft, линеаризуемые чтения, MVCC-ревизии, watch и leases — и честный разбор того, почему etcd в этой серии не шестая in-memory система, а граница таксономии, и что ломается при использовании не по назначению

Aerospike и Apache Ignite: масштаб и грид

Aerospike и Apache Ignite: масштаб и грид

Две системы для масштаба: Aerospike с гибридной архитектурой памяти (индекс в DRAM по умолчанию, данные в RAM или на flash) — и живая цена индекса в байтах; и Apache Ignite как in-memory data grid + compute grid, где вычисление едет к данным через affinity colocation, а экономия сети измеряется в объектах

Tarantool и Picodata: данные и вычисления рядом

Tarantool и Picodata: данные и вычисления рядом

Tarantool как in-memory DB со встроенным Lua application server: stored procedures выполняются рядом с данными — перенос вычислений к данным, а не наоборот. Движки memtx и vinyl, persistence через WAL и snapshot. И Picodata — самостоятельная СУБД на форке того же ядра, где вычисления рядом с данными живут иначе: PostgreSQL-протокол снаружи, плагины на Rust внутри, метрики Prometheus и веб-интерфейс из коробки

Redis: кэш и структуры данных в памяти как ускоритель

Redis: кэш и структуры данных в памяти как ускоритель

Redis под углом ускорения: паттерны кэширования (cache-aside, write-through, TTL, инвалидация, защита от cache stampede) и структуры данных под задачи (sorted set для leaderboard и rate-limit, HyperLogLog) — и честные трейдофы кэша. Внутреннее устройство Redis сюда намеренно не входит: оно разобрано в отдельной серии deep-dive

Вычисления в оперативной памяти: зачем, какой ценой и таксономия систем

Вычисления в оперативной памяти: зачем, какой ценой и таксономия систем

С чего начинается in-memory computing: почему память ускоряет (иерархия памяти, latency RAM vs SSD vs сеть), главные трейдофы (durability, стоимость RAM, консистентность, объём) и карта шести систем по ролям — от кэша до координации

Память и вытеснение: как Redis живёт под давлением памяти

Память и вытеснение: как Redis живёт под давлением памяти

Redis держит данные в оперативной памяти — значит, память рано или поздно закончится. Разбираем, что происходит на границе: как устроен аллокатор и откуда берётся фрагментация, какие есть политики вытеснения (LRU/LFU/по TTL/noeviction), что значит upper bound через maxmemory и что делает Redis при OOM. Плюс инструменты диагностики: MEMORY DOCTOR, INFO memory.