Background-Jobs

Temporal в эксплуатации: тюнинг воркеров, наблюдаемость, тестирование, Cloud

Temporal в эксплуатации: тюнинг воркеров, наблюдаемость, тестирование, Cloud

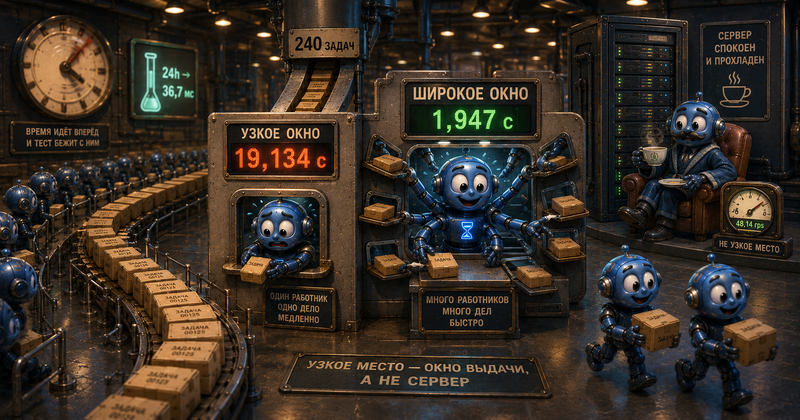
Запустить Temporal легко, эксплуатировать — отдельная работа. Разбираем тюнинг воркеров (ёмкость, pollers, sticky cache) с замером, где расширение воркера сокращает ожидание задач почти в десять раз при неизменном сервере; наблюдаемость и два семейства метрик с похожими именами, которые нельзя путать; тестирование с промоткой времени — Sleep(24h) проходит за десятки миллисекунд; и выбор Cloud vs self-host с честной оценкой стоимости. Это статья про то, что отличает пилот от прода
Версионирование workflow: patching, worker versioning, безопасные изменения

Версионирование workflow: patching, worker versioning, безопасные изменения

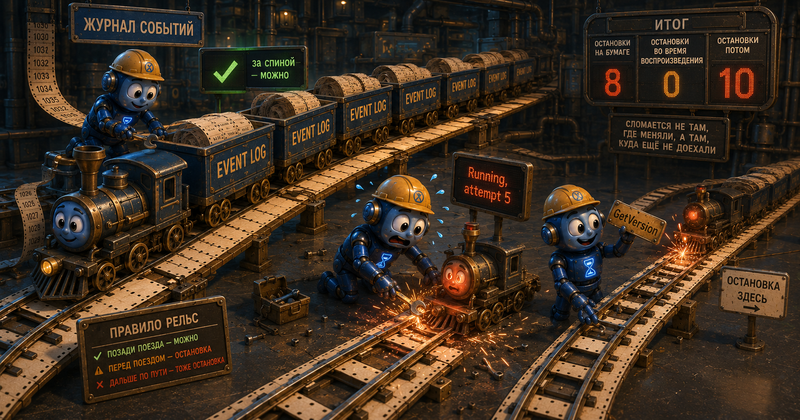
Самая недооценённая дисциплина Temporal: нельзя просто поменять код workflow, у которого есть запущенные экземпляры — при replay новой логики на старой истории рантайм упрётся в non-determinism error. Разбираем, почему так, где именно проходит граница ломающего изменения (она не там, где кажется), как чинит patching/GetVersion и почему преждевременное снятие патча ломает всё заново. Плюс worker versioning с build IDs и то, как встроить версионирование в деплой до первого инцидента, а не после

Signals, Queries, Updates и child workflows: связь с внешним миром

Signals, Queries, Updates и child workflows: связь с внешним миром

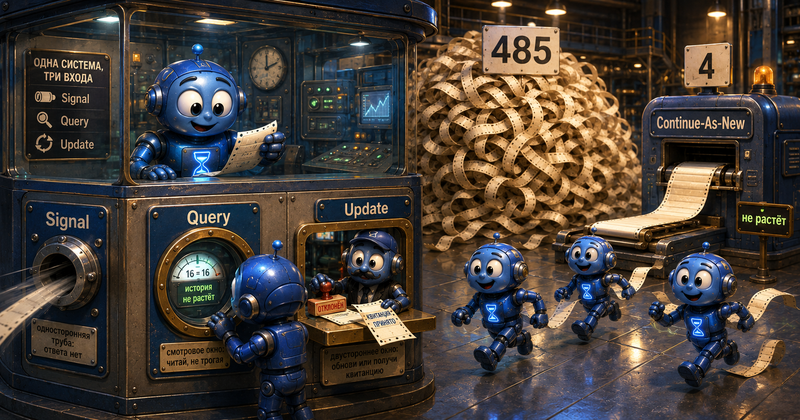
Workflow не живёт в вакууме: снаружи в него шлют события (Signal), читают его состояние (Query), выполняют валидируемые мутации (Update), а сам он декомпозируется на дочерние (child workflows). Разбираем каждый механизм: Signal как асинхронное входящее событие и «человек в цикле», Query как чтение без изменения истории, Update как синхронная валидируемая команда, child workflows для декомпозиции и независимого версионирования, и Continue-As-New как способ жить с ограничением размера истории в долгих и циклических процессах

Activities вглубь: таймауты, ретраи, heartbeat, идемпотентность

Activities вглубь: таймауты, ретраи, heartbeat, идемпотентность

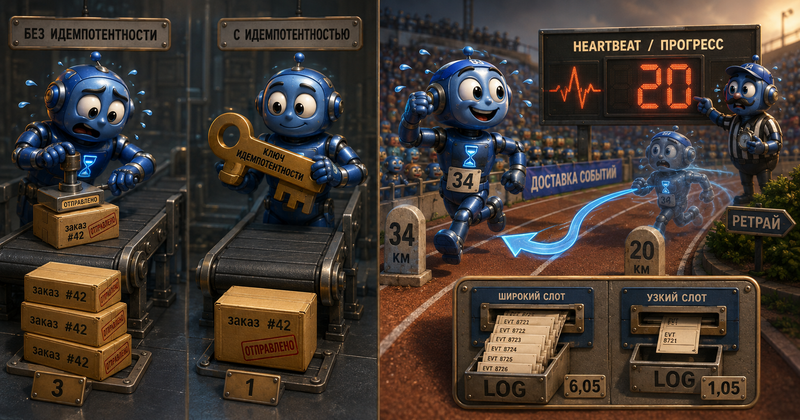
Весь I/O в Temporal живёт в activity — и именно на activity держится надёжность процесса. Разбираем четыре таймаута (ScheduleToStart, StartToClose, ScheduleToClose, Heartbeat) и что каждый ловит; retry-политики и non-retryable ошибки; heartbeat для долгих задач — и почему он возобновляет работу не с точки остановки, а с более ранней; почему идемпотентность activity целиком на вашей стороне (ретрай вызовет её повторно) и во что обходится её отсутствие; local activities и их цена в событиях истории. Это статья про то, что делает workflow надёжным, а не просто запущенным

Workflow и детерминизм: event history, replay, что можно и нельзя

Workflow и детерминизм: event history, replay, что можно и нельзя

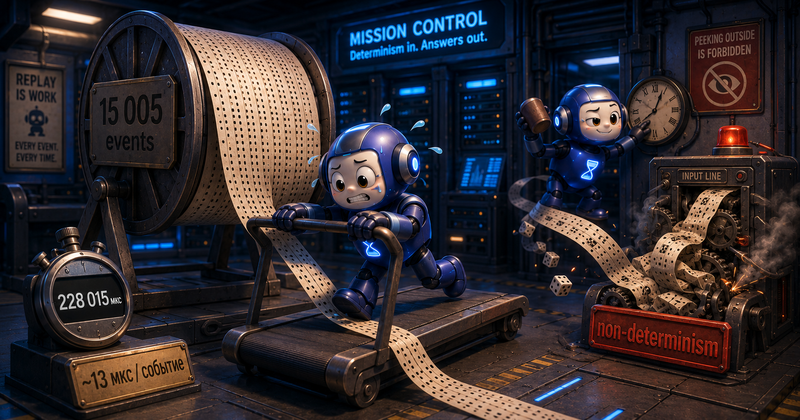
Магия «код продолжается с той же строки» держится на одном жёстком требовании: workflow-код должен быть строго детерминированным. Разбираем, что это значит на практике — почему нельзя time.Now(), rand(), прямой I/O, обход map в случайном порядке и потоки; как event history и replay восстанавливают состояние; что такое non-determinism error и откуда он берётся; и какой инструментарий workflow (таймеры, селекторы, side effects, детерминированные версии времени и случайности) заменяет запрещённое

Архитектура Temporal вглубь: сервисы, persistence, task queues

Архитектура Temporal вглубь: сервисы, persistence, task queues

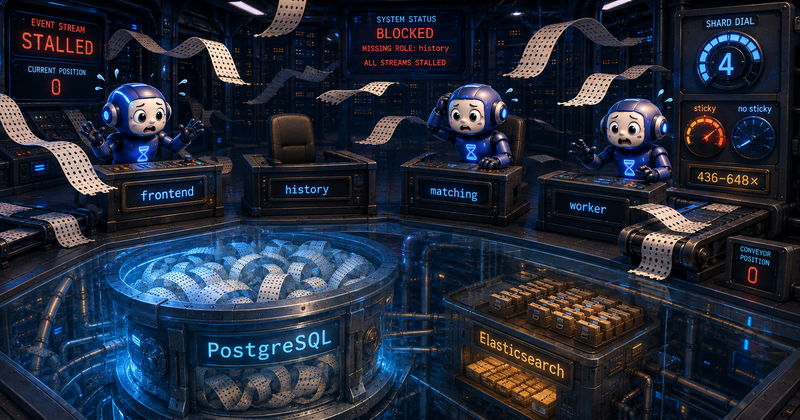
Temporal изнутри — это не «сервер», а четыре кооперирующихся сервиса (frontend, history, matching, worker) поверх persistence-хранилища и отдельного visibility-store. Разбираем, кто за что отвечает, как workflow шардируется по history-сервису, что физически лежит в PostgreSQL/Cassandra, зачем нужен отдельный visibility-store (Elasticsearch/Advanced Visibility) и как устроены task queues, на которых висят воркеры. Понимание этой механики — то, что отличает «запустил docker-compose» от «эксплуатирую в проде»

Durable execution: почему код должен переживать падения

Durable execution: почему код должен переживать падения

Прежде чем нырять в Temporal, стоит понять парадигму, которую он реализует: durable execution — выполнение, которое не теряется при падении процесса. Разбираем идею честно: что значит «код продолжается с той же строки после краха», как это даёт replay event history, откуда парадигма выросла (Cadence → Temporal) и чем durable execution отличается от очередей, saga-оркестраторов и BPM. Плюс ландшафт: Temporal, Cadence, Restate, DBOS, AWS Step Functions, Azure Durable Functions — кто на что и где граница применимости

Архитектура Kubernetes: control plane и reconciliation loop

Архитектура Kubernetes: control plane и reconciliation loop

Что крутится, когда вы делаете kubectl apply: API server как единственная дверь к etcd, scheduler раскладывает поды по узлам, controller manager бесконечно сверяет желаемое с фактическим (reconciliation loop), kubelet на узле воплощает поды через CRI, а CNI/CSI дают им сеть и хранилище. Ментальная модель k8s как набора контроллеров вокруг декларативного состояния — фундамент под всю практику

Postgres как очередь: SKIP LOCKED без отдельного брокера

Postgres как очередь: SKIP LOCKED без отдельного брокера

Очередь задач прямо в PostgreSQL: что на самом деле покупает FOR UPDATE SKIP LOCKED (не корректность), сколько стоит LISTEN/NOTIFY против опроса, почему очередь — худший случай для MVCC, где начинается потолок пропускной способности и что его задаёт: насыщение сбросов журнала и группировка коммитов, снятые прямым замером

Планировщики: семантика расписаний в кластере

Планировщики: семантика расписаний в кластере

«Раз в час» перестаёт быть понятным требованием, как только реплик становится больше одной, а планировщик успевает поспать: что означает пропущенный запуск, догоняет ли расписание пропущенное (одно или всё), что делать с перекрытием и почему полночь — худшее время для задачи. Поведение снято прогонами на живом кластере, а не пересказано по документации