
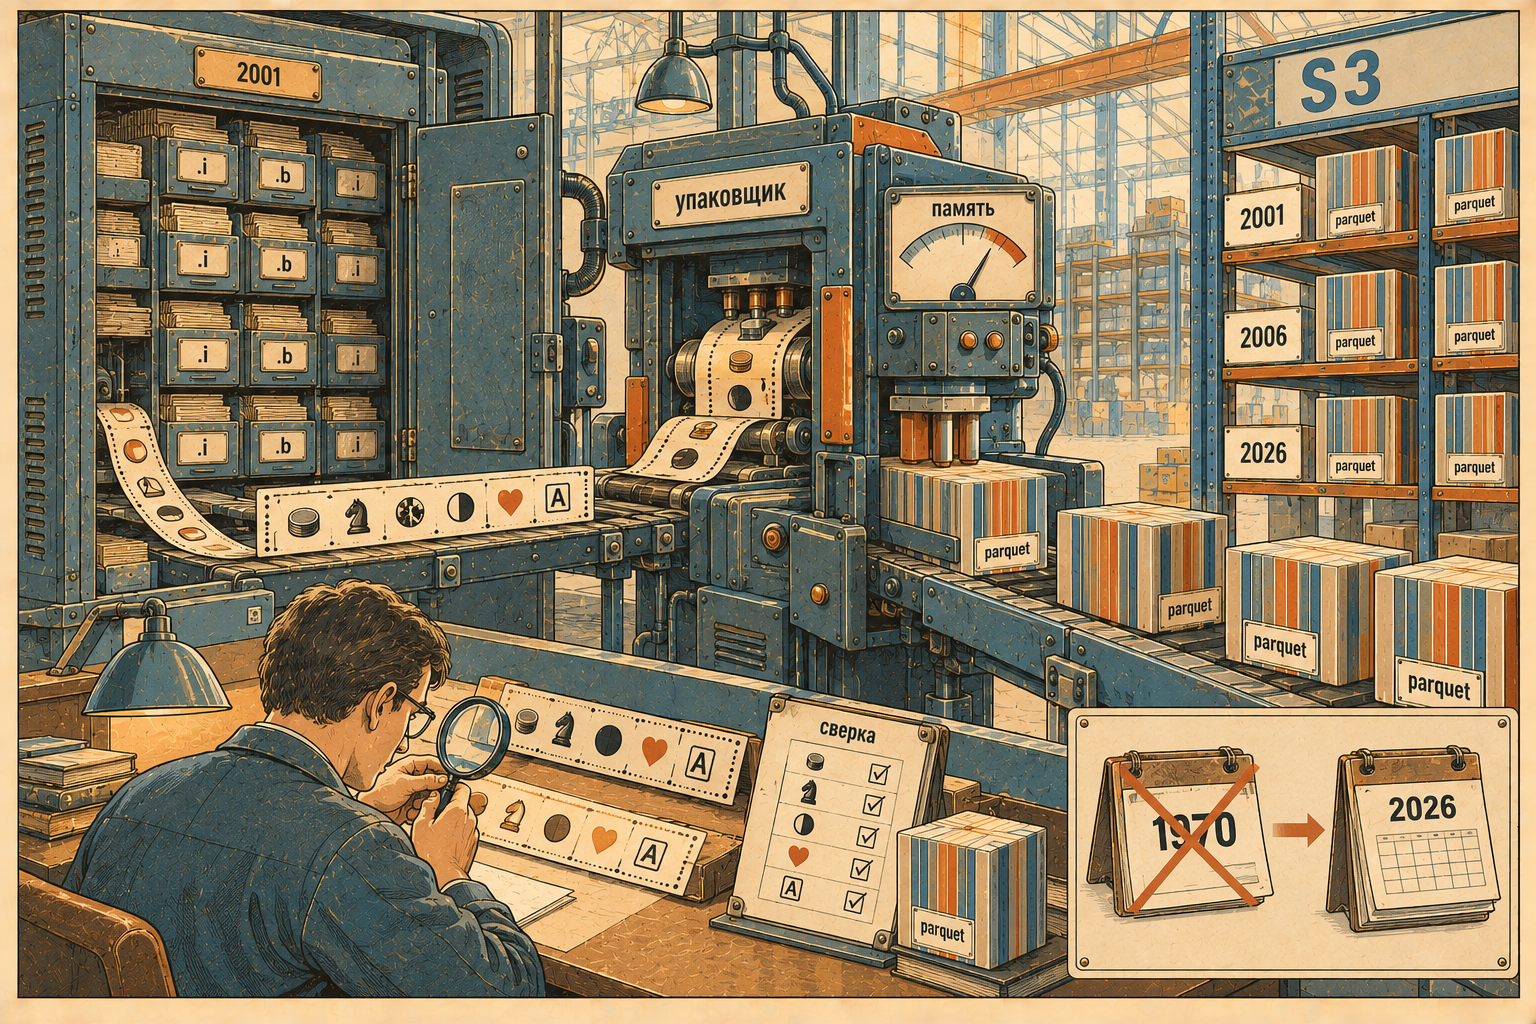
Это седьмая статья серии «VOG изнутри». В статье про порядок вывода легаси среди старых проблем было хранение архивов на файловой системе игрового сервера. Здесь — как этот архив переехал в Parquet на S3: как выбирали подход, как переупаковывали, что при этом ломалось и как проверяли, что ничего не потерялось.
Всё ниже описывает состояние на 8 октября 2026 года.
В статье
- Зачем переносить архив
- Что лежало на диске
- Почему Parquet, а не Iceberg и не protobuf
- Первое поколение: ходы по колонкам
- Второе поколение: транскрипт как есть
- Записи двадцатилетней давности
- Выгрузка: что шло не так
- Как проверяли
- Один формат для показа
- Архив в работе
- Что осталось
- Итог
Зачем переносить архив
Архив партий VOG — это двадцать пять лет игр: нарды, шашки, шахматы, реверси, червы и эрудит (в прежних статьях серии он назван по-клиентски — «Слова»). Самые первые партии хранились в базе, и при миграции восстановили не все, поэтому сегодня архив начинается с 2001 года и местами неполон в первые годы. Остальное — около 17,7 млн партий — лежало в файлах на диске игрового сервера, в собственном формате, который читал только сам сервер.
Главная причина переноса — не формат, а локальность. Пока архив лежит на диске одной машины, всё, что с ним работает, привязано к этой машине. Такая привязка мешала размещению, которое нам нужно в Kubernetes: сервисы, работающие с архивом, — показ партии, индекс для поиска, сверки, — должны подниматься на любой ноде и не в одном экземпляре. Им нужно хранилище, доступное по сети, а не каталог на чужом диске.
S3-совместимое хранилище эту привязку снимает. Но полностью от промежуточного хранения оно не избавляет. Закрытый файл Parquet нельзя дописать: пополнение — это новый файл, а перепаковка — чтение старых и запись нового. А наш упаковщик к тому же сортирует строки партиции перед записью (зачем — ниже), поэтому держит партицию в памяти целиком, прежде чем выгрузить файл. Сам формат этого не требует, это цена нашей сортировки. Упаковка и перепаковка поэтому требуют места, где файл собирается, — у нас это память упаковщика с жёстким пределом.
Что лежало на диске
Старый сервер хранил партии в формате, который в коде называется CFastLibrary. Устроен он просто. Партии лежат парами файлов .i и .b, по 16 384 номера партии на пару. Файл .i — массив 32-битных смещений, номер записи в нём — номер партии внутри диапазона; значение 0xFFFFFFFF означает «партии нет». В .b по смещению лежит длина и сами байты транскрипта. Партия открывается по номеру за два чтения.
bool CFastLibrary::AppendBlock(uint32_t Index, unsigned char *Block, unsigned int uiSize) {
    std::lock_guard<std::mutex> locker(m_ppLock);

    struct stat statv{};
    uint32_t PosBlock;
    int HandleIdx, HandleBlock;

    if (m_strBase == nullptr) {
        return false;
    }

    Index = FillBase(Index);

    m_strIndex[9] = 'b';
    if ((HandleBlock = open(m_strBase, O_CREAT | O_RDWR, 0660)) != -1) {
        PosBlock = lseek(HandleBlock, 0, SEEK_END);
        if (PosBlock != (uint32_t) -1) {
            auto w = write(HandleBlock, &uiSize, sizeof(uiSize));
            w = write(HandleBlock, Block, uiSize);
            // …
Транскрипт внутри — цепочка кусков вида «тип, длина, тело», упакованных без выравнивания. Кусок 0x00 — заголовок партии, ровно 22 байта; 0x01 — игрок с ником на момент партии; ходы — в 0x83, и раскладка хода у каждой из шести игр своя. Версия формата записи клиента — 28, отсюда и имя, под которым этот формат живёт в новом коде: chunk28.
В файлы попадала не каждая партия. Транскрипт писался только у рейтинговых, и только если за столом не сидел турнирный бот. Строка в базе при этом писалась всегда. По правилу транскрипт полагался 17 616 258 партиям из 17 617 344 строк базы — разница общих количеств крошечная. Но близкие суммы не означают одинаковый состав: ниже, на сверке, видно, что файлы и база расходятся в обе стороны на тысячи партий.
Весь файловый архив занимал 24 ГБ (здесь и дальше, где источник даёт двоичные единицы, пишем ГиБ и МиБ). Больше всего партий у нард — 8,7 млн, дальше эрудит (3,0 млн), шашки (2,8), реверси (1,19), шахматы (1,13) и червы (0,78). Средний транскрипт — около полутора килобайт.
Почему Parquet, а не Iceberg и не protobuf
Сначала о том, что с чем сравнивается. Parquet — формат файла, protobuf — способ сериализовать полезную нагрузку внутри файла или сообщения, Iceberg — слой управления таблицей поверх файлов. Это ответы на вопросы разных уровней, и выбирали мы на каждом уровне отдельно.
Решение записано в архитектурном решении о хранении партий. Главная мысль в нём — хранение делится по способу обращения к данным, а не по возрасту партии и не по тому, какой сервис её записал:
- горячее — идущие и отложенные партии. Частая запись, чтение по ключу, партия должна пережить перезапуск. Это ScyllaDB;
- тёплое — показать одну доигранную партию по запросу игрока. Точечное чтение по ключу;
- холодное — аналитика по всему массиву: сколько сыграно, как менялся рейтинг. Это Parquet в S3, который читается DuckDB прямо из хранилища — без кластера, без демона, без каталога.
Iceberg мы не завели. Он добавляет к Parquet каталог таблиц, снимки, эволюцию схемы и построчное удаление. Каталог не обязательно отдельный сервер — бывают каталоги на файловой системе или в обычной базе, — но это всё равно ещё один слой, который нужно обслуживать: уплотнение, чистка снимков. Нам пока хватает одного писателя на партицию и DuckDB для разовых запросов, архив целиком помещается на один диск, и вводить управление таблицами — а вместе с ним Trino или другой движок запросов — мы решили не сейчас. Условия, при которых к Iceberg стоит вернуться, записаны заранее: несколько независимых писателей, удаление задним числом или схема, меняющаяся чаще раза в год.
Protobuf проиграл даже исходному бинарному формату. Формат хранения ходов выбирали измерением на 20 000 реальных партий, в байтах на партию:
| Вариант | Реверси | Нарды |
|---|---|---|
| сырой блок в старом архиве | 297 | 1620 |
| тот же блок, сжатый внутри Parquet | 177 | 897 |
| protobuf внутри Parquet | 200 | 1242 |
ходы колонками, LIST<STRUCT> |
165 | 1017 |
Старый формат уже плотный: ход реверси занимает пять байт, перемещение в нардах — два байта битовыми полями. Protobuf добавляет тег и длину к каждому полю, то есть накладные расходы там, где избыточности не было.
Колонки выиграли у блока на реверси и проиграли на нардах, где ход — это список перемещений и Parquet платит за двойную вложенность. Их выбрали всё равно: по блоку нельзя считать ничего, а по колонкам можно.
Первое поколение: ходы по колонкам
Первая версия архива разбирала каждую партию по правилам её игры и раскладывала ходы колонками. Путь в хранилище был games/year=…/sid=…/game_type=…/part-NNNN.parquet: год, сервер (он же игра) и тип игры внутри сервера.
Время на ход округлили до десятых долей секунды. У нард колонка времени занимала 28% объёма, и округление сократило партию с 1017 до 891 байта. Точная миллисекунда у новых партий остаётся в Scylla, где по ней считают часы.
Одна деталь стоила трети объёма. Сначала выгрузку делал скрипт на Python с pyarrow, потом упаковщик переписали на Go. pyarrow включает словарное кодирование колонок сам, библиотека parquet-go — нет, и первая сборка на Go при тех же данных вышла на треть тяжелее. Словарь снимает 15–20% объёма почти у всех колонок: клетка доски, вид хода, масть, имя — значений у них в пределах файла немного.
Первое поколение заняло 11,5 ГБ на 17,6 млн партий. И почти сразу стало понятно, что формат неудачен:
- он терял данные — часы игроков и контроль времени в колонки не попали;
- он не годился для показа партии — из колонок нельзя собрать исходные байты, которые читает клиент;
- он привязывал архив к правилам игр — новая игра означала правку схемы архива.
Второе поколение: транскрипт как есть
Через два дня архив переделали. Теперь в нём лежит сам транскрипт, тем же куском байт, который читает игровой клиент. Разбирается только общее для всех игр: кто играл, когда, чем кончилось, сколько ходов. Разбор ходов, когда понадобится аналитика по ним, переедет в ClickHouse.
Рядом с байтами в каждой строке записан их формат: chunk28 для старых партий, jsonmoves1 для партий новых игровых сервисов. Формат читается до разбора. Двоичные данные охотно притворяются любыми другими двоичными данными, и партия нового сервиса, разобранная по старым правилам, дала бы правдоподобный мусор.
Путь в хранилище тоже изменился: games/year=YYYY/sid=NN/game_class=…/part-<прогон>-NNNN.parquet. Вместо типа игры — разряд партии (рейтинговая, обычная, турнирная, клубная), а в имени файла — метка прогона, чтобы случайный второй писатель не затёр чужой файл.
Поля для поиска берутся из самого транскрипта, а не из базы. Прежде всего это ники: в транскрипте записано имя на момент партии. Если брать его из профиля, человек сменит имя, и партия двадцатилетней давности подпишется сегодняшним.
Точечное чтение из колоночного файла
В решении о хранении сначала было записано, что для показа одной партии Parquet противопоказан: чтобы достать одну запись, придётся открыть файл с сотнями тысяч чужих. Второе поколение это обошло, и теперь одна партия читается прямо из Parquet. Путь от запроса до байт такой:
- Ключ запроса. Старый клиент и веб приносят сервер и номер партии, новые сервисы — идентификатор.
- Партиция. Её подсказывает индекс в ClickHouse (о нём ниже): по серверу и номеру он отдаёт год и разряд партии, то есть каталог в хранилище.
- Файл и группа строк. В исторических партициях после выгрузки файлов единицы; в подвале каждого записаны границы номеров по группам строк, и по ним выбирается одна группа одного файла.
- Страница. В группе по колонке номеров находится место партии, и по индексу страниц читается одна страница колонки транскрипта.
Из S3 файл целиком не скачивается: читаются диапазоны байт — подвал, нужные куски тела — кусками по мегабайту, которые кэшируются в памяти службы. Список партий за день открывает две сотни партий одного файла, и все они попадают в одни и те же несколько мегабайт.
У этого пути есть текущее ограничение: в партициях со свежими партиями каждый прогон упаковщика добавляет свой файл, и пока нет уплотнения, число файлов, чьи подвалы надо просмотреть, растёт.
Чтобы этот путь был дешёвым, понадобились три вещи.
Строки отсортированы по номеру партии. У каждой группы строк в подвале файла записаны минимальный и максимальный номер, и читатель пропускает все группы, кроме одной.
// Сортировка — то, на чём держится дешёвое точечное чтение: статистика
	// групп позволяет пропустить всё, кроме одной.
	//
	// Ключ составной, потому что спрашивают двумя способами. Сначала легасийный
	// номер: по нему приходит легасийный клиент, и он же даёт группам узкие
	// границы. Партии новых движков номера не имеют, собираются в блок с нулём и
	// внутри упорядочены по идентификатору — отсечение работает и там.
	sort.Slice(rows, func(i, j int) bool {
		if rows[i].LegacyGameID != rows[j].LegacyGameID {
			return rows[i].LegacyGameID < rows[j].LegacyGameID
		}
		return bytes.Compare(rows[i].GameID[:], rows[j].GameID[:]) < 0
	})
Страница — 64 КБ. Это целевой размер страницы до сжатия, а не объём сетевого чтения. Сжатие (zstd) идёт постранично, и достать один транскрипт, не распаковав его страницу, нельзя. При странице в мегабайт открытие партии означало бы распаковку мегабайта ради полутора килобайт полезных.
Чтение идёт колонками, а не строками. Сначала перебирается колонка номеров одной группы, потом по индексу смещений берётся одна страница колонки транскрипта. Строками так нельзя: parquet-go поднимает каждую строку целиком со всеми колонками. Мы это узнали, когда служба показа партий упала по памяти на выборке старых нард: чтение одной партии строками выделяло 43 МБ, колонками — 2,9 МБ.
Указателей «файл, группа, строка» в базе нет намеренно. Перепаковка меняет и файл, и группу, и рассогласование выглядело бы не как ошибка, а как «партия не открывается». Читатель находит файл и группу сам, по подвалам, а разобранные подвалы кэшируются ненадолго — как подсказка, а не как источник: промах ведёт к перечитыванию, а не к отказу.
Две личности партии
У партии в архиве два ключа: постоянный идентификатор game_id (UUID) и старый номер legacy_game_id. Номер уникален только внутри сервера, а у партий новых сервисов его нет вовсе — они получают UUIDv7. Идентификатор старой партии вычисляется из пары «сервер и номер»:
// GameIDForLegacy — идентификатор партии по её легасийному номеру.
//
// Считается из пары «сервер и номер»: номер уникален только внутри сервера, и
// без сервера партии разных серверов слились бы в одну.
//
// Функция чистая и повторяемая — в этом весь смысл. Старый архив, перенесённый
// сегодня, получит те же идентификаторы, что живая партия получила бы тогда, а
// повторный перенос не заведёт вторую запись вместо первой.
func GameIDForLegacy(serverID int, legacyGameID uint32) uuid.UUID {
	return uuid.NewSHA1(GameIDNamespace, []byte(fmt.Sprintf("%d/%d", serverID, legacyGameID)))
}
Это позволило упаковывать одним кодом обе дороги: разовый перенос из файлов и регулярную упаковку доигранных партий из Scylla. Партия, которую старый сервер вёл вчера и записал в оба места, получает в архиве один и тот же идентификатор, откуда бы её ни взяли.
Записи двадцатилетней давности
Перед выгрузкой формат разобрали заново на 60 000 партий с прода, по 10 000 на игру, с отдельным ревью разбора каждой игры. Документации на формат не было, только исходники сервера и клиента. Особенностей набралось много; вот те, что повлияли на архив.
- Порядок битовых полей. Первое поле лежит в младших битах. Обратное чтение выдавало пас в реверси за клетку (0, 15) — правдоподобно и неверно.
- Автор хода записан не везде. В шахматах место ходившего есть в самом ходе. В реверси и шашках автора восстанавливают чередованием с учётом пропусков. В червах его выводят из индекса карты: карты раздаются по кругу, и по отрицательному индексу карты из руки считается место игрока. Проверка дала совпадение на 827 124 ходах из 827 158; все 34 промаха — в одной битой партии.
- Время хода меряет клиент. Сервер кладёт присланное значение как есть. Нашлись ходы длиной около 49,6 суток — это аптайм машины игрока, попавший в поле целиком, когда стартовая отметка была нулевой. Такие ходы не отбрасываются, а считаются: значение может быть сломанным, а может быть законным, например в отложенной партии.
- Дат нет у 410 630 партий. Они записаны с нулевой меткой и показывались бы 1970 годом. Дату восстановили по ближайшим соседям: номера выдаются во времени. Метод проверили на 8,5 млн нард с известной датой — год верен в 99,9% случаев, день в 96%, медианная ошибка 4,5 минуты. Рядом с такой датой стоит признак
date_estimated: через год никто не отличит партию, сыгранную в 2004-м, от той, которой 2004-й приписан. - Битые записи встречаются. В реверси десять партий из 10 000 содержат сотни «ходов» на доске 8×8. Разбор обрывается на первой неправдоподобной длине и возвращает прочитанное:
// chunks разбирает запись на куски. Обрывается на первой неправдоподобной
// длине: записи двадцатилетней давности встречаются испорченными, и лучше
// вернуть прочитанное, чем ничего.
func chunks(blob []byte) []chunk {
	var out []chunk
	for off := chunkPrefix; off+chunkHeader <= len(blob); {
		length := int(binary.LittleEndian.Uint16(blob[off+1:]))
		if length < chunkHeader || off+length > len(blob) {
			return out
		}
		out = append(out, chunk{tag: blob[off], body: blob[off+chunkHeader : off+length]})
		off += length
	}
	return out
}- Структуры менялись между версиями клиента. У эрудита кусок правил бывает 32 и 33 байта, в другом куске поля смещены на 12 байт. Имена — в cp1251, декодер для неё написан свой, без зависимостей.
Отдельно оказалось, что «424 неразобранные партии нард из 10 000» — ошибка измерения: столько партий вовсе не имеют ходов. У шахмат таких 7%, почти все с причиной «партия не началась». Объявить их испорченными значило бы объявить испорченными семь процентов архива.
Выгрузка: что шло не так
Разовая выгрузка заняла несколько дней, и за них сломалось почти всё, что могло. Мы рассказываем об этом подробно, потому что каждая ошибка дала правило, которое работает и сейчас.
Прод-машина ушла в своп. Упаковщик копил партии в памяти по партициям и сбрасывал партицию на диск, когда в ней набиралось 200 000 партий. Общего предела не было. На пробном прогоне брали узкий диапазон номеров, и всё было хорошо. На полном проходе реверси — 1,18 млн партий, разложенных на два десятка лет и пять типов игр, — ни одна партиция не дошла до порога, и весь миллион остался в памяти. Машина с 8 ГБ, где рядом работали игровые контейнеры, ушла в своп. Игровые серверы выжили, а ssh не отвечал, и выгрузку останавливали с консоли гипервизора.
Главный урок здесь не про память: пробный прогон отличался от полного не масштабом, а формой — в нём просто не было того, что ломает. С тех пор тяжёлую работу сначала пробуют на полном диапазоне одного сервера и запускают с пределом памяти контейнера, чтобы ядро убивало выгрузку, а не соседей.
Повтор на нардах. Следующий прогон «умер молча»: в логе осталась строка про сервер нард без итога, процесс убило ядро. У нард полторы сотни партиций — двадцать шесть лет на несколько видов правил, — и предел на партицию умножался на их число. Теперь предел общий, и при его превышении сбрасывается самая тяжёлая партиция. Выгрузку направили прямо в хранилище: на диске машины оставалось 23 ГБ при архиве в 24.
Бакет оказался пуст. Выгрузку почистили перед новым прогоном, а прогон упал на разборе. Обнаружилось это, когда я спросил, можно ли уже делать миграцию. Потеряли часы машинного времени, а не партии: Parquet производный, его можно собрать заново. Но после переключения на новые сервисы подстраховки не станет — партия будет только в архиве. Поэтому:
- решено, что новый игровой сервис на переходный период пишет доигранную партию дважды: в Parquet и в пары
.i/.bтем же форматом, что старый сервер, — чтобы при ошибке упаковки перепаковать партии с диска. Выключать вторую запись — по признаку, а не по ощущению: когда сверка подтвердит каждую партию за достаточный срок. На 8 октября это правило исполняется только наполовину. Партии, которые ведёт старый сервер, по-прежнему ложатся в.i/.b. У новых сервисов вторая запись ещё не сделана; их партии страхует Scylla, из которой доигранные партии пока не удаляются вовсе; - появилась сверка числа партий в архиве с базой по каждой игре.
Файл на партию. По ошибке упаковщик писал по файлу на партию, что дало бы двести тысяч объектов в день. Отсюда правило: пополнение идёт пакетами, а файлы должны укрупняться по мере остывания.
Упаковщик ходил в Amazon. Задание в кластере не передавало адрес хранилища, а пустой адрес в SDK означает не «по умолчанию», а настоящий AWS. Ключ был от нашего хранилища, упаковка при каждом запуске получала «такого ключа не существует» и падала. Ошибка выглядела как проблема с доступом, а была промахом мимо хранилища. Партии при этом не терялись: они оставались в Scylla, а старый сервер ещё и писал их в файлы.
Дубли. Файлы второго поколения отдали 17 723 479 партий, а в индексе их оказалось на 1003 меньше: у части партий пара «сервер и номер» повторялась, и в индексе вторая строка вытесняла первую. Таких партий 37, некоторые повторены помногу раз. Опасно это, только если копии разные — тогда мы молча выбрали бы, какую запись истории считать настоящей. Отдельный инструмент сравнил все копии по SHA-256: совпали побайтово. Обычная сверка этого бы не увидела — она строит раскладку тем же отображением «номер → место», и вторая копия затирает первую ещё до сравнения.
Числа разных этапов не совпадают, и это не ошибка счёта — они считают разное:
| Этап | Дата | Строк | Уникальных партий | Что считали |
|---|---|---|---|---|
| База старого сервера | 21.08 | 17 617 344 | — | строки базы; транскрипт по правилу полагался 17 616 258 из них |
| Первое поколение | 21–22.08 | около 17,6 млн | — | черновой прогон шёл по вручную заданным диапазонам номеров, перенос на Go — уже по файлам |
| Второе поколение | 24.08 | 17 723 479 | 17 722 476 | обход по самим файлам .i/.b: всё, что лежит на диске, включая партии без строки в базе |
Причин у разницы чисел две, и они независимы. Первая — неполнота диапазонов: обход по файлам находит больше, чем обход по заданному вручную диапазону номеров; у реверси черновой прогон недосчитался 4485 партий, у шахмат — 2137. Это объясняет разницу между выгрузками. Вторая — сами файлы и база расходятся по составу: есть партии с транскриптом и без строки в базе, и наоборот (подробно — в разделе о проверке). Это объясняет, почему во втором поколении партий больше, чем строк в базе. Отсюда правило для сверок: числа предыдущей выгрузки не эталон, сверять надо с базой и с файлами.
Архив второго поколения занимает 15,1 ГиБ — меньше, чем 24 ГБ исходных файлов, хотя хранит больше, чем первое поколение.
Как проверяли
Проверок несколько, и каждая отвечает на свой вопрос.
Тот же ли разбор? Разборщик переносили со скрипта на Go и сверяли с прежней реализацией на тех же 60 000 партий до полного совпадения. Сверка нашла три ошибки: знаковое чтение превращало 255 в −1, время тихо обрезалось по часу, а номер подыгры терялся в потоке ходов.
Верен ли автор хода? Чередование проверили на шахматах, где автор записан явно: 57 916 ходов, ноль расхождений. Ошибка здесь не видна на глаз — партия с неверным автором разбирается и выглядит целой. У эрудита все ходы какое-то время приписывались одному игроку, пока это не поймала сверка.
Не потерялось ли что-то при упаковке? Каждый прогон упаковщика перечитывает записанное и сверяет:
- число партий с числом в списке доигранных;
- номер и сервер из транскрипта с теми, что назвал сервис, который вёл партию. Несовпадение означает чужие байты в партии — худшее, что может случиться с архивом, — и прогон завершается ошибкой;
- число ходов: расхождение считается отдельно, обрезанная запись лучше отсутствующей;
- счётчики пропусков — не хранится, не найдено, без транскрипта, чужой формат, не разобрано. Они видны в логе каждого прогона. Молчаливый пропуск читался бы как «упаковали всё».
Те же ли байты? Сравнение с файлами .i/.b байт в байт стало возможным только во втором поколении: в архиве те же байты, а не результат разбора. Червы проверили целиком — 783 030 партий за 9 минут, все совпали.
Сходится ли состав с базой? На реверси нашлись 4103 партии, которые есть в файлах и нет в базе: вокруг каждой в базе лежат соседние номера, то есть файл записался, а строка — нет, или партию позже удалили из базы. И 877 партий есть в базе, но нет в файлах, почти все из 2001–2002 годов: похоже, файлы тех лет просто не сохранились. Общие количества при этом почти равны — именно поэтому сверять нужно множества, а не суммы.
Один формат для показа
В архиве два формата: chunk28 у старых партий и транскрипт новых сервисов. Показывать их браузеру двумя путями значило бы держать два просмотрщика. Поэтому на стороне показа есть переводчик старой записи в транскрипт новых сервисов. Им пользуются веб-архив партий и инструменты администрирования.
Переводчик писали по игре за раз, и каждую проверяли на выборке старых партий:
| Игра | Выборка | Что проверяли |
|---|---|---|
| Реверси | 1133 партии | все ходы законны, победитель совпал во всех доигранных; 13 партий 2001–2007 годов со своей начальной расстановкой поддержаны отдельно |
| Шахматы | 1200 партий 2001–2026 годов | все ходы законны; в победах последний ход за победителем |
| Червы | 1175 партий | 9818 раздач, кроме двух с испорченной картой |
| Эрудит | 96 партий | 1155 слов, счёт совпал |
| Шашки | 1199 партий | одна партия со своей расстановкой отвергнута |
| Нарды | 178 партий | счёт матча равен сумме подпартий |
По дороге всплыли новые особенности: итальянские шашки записаны на другой раскраске доски, точку поворота при бое клиент местами писал дважды, а у 40% партий нард нет правил — в начале 2000-х там лежал мусор.
Итоговая проверка: случайная выборка по 5000 старых партий каждой игры прямо из хранилища, минуя службу показа. Успехом считался перевод без ошибки переводчика; законность ходов и совпадение результата проверялись раньше, на выборках из таблицы. Переведены все 30 000. При нуле отказов из 5000 односторонняя 95-процентная верхняя граница доли непереводимых — 0,06% на игру. Это оценка по выбранному критерию — «перевод не падает», — а не по всем возможным ошибкам архива.
Архив в работе
идущие и доигранные партии"] L -.-> F["Файлы .i/.b
подстраховка"] G["Новые игровые сервисы"] --> SC SC --> P["Упаковщик"] F -.->|"перенос и перепаковка"| P P --> S3["Parquet в S3"] S3 --> IX["Индекс
ClickHouse"] S3 --> V["Показ партии"] IX --> W["Поиск партий в вебе"] V --> W
flowchart LR
    L["Старый сервер"] --> SC["ScyllaDB
идущие и доигранные партии"]
    L -.-> F["Файлы .i/.b
подстраховка"]
    G["Новые игровые сервисы"] --> SC
    SC --> P["Упаковщик"]
    F -.->|"перенос и перепаковка"| P
    P --> S3["Parquet в S3"]
    S3 --> IX["Индекс
ClickHouse"]
    S3 --> V["Показ партии"]
    IX --> W["Поиск партий в вебе"]
    V --> W
Состояние механизмов на 8 октября:
| Механизм | Статус |
|---|---|
| Упаковка доигранных партий из Scylla | работает на проде |
| Индекс в ClickHouse из Parquet | работает на проде |
| Показ старой и новой партии из Parquet | работает на проде |
| Журнал удалений | сделан |
| Перепаковка партиции (удаление, уплотнение) | спроектирована, не реализована |
| Полная пересборка индекса из архива | не проверялась на полном объёме |
Упаковка. Свежие партии лежат в Scylla и показываются оттуда, пока не попали в архив. Сервис, закрывая партию, кладёт её в список доигранных за день. Упаковщик идёт по расписанию, берёт из списков вчерашний и сегодняшний день и ведёт отметку «докуда упаковано»: запускать его можно хоть каждые четверть часа, и при штатной работе уже упакованный участок повторно не обрабатывается. Граница у этой гарантии есть. Отметка сдвигается отдельным шагом после записи файлов, и если процесс упадёт между ними, файлы уже лежат в архиве, а следующий прогон упакует те же партии ещё раз — в файл с меткой нового прогона, то есть рядом, а не поверх. Окно узкое — между сбросом файлов и записью отметки; открывается оно на каждой контрольной точке (раз в 20 000 партий) и в конце дня. Но дубли после такого сбоя возможны, и отдельной проверки на них пока нет. Писатель на партицию один, режим только дописывающий, имя файла содержит метку прогона. Перезапись партиции целиком осталась инструментом миграции и в работающую систему не попала.
У этого окна в двое суток есть слабое место. Окно отсчитывается от дня завершения партии, а не от её начала, поэтому долгие и отложенные партии ему не страшны. Опасен простой: если упаковщик не работал дольше двух суток или партия не попала в список дня при закрытии, назад он не посмотрит, а прогон отчитается нулями и будет выглядеть здоровым. Необратимой потери при этом нет: доигранные партии из Scylla сейчас не удаляются. Но восстанавливаются два случая по-разному. Простой упаковщика догоняется ручным прогоном за пропущенные дни. Партию, которой нет в списке дня, повторное чтение того же списка не найдёт: нужен отдельный поиск доигранных и не упакованных партий в Scylla, а его пока нет. И заметить ни тот, ни другой пропуск сейчас нечем — оба записаны в долг (ниже).
Файлы от частых прогонов получаются мелкими. Укрупнять их по мере остывания — суточные в месячные, месячные в годовые — задумано отдельным проходом, который переносит группы строк целиком, без перекодирования. Пока он не написан.
Поиск партий идёт не по Parquet, а по индексу в ClickHouse, который строится из него: строка на партию и строка на участие игрока. Замер делали 22.08 на загрузке из первого поколения — 17,6 млн партий и 36,7 млн участий; нынешний индекс строится из второго поколения тем же способом. Загрузка заняла 51 секунду, индекс занял 386 МиБ, а поиск партий игрока за двадцать шесть лет — 80 мс. Те же данные в PostgreSQL занимали 7,4 ГБ; сравнение грубое — разные движки, своё сжатие и свои индексы, — но порядок разницы показателен. Индекс отмечает разобранные файлы и пропускает их, загрузка повторяемая.
Удаление. Партии иногда нужно удалять: испорченная запись или требование убрать данные игрока. Объект в S3 неизменяем, и удаление задумано в два срока: запись в журнал удалений сразу скрывает партию от всех читателей службы, а отложенный проход перепаковывает партицию без неё. Журнал уже есть, перепаковки ещё нет — пока партия только скрывается.
Здесь и сказывается ограничение, с которого начиналась статья: перепаковка означает прочитать партицию, собрать новый файл и только потом записать его. Чем крупнее файл, тем дороже удаление одной партии, поэтому удаления будут копиться и исполняться партициями. Порядок публикации — тоже нерешённая часть: сначала новый файл, потом вывод старого из чтения. Между этими шагами читатель увидел бы партии дважды или не увидел вовсе. Ответ запланирован в манифесте публикации: упаковка во временный префикс, перечитывание и переключение одним указателем.
Что осталось
- Сплошная побайтовая сверка сделана только для червей; для остальных игр — выборочные проверки.
- Сверка по множествам и манифест публикации. Сейчас сверяется число партий, а не их состав: две ошибки, компенсирующие друг друга, пройдут незамеченными.
- Расхождения с базой на реверси (4103 и 877 партий) не разобраны, как и несколько одиночных странностей: шахматная партия с номером 304 280 987 при потолке около 28 млн у остальных и строка базы с номером сервера 111.
- Перепаковка — для удаления и уплотнения файлов до целевых 128–256 МБ — не реализована.
- Вторая запись в
.i/.bу новых сервисов не сделана; их партии страхует только Scylla. - Пересборка индекса из архива целиком ни разу не проверялась на полном объёме.
- Отставание упаковщика не видно. Партия, выпавшая из двухсуточного окна, останется в Scylla, но в архив сама не уедет, и ни один отчёт этого не покажет. Нужно число «закрыто и не упаковано» с возрастом самой старой такой партии.
- Партия, не попавшая в список дня при закрытии, не находится ни упаковщиком, ни его повторным прогоном. Нужен поиск доигранных и не упакованных партий по самой Scylla.
- Дубли после сбоя упаковщика. Падение между записью файлов и сдвигом отметки оставляет те же партии в двух файлах. Нужна проверка уникальности номера партии в партиции — при перепаковке или отдельным проходом по индексу.
- Старые файлы
.i/.bхранятся до конца перехода: пока идёт хоть одна сверка, они — единственный первоисточник.
Итог
- Переносили ради независимости от диска. Архив на диске одной машины привязывает к ней всех, кто с ним работает. Parquet в S3-совместимом хранилище эту привязку снимает, но не до конца: упаковка и перепаковка всё равно требуют места, где собирается файл.
- Хранение делится по способу обращения. Горячее — Scylla, аналитика — Parquet и индекс в ClickHouse. Слой управления таблицами вроде Iceberg нам пока не нужен: писатель один, объём помещается на один диск. Условия возврата к нему записаны заранее.
- Храните исходные байты, а не результат разбора. Первое поколение с ходами по колонкам теряло данные и не годилось для показа. Транскрипт как есть с форматом в каждой строке — и полнее, и проще.
- Точечное чтение из Parquet возможно, если отсортировать строки по ключу, взять мелкую страницу, читать колонками и диапазонами байт, а партицию брать из индекса.
- Пробный прогон должен иметь ту же форму, что полный. Своп на проде случился потому, что в пробе не было того, что ломает.
- Сверять множества, а не суммы. Близкие общие количества скрывали тысячи расхождений в составе в обе стороны.
- Каждый пропуск — счётчик, а не тишина. Партия без транскрипта, битая запись, восстановленная дата — всё это считается и помечается, иначе расхождение всплывает много позже.


Комментарии