
Серия прошла весь путь: первая статья была про решение (брать ли готовый IdP), вторая — про деплой и модель realm, третья — про бэкенд как resource server и локальную валидацию токенов, четвёртая — про темы и федерацию. Всё это работало на dev-стенде: один start-dev, HTTP без TLS, кэши в памяти, одна реплика. Для разработки — идеально. Для production — недопустимо. Осталась самая «взрослая» тема серии: как эксплуатировать этот же Keycloak в бою, где он — критическая зависимость, без которой не войдёт никто и никуда.
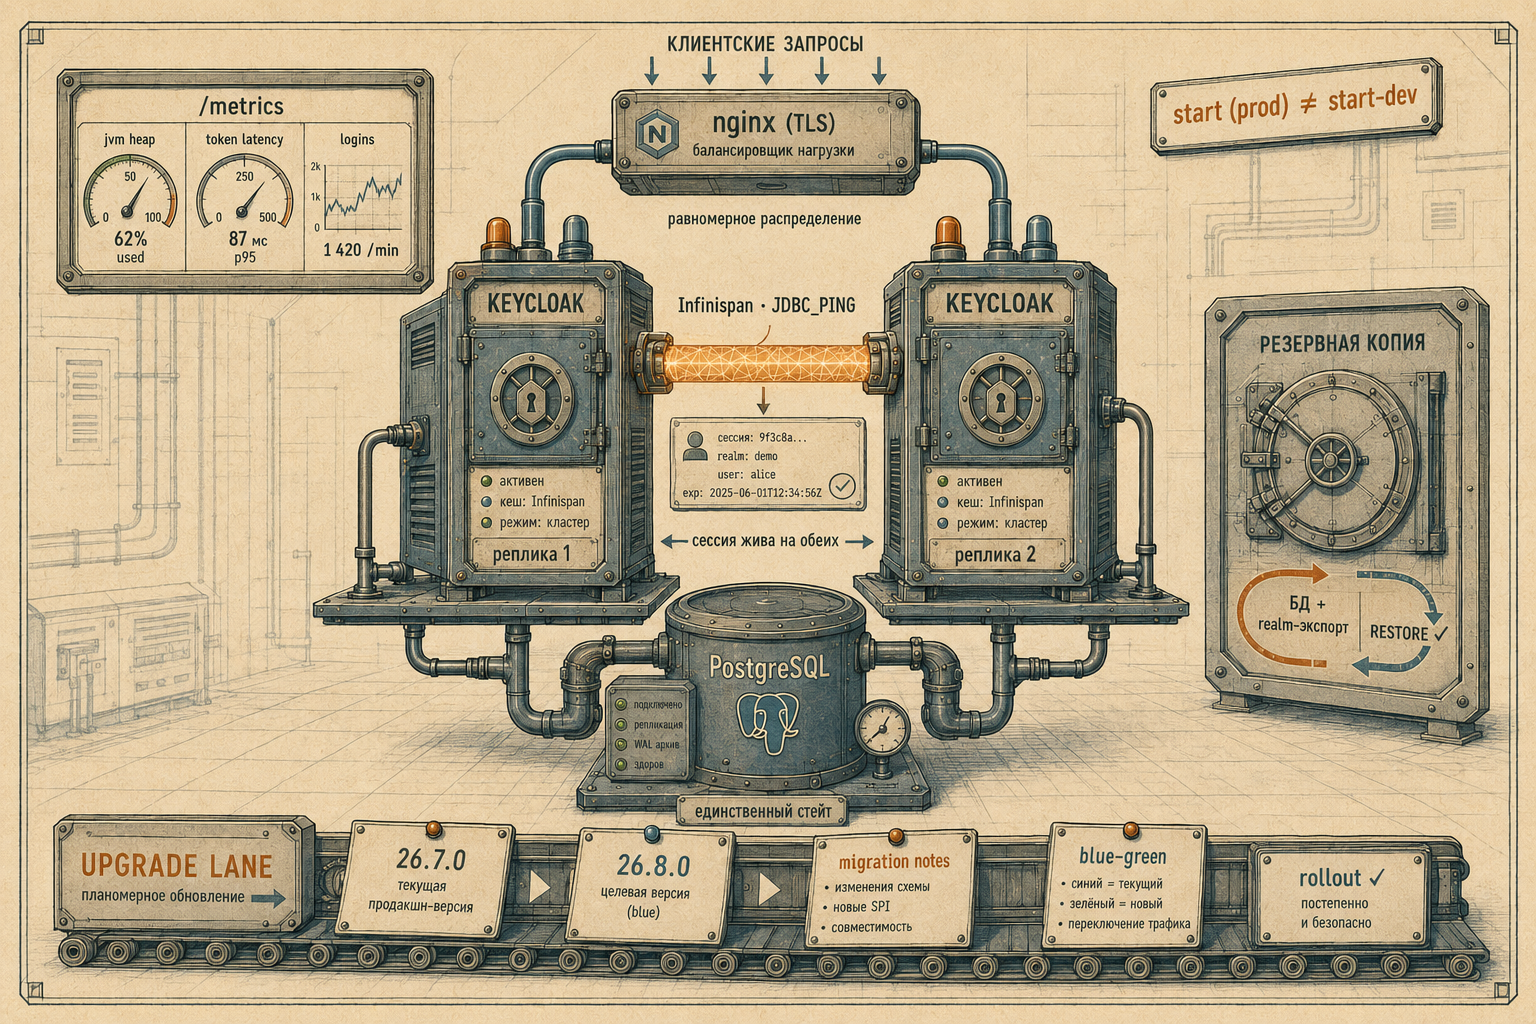
Ещё в первой статье мы честно назвали цену готового IdP: вы снимаете с себя разработку аутентификации, но берёте эксплуатацию критичного stateful-сервиса — HA, бэкапы, обновления мажоров, TLS, наблюдаемость. Эта статья раскрывает ту цену в деталях, на отдельном production-стенде digital-cookbook: security/keycloak (docker-compose.prod.yml: Keycloak 26.7.0 в режиме start --optimized, две реплики за nginx-балансировщиком, внешний PostgreSQL, TLS, /metrics). Кластер из двух нод реально поднят, распределённая сессия проверена вживую — все логи и числа ниже с этого прогона, не придуманы.
В статье
- Почему start-dev нельзя в production
- Оптимизированный образ: kc.sh build + start –optimized
- Внешний PostgreSQL как единственный стейт
- HA и кластеризация: две реплики, Infinispan, JDBC_PING
- Кластер вживую: 2-member ISPN view
- Распределённая сессия: login на одной, refresh на другой
- Балансировщик и TLS: offload против re-encrypt
- Наблюдаемость: /metrics на management-порту
- Тюнинг: пул БД, кэши, JVM/heap
- Обновления мажоров: пиновка, migration notes, blue-green
- Бэкапы и DR: единственный стейт — БД плюс realm как код
- Итог
- Источники
Почему start-dev нельзя в production
Во второй статье мы уже отметили, что start-dev — только для разработки. Теперь разберём, что именно ломается при попытке унести dev-конфиг в бой, и что взамен требует production start.
start-dev осознанно жертвует безопасностью ради удобства:
- HTTP без TLS разрешён — трафик к IdP, включая пароли на форме логина и токены, идёт открытым текстом;
hostname-strictвыключен — issuer собирается из заголовкаHostзапроса, чем можно манипулировать;- кэши в памяти, без кластеризации — сессии живут в одной ноде, масштабировать на несколько реплик нельзя;
- автоматическая пересборка конфигурации и тем на каждый старт — предсказуемый быстрый запуск приносится в жертву гибкости.
Production start разворачивает эти умолчания в обратную сторону. Тут стоит различать два уровня требований: без чего start вообще не поднимется — и без чего deployment нельзя считать production-ready.
Без этого start не стартует:
KC_HOSTNAME— реальный внешний адрес (у нас на стендеhttps://localhost:8443). По нему строятсяissтокенов иredirect_uri; без валидного hostnamestartне поднимется.- TLS — либо собственный HTTPS реплики (
KC_HTTPS_CERTIFICATE_FILE/KC_HTTPS_CERTIFICATE_KEY_FILE), либо работа за reverse-proxy, терминирующим TLS, — тогдаKC_PROXY_HEADERS=xforwarded, чтобы Keycloak доверялX-Forwarded-*.
Без этого стартует, но production-ready не считается:
KC_DB— настроенный внешний PostgreSQL. Формально без негоstartподнимется на встроенной dev-file БД, но она deprecated и непригодна для production (одиночный файл, без реальной HA и бэкапа) — в проде внешний PostgreSQL обязателен.- распределённый кэш —
KC_CACHE=ispn(Infinispan). Это уже production-дефолт режимаstart; на стенде мы задаём его явно для наглядности, но специально «включать» его не требуется.
Ключевая мысль: production-режим — это не «тот же Keycloak с флагом», а другой контракт запуска. Он заставляет вас принять решения по TLS, hostname, БД и кэшу до старта, а не откладывать их «на потом». Именно поэтому dev-конфиг нельзя «дотюнить» в прод — его нужно собрать заново, что мы и делаем в отдельном docker-compose.prod.yml.
Оптимизированный образ: kc.sh build + start –optimized
Keycloak на Quarkus разделяет конфигурацию на два класса: build-time (тип БД, движок кэша, включённость health/metrics — то, что меняет структуру приложения) и run-time (адреса, креды, hostname). Build-time опции применяются командой kc.sh build, которая «запекает» аугментацию Quarkus в образ. Если этого не сделать, Keycloak выполняет неявный build при каждом старте — медленно и непредсказуемо.
Production-паттерн — собрать оптимизированный образ заранее, двухстадийной сборкой, и стартовать с флагом --optimized (пропустить build, использовать запечённую конфигурацию):
ARG KC_VERSION=26.7.0

FROM quay.io/keycloak/keycloak:${KC_VERSION} AS build
# build-time опции: БД postgres, кэш ispn (distributed Infinispan),
# health и metrics включены. Аугментация Quarkus «запекается» в образ.
RUN /opt/keycloak/bin/kc.sh build \
      --db=postgres \
      --cache=ispn \
      --health-enabled=true \
      --metrics-enabled=true

FROM quay.io/keycloak/keycloak:${KC_VERSION}
COPY --from=build /opt/keycloak/ /opt/keycloak/
ENTRYPOINT ["/opt/keycloak/bin/kc.sh"]
Соответственно command реплики в compose — start --optimized, а не start-dev:
x-keycloak-common: &keycloak-common
  build:
    context: ./prod
    dockerfile: Dockerfile
    args:
      KC_VERSION: "26.7.0"
  # start (не start-dev) + --optimized (использовать запечённую сборку) + импорт realm
  command: ["start", "--optimized", "--import-realm"]
  environment: &keycloak-env
    KC_HOSTNAME: https://localhost:8443       # внешний адрес за LB: iss и redirect_uri
    KC_PROXY_HEADERS: xforwarded              # доверяем X-Forwarded-* от nginx
    KC_HTTPS_CERTIFICATE_FILE: /opt/keycloak/certs/keycloak.crt.pem
    KC_HTTPS_CERTIFICATE_KEY_FILE: /opt/keycloak/certs/keycloak.key.pem
    KC_DB: postgres
    KC_DB_URL: jdbc:postgresql://postgres:5432/keycloak
    KC_DB_USERNAME: keycloak
    KC_DB_PASSWORD: keycloak                  # demo-only, в проде — из секрет-менеджера
    KC_HEALTH_ENABLED: "true"
    KC_METRICS_ENABLED: "true"
    KC_CACHE: ispn                            # distributed Infinispan (запечён на build)
Пиновка версии здесь — не формальность, а часть production-дисциплины. Тег 26.7.0 зафиксирован и в build-args образа, и совпадает с dev-стендом. Поведение Keycloak меняется между мажорами (переход на Quarkus, удаление legacy, изменения SPI и тем), поэтому latest в проде — прямой путь к сюрпризу при очередном автоматическом обновлении. Про сами обновления — отдельный раздел ниже.
Секреты (KC_BOOTSTRAP_ADMIN_PASSWORD, KC_DB_PASSWORD, ключи подписи) на стенде — demo-only в открытом виде; в бою они живут в хранилище секретов (например, Vault), а не в env compose-файла.
Внешний PostgreSQL как единственный стейт
Мы повторяли это в каждой статье серии, но в production-контексте тезис приобретает практический вес — с одной честной оговоркой (о ней сразу после списка): весь долговечный стейт Keycloak — в PostgreSQL. База хранит:
- пользователей — учётки, хэши паролей, атрибуты, привязки внешних аккаунтов (federated identity);
- конфигурацию realm — клиенты, роли, группы, protocol mappers, identity providers, темы realm;
- ключи подписи — приватные ключи realm, которыми подписываются JWT (те самые, что бэкенд проверяет по JWKS из третьей статьи);
- таблицу JDBC_PING — служебную таблицу, через которую реплики находят друг друга в кластере (о ней — ниже).
Сам процесс Keycloak по долговечным данным stateless. Тут важная оговорка, без которой тезис «весь стейт в базе» звучит слишком абсолютно: в Keycloak 26 пользовательские сессии по умолчанию персистентны — их источник истины PostgreSQL, а Infinispan лишь кэширует их для скорости (сессия подгружается в кэш по необходимости). Но не весь runtime-стейт живёт в базе: незавершённые authentication flows, счётчики неудачных логинов (brute-force detection) и часть краткоживущего состояния держатся только в кэшах и теряются при остановке всего кластера — это прямо отмечено в Keycloak Upgrading Guide. Практически это не страшно (потерять «наполовину введённый логин» при полном рестарте кластера — не катастрофа), но формулировка честная: PostgreSQL — единственный источник долговечного бизнес-состояния, а не всего runtime-стейта процесса. Всё, что нельзя воссоздать — пользователи, ключи, привязки, конфигурация, персистентные сессии, — в базе. Отсюда два свойства. Первое — реплики масштабируются горизонтально: добавить ноду = поднять ещё один контейнер с тем же KC_DB. Второе — единственная точка долговечных данных, которую нельзя потерять, — это база. Потеря процесса Keycloak переживается рестартом; потеря PostgreSQL — потеря пользователей, ключей и конфигурации. Отсюда прямое следствие: стратегия бэкапов и DR для Keycloak — это стратегия бэкапов для одной PostgreSQL (см. раздел про бэкапы).
Отдельно про миграции схемы. При обновлении Keycloak на новый мажор структура таблиц может измениться. По умолчанию Keycloak при старте сам применяет миграцию схемы; поведением управляет SPI-опция --spi-connections-jpa--quarkus--migration-strategy (значения update — применить, по умолчанию; manual — только сгенерировать SQL, чтобы DBA применил вручную; validate — проверить и упасть, если схема не совпадает). В проде это осознанный момент: миграцию выполняет первая поднимающаяся нода нового мажора, и откатить её «на месте» нельзя (схема уже изменена) — поэтому перед мажорным апгрейдом снимают бэкап БД и обкатывают миграцию на копии, а для крупных установок часто ставят manual, чтобы применить миграционный SQL под контролем. Пул соединений к базе (KC_DB_POOL_*) — параметр тюнинга, к нему вернёмся в разделе про тюнинг.
HA и кластеризация: две реплики, Infinispan, JDBC_PING
Одна реплика Keycloak — единая точка отказа: она падает, и не может войти никто. Production-минимум — две и более реплики за балансировщиком. Но реплики — не просто копии за round-robin: пользовательская SSO-сессия, созданная на одной ноде, должна быть видна на другой, иначе балансировщик, перекинувший следующий запрос на «чужую» реплику, разлогинит пользователя.
Сразу честная граница того, что здесь сделано. Две реплики убирают SPOF вычислительного слоя Keycloak — это и демонстрирует стенд. Но полная HA-топология Keycloak — это ещё два обязательных блока, которых на стенде нет и которые тут одиночные, то есть сами являются точками отказа: база данных (в стенде — один PostgreSQL; для настоящей HA нужна реплицированная/отказоустойчивая БД — Patroni, Stolon, облачный managed-PG с failover) и внешний балансировщик (в стенде — один nginx; в проде перед ним нужен отказоустойчивый L4/L7 — пара с keepalived/VRRP, облачный LB или anycast). То есть корректно называть показанное «кластеризацией Keycloak и отказоустойчивостью его вычислительного слоя», а не «полной HA». HA БД и LB — осознанно вне рамок стенда (каждый — тема отдельного разговора); официальная HA-архитектура Keycloak рассматривает реплицированную БД и отдельный отказоустойчивый балансировщик как обязательные блоки.
За это отвечает Infinispan — встроенный распределённый кэш Keycloak. В режиме start (и с KC_CACHE=ispn) кэши сессий (sessions, clientSessions, offlineSessions) — distributed: запись реплицируется между нодами, и сессия доступна на любой реплике кластера. Чтобы ноды образовали кластер, им нужно найти друг друга — это задача discovery слоя JGroups.
Здесь важное упрощение, которое принёс Keycloak 26.1: discovery по умолчанию — JDBC_PING. Раньше кластеризация требовала настройки JGroups-стека (multicast, TCPPING со списком адресов, JGroups-порты между контейнерами). Теперь ноды находят друг друга через таблицу в той же базе PostgreSQL, которая и так единственный стейт: каждая нода пишет туда свой адрес, читает адреса остальных и поднимает канал. Никаких JGroups-портов наружу, никакого multicast, никакой отдельной конфигурации — на стенде discovery завёлся «из коробки», без единой доп. настройки. Более того, Keycloak автоматически поднял mTLS для JGroups-канала — межнодовый трафик кластера шифруется и аутентифицируется без ручной настройки.
HTTPS :8443"] --> LB["nginx L7-LB
TLS-offload"] LB -->|"HTTP :8080
X-Forwarded-Proto=https"| K1["Keycloak реплика 1
start --optimized"] LB -->|"HTTP :8080"| K2["Keycloak реплика 2
start --optimized"] K1 <-->|"Infinispan / JGroups (mTLS)
кластерный канал"| K2 K1 --> PG[("PostgreSQL
долговечный стейт
+ таблица JDBC_PING")] K2 --> PG
flowchart TD
  C["Клиент
HTTPS :8443"] --> LB["nginx L7-LB
TLS-offload"]
  LB -->|"HTTP :8080
X-Forwarded-Proto=https"| K1["Keycloak реплика 1
start --optimized"]
  LB -->|"HTTP :8080"| K2["Keycloak реплика 2
start --optimized"]
  K1 <-->|"Infinispan / JGroups (mTLS)
кластерный канал"| K2
  K1 --> PG[("PostgreSQL
долговечный стейт
+ таблица JDBC_PING")]
  K2 --> PG
Порядок старта реплик задан через depends_on — вторая ждёт, пока первая станет healthy:
keycloak-1:
    <<: *keycloak-common
    container_name: kc-prod-1
    depends_on:
      postgres:
        condition: service_healthy

  keycloak-2:
    <<: *keycloak-common
    container_name: kc-prod-2
    depends_on:
      postgres:
        condition: service_healthy
      keycloak-1:
        condition: service_healthy   # ждёт первую: сериализует --import-realm и старт канала
Это решает две задачи разом. Первая — сериализация первичного импорта: --import-realm стоит у обеих реплик, но realm заводится один раз; вторая нода, стартовав после первой, увидит существующий realm и залогирует Realm 'demo' already exists. Import skipped. Вторая — первая нода первой поднимает Infinispan-канал, к которому вторая затем присоединяется, а не наоборот.
Кластер вживую: 2-member ISPN view
Что discovery и кластер реально работают — видно в логах обеих реплик. При старте каждая нода логирует включение JDBC_PING и шифрования канала:
JGroups JDBC_PING discovery enabled.
JGroups Encryption enabled (mTLS).
Starting JGroups channel `ISPN` with stack `jdbc-ping`
Ключевое доказательство кластеризации — cluster view с двумя членами. После присоединения второй ноды Infinispan логирует новый вид канала (ISPN000094), и в нём — оба узла ((2) = два члена):
ISPN000094: Received new cluster view for channel ISPN:
  [c68074afe4a7-58653(v=16.0.12)|1] (2)
  [c68074afe4a7-58653(v=16.0.12), 2ed1085948de-32137(v=16.0.12)]
На первой ноде картина симметричная: сначала view с одним членом ((1), пока она одна), затем — тот же двухчленный view после присоединения второй. Это и есть поведение при рестарте узла: упавшая нода после подъёма снова регистрируется в таблице JDBC_PING, находит живого соседа и присоединяется к каналу; view пересчитывается, distributed-кэш ребалансируется. Пользователи, чьи сессии лежали в кэше живой ноды, входа не теряют.
Распределённая сессия: login на одной, refresh на другой
Двух-членный view доказывает, что ноды в кластере, но не что сессия доступна на обеих. Это проверяется отдельным сценарием, и он — сердцевина HA-части. На стенде реплики доступны напрямую, в обход балансировщика, по их собственному HTTPS (KC_HTTPS_*): реплика 1 — https://localhost:8491, реплика 2 — https://localhost:8492. Сценарий прямолинейный: залогиниться на реплике-1, а refresh и userinfo сделать на реплике-2. Успех на другой ноде означает, что сессия, созданная первой нодой, доступна второй — а это ровно то операционное свойство, ради которого нужен кластер за не-sticky балансировщиком.
Реальный вывод прогона (пользователь bob, роли user + admin):
STEP 1: login на REPLICA-1 (https://localhost:8491, scope=openid)
  -> SSO session_state=nBR5YY0FKDYBRioQ3TLdex9r
     access_token: iss=https://localhost:8443/realms/demo, sub=e4ddfce6-...,
     preferred_username=bob,
     realm_access.roles=[offline_access, admin, uma_authorization,
                         default-roles-demo, user]

STEP 2: REFRESH этого токена на REPLICA-2 (https://localhost:8492)
  -> HTTP 200 — реплика-2 выдала НОВЫЙ access_token + refresh_token,
     expires_in=300  (сессия найдена в общем кэше на второй ноде)

STEP 3: userinfo на REPLICA-2 токеном, выпущенным REPLICA-1
  -> HTTP 200: {"sub":"e4ddfce6-...","name":"Bob Demo",
                "preferred_username":"bob","email":"bob@demo.local"}
Разберём, что именно это доказывает — и что нет. refresh_token grant требует, чтобы обрабатывающая нода видела user-SSO-сессию. Реплика-2 сессию bob сама не создавала — её создала реплика-1 на STEP 1. Тем не менее refresh на реплике-2 вернул HTTP 200 и выдал новую пару токенов (expires_in=300 — те самые 5 минут accessTokenLifespan из второй статьи), а userinfo на реплике-2 токеном, выписанным репликой-1, тоже вернул 200 с профилем. Значит сессия, созданная на одной ноде, полноценно обслужена другой — и refresh, и userinfo. Это подтверждает межнодовую непрерывность сессии — то, что и требуется от кластера.
Чего этот сценарий не доказывает — что сессия дошла до реплики-2 именно через Infinispan-репликацию. В Keycloak 26 пользовательские сессии по умолчанию персистентны (источник истины — PostgreSQL), поэтому реплика-2 могла и подгрузить сессию из общей базы в свой кэш, а не получить её репликацией по JGroups. Для HA это различие не принципиально — важен результат «любая нода обслуживает любую сессию», а достигается он и общим кэшем, и общей БД. Но честно: доказана непрерывность, а не конкретный механизм. Обратите внимание: iss в токене — https://localhost:8443/realms/demo (внешний адрес за LB из KC_HOSTNAME), хотя запрос шёл на порт конкретной реплики; issuer стабилен независимо от того, какая нода обслужила запрос.
Отсюда практический вывод про sticky vs stateless-балансировку. Раз сессия распределена, балансировщику не обязательно быть sticky (привязывать клиента к одной ноде): любой запрос корректно обслужит любая реплика. Sticky-режим (ip_hash в nginx или cookie-affinity) в проде используют для локальности — чтобы чаще попадать на ноду, где сессия уже «горячая» в кэше, снижая межнодовый трафик, — но это оптимизация, а не требование корректности. С distributed-кэшем система остаётся правильной и при чистом round-robin.
Балансировщик и TLS: offload против re-encrypt
Перед репликами стоит nginx как L7-балансировщик. Его роль двойная: терминировать клиентский TLS и раздавать запросы по репликам. На стенде выбрана схема TLS-offload — каноничный паттерн «Keycloak за reverse-proxy»:
upstream keycloak_cluster {
    server keycloak-1:8080 max_fails=3 fail_timeout=10s;
    server keycloak-2:8080 max_fails=3 fail_timeout=10s;
    # ip_hash;   # раскомментировать для sticky-балансировки по клиентскому IP
}

server {
    listen 8443 ssl;
    http2 on;
    ssl_certificate     /etc/nginx/certs/keycloak.crt.pem;
    ssl_certificate_key /etc/nginx/certs/keycloak.key.pem;

    location / {
        proxy_pass http://keycloak_cluster;                 # HTTP в доверенной сети
        proxy_set_header Host              $host:8443;
        proxy_set_header X-Forwarded-Proto https;           # Keycloak доверяет через
        proxy_set_header X-Forwarded-Host  $host:8443;      # KC_PROXY_HEADERS=xforwarded
        proxy_set_header X-Forwarded-Port  8443;
        add_header X-Upstream $upstream_addr always;        # видно, какая реплика обслужила
    }
}
Клиент приходит на HTTPS :8443, nginx терминирует TLS и проксирует на keycloak-N:8080 по HTTP внутри доверенной docker-сети. Keycloak доверяет заголовкам X-Forwarded-* (через KC_PROXY_HEADERS=xforwarded) и строит iss/redirect_uri по KC_HOSTNAME=https://localhost:8443, хотя сам запрос дошёл до него по http. Это и объясняет iss=https://localhost:8443/... в токене выше.
Тонкость, пойманная на стенде: первоначально LB настраивался на re-encrypt — HTTPS от nginx к keycloak:8443 (собственный HTTPS реплики). Quarkus-listener Keycloak рвал этот handshake с ошибкой SSL alert number 47 (illegal_parameter) → клиент получал 502. Переключение на TLS-offload (nginx терминирует, дальше HTTP) проблему сняло — и это к тому же стандартнее: TLS терминируется на границе, внутри приватной сети — обычный HTTP. При этом собственный HTTPS реплик (KC_HTTPS_*, порт 8443) не остался «мёртвым» — именно по нему шёл прямой доступ к репликам в тесте распределённой сессии выше.
Что балансировка реально round-robin по обеим нодам — видно по заголовку X-Upstream (nginx отдаёт наружу адрес обслужившей реплики). 8 запросов через LB:
4 x  X-Upstream: 172.22.0.3:8080   (реплика 1)
4 x  X-Upstream: 172.22.0.4:8080   (реплика 2)
Ровно 4/4. Оговорка стенда: в конфиге worker_processes 1 — иначе у каждого nginx-worker свой счётчик round-robin, и при одном запросе на соединение балансировка «залипает» на первой реплике; в реальном проде — worker_processes auto, где нагрузка на многих соединениях распределяется статистически ровно. Весь трафик к IdP обязан идти по TLS с корректным hostname — фундамент рукопожатия и сертификатов разбирает отдельная статья.
Наблюдаемость: /metrics на management-порту
Keycloak — критичный сервис, и его деградацию нужно видеть по приборам, а не по жалобам пользователей. Health и метрики отдаются на отдельном management-порту 9000, не на публичном auth-порту — намеренно, чтобы /health и /metrics не торчали наружу вместе с формой логина. В проде порт 9000 не публикуется: его скрейпит Prometheus и дёргают health-пробы изнутри.
Здесь — тонкость, из-за которой на стенде реплики сначала не становились healthy. При включённом KC_HTTPS_* management-интерфейс наследовал HTTPS и поднимался на https://0.0.0.0:9000, а healthcheck через bash /dev/tcp (без TLS) не мог с ним говорить. Решение — принудительно задать HTTP на management-порту:
KC_HTTP_ENABLED: "true"
    KC_HTTP_MANAGEMENT_PORT: "9000"
    # иначе при KC_HTTPS_* management поднимается по HTTPS и healthcheck /dev/tcp не проходит
    KC_HTTP_MANAGEMENT_SCHEME: http
После фикса лог показывает Management interface listening on http://0.0.0.0:9000, и healthcheck зеленеет. Метрики отдаёт GET /metrics (формат Prometheus/Micrometer). На стенде оба узла на /metrics возвращают HTTP 200 (~176 КБ текста). Срез с реплики-1:
jvm_memory_used_bytes{area="heap",id="G1 Survivor Space"} 8975848.0
jvm_threads_live_threads 50.0
process_uptime_seconds 1182.298

# кэши Infinispan видны в метриках — в т.ч. distributed-кэши сессий:
vendor_statistics_current_number_of_entries_in_memory{cache="users",...}  2.0
vendor_statistics_current_number_of_entries_in_memory{cache="realms",...} 40.0
vendor_statistics_..._entries_in_memory{cache="sessions",...}
vendor_statistics_..._entries_in_memory{cache="clientSessions",...}
vendor_statistics_..._entries_in_memory{cache="offlineSessions",...}

# http_server_requests_* — 15 строк: per-endpoint latency и счётчики
http_server_requests_seconds_count{method="POST",uri="/realms/{realm}/protocol/openid-connect/token",...}
Что из этого стоит выводить в дашборд и алерты:
- логины и токены —
http_server_requests_*поuritoken-эндпоинта: rate успешных выдач, доля ошибок, latency. Важная оговорка про latency: по умолчанию это метрика-summary с_count/_sum/_max— из них считаются rate, доля ошибок, средняя (sum/count) и максимум, но НЕ перцентили: histogram buckets Keycloak из коробки не отдаёт, поэтому p50/p99 требуют отдельно включить бакеты (Micrometer distribution/percentiles-histogramдля нужных метрик). Всплеск ошибок на token endpoint = деградация входа для всех. - сессии —
vendor_statistics_*по кэшамsessions/clientSessions/offlineSessions: число записей растёт с активными пользователями; резкий обрыв на одной ноде при живой второй — сигнал проблемы репликации. - JVM —
jvm_memory_used_bytes{area="heap"},jvm_threads_live_threads, GC-паузы: heap под потолком и растущий GC — предвестники деградации (тюнинг — ниже). - health —
/health/readyи/health/liveдля liveness/readiness-проб оркестратора.
Метрики Keycloak удобно ложатся на модель RED (Rate, Errors, Duration) для token-эндпоинтов; как строить дашборды и алерты по RED/USE и бизнес-метрикам — отдельная статья про Prometheus. Keycloak инструментирован из коробки — включить --metrics-enabled=true (мы это сделали на build-стадии) и подключить скрейп.
Тюнинг: пул БД, кэши, JVM/heap
Дефолты Keycloak разумны для среднего случая, но под нагрузку три класса параметров стоит держать в голове.
Пул соединений к БД. Каждая реплика держит свой пул к PostgreSQL. Управляется KC_DB_POOL_INITIAL_SIZE / KC_DB_POOL_MIN_SIZE / KC_DB_POOL_MAX_SIZE (по умолчанию max — 100 на реплику). Тонкость масштабирования: суммарное число соединений = max_size × число реплик, и оно не должно превысить max_connections самого PostgreSQL. Две реплики по 100 — это уже до 200 соединений к базе; при добавлении нод пул на реплику уменьшают или ставят перед БД пулер (PgBouncer). Слишком маленький пул — очередь запросов и рост latency token-эндпоинта; слишком большой — исчерпание соединений базы.
Кэши Infinispan. У distributed-кэшей есть число владельцев (owners) каждой записи. Важная тонкость Keycloak 26: при персистентных сессиях (дефолт) кэши пользовательских сессий держат одного owner — устойчивость к падению ноды даёт не вторая копия в памяти, а PostgreSQL как источник истины (упавшую запись любая нода перечитает из базы). Параметр owners существен для остальных distributed-кэшей, у которых нет бэкапа в БД: там больше owners — выше отказоустойчивость ценой памяти и межнодового трафика. То есть «дефолт 2 переживает падение ноды за счёт второй копии» — это про не-сессионные кэши, а не про сессии. Размеры и стратегии вытеснения кэшей users/realms/authorizationCache настраиваются в Infinispan-конфиге, если профиль нагрузки требует.
JVM/heap. Keycloak на Quarkus по умолчанию берёт долю памяти контейнера под heap (-XX:MaxRAMPercentage, порядка 70%). В контейнере важно задать лимит памяти и убедиться, что heap-доля оставляет запас на off-heap (metaspace, потоки, direct-буферы). На стенде /metrics показывал живой heap (G1 GC, 50 потоков) — в проде за этими цифрами следят: heap у потолка и растущие GC-паузы означают, что реплике нужно больше памяти либо горизонтальное масштабирование. Правило простое: сначала измерить по /metrics под реальной нагрузкой, потом крутить — не наугад.
Обновления мажоров: пиновка, migration notes, blue-green
Самая недооценённая часть эксплуатации Keycloak — обновления. Проект релизится часто и между мажорами меняет поведение: переход на Quarkus (в своё время сломавший всю старую WildFly-конфигурацию), удаление legacy-фич, изменения SPI и структуры тем, иногда — миграция схемы БД. Обновление Keycloak — не docker pull, а процедура. Дисциплина, которая делает её предсказуемой:
- Пиновка версии. Точный тег (
26.7.0), а неlatestили плавающий26. Обновление — осознанный шаг со сменой тега, а не побочный эффект передеплоя. Это мы заложили ещё в образ. - Чтение migration notes / release notes целевого мажора до обновления: что удалено, что задепрекейчено, какие настройки переименованы, есть ли миграция схемы. Между мажорами это почти всегда нетривиально.
- Тест на realm-экспорте. Realm держится как код (
kc.sh export→ JSON в Git →--import-realm). Перед апгрейдом realm-экспорт прогоняют на новой версии в тестовом окружении: импортируется ли он без ошибок, не сломались ли клиенты/мапперы/флоу. Realm-as-code превращает проверку совместимости в воспроизводимый тест, а не в ручную сверку в админке. - Бэкап БД перед миграцией схемы. Если новый мажор мигрирует схему, миграция необратима «на месте» — поэтому снимок базы снимается до, а сама миграция сначала обкатывается на копии.
- Rolling update — только внутри одной ветки. Обновление без простоя (по одной ноде, старая и новая версии в кластере одновременно) Keycloak официально поддерживает лишь между patch-релизами одного минора (например,
26.7.0 → 26.7.3) — там схема БД не меняется и старая с новой совместимы. Для мажорного/минорного апгрейда так делать нельзя: как только первая нода нового мажора мигрирует схему, старые ноды на этой же базе работать уже не смогут (схема несовместима). Официальный порядок мажора — остановить все старые ноды, поднять новые (они мигрируют схему на старте). Это означает окно недоступности (или отдельный контур), а не бесшовный rolling. - Откат мажора — из бэкапа, а не «переключением балансировщика». Раз миграцию схемы «на месте» не отменить, откат неудачного мажора — это восстановление предыдущей версии Keycloak И базы из снятого до апгрейда бэкапа. Держать старый мажор «наготове» на той же, уже мигрированной базе — не рабочий план отката.
- Blue-green — только на ОТДЕЛЬНОЙ базе. Настоящий blue-green для мажора: развернуть новый контур на копии базы (не на боевой!), мигрировать и проверить её, затем переключить трафик; «синий» контур со своей старой базой остаётся точкой отката. Ключевое отличие от неверной схемы — новый мажор мигрирует не ту базу, что обслуживает старый, иначе откат ломается вместе со схемой.
На стенде мы намеренно пинуемся к одной версии и апгрейд не прогоняем — фабриковать «живое обновление мажора» было бы нечестно. Но вся инфраструктура для безопасного апгрейда у нас уже есть: пиновка в образе, realm как код, внешняя БД, из которой снимается бэкап, и топология из двух реплик, допускающая blue-green.
Бэкапы и DR: единственный стейт — БД плюс realm как код
Стратегия бэкапов Keycloak прямо следует из раздела про БД: раз весь долговечный стейт — в одной PostgreSQL, то бэкап Keycloak = бэкап этой базы. Два уровня защиты, взаимодополняющих:
- Бэкап PostgreSQL — обязательный, полный. Регулярный
pg_dump(или физический бэкап / PITR через WAL для больших установок) базыkeycloak. Это единственный источник, где лежат пользователи, хэши паролей, привязки внешних аккаунтов и приватные ключи подписи realm — то, что нельзя восстановить из конфигурации. Бэкап без проверенного восстановления — не бэкап: восстановление на чистый экземпляр прогоняют регулярно. - Realm-экспорт как код — конфигурация (и, при желании, пользователи).
kc.sh exportдаёт JSON с клиентами, ролями, мапперами, флоу, темами realm; с флагом--users realm_file(как в стенде) в него попадают и пользователи с хэшами паролей. Он лежит в Git, ревьюится, разворачивается--import-realm. Но realm-экспорт не заменяет бэкап БД: он не содержит runtime-стейта — активных сессий, событий/audit, отозванных токенов, — а при экспорте конфигурации без--usersв нём нет и живых пользователей. Плюс секреты клиентов при публикации выносят в плейсхолдеры. Так что экспорт — это декларативное восстановление структуры realm и быстрый способ поднять идентичное окружение, а полноту (пользователи + история) закрывает бэкап PostgreSQL.
Отсюда — два сценария DR, под разные катастрофы:
Потеря процесса Keycloak (реплика упала):
  реплики stateless по данным -> рестарт/новая нода с тем же KC_DB
  -> присоединяется к кластеру (JDBC_PING) -> сессии в distributed-кэше
  живой ноды сохранены. Вход не теряется.

Потеря/повреждение PostgreSQL (катастрофа):
  1. восстановить БД из бэкапа (pg_restore / PITR)
  2. поднять реплики с тем же KC_DB
  -> пользователи, ключи, конфигурация вернулись из базы.
  (realm-as-code — для чистого пересоздания структуры realm с нуля)
И это на стенде не только описано, но и прогнано — потому что «бэкап без проверенного восстановления не бэкап» относится и к учебному стенду. Скрипт scripts/backup-restore.sh выполняет полный цикл end-to-end: снимает pg_dump живой базы, затем down -v (удаление тома — имитация потери БД), поднимает чистый PostgreSQL, восстанавливает дамп и проверяет, что реально вернулось:
pg_dump keycloak                    -> дамп 343 KiB (351 717 байт)
down -v (потеря тома)               -> чистый PostgreSQL: 0 таблиц
restore из дампа (ON_ERROR_STOP=1)  -> 100 таблиц; psql без единой ошибки
проверки после restore:
  realm demo                        -> присутствует (kcadm get realms/demo)
  пользователь "canary"             -> на месте (заводили ДО бэкапа, нет в realm-JSON)
  подписной kid в JWKS              -> тот же, что до бэкапа (WNprIoSV…3r8)
  материал ключа (RSA-модуль n)     -> совпал байт-в-байт до и после restore
                                       => это ТОТ ЖЕ ключ, не новый под тем же kid
  СТАРЫЙ токен (выдан ДО аварии)     -> userinfo HTTP 200 после restore
                                       => неистёкший токен остаётся валиден
  новый токен bob                   -> HTTP 200
Проверка предметная. Восстановились не только таблицы, но и пользователи (тестовый canary, заведённый до бэкапа — его нет в realm-экспорте, значит прийти он мог только из дампа) и приватные ключи подписи realm. Причём ключи проверены не косвенно («токен выдался»), а на уровне материала ключа: и kid, и сам RSA-модуль n подписного ключа из JWKS после восстановления совпадают с теми, что были до бэкапа (kid=WNprIoSV…3r8), байт-в-байт — то есть это буквально тот же ключ, а не новый под тем же идентификатором. Keycloak не сгенерировал ключи заново, а поднял прежние из базы. И это проверено не на словах: скрипт сохраняет access-token, выданный до аварии, и после восстановления предъявляет именно его на userinfo — тот отвечает HTTP 200. То есть неистёкший токен, подписанный до аварии, остаётся криптографически валидным и принимается восстановленным Keycloak (подпись сходится на восстановленных ключах, а сессия персистентна и вернулась из дампа). Оговорка честная — «неистёкший»: время жизни токена никто не продлевает, за exp он умрёт, как и в норме.
Важная оговорка про границы. Дамп PostgreSQL восстанавливает данные Keycloak — realm, пользователей, ключи, привязки, стейт сессий и событий, — но не весь контур. В нём нет самого образа и версии Keycloak, кастомных provider-JAR, тем логина, TLS-сертификатов, конфигурации reverse-proxy и deployment-секретов (env). «Весь стейт — в PostgreSQL» означает, что в базе лежат все невосстановимые иначе данные; но чтобы поднять сервис с нуля, к дампу нужен ещё и воспроизводимый деплой — образ нужной версии, конфиг, секреты, артефакты тем и провайдеров (обычно docker-compose.prod.yml / чарт в Git плюс секрет-менеджер). Бэкап БД закрывает слой данных, деплой-как-код — слой окружения; DR-план держит оба.
Разница между сценариями и есть суть архитектуры: потеря вычислительного слоя переживается тривиально, потеря слоя данных — только из бэкапа. Поэтому вся серьёзность DR-плана Keycloak сосредоточена на PostgreSQL. Секреты и ключи, попадающие в бэкап, — предмет работы с секретами: бэкап базы содержит приватные ключи подписи, и защищать его нужно соответственно.
Итог
- Production
start— другой контракт запуска, не «dev с флагом». Без явныхKC_HOSTNAMEи TLS (или reverse-proxy +KC_PROXY_HEADERS) он не стартует. Внешняя БД иispn— требования production-готовности, а не старта: формальноstartподнимется на встроенной dev-file БД, но она deprecated и непригодна для прода, аispn— и так production-дефолт. Dev-конфиг в прод не переносится — собирается заново (docker-compose.prod.yml). - Оптимизированный образ.
kc.sh buildзапекает build-time опции (--db=postgres --cache=ispn --health/metrics-enabled), реплика стартуетstart --optimized— быстрый предсказуемый запуск. Версия пинуется точным тегом (26.7.0). - PostgreSQL — единственный источник долговечного стейта. Пользователи, realm, ключи подписи, персистентные сессии (в KC 26 — по умолчанию) и таблица JDBC_PING — в базе; процесс stateless по долговечным данным. Оговорка: часть краткоживущего runtime-стейта (незавершённые флоу, brute-force-счётчики) живёт только в кэшах и теряется при остановке всего кластера. Отсюда: горизонтальное масштабирование тривиально, а вся защита долговечных данных — про эту одну базу.
- Кластеризация вычислительного слоя — две реплики за LB. Infinispan даёт distributed-кэш сессий, discovery — JDBC_PING (дефолт с 26.1, через таблицу в той же БД, mTLS-канал автоматически). Кластер подтверждён 2-member ISPN view; distributed-сессия проверена вживую: login на реплике-1 → refresh + userinfo на реплике-2 = HTTP 200. Sticky-балансировка не обязательна — только для локальности. Честная граница: это HA compute-слоя Keycloak; PostgreSQL и nginx на стенде — одиночные (SPOF), полная HA требует реплицированной БД (Patroni/managed) и отказоустойчивого внешнего LB — осознанно вне стенда.
- TLS-offload, не re-encrypt. nginx терминирует TLS и проксирует HTTP в доверенной сети (
X-Forwarded-Proto=https+KC_PROXY_HEADERS=xforwarded); re-encrypt наkeycloak:8443рвал handshake (alert 47). Балансировка — round-robin 4/4 по обеим нодам. - Наблюдаемость —
/metricsна management-порту 9000. Тонкость: приKC_HTTPS_*management наследует HTTPS — принудительноKC_HTTP_MANAGEMENT_SCHEME=http. Ключевое: latency/ошибки token-эндпоинта (http_server_requests_*), число сессий в кэшах (vendor_statistics_*), JVM heap/threads. Ложится на RED-модель Prometheus. - Тюнинг — по измерениям. Пул БД (
KC_DB_POOL_*, суммарно ≤max_connections), owners не-сессионных distributed-кэшей (сессии в KC 26 персистентны — их устойчивость даёт PostgreSQL, а не второй owner в памяти), heap-доля JVM. Сначала снять/metricsпод нагрузкой, потом крутить. - Обновления — процедура, не
docker pull. Пиновка, чтение migration notes, тест realm-экспорта на новой версии, бэкап БД перед миграцией схемы. Rolling без простоя — только между patch-релизами одного минора; мажор/минор мигрирует схему, поэтому старые ноды на мигрированной базе не работают: официальный порядок — остановить старые, поднять новые, а откат — восстановление старой версии и БД из бэкапа. Настоящий blue-green для мажора — на отдельной копии базы, не на боевой. - Бэкапы и DR — прогнаны, не только описаны. Единственный обязательный бэкап — PostgreSQL (пользователи, ключи, привязки — невосстановимы иначе), плюс realm-as-code для декларативного восстановления структуры. На стенде цикл
pg_dump → потеря тома → restoreпрогнан end-to-end: вернулись realm, пользователи и ключи подписи — совпал иkid, и материал ключа (RSA-модуль) байт-в-байт, а токен, выданный до аварии, после restore принятuserinfo(HTTP 200) — неистёкшие токены остаются валидны. Но дамп восстанавливает данные, не весь контур: образ/версию, темы, provider-JAR, TLS и секреты даёт деплой-как-код. Потеря процесса — рестарт; потеря базы — только из бэкапа.
На этом мини-серия «Готовый IdP: Keycloak на практике» завершена. От решения «свой auth или готовый IdP» — через деплой и модель realm, интеграцию бэкенда и темы с федерацией — до production-эксплуатации. Итоговый вывод тот же, что и в первой статье, но теперь подкреплённый практикой: Keycloak снимает с вас разработку аутентификации и отдаёт взамен эксплуатацию надёжного stateful-сервиса. Для многих команд это выгодный обмен — но обмен, а не подарок, и эта статья была про его цену. Механику самих протоколов, стоящих за токенами Keycloak, разбирает статья про OAuth2 и OIDC; альтернативу «сделай сам» — весь цикл auth.
Источники
- Keycloak — Configuring Keycloak for production: https://www.keycloak.org/server/configuration-production
- Keycloak — Running Keycloak in a container (optimized image,
kc.sh build): https://www.keycloak.org/server/containers - Keycloak — Configuring distributed caches (Infinispan, JDBC_PING): https://www.keycloak.org/server/caching
- Keycloak — Using a reverse proxy (
proxy-headers, hostname): https://www.keycloak.org/server/reverseproxy - Keycloak — Configuring the database (
KC_DB, пул, миграции): https://www.keycloak.org/server/db - Keycloak — Enabling Keycloak Metrics (Micrometer/Prometheus): https://www.keycloak.org/server/configuration-metrics
- Keycloak — Importing and exporting realms: https://www.keycloak.org/server/importExport
- Keycloak — Upgrading Guide (migration notes между мажорами): https://www.keycloak.org/docs/latest/upgrading/
- Infinispan — Cross-site и distributed caches: https://infinispan.org/docs/

Комментарии