
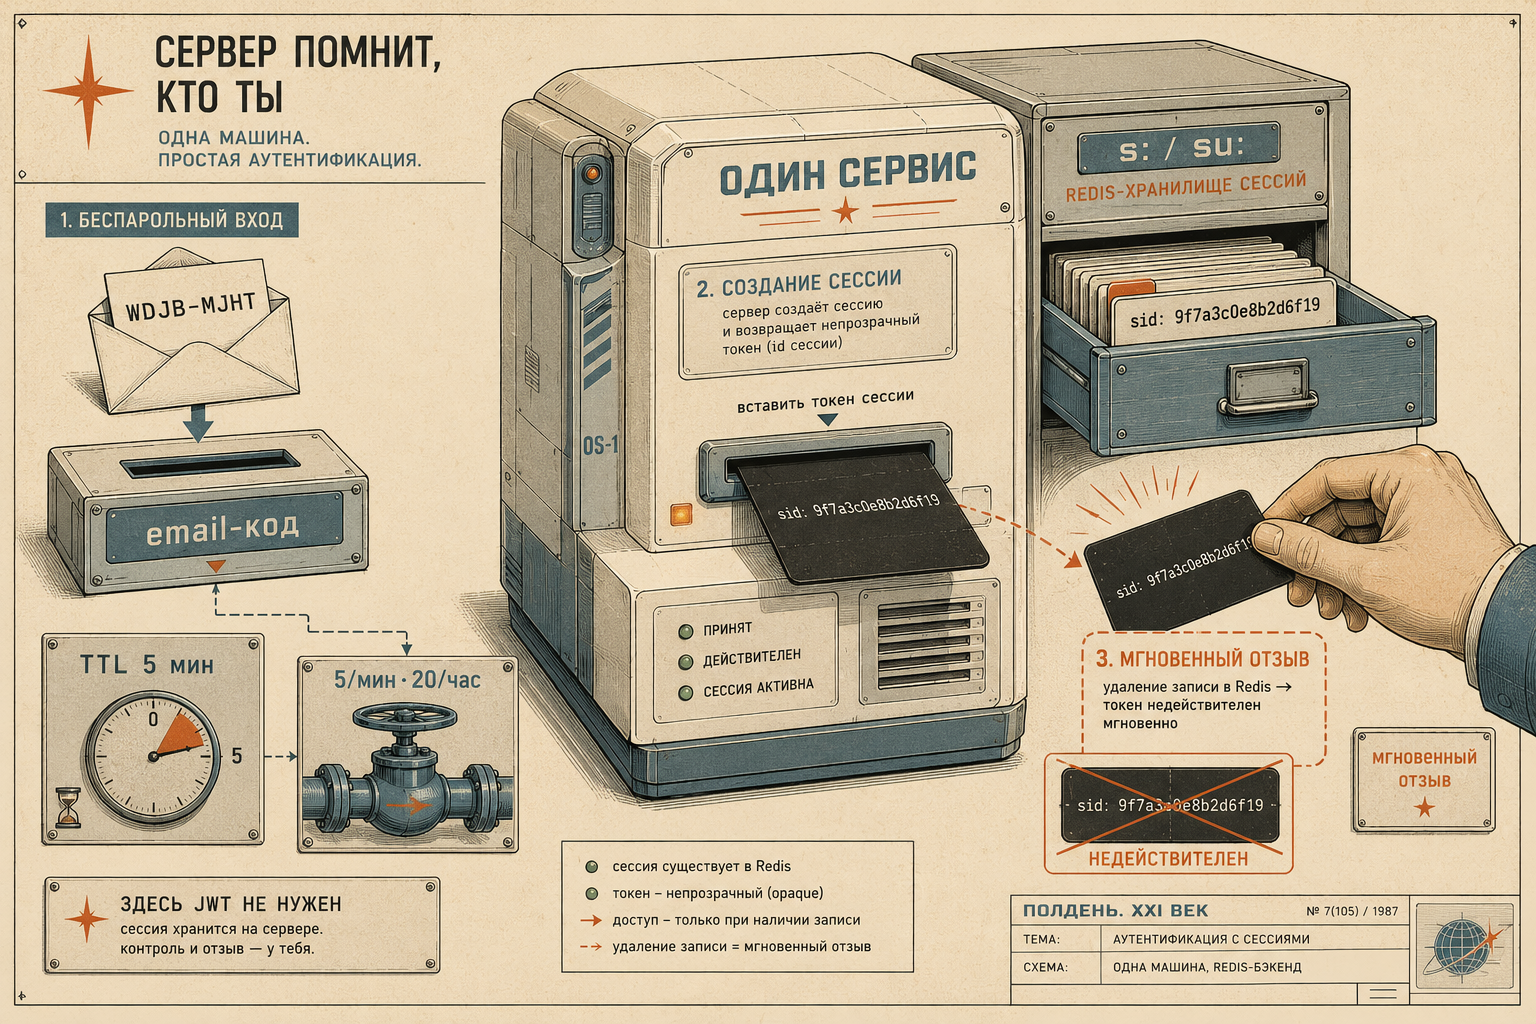
Когда бэкенд один, тащить в него JWT, выделенный auth-сервис и stateless-валидацию — это решать проблему, которой нет. Сервер и так владеет состоянием: пусть он просто помнит сессии. Непрозрачный случайный токен, запись в Redis с TTL — и вся авторизация укладывается в несколько ручек и одно middleware. Отзыв мгновенный, список активных сессий бесплатный, а код читается целиком.
Это вторая статья серии «Авторизация: токены, сессии, refresh». В первой мы разобрали, когда opaque-сессии — правильный выбор. Здесь — рабочий минимальный путь на одном сервисе (обезличенные паттерны из реального проекта system-design-sandbox).
В статье
- Модель данных в Redis
- Вход по email-коду: без паролей
- Сессия как opaque-токен
- Touch last_active без read-modify-write
- Rate-limit и его честная цена
- Список сессий, logout, чужая сессия
- Почему здесь не нужен JWT
- Куда дальше
Модель данных в Redis
Весь стенд (security/auth/single-service) держит состояние в четырёх видах записей, и ни одна из них не пересекается по TTL со «навсегда»:
auth:pending:{email}   HASH    { token, code, attempts }         TTL 5 мин
auth:rl:{email}:min    STRING  счётчик запросов кода за минуту   TTL 60 с
auth:rl:{email}:hour   STRING  счётчик запросов кода за час      TTL 1 ч
s:{sid}                HASH    { uid, cat (created), lat (last-active) }  TTL 168 ч
su:{userID}            SET     { sid, sid, … } — индекс живых сессий пользователя
Ничего из этого не трогает PostgreSQL. Даже userID — не первичный ключ из таблицы пользователей, а детерминированная функция от email:
// userIDFromEmail детерминированно производит userID из email для demo-целей:
// hex(sha256(email))[:16]. В реальной системе это был бы lookup/insert в таблице
// пользователей; здесь — чтобы не тащить БД в demo-стенд.
func userIDFromEmail(email string) string {
	sum := sha256.Sum256([]byte(email))
	return hex.EncodeToString(sum[:])[:16]
}
Это честное упрощение стенда, а не совет «не заводите таблицу пользователей» — в реальном сервисе userIDFromEmail заменяется на SELECT id FROM users WHERE email = $1 (плюс INSERT ... ON CONFLICT при первом входе). Суть демонстрации не в этом: суть в том, что всё, что происходит на каждый запрос — проверка кода, создание сессии, чтение сессии, touch — не задевает Postgres вообще. База нужна была бы только один раз, при первом входе конкретного email, а не на каждый HTTP-запрос.
Вход по email-коду: без паролей
Магической аутентификации — magic code — не нужен пароль, а значит не нужны его хранение, хеширование, сброс по забытому паролю и вся сопутствующая инфраструктура. Взамен — одноразовый код, присланный на email, который пользователь тут же вводит обратно.
SendCode генерирует непрозрачный токен подтверждения и шестисимвольный код, кладёт их в auth:pending:{email} на 5 минут:
func SendCode(ctx context.Context, rdb *redis.Client, email string) error {
	limited, err := checkAndBumpRateLimit(ctx, rdb, email)
	if err != nil {
		return err
	}
	if limited {
		return ErrRateLimited
	}

	tok, err := token.OpaqueHex(32)
	if err != nil {
		return err
	}
	code, err := token.Code()
	if err != nil {
		return err
	}

	pendingKey := "auth:pending:" + email
	pipe := rdb.TxPipeline()
	pipe.HSet(ctx, pendingKey, map[string]interface{}{
		"token":    tok,
		"code":     code,
		"attempts": 0,
	})
	pipe.Expire(ctx, pendingKey, codeTTL)
	_, err = pipe.Exec(ctx)
	return err
}
Код — не случайные ASCII-символы вперемешку, а строка вида XXX-XXX из алфавита ABCDEFGHJKLMNPQRSTUVWXYZ23456789 — специально без 0/O/1/I, чтобы человек, диктующий код по телефону или переписывающий его с экрана, не путал похожие символы:
const charset = "ABCDEFGHJKLMNPQRSTUVWXYZ23456789"

func Code() (string, error) {
	b := make([]byte, 6)
	if _, err := rand.Read(b); err != nil {
		return "", err
	}
	out := make([]byte, 6)
	for i, x := range b {
		out[i] = charset[int(x)%len(charset)]
	}
	return string(out[:3]) + "-" + string(out[3:]), nil
}
Шесть символов из 32-буквенного алфавита — это 32^6 ≈ 1.07 млрд комбинаций, то есть около 30 бит энтропии. Само по себе это не «криптографически много», но код проверяется не оффлайн, а через сеть, с лимитом попыток (см. ниже) — и это единственная причина, по которой такой короткий код вообще безопасен: подбор возможен только пока запись жива (5 минут) и только 5 попыток за это время.
Повторный вызов SendCode для того же email перезаписывает pending-запись — предыдущий код становится недействителен. Это удобно (пользователь может запросить новый код, если первое письмо не дошло), но плата — если письма идут с задержкой, старое письмо в почтовом ящике будет содержать код, который уже не сработает.
VerifyCode — вторая половина. Важная деталь в комментарии к коду: счётчик attempts увеличивается на каждую неудачную попытку, а не только когда код есть в какой-то индексной структуре:
// VerifyCode ... Счётчик attempts инкрементируется на КАЖДУЮ неудачную
// попытку (в т.ч. когда код в принципе не совпадает), что реально ограничивает
// перебор — в отличие от схемы "индекс по присланному коду", где неверный код
// просто не находил ключ и попытка не засчитывалась.
func VerifyCode(ctx context.Context, rdb *redis.Client, email, code string) (string, error) {
	pendingKey := "auth:pending:" + email

	data, err := rdb.HGetAll(ctx, pendingKey).Result()
	if err != nil {
		return "", err
	}
	if len(data) == 0 {
		return "", ErrInvalidCode
	}

	attempts, _ := strconv.Atoi(data["attempts"])
	if attempts >= maxAttempts {
		rdb.Del(ctx, pendingKey)
		return "", ErrTooManyAttempts
	}

	if !token.SafeEqual(code, data["code"]) {
		if err := rdb.HIncrBy(ctx, pendingKey, "attempts", 1).Err(); err != nil {
			return "", err
		}
		return "", ErrInvalidCode
	}

	rdb.Del(ctx, pendingKey)
	return userIDFromEmail(email), nil
}
Это тонкий, но реальный архитектурный выбор: альтернативная наивная схема «индекс auth:code:{email}:{code} → токен» звучит проще, но не считает попытку неудачной, если присланный код просто не совпал ни с одним ключом — а значит перебор всех 32^6 вариантов ничем не ограничен. Здесь же лимит попыток применяется к самому факту вызова VerifyCode, независимо от того, что было предъявлено.
Сравнение кода — token.SafeEqual, обёртка над hmac.Equal:
func SafeEqual(a, b string) bool {
	return hmac.Equal([]byte(NormalizeCode(a)), []byte(NormalizeCode(b)))
}
Обычное == для строк в Go завершается на первом несовпадающем байте — время сравнения зависит от того, сколько начальных символов угаданы верно. Для шестисимвольного кода это не самая критичная утечка (диапазон атаки и так мал), но hmac.Equal — она же timing-safe, константное время сравнения независимо от содержимого — стоит буквально одной обёртки, и это тот случай, когда правильная привычка дешевле объяснения, почему в этом конкретном месте она была не нужна.
При успехе VerifyCode возвращает userID — и на этом этапе в дело вступает сессия.
Сессия как opaque-токен
Как разобрано в первой статье серии, opaque-сессия — это случайная строка без внутренней структуры, указывающая на запись, которую сервер сам создал и которой сам доверяет. CreateSession — короткая функция, которая генерирует sid и кладёт HASH плюс индекс атомарным пайплайном:
const (
	sessionTTL    = 7 * 24 * time.Hour
	touchInterval = 20 * time.Second
)

func CreateSession(ctx context.Context, rdb *redis.Client, userID string) (string, error) {
	sid, err := token.OpaqueHex(16)
	if err != nil {
		return "", err
	}

	now := time.Now().UTC().Format(time.RFC3339)
	sKey := "s:" + sid
	suKey := "su:" + userID

	pipe := rdb.TxPipeline()
	pipe.HSet(ctx, sKey, map[string]interface{}{
		"uid": userID,
		"cat": now,
		"lat": now,
	})
	pipe.Expire(ctx, sKey, sessionTTL)
	pipe.SAdd(ctx, suKey, sid)
	pipe.Expire(ctx, suKey, sessionTTL)
	if _, err := pipe.Exec(ctx); err != nil {
		return "", err
	}

	return sid, nil
}
sid — token.OpaqueHex(16): 16 байт из crypto/rand, 32 hex-символа на выходе, 128 бит энтропии. Этого достаточно, чтобы угадать чужой sid перебором было практически невозможно — в отличие от шестисимвольного magic-кода, здесь пространство перебора не 30, а 128 бит, и лимита попыток тут не нужно: атака подбором sid нерентабельна сама по себе.
Sid уезжает клиенту в httpOnly cookie:
func (h *authHandler) setSessionCookie(w http.ResponseWriter, r *http.Request, sid string) {
	http.SetCookie(w, &http.Cookie{
		Name:     sessionCookieName,
		Value:    sid,
		Path:     "/",
		HttpOnly: true,
		Secure:   h.secureCookies || r.TLS != nil,
		SameSite: http.SameSiteStrictMode,
		MaxAge:   int(sessionTTL.Seconds()),
	})
}
А проверка на каждый защищённый запрос — middleware RequireAuth, которое читает cookie, валидирует sid через Redis и кладёт userID в контекст:
func (h *authHandler) RequireAuth(next http.Handler) http.Handler {
	return http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
		cookie, err := r.Cookie(sessionCookieName)
		if err != nil {
			writeError(w, http.StatusUnauthorized, "no session")
			return
		}

		uid, err := ValidateAndTouch(r.Context(), h.rdb, cookie.Value)
		if err != nil {
			writeError(w, http.StatusUnauthorized, "invalid session")
			return
		}

		ctx := context.WithValue(r.Context(), userIDCtxKey, uid)
		next.ServeHTTP(w, r.WithContext(ctx))
	})
}
Это всё middleware. Никакой криптографии, никакой подписи — просто чтение HASH по ключу. Именно эта простота и есть смысл всей статьи: для одного сервиса дальше рассуждать не о чем, авторизация укладывается в эти пятнадцать строк.
Одна оговорка, важная именно для security-темы. Раз сессия живёт в cookie, браузер отправляет её автоматически на каждый запрос к нашему origin — включая изменяющие состояние POST /auth/logout и DELETE /auth/sessions/{sid}. Это открывает дверь для CSRF: сторонний сайт может попытаться от имени залогиненного пользователя дёрнуть наш destructive-endpoint. Первая линия защиты здесь — SameSite=Strict на cookie (строка SameSite: http.SameSiteStrictMode выше): браузер вообще не приложит нашу cookie к запросу, инициированному с чужого сайта, и cross-site CSRF на этом закрывается. Но SameSite — это не полноценная CSRF-защита: стенд намеренно не показывает ни anti-CSRF-токен (double-submit), ни проверку заголовка Origin/Referer на state-changing запросах — это demo-упрощение. В проде для cookie-аутентификации POST/DELETE поверх SameSite добавляют явный CSRF-механизм (синхронизированный токен или строгую проверку Origin), потому что SameSite=Lax (частый дефолт), старые браузеры и некоторые навигационные сценарии оставляют щели, которые Strict закрывает не полностью.
Touch last_active без read-modify-write
Наивная реализация «обновлять время последней активности при каждом запросе» писала бы в Redis на каждый HTTP-запрос — при сколько-нибудь заметном трафике это лишняя нагрузка ради данных, которые никто не читает с точностью до секунды. ValidateAndTouch решает это throttle’ом: пишет lat не чаще раза в touchInterval (20 секунд):
func ValidateAndTouch(ctx context.Context, rdb *redis.Client, sid string) (string, error) {
	sKey := "s:" + sid
	data, err := rdb.HGetAll(ctx, sKey).Result()
	if err != nil {
		return "", err
	}
	if len(data) == 0 {
		return "", ErrNoSession
	}

	uid := data["uid"]

	if lat, ok := data["lat"]; ok {
		if last, perr := time.Parse(time.RFC3339, lat); perr == nil {
			if time.Since(last) < touchInterval {
				return uid, nil
			}
		}
	}

	now := time.Now().UTC().Format(time.RFC3339)
	pipe := rdb.TxPipeline()
	pipe.HSet(ctx, sKey, "lat", now)
	pipe.Expire(ctx, sKey, sessionTTL)
	if _, err := pipe.Exec(ctx); err != nil {
		return "", err
	}

	return uid, nil
}
Ключевая деталь — это не read-modify-write всего HASH. Обновляется одно поле (HSET sKey lat now), а не перечитывается и не переписывается вся запись целиком: uid и cat не трогаются вообще. Продление TTL (Expire) идёт в том же пайплайне, что и сама запись — сессия не может «протухнуть» ровно в момент, когда пользователь активен.
Throttle-проверка («прошло ли 20 секунд») сама по себе не атомарна — это read, потом условный write, и под настоящей конкуренцией два параллельных запроса от одного и того же пользователя оба могут решить, что пора писать, и оба напишут lat. Ничего страшного тут не происходит: оба напишут примерно одно и то же время, худший случай — лишняя пара HSET/EXPIRE вместо одной. Это осознанно неточная оптимизация, а не место, где нужна строгая атомарность — в отличие от rate-limit ниже, где та же схема «прочитать, потом решить» уже становится настоящим компромиссом.
Rate-limit и его честная цена
Запрос кода ограничен по email в двух окнах: 5 в минуту и 20 в час.
const (
	rateLimitMinTTL = 60 * time.Second
	rateLimitHrTTL  = time.Hour

	perMinLimit = 5
	perHrLimit  = 20
	maxAttempts = 5
)

func checkAndBumpRateLimit(ctx context.Context, rdb *redis.Client, email string) (limited bool, err error) {
	minKey := "auth:rl:" + email + ":min"
	hrKey := "auth:rl:" + email + ":hour"

	minCount, err := getCounter(ctx, rdb, minKey)
	if err != nil {
		return false, err
	}
	if minCount >= perMinLimit {
		return true, nil
	}

	hrCount, err := getCounter(ctx, rdb, hrKey)
	if err != nil {
		return false, err
	}
	if hrCount >= perHrLimit {
		return true, nil
	}

	pipe := rdb.TxPipeline()
	pipe.Incr(ctx, minKey)
	pipe.Expire(ctx, minKey, rateLimitMinTTL)
	pipe.Incr(ctx, hrKey)
	pipe.Expire(ctx, hrKey, rateLimitHrTTL)
	if _, err := pipe.Exec(ctx); err != nil {
		return false, err
	}

	return false, nil
}
И вот здесь стоит остановиться на честном компромиссе, прямо названном в README стенда: это check-then-act, не атомарная операция. Сначала читаются оба счётчика (GET), потом, если оба в пределах лимита, отдельным пайплайном инкрементируются оба (INCR + EXPIRE). Между чтением и записью — не транзакция уровня Redis, а два раздельных обращения. Под настоящей конкурентной нагрузкой несколько параллельных запросов могут одновременно пройти проверку «ещё не превышен», прежде чем кто-либо из них успеет инкрементировать — итоговый счётчик может ненадолго превысить лимит на несколько единиц (overshoot). Для demo это приемлемо: лимит — это защита от массового перебора, не точная квота, и небольшой overshoot ничего не ломает. В продакшене та же логика делается атомарно одной командой INCR + EXPIRE NX, либо Lua-скриптом, который читает и инкрементирует за один вызов Redis, не оставляя окна между шагами.
Отдельно ограничены и попытки ввода кода — maxAttempts = 5, разобрано выше в VerifyCode. Оба лимита решают разные задачи: минутный/часовой — от рассылки кода на чужой email в промышленных масштабах, maxAttempts — от подбора конкретного кода, который уже отправлен.
Список сессий, logout, чужая сессия
Список активных сессий — не отдельная витрина статистики, а прямое следствие того, что su:{userID} уже хранит все живые sid пользователя:
func ListSessions(ctx context.Context, rdb *redis.Client, userID string) ([]SessionView, error) {
	suKey := "su:" + userID
	sids, err := rdb.SMembers(ctx, suKey).Result()
	// ...
	views := make([]SessionView, 0, len(sids))
	var stale []string
	for i, sid := range sids {
		data := cmds[i].Val()
		if len(data) == 0 {
			stale = append(stale, sid)
			continue
		}
		views = append(views, SessionView{
			SID:        sid,
			UserID:     data["uid"],
			CreatedAt:  data["cat"],
			LastActive: data["lat"],
		})
	}
	if len(stale) > 0 {
		rdb.SRem(ctx, suKey, toInterfaceSlice(stale)...)
	}
	return views, nil
}
Есть нюанс, о котором легко забыть: HASH s:{sid} и запись sid в SET su:{userID} истекают по TTL независимо друг от друга. Если s:{sid} уже пропал (истёк раньше, чем успели прочитать), а ссылка на него в su: осталась — ListSessions не падает и не отдаёт «призрачную» запись, а тихо чистит её через SRem. Тест на это поведение (TestListSelfCleansStale) явно есть в стенде.
Удаление сессии — DeleteSession — не просто DEL по sid из URL. Сначала проверяется владение:
func DeleteSession(ctx context.Context, rdb *redis.Client, sid, userID string) error {
	owned, err := rdb.SIsMember(ctx, "su:"+userID, sid).Result()
	if err != nil {
		return err
	}
	if !owned {
		return ErrNoSession
	}

	pipe := rdb.TxPipeline()
	pipe.Del(ctx, "s:"+sid)
	pipe.SRem(ctx, "su:"+userID, sid)
	_, err = pipe.Exec(ctx)
	return err
}
DELETE /auth/sessions/{sid} берёт sid из URL, но userID — из уже проверенного контекста (того, что положило туда RequireAuth по cookie текущего пользователя). Без проверки SIsMember это была бы классическая IDOR: подставь чужой sid — и удали чужую сессию. Тест TestDeleteForeignSessionRejected в стенде проверяет ровно это: сессия u1 переживает попытку u2 её удалить, DeleteSession возвращает ErrNoSession и s:{sid} не трогает вообще.
При успешном удалении отзыв мгновенный и полный: s:{sid} и ссылка в su:{userID} уходят синхронно одним пайплайном, следующий же запрос с этим sid получает ErrNoSession от ValidateAndTouch — никакого «доживёт до истечения TTL», никакого промежуточного состояния. POST /auth/logout делает то же самое для sid из собственной cookie текущего запроса. Заметим честно: в стенде нет отдельной ручки «выйти со всех устройств одной кнопкой» — это было бы естественным расширением (пройтись по всем sid из su:{userID} и удалить каждый), но конкретно в single-service такого маршрута нет, есть только «текущая сессия» (/auth/logout) и «конкретная сессия по id» (DELETE /auth/sessions/{sid}), из которых logout-all собирается на клиенте циклом.
Почему здесь не нужен JWT
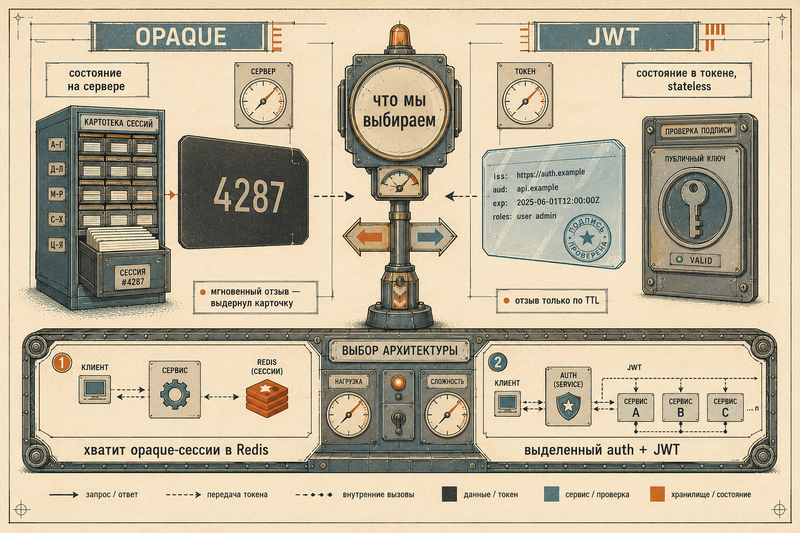
Вернёмся к карте выбора из первой статьи. Единственная причина брать JWT — избежать похода в общее хранилище на каждый запрос, когда таких запросов много и обслуживают их разные сервисы. Здесь сервис один. «Общее хранилище» — это тот же Redis, что стоит рядом с единственным процессом, который к нему и так обращается на каждый запрос за чем угодно. Stateless-валидация не экономит ничего, потому что нечего распределять: сходить в Redis дешевле, чем было бы поддерживать инфраструктуру для JWT, которую здесь некому переиспользовать.
А вот чем пришлось бы заплатить, выбери мы JWT для одного сервиса:
- Отзыв перестаёт быть мгновенным. Подписанный токен валиден до
exp, и «удалить» его при компрометации нельзя — только ждать истечения или городить отдельный чёрный список (который сам по себе снова требует общего хранилища — то есть то, от чего убегали). - Список активных сессий перестаёт быть бесплатным. У JWT сервер ничего не хранит — значит, «какие у меня сессии сейчас открыты» нужно снова реализовывать отдельно поверх токена, а не читать из индекса.
- Появляется код, которого не было бы иначе: ключи (генерация, хранение, ротация), подпись и проверка
alg, claims, размер токена в каждом запросе. Ничего из этого не решает проблему, которой здесь нет.
Ровно это и произошло бы: сложность стенда multi-service — третьей статьи серии — была бы добавлена без единственной причины, ради которой она того стоит, — избавления от общего похода в хранилище. Правило простое: JWT окупается количеством сервисов-потребителей, которые иначе синхронно ходили бы в общее хранилище. Один сервис — один потребитель, окупать нечего.
Граница, где решение стоит пересмотреть, наступает не сразу, а когда появляется второй сервис, которому тоже нужно знать, кто пользователь — и вот тут opaque-сессия в общем Redis либо остаётся (если сервисов мало и Redis рядом не становится бутылочным горлышком), либо действительно пора выделять auth и переходить к модели JWT + refresh, разобранной в третьей статье.
Куда дальше
Это вторая статья серии «Авторизация: токены, сессии, refresh»:
- Ст.1 — модели сессий: карта выбора opaque vs JWT, откуда взялась эта статья.
- Ст.3 — сложный путь: выделенный auth-сервис, JWT + refresh, локальная валидация без похода в auth — граница, за которой opaque-сессии одного сервиса перестают быть достаточными.
- Ст.4 — вход и регистрация: email-код здесь — лишь один из методов входа; OAuth, OTP, Telegram сходятся к той же модели сессии.
Источники
- OWASP — Session Management Cheat Sheet
- OWASP — Forgot Password Cheat Sheet (те же принципы применимы к magic-code)
- Redis — Transactions (MULTI/EXEC)
- Go
crypto/hmac— hmac.Equal (timing-safe comparison) - Живой стенд статьи:
security/auth/single-service
Комментарии