
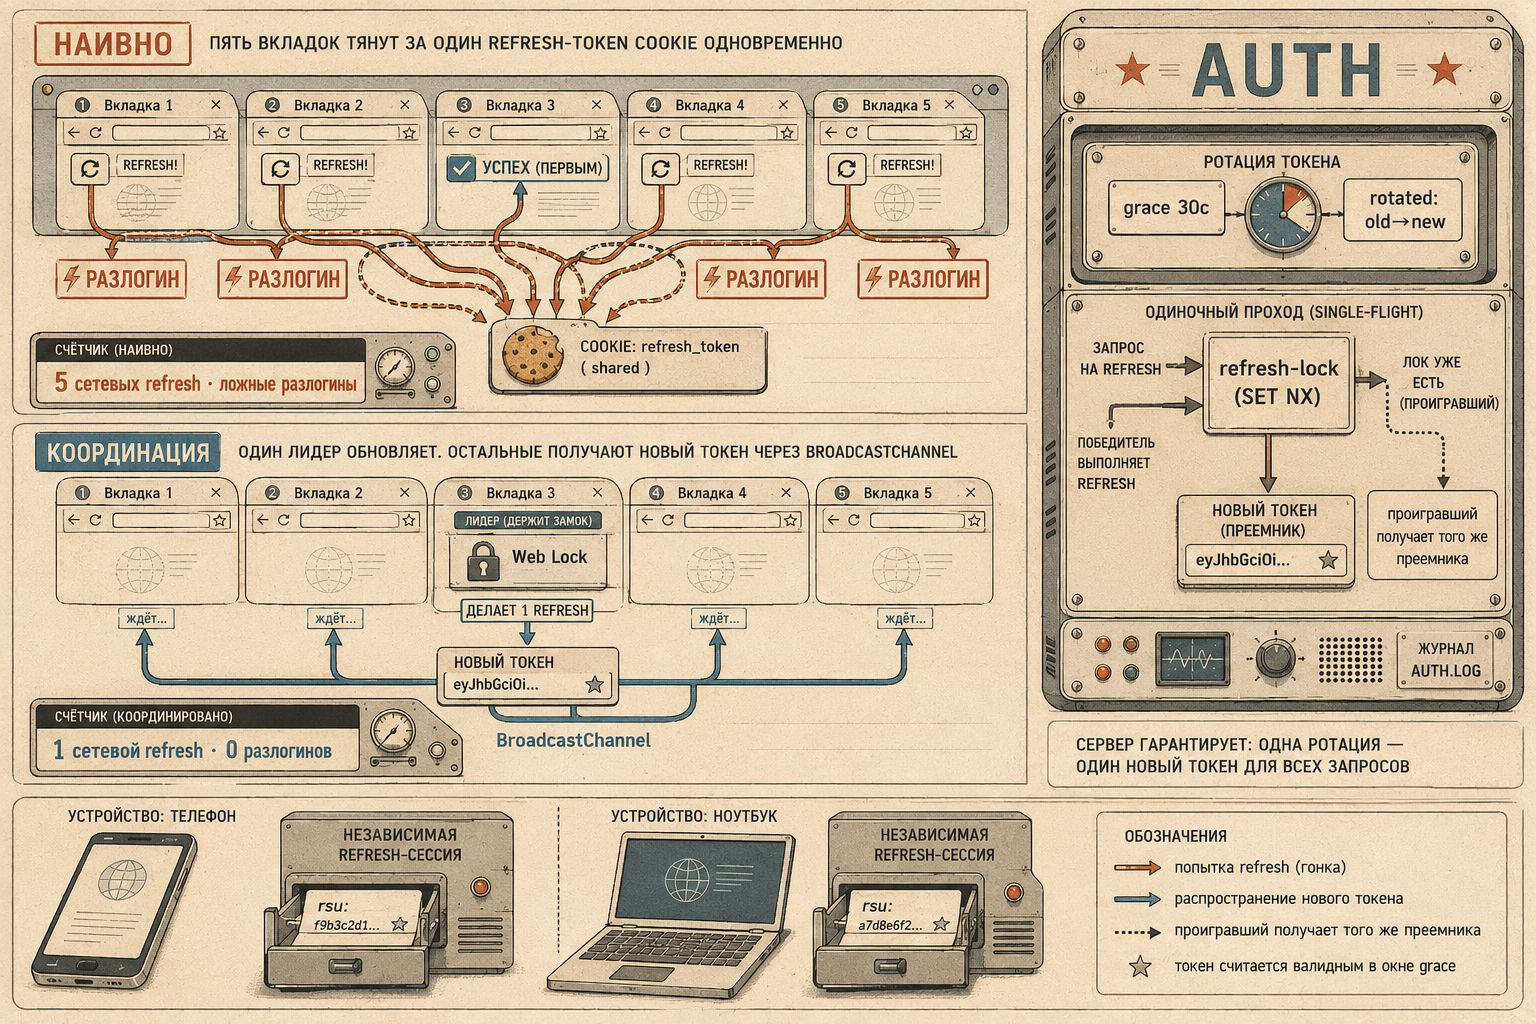
Пока пользователь в одной вкладке — refresh тривиален: access истёк, меняем его по refresh-токену, продолжаем. Проблемы начинаются, когда вкладок несколько и они делят одну cookie. Их таймеры refresh срабатывают почти одновременно, каждая пытается обновить токен, происходит ротация — и вкладка, чей refresh «проиграл гонку», получает уже недействительный токен и разлогинивается. Плюс несколько устройств и браузеров, где сессии должны жить и отзываться независимо. Эта статья — про то, как всё это не сломать.
Это пятая статья серии «Авторизация: токены, сессии, refresh» — финал её ядра (ст. 1–5) и флагман: сводит серверные механизмы ротации и клиентскую координацию вкладок в один рабочий паттерн. Опирается на модели из статей 1–3. Дальше в серии — ст. 6–8, три отдельных углубления (OAuth2/OIDC, MFA, passkeys), но несущая линия «от простого к сложному» замыкается здесь.
В статье
- Несколько устройств: независимые refresh-сессии
- Проблема: несколько вкладок, одна cookie
- Серверное решение: идемпотентная ротация с grace-period
- Distributed refresh-lock: single-flight на аккаунт
- Клиентская координация: BroadcastChannel + Web Locks
- Что доказывают числа
- Честные компромиссы demo
- Полный цикл и куда дальше по серии
- Источники
Несколько устройств: независимые refresh-сессии
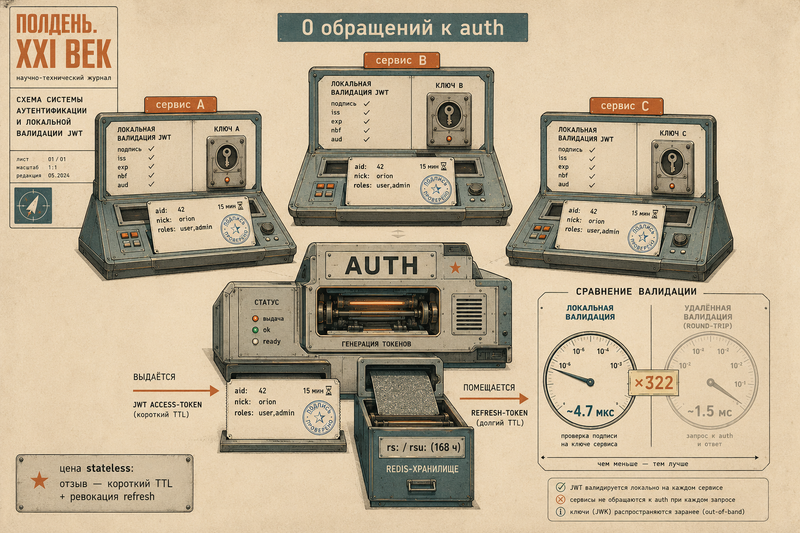
Прежде чем разбирать гонку вкладок, стоит закрыть более простой вопрос — несколько устройств и браузеров одного пользователя. Здесь никакой новой механики не нужно: это ровно та же модель rs:/rsu:, что уже разобрана в третьей статье серии. Каждый вход — отдельная refresh-сессия rs:{refresh} с записью в индексе rsu:{accountID}; ноутбук, телефон и рабочий компьютер получают три независимых refresh-токена, три независимых записи, три независимых TTL. client-refresh не заводит для этого отдельного хранилища — он пишет и читает те же ключи rs:/rsu:, что и authservice из ст. 3 (это видно в схеме ключей README стенда: оба сервиса значатся как «кто пишет» для rs:/rsu:), просто добавляет поверх них ротацию.
Из независимости сессий следует главное: на уровне устройств гонок нет. Отозвать сессию с телефона не задевает сессию на ноутбуке — это разные записи rs:{refresh} с разными значениями refresh. Список активных устройств (GET /auth/sessions, ListSessions по индексу rsu:) и глобальный logout (снос всех rs: из rsu:{accountID} разом) — уже разобранная в ст. 3 функциональность, которую эта статья не переоткрывает. Единственное, что стоит держать в голове дальше: настоящая гонка начинается не между устройствами, а внутри одного устройства, когда несколько вкладок одного браузера делят один и тот же refresh-токен через общую cookie. Именно туда мы и переходим.
Проблема: несколько вкладок, одна cookie
Refresh-cookie в client-refresh — app_rt, httpOnly, Path=/auth, ровно как в модели из первой статьи. Ключевая деталь: cookie принадлежит браузеру, а не вкладке. Если у вас открыты пять вкладок одного сайта, все пять шлют в POST /auth/refresh один и тот же refresh-токен — браузер не различает, из какой вкладки ушёл запрос.
Пока вкладка одна, это неважно. Проблема начинается, когда таймеры refresh (или одновременные 401 на access-эндпоинтах) срабатывают в нескольких вкладках почти одновременно. Naive-клиент стенда (web/naive.js) моделирует именно это: клик по #force-refresh шлёт POST /auth/refresh без какой-либо координации с другими вкладками того же браузера.
// web/naive.js
document.getElementById('force-refresh').addEventListener('click', async () => {
  const result = await rawRefresh();
  if (!result.ok) {
    // Наивная обработка: 429 (проигранный backend-lock) неотличим от 401
    // (реальный разлогин) — оба трактуются как "меня разлогинили".
    setLoggedIn(false);
    return;
  }
  setLoggedIn(true);
});
Если бы сервер ротировал refresh «в лоб» — удалял старую сессию и заводил новую при каждом обмене без какой-либо защиты от параллелизма (в стенде это RotateNaive, оставленный именно как контрастный, заведомо упрощённый путь) — картина была бы такой: одна из вкладок первой доходит до Redis, удаляет rs:{oldRefresh}, заводит новую сессию и получает свежую пару токенов. Все остальные вкладки, чьи запросы пришли на долю секунды позже, всё ещё держат в памяти старый refresh — но rs:{oldRefresh} уже удалён победителем. Для них ValidateAndTouch возвращает ErrNoSession, наивный клиент трактует это как «меня разлогинили», и пользователь получает ложный logout в части вкладок, хотя ни разу не выходил из системы. Хуже: RotateNaive при этом реально заводит новую сессию каждой горутине, успевшей пройти ValidateAndTouch до удаления старой записи, — то есть параллельно с ложными разлогинами в rsu: накапливаются «фантомные» записи: сессии, которые никто не будет использовать, но которые засоряют список устройств пользователя. Тест ниже считает только ложные разлогины, но фантомные сессии возникают в той же гонке.
Насколько это реально, а не гипотетически, показывает прямой concurrency-тест стенда: TestNaiveConcurrentProducesFalseLogouts запускает 20 горутин, которые одновременно вызывают RotateNaive с одним и тем же refresh-токеном. Три независимых прогона дали 17 из 20, 18 из 20 и 18 из 20 горутин, получивших ErrTokenInvalid — то есть подавляющее большинство параллельных запросов ложно разлогинилось бы, останься только один «победитель» с валидной парой токенов. Это не крайний случай — это типичный результат гонки без координации.
Серверное решение: идемпотентная ротация с grace-period
Настоящий Rotate (в отличие от контрастного RotateNaive выше) устроен так, чтобы у гонки не было проигравших — только один «первый» и произвольное число «опоздавших», которые получают тот же результат, что и первый, а не ошибку. Три механизма работают вместе: grace-period, распределённый lock и запись ротации для replay.
Grace-period. Когда refresh ротируется, старый токен не становится немедленно «мёртвым» — на graceTTL = 30 * time.Second в Redis остаётся мост:
// client-refresh/rotation.go
const (
	graceTTL = 30 * time.Second // окно, в которое опоздавший старый токен ещё "жив" как replay
	lockTTL  = 5 * time.Second  // TTL распределённого refresh-lock
)

// SetRotation регистрирует мост rotated:{oldRefresh} = "{newRefresh}:{accountID}"
// с TTL ttl (grace-период). Опоздавшие запросы старым токеном в это окно
// находят его через GetRotation вместо ложного разлогина.
func SetRotation(ctx context.Context, rdb *redis.Client, oldRefresh, newRefresh string, accountID int64, ttl time.Duration) error {
	key := "rotated:" + oldRefresh
	val := newRefresh + ":" + strconv.FormatInt(accountID, 10)
	return rdb.Set(ctx, key, val, ttl).Err()
}
Опоздавший запрос старым токеном не бьёт в пустоту — он находит rotated:{oldRefresh} и получает того же преемника, что и победитель гонки, через replayRotated:
// client-refresh/rotation.go
func replayRotated(ctx context.Context, rdb *redis.Client, secret []byte, oldRefresh string) (access, newRefresh string, err error) {
	newRef, _, found := GetRotation(ctx, rdb, oldRefresh)
	if !found {
		return "", "", ErrTokenInvalid // моста тоже нет — настоящий разлогин
	}
	// oldRefresh уже удалён — полный Account читаем из НОВОЙ сессии.
	acc, acctErr := session.AccountFromSession(ctx, rdb, newRef)
	// ...выпускаем свежий access для того же newRef, новую сессию НЕ создаём
}
Ключевая разница с наивным путём: проигравшая вкладка не получает 401, она получает валидную пару токенов — те же самые, что уже выданы победителю. С точки зрения пользователя ничего не произошло: обе вкладки продолжают работать с одним и тем же (новым) refresh, никакого разлогина, никаких фантомных сессий — вторая сессия не создаётся вообще.
Порядок проверки в Rotate именно такой: сначала ValidateAndTouch(oldRefresh); если сессия жива — идём в блок ротации; если ErrNoSession — это либо опоздавший запрос (мост ещё жив, replayRotated отдаёт преемника), либо настоящий разлогин (моста тоже нет, ErrTokenInvalid). Идемпотентность ротации — именно в этом: сколько бы раз ни пришёл один и тот же старый refresh в течение 30-секундного окна, результат один и тот же, новая сессия заводится один-единственный раз.
Здесь же стоит зафиксировать честную деталь стенда: SetRotation вызывается после того, как новая сессия уже создана, и её ошибка не роняет ротацию — только логируется (slog.Error, не return err). Это осознанный выбор: если запись моста не удалась (сетевой сбой ровно в этот момент), победитель гонки всё равно получает рабочую пару токенов — сессия не потеряна. Цена — тонкое (hairline) окно: если именно в эти доли секунды придёт опоздавший запрос старым токеном, а мост не записался, replayRotated его не найдёт и отдаст ErrTokenInvalid вместо replay. Это не баг, а сознательно принятый компромисс между «не потерять успешную ротацию из-за побочной записи» и «гарантировать replay абсолютно всегда» — устранить целиком можно только сделав SetRotation частью одной атомарной транзакции с созданием сессии, что стенд ради читаемости не делает.
Distributed refresh-lock: single-flight на аккаунт
Grace-period решает проблему опоздавших запросов — тех, кто пришёл уже после того, как ротация состоялась. Но что мешает двум запросам ротировать одновременно, до того как кто-то из них успел записать rotated:? Ответ — распределённый lock на аккаунт, rl:{accountID}, взятый через SET NX:
// client-refresh/rotation.go
func AcquireRefreshLock(ctx context.Context, rdb *redis.Client, accountID int64) (bool, error) {
	key := "rl:" + strconv.FormatInt(accountID, 10)
	ok, err := rdb.SetNX(ctx, key, "1", lockTTL).Result() // lockTTL = 5s
	return ok, err
}

func ReleaseRefreshLock(ctx context.Context, rdb *redis.Client, accountID int64) error {
	return rdb.Del(ctx, "rl:"+strconv.FormatInt(accountID, 10)).Err()
}
Rotate берёт этот lock уже после первого ValidateAndTouch, но до собственно ротации, и повторно проверяет GetRotation под локом — на случай, если конкурент успел ротировать между первой проверкой и захватом лока:
// client-refresh/rotation.go — сокращённый Rotate
ok, lockErr := AcquireRefreshLock(ctx, rdb, aid)
if !ok {
	return "", "", ErrRefreshInProgress // проигравший single-flight
}
defer ReleaseRefreshLock(ctx, rdb, aid)

if existingNew, _, found := GetRotation(ctx, rdb, oldRefresh); found {
	// конкурент уже ротировал между шагом 1 и захватом лока — не создаём
	// вторую сессию, выпускаем свежий access для уже существующего преемника
}
// ...иначе — собственно ротация: CreateTokenPair, SetRotation, удаление старой сессии
Тот, кто не взял lock, не ждёт молча и не повисает — HTTP-слой сразу отдаёт 429 с Retry-After: 1:
// client-refresh/http.go
switch {
case errors.Is(err, ErrRefreshInProgress):
	w.Header().Set("Retry-After", "1")
	writeError(w, http.StatusTooManyRequests, "refresh_in_progress")
case errors.Is(err, ErrTokenInvalid):
	writeError(w, http.StatusUnauthorized, "invalid_refresh")
default:
	writeError(w, http.StatusInternalServerError, "internal_error")
}
Это разделение принципиально: 429 — «подожди секунду и попробуй снова, ты не разлогинен», 401 — «сессии действительно больше нет». Именно эту разницу наивный клиент стирает (см. выше — !result.ok трактуется одинаково для обоих кодов), а координированный клиент, разобранный дальше, вообще не даёт этой ситуации возникнуть на уровне браузера.
Единственный корректный concurrency-тест стенда, TestConcurrentRefreshNoFalseLogout, воспроизводит именно такую гонку — 20 горутин против одного refresh-токена, но с ретраем на ErrRefreshInProgress (горутина, проигравшая lock, засыпает на 10 мс и пробует снова, до 20 попыток — модель клиента, который уважает 429+Retry-After, а не сдаётся после первой неудачи). Три независимых прогона (-count=3) дали 0 ложных разлогинов во всех трёх — каждая из 20 горутин в итоге получила валидного преемника, без единого исключения.
Клиентская координация: BroadcastChannel + Web Locks
Сервер даёт клиенту право на ошибку — проигравший lock получает 429, а не разлогин. Но это всё ещё означает лишний сетевой запрос на каждую вкладку и (для naive-клиента) неверную интерпретацию 429 как logout. Правильный клиент вообще не должен позволять пяти вкладкам одновременно бить по /auth/refresh — вместо этого одна вкладка-лидер должна сделать один запрос, а остальные — получить результат без похода в сеть. Это и делает coordinated.js двумя браузерными API.
Web Locks API (navigator.locks.request) выбирает лидера: все вкладки одного origin разделяют один LockManager, поэтому navigator.locks.request('auth-refresh', ...) — это single-flight в рамках браузера, а не только в рамках вкладки.
// web/coordinated.js
const LOCK_NAME = 'auth-refresh';
const FRESH_WINDOW_MS = 2000;

async function coordinatedRefresh() {
  if (!('locks' in navigator)) {
    await rawSingleRefresh(); // фолбэк для окружений без Web Locks
    return;
  }
  await navigator.locks.request(LOCK_NAME, async () => {
    if (accessToken && Date.now() - lastRefreshAt < FRESH_WINDOW_MS) {
      // refresh уже случился (в этой или другой вкладке) — не шлём повторный
      setLoggedIn(true);
      return;
    }
    await rawSingleRefresh(); // единственный держатель лока бьёт по сети
  });
}
Пока одна вкладка держит лок и делает единственный сетевой POST /auth/refresh, остальные встают в очередь navigator.locks и не отправляют параллельный запрос вовсе — backend-lock rl:{accountID} в этой картине никогда не видит конкуренции от этого браузера, потому что клиент сериализовал запросы ещё до сети. 429 от rl: в координированном режиме — это не баг, а просто ситуация, которая структурно не должна возникать между вкладками одного браузера (она остаётся возможной между разными браузерами/устройствами одного аккаунта — но там её штатно гасит grace+lock, разобранные выше).
BroadcastChannel разносит результат победителя остальным вкладкам без похода в сеть:
// web/coordinated.js
channel.onmessage = (ev) => {
  const msg = ev.data;
  if (msg.type === 'refreshed') {
    accessToken = msg.accessToken;
    lastRefreshAt = msg.at;
    setLoggedIn(true);
  } else if (msg.type === 'logout') {
    accessToken = null;
    setLoggedIn(false); // настоящий разлогин — сессии и grace-моста уже нет ни для кого
  }
};
Держатель лока после успешного rawRefresh шлёт {type: 'refreshed', accessToken, at} — все остальные вкладки, ожидавшие в очереди Web Locks или просто слушавшие канал, обновляют токен в памяти и остаются залогиненными без единого дополнительного запроса. Если единственный, кто реально бьёт по сети, получает настоящий 401 (сессии и grace-моста больше нет — реальная компрометация или истёкший refresh), он рассылает {type: 'logout'}, и все вкладки честно разлогиниваются разом — это не тот случай, что «ложный logout» из наивного сценария: тут причина реальна и относится ко всем вкладкам одинаково.
Здесь важна честная оговорка: план демо предполагал ещё и фолбэк на storage-событие — стандартный запасной канал межвкладочной синхронизации для браузеров без BroadcastChannel. В coordinated.js эта ветка не реализована — она оставлена только комментарием в исходнике («в этом demo сознательно НЕ реализован — оставлен только как комментарий; в продакшн-клиенте это была бы дополнительная ветка синхронизации»). В целевых окружениях стенда (Chromium, Playwright) BroadcastChannel присутствует всегда, так что для демонстрации механизма это не критично, но переносить coordinated.js как есть в продакшн с поддержкой старых браузеров без этого фолбэка не стоит. Точно так же в demo нет отдельной кнопки logout и явной очереди «pending-запросов» на время refresh, описанной в исходном плане статьи, — то, что реально показывает стенд, это единый refresh на браузер и синхронная рассылка его результата (успеха или настоящего разлогина), а не полноценный production HTTP-клиент с перехватом всех запросов.
Что доказывают числа
Два независимых замера — серверный (Go, честная конкурентность в одном процессе) и клиентский (Playwright, реальная гонка вкладок в браузере) — показывают один и тот же эффект с разных сторон.
Сервер (go test ./client-refresh/ -run 'TestConcurrent|TestNaive' -count=3 -v, 3 независимых прогона):
| Тест | Результат (3 прогона) |
|---|---|
TestConcurrentRefreshNoFalseLogout (grace + lock + replay) |
PASS, 0 ложных разлогинов во всех трёх прогонах |
TestNaiveConcurrentProducesFalseLogouts (наивная ротация, контраст) |
17/20, 18/20, 18/20 горутин получили ErrTokenInvalid |
Браузер (client-refresh/e2e/tabs.spec.ts, живой прогон против поднятого client-refresh, 5 вкладок, 3 независимых запуска):
| Режим | Сетевых /auth/refresh |
Ложных разлогинов |
|---|---|---|
coordinated (Web Locks + BroadcastChannel) |
1 (все 3 прогона) | 0 (все 3 прогона) |
naive (каждая вкладка независимо) |
5 (все 3 прогона) | 1/5, 1/5, 0/5 |
Разница в детерминированности между двумя таблицами — не случайность и не небрежность замера, а честное отражение того, что именно они измеряют. Go-тест — это счётчик внутри одного процесса с искусственно растянутым во времени доступом к in-memory Redis (miniredis): гонка контролируемая, воспроизводимая, поэтому результат стабильно высокий (17–18 из 20) прогон за прогоном. Playwright-тест — это реальная гонка между процессами браузера: page.click() для каждой из пяти вкладок сам по себе не атомарен, actionability-проверки Playwright и планировщик событий браузера иногда размазывают клики по времени настолько, что часть запросов проскакивает мимо узкого окна, в которое backend-lock (SetNX с TTL в единицы секунд) успевает поймать конкуренцию — отсюда и случай 0/5 в одном из трёх прогонов вместо стабильных 1–2. Оба замера воспроизводят проблему в большинстве прогонов, но серверный Go-тест — более надёжный источник числа, потому что не зависит от таймингов конкретного браузера и рендер-движка; браузерный замер ценен не абсолютным числом ложных разлогинов, а тем, что стабильно показывает: naive-клиент всегда шлёт до 5 отдельных сетевых запросов, coordinated — стабильно 1.
Честные компромиссы demo
Один компромисс стенда стоит того, чтобы разобрать его отдельно и подробно — он ярко иллюстрирует разницу между «работает в демо» и «выдержит прод».
rl:{accountID} — SET NX без токена владения. AcquireRefreshLock ставит лок простым SET NX key "1" TTL, а ReleaseRefreshLock снимает его безусловным DEL key. Формально это означает: снять лок может кто угодно, вызвавший Del по тому же ключу — не обязательно тот, кто его поставил. В классическом сценарии сбоя это выглядит так: горутина A берёт лок, начинает ротацию, но зависает дольше lockTTL (5 секунд) — например, из-за деградации сети до Redis. Лок истекает сам по TTL. Горутина B, которая всё это время ждала своей очереди, тоже успешно берёт SET NX (ключа уже нет) и начинает свою ротацию. Если после этого горутина A «отмирает» и вызывает ReleaseRefreshLock, она физически удаляет чужой лок — тот, что сейчас держит B, — и открывает дорогу третьей горутине C влезть в разгар ротации B. Это уже не redlock, а простая мьютекс-имитация без гарантии владения.
В стенде это структурная слабость, а не наблюдаемый баг: сама ротация занимает единицы миллисекунд (одна транзакция в Redis плюс пара отдельных команд), тогда как lockTTL — 5 секунд, разница на четыре порядка. Достичь состояния «висим дольше TTL» в demo-нагрузке практически нереально, поэтому в тестах и e2e-прогонах эта дыра ни разу не проявилась. Но это именно везение по масштабу, не гарантия протокола: правильный распределённый lock требует уникального токена владения, который держатель сравнивает со значением ключа перед удалением — атомарно, одним Lua-скриптом (compare-and-delete, аналог GET+DEL без гонки между ними), либо полноценного Redlock при нескольких независимых Redis-инстансах. Разница на одну строчку кода (Del вместо EVAL с проверкой владельца) — но именно эта строчка отделяет учебный SET NX от продакшн-lock.
Ещё один компромисс уже прозвучал выше, но стоит суммировать здесь: SetRotation — non-fatal, ошибка записи моста rotated: логируется, но не прерывает уже состоявшуюся ротацию — тонкое окно, в котором опоздавший запрос старым токеном получит ErrTokenInvalid вместо честного replay, если мост не успел записаться именно в этот момент. И третий — наивный контраст в браузере менее детерминирован, чем в контролируемой Go-гонке, о чём подробно сказано в предыдущем разделе: это следствие природы замера (реальный race в браузере против искусственной задержки в процессе), а не непоследовательность стенда.
Полный цикл и куда дальше по серии
Собирая всё вместе: access-токен истекает → координированный клиент берёт navigator.locks, вкладка-лидер шлёт единственный POST /auth/refresh → сервер под rl:{accountID} ротирует refresh, ставит мост rotated:{old}→new на 30 секунд, удаляет старую сессию → лидер получает новую пару, рассылает её через BroadcastChannel → все вкладки браузера продолжают работать с одним и тем же новым access, ни одна не увидела ни 401, ни 429. Если вместо этого refresh пришёл с другого устройства (телефон рядом с ноутбуком) — это уже не гонка, а независимая сессия из первого раздела статьи, никакого взаимодействия с grace/lock не требуется вовсе.
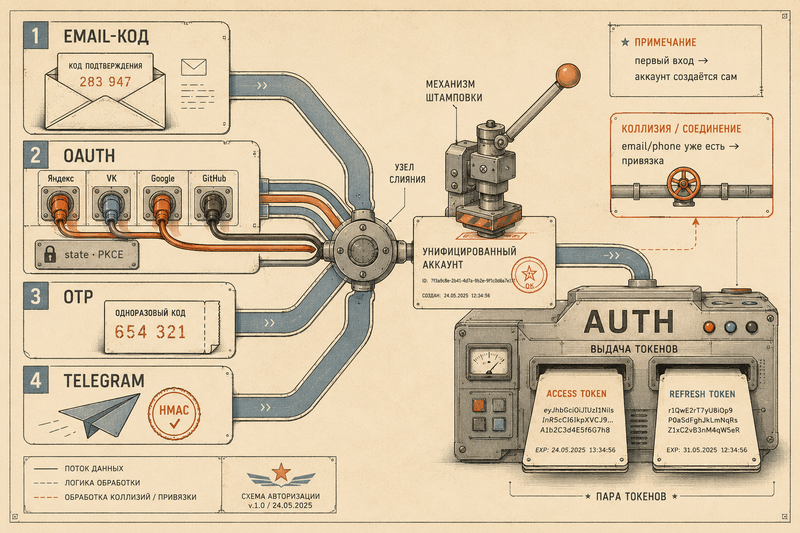
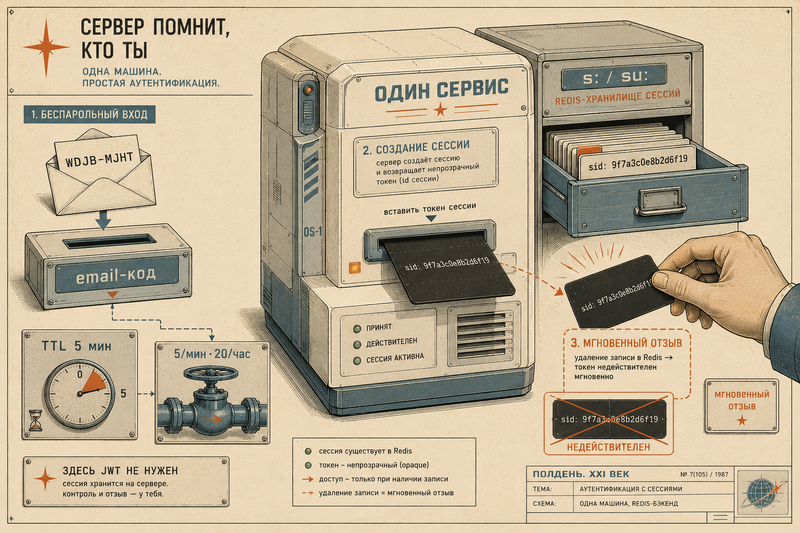
Это и есть точка, в которой ядро серии — ст. 1–5 — замыкается: от вопроса «где хранить состояние сессии» (ст. 1) через две архитектуры (ст. 2 — просто, ст. 3 — с масштабом) и разные способы попасть в систему (ст. 4) до самой болезненной части эксплуатации многовкладочного клиента (эта статья). Дальше по серии — три отдельных углубления, каждое достаточно большое, чтобы не поместиться в ядро: ст. 6 — OAuth2/OIDC вглубь (authorization code + PKCE, JWKS, device flow), ст. 7 — MFA и TOTP (второй фактор, step-up), ст. 8 — Passkeys и WebAuthn (passwordless). Они не продолжают эту тему линейно — они берут модель токенов и сессий, разобранную здесь, как данность и идут вглубь в своих направлениях.
Источники
- MDN — Broadcast Channel API
- MDN — Web Locks API
- RFC 6749 §6 — OAuth 2.0: Refreshing an Access Token
- Auth0 — Refresh Token Rotation
- Redis — Distributed Locks with Redis
- OWASP — Session Management Cheat Sheet
- Первая статья серии: Модели сессий: opaque vs JWT
- Третья статья серии: Сложный путь: выделенный auth, JWT и refresh в Redis — модель
rs:/rsu:, список сессий, глобальный logout - Четвёртая статья серии: Вход и регистрация
- Живой стенд статьи:
security/auth/client-refresh
Комментарии