
«Тесты есть» и «тестам можно верить» — разные состояния. Спор о моках, фейках и настоящей базе обычно ведут на примерах, подобранных под ответ: кто хочет доказать бесполезность моков, приводит случай, где моки слепы, и наоборот.
Я попробовал сделать иначе. Один репозиторий с тремя правилами предметной области, четыре набора тестов и четыре подсунутых дефекта плюс контроль. Каждый набор прогоняется по каждому состоянию кода, результат — целое «да/нет»: покраснел или нет. Такие факты переживают перезамер, в отличие от процентов.
digital-cookbook/python/tooling
В статье
- Что проверяем и чем
- Матрица: кто что ловит
- Контроль важнее любой поимки
- Фейк — не пустышка и не панацея
- Что видят только моки
- hypothesis: сколько примеров до ошибки
- Цена: считайте старты контейнера
- Что из этого следует
Что проверяем и чем
Репозиторий из трёх методов, каждый — одно правило предметной области и один запрос.
def unfinished(self):
    """ПРАВИЛО: незавершённые — это всё, что не «done».

    Задача без статуса тоже не завершена: статус неизвестен,
    значит работа не сдана.
    """
    where = tasks.c.status.is_distinct_from("done")
    return [row[0] for row in self.c.execute(
        select(tasks.c.id).where(where).order_by(tasks.c.id))]
Дефекты подсовываются переменной окружения, а не правкой файла. Это принципиально: сравнение имеет смысл, только если все четыре набора гоняются по одному и тому же коду. Исправляя руками между прогонами, вы получите «поймал» и «не поймал» про разные версии репозитория.
none         правильная реализация — контроль
null-filter  <> вместо IS DISTINCT FROM: строки с NULL молча выпадают
like-case    LIKE вместо регистронезависимого поиска
group-by     несгруппированная колонка в SELECT ... GROUP BY
n-plus-1     запрос на каждого автора вместо одного
Наборов четыре:
- моки — соединение подменено
MagicMock, тест проверяет взаимодействие; - фейк — тот же код против SQLite в памяти;
- база — тот же код против PostgreSQL 18 в контейнере через Testcontainers;
- hypothesis — property-based тест против той же базы, данные генерируются.
Утверждения у фейка и настоящей базы общие — буквально один файл, подключаемый обоими наборами. Скопировать их в два места значило бы через неделю получить расхождение результатов, объясняемое не базой, а забытым обновлением ожидания.
Набор на моках в этот общий файл не входит, и это не упущение. Мок не выполняет запрос, поэтому проверить им результат правила нечем: результат придумывает сам тест. Разница в утверждениях — не изъян сравнения, а его предмет.
Матрица: кто что ловит
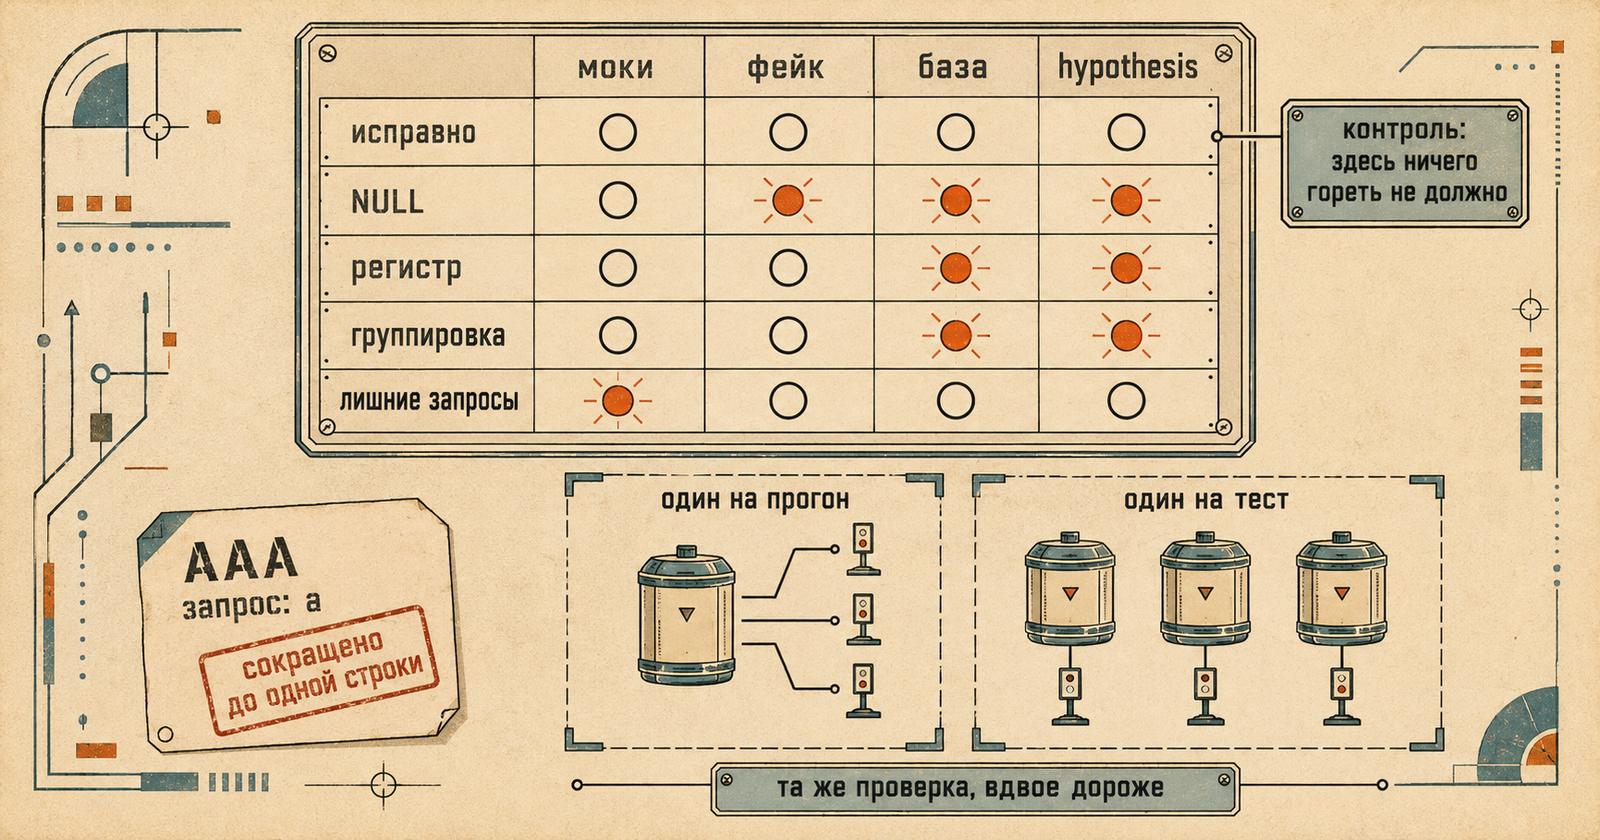
| состояние кода | моки | фейк | база | hypothesis |
|---|---|---|---|---|
| none — контроль | зелёный | зелёный | зелёный | зелёный |
| null-filter | нет | поймал | поймал | поймал |
| like-case | нет | нет | поймал | поймал |
| group-by | нет | нет | поймал | поймал |
| n-plus-1 | поймал | нет | нет | нет |
Читать её стоит не как турнирную таблицу, а как карту слепых зон. Ни один набор не покрывает всё, и ни один не бесполезен.
Контроль важнее любой поимки
Строка none — не для симметрии. Без неё утверждение «набор поймал дефект» не значит ничего: набор, который падает всегда, ловит любой дефект и ни одного.
Это тот же принцип, что и в проверке отсутствия чего-либо: подтверждение обязано быть отличимо от постоянного «нет». В разборе стенда красный контроль — признак негодного замера, а не строгого набора:
if row["failed"]:
    problems.append(
        f"{suite}: на ИСПРАВНОЙ реализации упало {row['failed']} из "
        f"{row['tests']} — набор красный сам по себе, и его "
        "«пойманные» дефекты ничего не значат")
Второй пункт того же разбора — дефект, которого не поймал никто. Такая строка читается как «даже настоящая база не помогла», но однозначного прочтения у неё нет. Причин несколько: внедрение не сработало, мутация оказалась эквивалентной и код с ней ведёт себя так же, как без неё, тестовые данные не проходят через изменённую ветку, или проверкам просто не хватает утверждений. Это повод разобрать конкретный случай, а не вывод ни о замере, ни о тестах.
Фейк — не пустышка и не панацея
SQLite в памяти вместо PostgreSQL — самый распространённый компромисс: настоящий SQL-движок, быстрый, без контейнеров. Матрица показывает, где он работает и где обманывает.
Работает. null-filter он ловит по-настоящему. Замена IS DISTINCT FROM на <> выбрасывает строки с NULL, потому что NULL <> 'done' даёт не истину, а NULL. SQLite трактует это так же, как PostgreSQL, и тест краснеет.
Обманывает. like-case он пропускает: у SQLite LIKE регистронезависим для ASCII по умолчанию, у PostgreSQL — нет. Тест зелёный, а в проде поиск не находит.
Обманывает. group-by он тоже пропускает: SQLite разрешает выбирать несгруппированную колонку и молча берёт значение из произвольной строки группы. PostgreSQL на этом останавливается с ошибкой.
Оба раза фейк зелёный, и оба раза он неправ. Причём заметьте характер обеих ошибок: это не экзотика, а рутинный поиск по названию и рутинная агрегация.
Вывод из этого не «SQLite использовать нельзя», а более узкий: фейк проверяет ваш код, но не вашу СУБД. Всё, что зависит от диалекта — регистр, NULL в неочевидных местах, строгость группировки, типы, коллации, — остаётся непроверенным, причём молча.
Что видят только моки
Строка n-plus-1 в матрице появилась не сразу, и появилась она из-за проблемы с честностью сравнения.
В первой версии матрицы набор на моках не поймал ничего: три «нет» подряд. Такую таблицу можно было бы опубликовать как приговор подходу — а означала она лишь, что своего дефекта он не встретил. Слабость набора и отсутствие подходящего случая выглядят одинаково, пока не показан хотя бы один случай, который он ловит.
Поэтому добавился четвёртый дефект: per_author делает запрос на каждого автора вместо одного общего.
def _per_author_n_plus_1(self, done):
    """Тот же ответ, но запросом на каждого автора.

    Результат совпадает с правильным до последнего байта — потому
    этот дефект и не виден наборам, которые сверяют результат.
    """
    authors = [r[0] for r in self.c.execute(
        select(tasks.c.author).distinct().order_by(tasks.c.author))]
    ...
Он не меняет результат. Поэтому его не видит ни фейк, ни настоящая база — оба сверяют результат, и он правильный. Видит его только тест, считающий обращения к соединению:
def test_per_author():
    repo, conn = make_repo([row])
    result = repo.per_author()
    # Порядок утверждений важен: число обращений проверяется ПЕРВЫМ.
    assert conn.execute.call_count == 1, (
        "правило — один запрос, а не запрос на автора")
    assert result == [("lem", 2, 0)]
Это и есть настоящая ниша моков: свойства взаимодействия, а не результата. Сколько раз сходили в базу, с какими аргументами, в каком порядке, отправили ли письмо ровно один раз. Ни один тест, сверяющий выход, такого не увидит — выход правильный.
Разбор стенда теперь считает набор, не поймавший ни одного дефекта, признаком негодного замера — наравне с красным контролем. Это защита не от плохих тестов, а от подставного сравнения.
hypothesis: сколько примеров до ошибки
В наборах выше данные подобраны руками: одна задача без статуса, одно название в верхнем регистре. Подобраны — значит, автор заранее знал, где искать. Property-based тест устроен иначе: данные генерируются, а ожидание считает независимый образец на Python.
@given(data=dataset())
def test_rules_hold_for_any_dataset(pg_engine, data):
    rows, term = data
    with pg_engine.connect() as conn:
        trans = conn.begin()
        try:
            conn.execute(repo_mod.tasks.insert(), rows)
            repo = repo_mod.TaskRepo(conn)
            assert repo.unfinished() == expected_unfinished(rows)
            assert repo.search(term) == expected_search(rows, term)
            assert repo.per_author() == expected_per_author(rows)
        finally:
            trans.rollback()
Образец обязан быть независимым. Если ожидание считать тем же запросом, что и проверяемое значение, тест сойдётся при любой ошибке — он будет сравнивать SQL сам с собой.
Сколько примеров потребовалось:
| состояние кода | без сжатия | со сжатием | поймал |
|---|---|---|---|
| none | 100 | 100 | нет |
| null-filter | 4 | 27 | да |
| like-case | 4 | 47 | да |
| group-by | 2 | 12 | да |
| n-plus-1 | 100 | 100 | нет |
Все три дефекта, которые вообще видны по результату, нашлись за единицы примеров. Контроль и n-plus-1 дошли до предела в сто и остались зелёными — и это правильный ответ в обоих случаях.
Считать примеры можно только на прогоне без сжатия. После первого падения hypothesis прогоняет тело ещё десятки раз, сокращая пример: 4 превращается в 27 и 47, 2 — в 12. Счётчик на таком прогоне мерит работу сжатия, а не поиска. Поэтому прогонов два, с разными фазами.
Базу примеров надо отключить. По умолчанию hypothesis запоминает падавший пример и на следующем прогоне подставляет его первым. Замер «нашлось с первого примера» окажется свойством кэша, а не поиска:
@settings(max_examples=100, deadline=None, database=None, phases=PHASES)
А вот главная ценность подхода — не число примеров, а то, что остаётся после сокращения:
$ DEFECT=like-case HYP_SHRINK=1 python -m pytest test_with_hypothesis.py -q -p no:cacheprovider \
    | grep -A3 '^Failing test case'
Failing test case: test_rules_hold_for_any_dataset(
    pg_engine=Engine(postgresql+psycopg://test:***@.../test),
    data=([{'author': 'lem', 'title': 'AAA', 'status': 'done', 'id': 1}], 'a'),
)
Одна задача с названием AAA и поисковый запрос a. Это готовый тест-пример, который можно перенести в обычный набор и держать там навсегда. «Сокращённый» не значит «наименьший возможный»: hypothesis упрощает, пока упрощение сохраняет падение, и останавливается на достигнутом.
Отдельно скажу про разбор вывода, потому что на нём я споткнулся. Я искал в отчёте блок «Falsifying example» — фразу, которой в выводе нет вовсе, там «Failing test case». Разбор молча возвращал пустоту для каждой поимки, и замер при этом выглядел исправным: поимки на месте, счётчики на месте, не было только того, ради чего набор и нужен. Теперь поимка без контрпримера — признак негодного замера.
Цена: считайте старты контейнера
| набор | область фикстуры | медиана, с | стартов контейнера |
|---|---|---|---|
| моки | — | 0,9 | 0 |
| фейк (SQLite) | — | 0,9 | 0 |
| база (Testcontainers) | function | 13,5 | 3 |
| база (Testcontainers) | session | 6,2 | 1 |
Одни и те же три теста стоят вдвое с лишним дороже, если контейнер поднимается на каждый тест. На трёх тестах это семь секунд; на трёхстах — разница между «прогоняю на каждый коммит» и «не прогоняю».
pytest позволяет задавать область видимости функцией, а не константой, — удобно, когда её надо менять ключом:
from testcontainers.community.postgres import PostgresContainer


def pg_scope(fixture_name, config):
    """Динамическая область: pytest разрешает задать её функцией."""
    return config.getoption("--pg-scope")


@pytest.fixture(scope=pg_scope)
def pg_container(request):
    container = PostgresContainer("postgres:18", driver="psycopg")
    container.start()
    STARTS["postgres"] += 1
    request.addfinalizer(container.stop)
    return container
Про импорт стоит сказать отдельно, потому что на нём легко не заметить проблему. В testcontainers 4.15 путь testcontainers.postgres оставлен ради совместимости и на каждом импорте печатает DeprecationWarning; рабочий путь — testcontainers.community.postgres. Прогон при этом остаётся зелёным, и увидеть предупреждение можно только вчитавшись в вывод.
Лечится это одной строкой в pytest.ini, и поставить её стоит сразу:
[pytest]
filterwarnings =
    error::DeprecationWarning
    error::PendingDeprecationWarning
Теперь любой устаревший вызов роняет прогон, а исключения перечисляются тут же и поимённо. Молчаливых не остаётся.
Обратите внимание на STARTS. Старты считаются, а не выводятся из области видимости. «Session — значит один раз» звучит очевидно ровно до первой ошибки в приспособлении: подтянули фикстуру из другого модуля, поменяли параметризацию — и контейнер поднимается снова, а замер об этом молчит. Стоит такая ошибка ровно вдвое.
Плата за один контейнер на весь прогон — изоляция. Каждый тест обязан откатывать свою транзакцию, иначе тесты видят данные друг друга и порядок начинает влиять на результат:
@pytest.fixture(scope="function")
def pg_conn(pg_container):
    engine = sqlalchemy.create_engine(pg_container.get_connection_url())
    conn = engine.connect()
    trans = conn.begin()
    repo_mod.create_and_seed(conn)
    try:
        yield conn
    finally:
        trans.rollback()
        conn.close()
        engine.dispose()
Ещё одна деталь, если запускаете Testcontainers изнутри контейнера (CI в докере — обычное дело): внутрь надо пробросить сокет докера, а библиотеке — сказать, по какому имени искать опубликованный порт. Изнутри контейнера localhost — это он сам, а не хост.
docker run --rm \
  -v /var/run/docker.sock:/var/run/docker.sock \
  --add-host=host.docker.internal:host-gateway \
  -e TESTCONTAINERS_HOST_OVERRIDE=host.docker.internal \
  ...
Что из этого следует
Пирамида не про количество, а про слепые зоны. Моки, фейк и настоящая база видят разное, и ни одно из этих «разное» не является подмножеством другого. Матрица выше — четыре дефекта, и нет ни одного набора, который поймал бы все четыре.
Фейк вместо базы проверяет ваш код, но не вашу СУБД. Два дефекта из четырёх SQLite пропускает молча, и оба — рутинные: регистр в поиске и строгость группировки. Если решаете использовать SQLite, решайте это сознательно, зная, что диалект остаётся непроверенным.
Моки нужны для свойств взаимодействия. Число запросов, порядок вызовов, «письмо отправлено ровно один раз». Всё, что не меняет результат, для тестов по результату невидимо — включая тесты на настоящей базе.
Property-based окупается контрпримером, а не поиском. Три дефекта нашлись за 2–4 примера, но ценно не это, а сокращённый пример из одной строки: его переносят в обычный набор и держат там как регрессионный тест.
Считайте старты контейнера, а не догадывайтесь о них. Один счётчик в conftest — и вы знаете, что область видимости работает так, как вы думали. Разница на стенде — ровно вдвое.
Заведите контроль в любом сравнении наборов. Прогон по исправному коду обязан быть зелёным везде; набор, не поймавший ни одного дефекта, ничего не говорит о подходе. Оба правила стоят пяти строк в разборе и снимают целый класс ложных выводов.
Границы всего сказанного. Дефектов четыре, и подобраны они мной — набор не претендует на полноту. Правил три, все читающие; ничего про транзакции, блокировки, конкурентный доступ и миграции здесь не проверялось, а именно там разница между фейком и настоящей базой обычно больше. Версии зафиксированы: Python 3.14.7, PostgreSQL 18.4, SQLAlchemy 2.0.52, pytest 9.1.1, hypothesis 6.165.10, testcontainers 4.15.0. Числа времени сняты на одной машине и переносу не подлежат; целые — поимки, старты контейнера, число примеров — переносятся, кроме последнего: генератор случайный, и число примеров от прогона к прогону меняется.
Как это устроено в других языках
Тестирование на JVM — там Testcontainers родом из экосистемы Java, и интеграционные тесты на настоящей инфраструктуре стали нормой раньше. Тестирование в .NETСкоро — другой полюс: сильная типизация снимает часть дефектов, которые в Python приходится ловить тестами.

Комментарии