
Прототип на FastAPI запускается одной командой — а вот довести его до эксплуатации под нагрузкой уже дисциплина: правильный сервер и число воркеров, конфигурация, корректное завершение и наблюдаемость.
Три из этих четырёх вещей обычно описывают словами: «выберите число воркеров по формуле», «включите graceful shutdown», «валидируйте конфигурацию на старте». Здесь они измерены, и каждый совет оказался точнее или неожиданнее, чем его обычная формулировка.
digital-cookbook/python/web
В статье
- Сколько нужно воркеров
- Способ запуска стоит порядка величины
- Что на самом деле защищает graceful shutdown
- Конфигурация: отказ против ложной готовности
- Наблюдаемость
- Чек-лист
Сколько нужно воркеров
Правильный ответ начинается с вопроса «какая у вас нагрузка», и разница между двумя ответами радикальная.
Одно и то же приложение, 64 одновременных запроса, ручка с ожиданием 20 миллисекунд вместо похода в базу:
| способ запуска | 1 воркер | 8 воркеров | рост |
|---|---|---|---|
| gunicorn, синхронные воркеры | 48,2 | 390,7 | 8,11x |
| gunicorn, gthread | 391,1 | 1849,9 | 4,73x ⚠️ |
| gunicorn + uvicorn-воркеры | 2927,1 | 2934,7 | 1,00x |
⚠️ Строку gthread по числам читать нельзя, и это честнее показать, чем спрятать. У четырёх воркеров пять кругов дали 877, 1513, 1519, 1609 и 1625 запросов в секунду, у восьми — 1177, 1574, 1850, 2462 и 2632. Разброс 1,85x и 2,24x при 1,01–1,10x у остальных плеч; собственный анализатор стенда такие клетки к ранжированию не допускает. Качественно gthread ведёт себя как промежуточная модель — масштабируется лучше синхронной и хуже асинхронной, — но конкретный множитель роста из этих фикстур брать нельзя.
Синхронная модель совпала с формулой с точностью до процента: 48,2 / 96,6 / 193,6 / 390,7 запроса в секунду при одном, двух, четырёх и восьми воркерах — против теоретического потолка 50 / 100 / 200 / 400. Разброс по кругам у неё 1,01–1,04x, то есть числу можно верить.
Формула простая и стоит того, чтобы её помнить:
пропускная способность = воркеров / время ответа
Синхронный воркер занят всё время ожидания целиком. При ответе в 20 миллисекунд один воркер даёт 50 запросов в секунду, и одновременность на это не влияет никак — лишние запросы просто стоят в очереди. Видно это по задержке: при четырёх воркерах и 64 одновременных запросах p50 равен 329 миллисекундам, хотя сам ответ занимает двадцать.
Асинхронной модели воркеры на ожидании не нужны — 1,00x. Один цикл событий уже держит 2927 запросов в секунду, добавление процессов не даёт ничего.
А вот на счётной нагрузке картина переворачивается: воркеры нужны всем моделям, потому что это отдельные процессы и они обходят GIL. Синхронные дают 6,80x при восьми воркерах — согласуется с замерами GIL, где восемь процессов дали 6,53x.
Отсюда практическое правило. Считаете число воркеров под ожидание — берите формулу выше и добавляйте запас на пики. Считаете под счёт — упирайтесь в число ядер, дальше процессы начнут мешать друг другу.
Способ запуска стоит порядка величины
Это тот случай, когда замер дал результат, которого я не ожидал, и он важнее формулы выше.
Тот же FastAPI, те же четыре воркера, разница только в команде запуска. Класс воркера берётся из отдельного пакета uvicorn-worker — встроенный uvicorn.workers.UvicornWorker объявлен устаревшим самим uvicorn:
| команда | запросов в секунду | p50 |
|---|---|---|
uvicorn app:app --workers 4 |
1283 | 50,00 мс |
gunicorn -k uvicorn_worker.UvicornWorker -w 4 |
16905 | 3,83 мс |
Разрыв в тринадцать раз при одинаковом приложении и одинаковом числе ASGI-воркеров. Обе клетки устойчивы: разброс по кругам 1,01x и 1,11x.
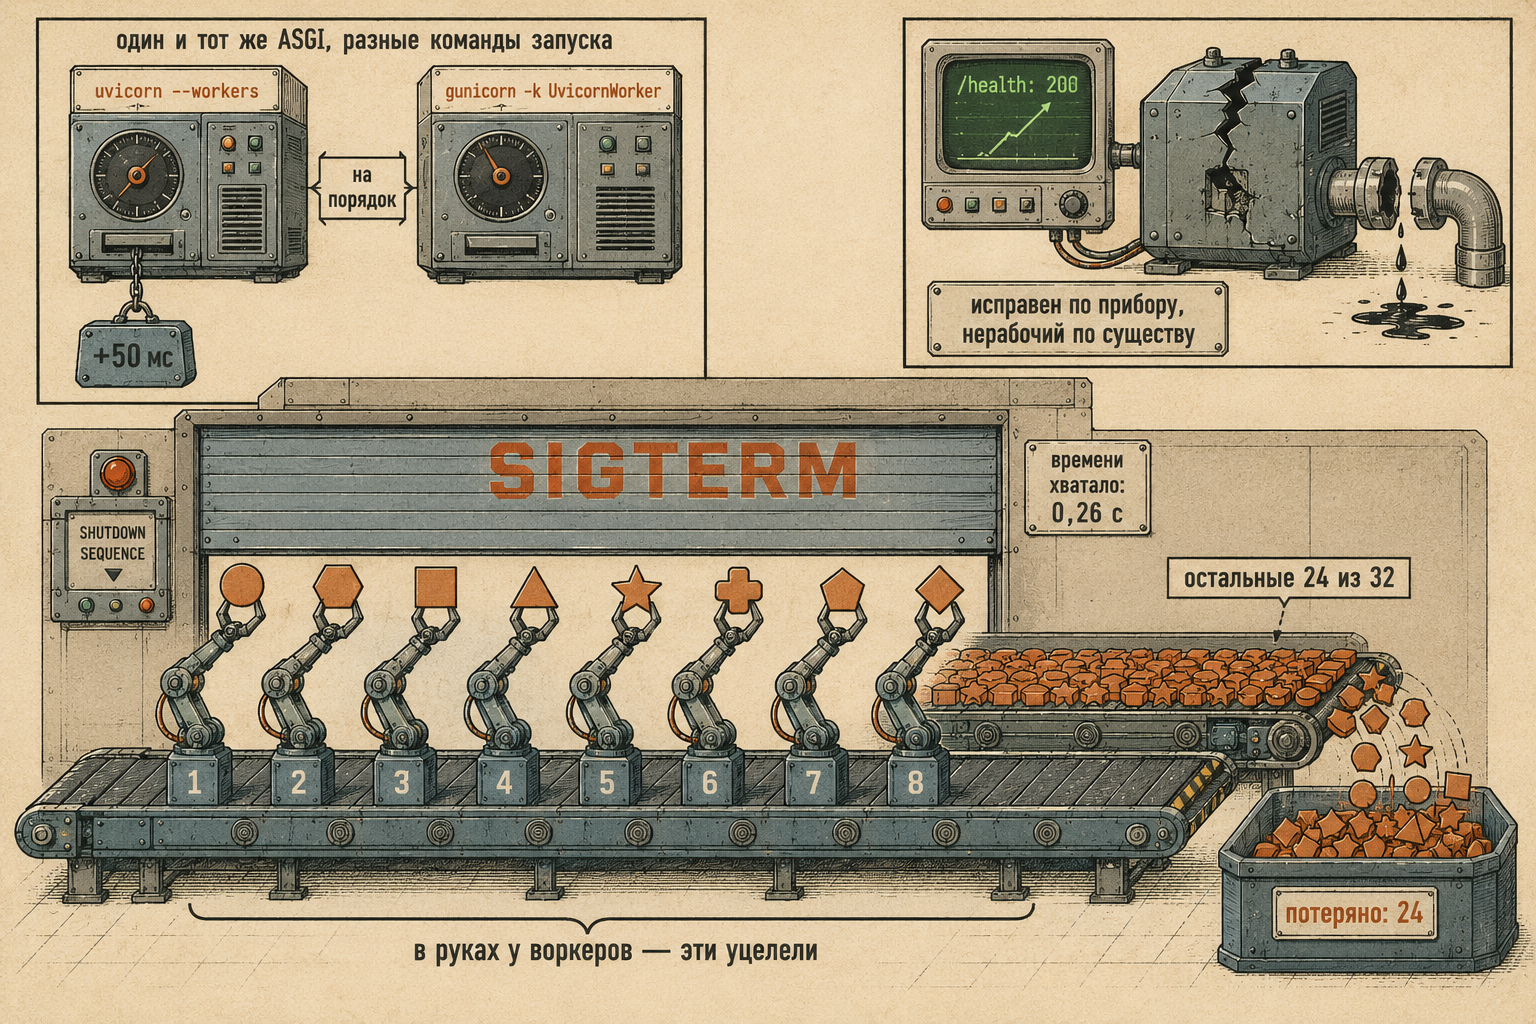
Выдали механизм круглые числа. Задержка при многопроцессном режиме uvicorn оказалась ровно 50,00 миллисекунды на пустой ручке и ровно 70,00 на ручке с ожиданием 20 миллисекунд. Число воркеров на неё не влияет: 50,00 при двух, четырёх и восьми.
Но «пятьдесят миллисекунд каждому запросу» было бы точнее измеренного. Ступень отлично видна на медиане и держится на p95 (50,3–50,5 мс), а вот p99 уходит к 60 мс — то есть распределение получило ступень около пятидесяти миллисекунд, но хвост сидит ещё десятью выше. На ручке с ожиданием то же самое со сдвигом на двадцать: 70,0 в медиане, 70,2 на p95, 80,0 на p99. Что это за задержка — стенд не выяснил. Он показывает постоянную добавку у конкретного способа запуска на конкретной версии и конкретной машине; ни слой, ни причина не локализованы. Утверждать можно ровно то, что видно: ступень не зависит ни от числа воркеров, ни от того, что делает ручка, и к модели обработки она отношения не имеет — та же модель под gunicorn её не даёт.
Порог — ровно два воркера. При одном uvicorn --workers 1 неотличим от gunicorn: 4219 против 4274 запросов в секунду, разница задержек 0,25 миллисекунды. Добавка появляется при переходе к двум и дальше не растёт.
Полезнее самого числа здесь методологический вывод. По первым данным выходило, что uvicorn теряет пропускную способность втрое при росте с одного воркера до двух: 2922 против 914 на ручке с ожиданием. Из этого напрашивался вывод «воркеры не помогают асинхронной модели» — правдоподобный, укладывающийся в общую логику статьи и полностью ложный. Спасло то, что ступень ровно в 50 миллисекунд не похожа на свойство модели, а второй способ развёртывания вопрос закрыл.
Величина разрыва зависит от того, что делает ручка. На пустой это тринадцать раз, на ручке с ожиданием — три с четвертью: 915 против 2949. Фиксированные 50 миллисекунд весят тем больше, чем короче сам ответ.
Проверяйте свою команду запуска замером, а не доверием. Числа в статьях, включая эту, получены на конкретной версии и конкретном окружении, и разница между двумя правильными на вид командами может стоить порядка.
Что на самом деле защищает graceful shutdown
Обещание «мы корректно завершаемся» проверяется одним вопросом: что произойдёт с запросами, которые уже в работе, если оркестратор пришлёт SIGTERM.
Замер устроен так: под постоянной нагрузкой в 32 одновременных запроса серверу шлётся сигнал, и считается судьба тех запросов, которые были в полёте в этот момент. Запросы, начавшиеся после сигнала, потерями не считаются — сервер вправе их не принимать.
Контроль обязателен и идёт первым. Каждый сервер гасится дважды: штатно и обрывом через SIGKILL. При обрыве теряются все 32 из 32 — значит потери в принципе видны, и ноль означает настоящий ноль, а не слепоту замера.
| сервер | воркеров | в полёте | уцелело при SIGTERM |
|---|---|---|---|
| gunicorn | 1 | 32 | 1 |
| gunicorn | 2 | 32 | 2 |
| gunicorn | 4 | 32 | 4 |
| gunicorn | 8 | 32 | 8 |
| uvicorn | — | 32 | 32 |
Совпадение точное на всех четырёх точках, и его надо объяснить.
Что здесь измерено буквально. Замер видит происходящее глазами клиента: он знает, что отправил 32 запроса и получил ответ ровно на столько, сколько у сервера воркеров. Состояние очереди внутри ядра стенд не наблюдает — для этого нужна инструментация на стороне сервера или сети, и её здесь нет.
Механизм, который это объясняет — и который остаётся гипотезой, пусть и хорошо согласованной с данными. Синхронный воркер держит ровно один запрос. Остальные соединения установлены, но их никто не обрабатывает, и корректному завершению нечего с ними делать: уцелевают те, что были у воркеров в руках. Совпадение числа выживших с числом воркеров на всех четырёх точках сильно поддерживает такое объяснение, но строго доказать его клиентскими наблюдениями нельзя.
Отсюда вывод — с границей применимости, потому что без неё он превращается в правило, которого замер не даёт. На этой конфигурации «мы включили graceful shutdown» у синхронной модели означало: уцелело столько запросов, сколько воркеров, а остальные из тридцати двух потерялись. Совпадение на четырёх точках подряд позволяет ожидать того же от gunicorn с синхронными воркерами при похожей нагрузке — но именно ожидать, а не гарантировать: другой сервер, другой профиль запросов или другая длина очереди могут дать иную картину, и проверяется это только замером на вашей стороне.
И наблюдение, которое стоит запомнить отдельно: увеличение таймаута дренажа здесь не помогло. Время завершения составило 0,26 секунды при одном, двух и четырёх воркерах и 0,36 при восьми — то есть завершение не упиралось в отведённое время и добавка к нему ничего бы не изменила. Почему дренировать оказалось нечего — см. гипотезу выше; из данных следует только то, что времени хватало с запасом.
У асинхронной модели картина вышла другой: uvicorn сохранил все 32 запроса из 32. Объясняется это тем, что цикл событий держит все принятые запросы одновременно, и дренировать есть что — но и здесь это объяснение, а не измеренный механизм.
Важнее другая оговорка. Замер снят на uvicorn без ограничений: не заданы ни предел одновременных задач, ни предел соединений, ни свой таймаут корректного завершения. Всё это у uvicorn настраивается, и настройки меняют картину: с ограничением одновременности лишние соединения окажутся ровно в том же положении, что у синхронной модели, а короткий таймаут дренажа оборвёт то, что не успело. Так что «асинхронная модель дренирует всё» — вывод не про модель, а про конкретную конфигурацию без лимитов. Свою проверяйте своим замером.
Что с этим делать практически. Если вы на синхронной модели и потери при выкатке недопустимы — рычаг находится не в приложении, а перед ним: трафик должен перестать приходить до того, как процессу придёт SIGTERM.
В Kubernetes для этого используют preStop-хук, но подавать его как гарантию неверно, и вот почему. Удаление пода запускает две вещи параллельно: выполнение хука и обновление EndpointSlice. Хук не ждёт, пока балансировщики узнают об исключении, а лишь даёт время, в течение которого это может произойти. Сколько именно нужно — зависит от того, что стоит перед подом: kube-proxy на узлах обновляется быстро, а внешний балансировщик или ingress-контроллер со своим пулом может отставать на секунды.
Плюс два ограничения, о которых легко забыть. Время хука тратится из общего terminationGracePeriodSeconds — если задержка в хуке съест весь бюджет, на сам дренаж не останется ничего.
Второе — про готовность, и здесь важно различать два пути трафика. Для обычного Service снимать readiness вручную не нужно: под, у которого пошло завершение, помечается в EndpointSlice как не готовый сам, и kube-proxy перестаёт его выбирать. А вот всё, что ходит в под мимо Service — ingress-контроллер со своим пулом соединений, внешний балансировщик облака с собственными проверками, service mesh со своей регистрацией, — узнаёт об исключении по своим правилам и в свои сроки. Вот там сигнал «я больше не готов» и нужен явно, вместе с пониманием, как устроено снятие с регистрации именно у вашего балансировщика.
Так что preStop — это способ купить время, а не переключатель. Сколько времени покупать, определяется вашей топологией, и проверяется это тем же способом, что и всё в этой статье: выкаткой под нагрузкой со счётом потерь.
Конфигурация: отказ против ложной готовности
Совет «валидируйте конфигурацию на старте» верен, но его обычно обосновывают неправильно — экономией времени. Замер показывает, что дело в другом.
Два режима с одной и той же проверкой, различается только момент вызова: при импорте модуля или при обработке запроса.
| режим | конфигурация | поднялся | /health | рабочая ручка | код выхода |
|---|---|---|---|---|---|
| наивный | корректная | да | 200 | 200 | — |
| наивный | сломанная | да | 200 | 500 | — |
| строгий | корректная | да | 200 | 200 | — |
| строгий | сломанная | нет | — | — | 78 |
Смотрите не на последнюю строку, а на вторую. Наивный режим при сломанной конфигурации поднимается, занимает порт и отвечает успехом на проверку здоровья, хотя ни одного рабочего запроса выполнить не может.
Проверка здоровья написана самым обычным образом — она не заглядывает в конфигурацию. Именно поэтому она и врёт. Для оркестратора такой экземпляр исправен: он пройдёт readiness, встанет в балансировку и начнёт получать трафик, который будет отдавать пятисотками.
Строгий режим не поднимается вовсе и выходит с кодом 78 — это EX_CONFIG из sysexits.h, и он отличает ошибку конфигурации от прочих отказов.
Разница по времени при этом мизерная: 0,20 секунды против 0,37. Так что аргумент «падать раньше — быстрее» здесь не работает, и опираться на него не стоит. Работает другой: разница в том, что́ система сообщает наружу — отказ или ложную готовность.
from pydantic import BaseModel, Field, ValidationError
import os, sys

class Settings(BaseModel):
    database_url: str = Field(pattern=r"^postgresql://")
    pool_size: int = Field(ge=1, le=100)

try:
    SETTINGS = Settings(
        database_url=os.environ.get("DATABASE_URL", ""),
        pool_size=int(os.environ.get("POOL_SIZE", "0") or 0),
    )
except (ValidationError, ValueError) as exc:
    print(f"конфигурация отвергнута: {exc}", file=sys.stderr)
    raise SystemExit(78)     # EX_CONFIG
Ключевое здесь — что этот код выполняется при импорте, до того как сервер начнёт слушать порт. И что проверка здоровья, если она у вас есть, должна отражать способность обслуживать запросы, а не факт, что процесс жив.
Наблюдаемость
Здесь я обязан обозначить границу: этот раздел не измерен. Стенд серии меряет модели развёртывания, завершение и конфигурацию, но накладных расходов трассировки и структурного логирования не снимает. Дальше — устройство и практика, без чисел.
Структурные логи — structlog или logging с JSON-форматтером. Смысл не в формате как таковом, а в том, что в каждую запись попадает идентификатор трассы: иначе логи и трассы живут отдельно, и связать их в момент разбора инцидента не получится.
OpenTelemetry для Python даёт автоматическую инструментацию популярных библиотек — HTTP-сервер, клиенты, драйверы баз. Начинать стоит с неё: она покрывает большую часть картины без правок кода. Ручные спаны добавляются там, где автоматических не хватает — вокруг доменных операций, которые вы хотите видеть отдельно.
Про накладные расходы. Трассировка не бесплатна, и её цену надо измерить на своей нагрузке, а не принять на веру. Тот же принцип, что с профайлерами в статье про производительность: инструмент, включённый постоянно, обязан иметь измеренную цену. Сэмплирование — основной рычаг, но выбирать долю сэмплов без замера значит гадать.
Health и readiness — разные вещи. Первое отвечает «процесс жив», второе — «я готов принимать трафик». Раздел выше показывает, во что обходится их смешение.
Чек-лист
- Число воркеров считайте по типу нагрузки. Ожидание — «воркеров ÷ время ответа» плюс запас. Счёт — упирайтесь в ядра.
- Замерьте свою команду запуска. Две правильные на вид команды разошлись в тринадцать раз на одном приложении.
- Проверьте, что даёт ваш graceful shutdown, отправив сигнал под нагрузкой — и именно проверьте, а не примите на веру. На стенде у синхронной модели уцелело ровно столько запросов, сколько воркеров, и увеличение таймаута этого не меняло; ваша конфигурация может вести себя иначе, и узнать это можно только замером.
- Уводите трафик до сигнала, если потери недопустимы:
preStopи задержка передSIGTERM. - Валидируйте конфигурацию при импорте и выходите с кодом 78. Не ради скорости отказа, а чтобы не было ложной готовности.
- Health не должен отвечать успехом, когда приложение не работает. Проверьте это, сломав конфигурацию намеренно.
- Измерьте цену трассировки на своей нагрузке, прежде чем включать её постоянно.
Соседние сюжеты
Выбор фреймворка и то, почему разница между ними тонет в первом же походе в базу, — в статье про web-фреймворки. Природа ограничения, из-за которого синхронный воркер занят всё время ожидания, — в статье про asyncio и GIL.
По аналогии с production-паттернами Rust и JVM, но со спецификой Python. Про сбор телеметрии — OpenTelemetry Collector.

Комментарии