
«Python медленный» — полуправда. Для ввода-вывода и связующего кода его скорость обычно не проблема; проблема начинается в счётных горячих путях, где интерпретация и GIL берут своё. Эта статья — про то, как найти место, где теряется время, и не обмануться при этом собственным инструментом.
Предыдущая статья серии отвечала на вопрос «какую модель конкурентности выбрать». Здесь вопрос другой: где именно уходит время и что с этим делать. Числа сняты на том же стенде.
digital-cookbook/python/concurrency
В статье
- Профайлер — тоже инструмент со своей ценой
- Два профайлера, одна нагрузка, разные картины
- Что делать с показаниями
- Где проходит граница GIL
- Нативные расширения
- Порядок действий
Профайлер — тоже инструмент со своей ценой
Правило «не оптимизируй без профиля» верное, но неполное. У профайлера есть цена, и она разная у разных инструментов.
Одна и та же нагрузка, семь кругов, медианы:
| режим | медиана | к прогону без профайлера |
|---|---|---|
| без профайлера | 3,628 с | 1,00x |
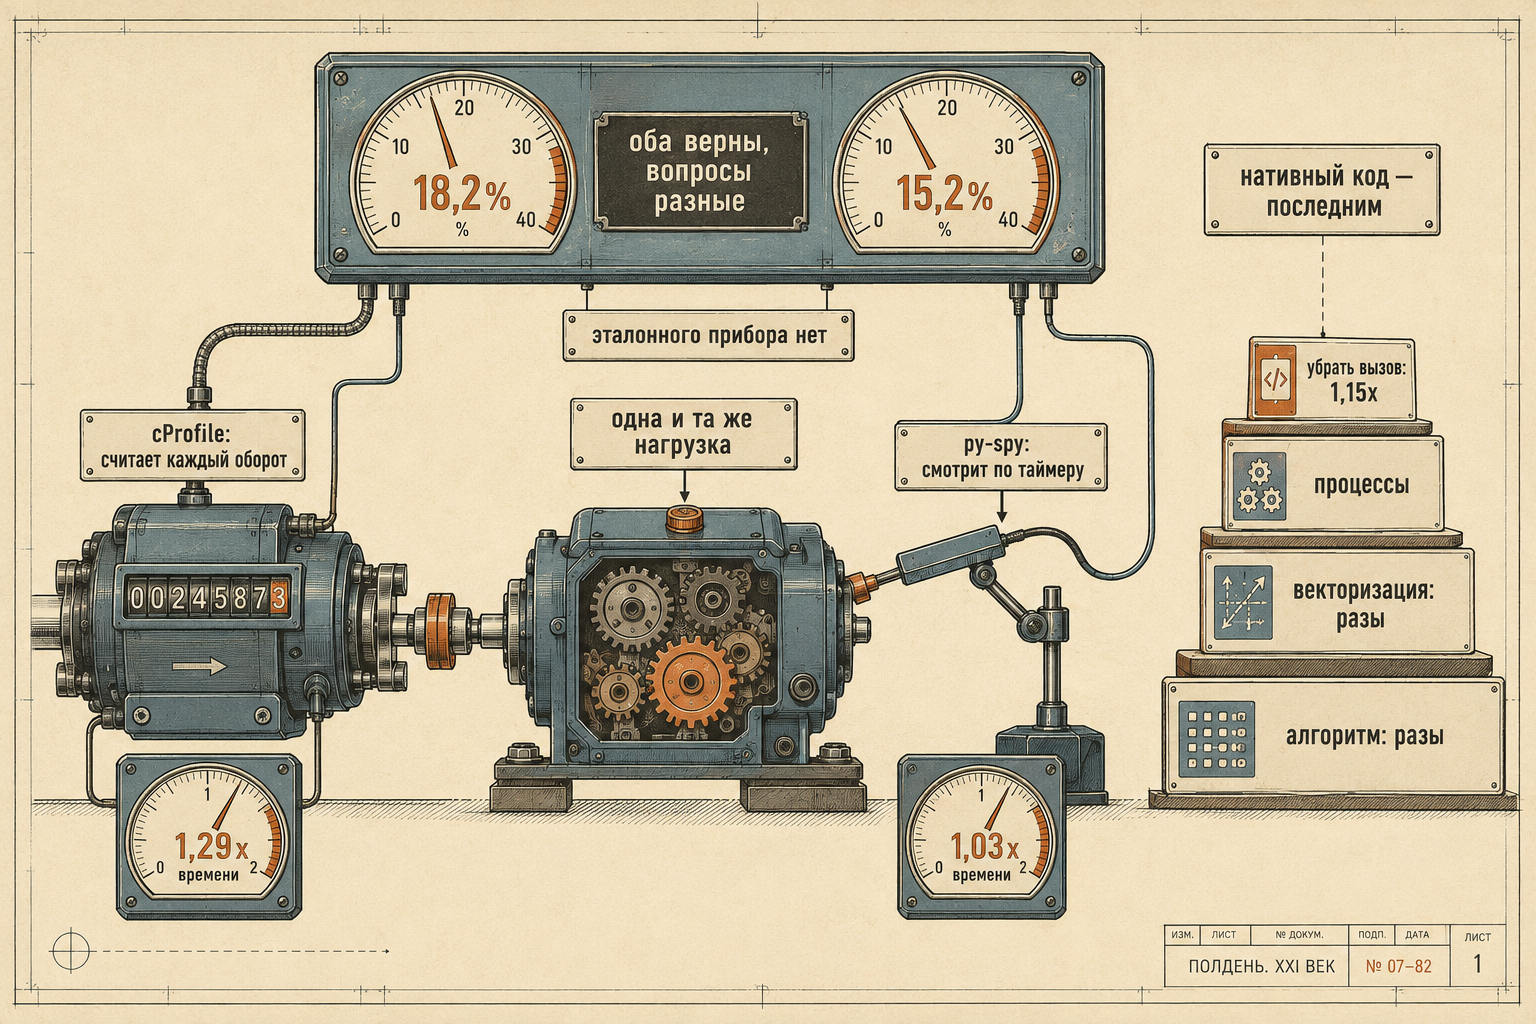
| под cProfile | 4,671 с | 1,29x |
| под py-spy | 3,727 с | 1,03x |
Разница не в качестве инструментов, а в их устройстве. cProfile — детерминированный: он перехватывает каждый вызов и возврат, поэтому знает точное число вызовов, но платит за это на каждом из них. py-spy — сэмплирующий: он периодически читает стек целевого процесса извне и о числе вызовов не знает вовсе.
Отсюда практическое следствие, ради которого этот замер и сделан. Но сначала оговорка про сами 1,29x: нагрузка на стенде намеренно сделана максимально невыгодной для детерминированного профайлера — шесть миллионов вызовов. На нагрузке, где вызовов меньше, а работы внутри каждого больше, цена будет заметно ниже, и документация Python описывает cProfile как инструмент с приемлемыми накладными расходами для долго работающих программ. Переносить мой множитель на свою систему нельзя.
Правило поэтому не «в проде нельзя», а такое: не держать детерминированный профайлер включённым постоянно, не измерив его цену на своей нагрузке. Сэмплирующий для этого подходит лучше — он читает чужой процесс, не требует ни перезапуска, ни изменения кода. Но и он не бесплатен в смысле прав, и граница тут тоньше, чем обычно пишут. Требуется не конкретная возможность, а право присоединиться к процессу и читать его память, а нужна ли для этого CAP_SYS_PTRACE — зависит от окружения: от политики Yama (/proc/sys/kernel/yama/ptrace_scope), от того, тот же ли это пользователь, и от того, находитесь ли вы в одном пространстве процессов с целью.
На стенде этой серии есть сценарий, который гоняет три случая без возможности и с ней. Вот что вышло на ядре, где модуль Yama не включён:
| сценарий | без SYS_PTRACE |
с SYS_PTRACE |
|---|---|---|
| root, py-spy сам запускает цель | работает | работает |
| root присоединяется к соседнему процессу root | работает | работает |
nobody присоединяется к процессу root |
Permission Denied | Permission Denied |
Первые две строки показывают, что возможность здесь просто не требовалась. Третья интереснее: cap_add контейнеру не помог. Причина в том, что возможность выдана root’у контейнера, а профайлер запущен от nobody — процессу, у которого её нет. То есть в этом сценарии решает пользователь, а не строчка в манифесте.
Отдельно оговорю, чего я не проверял: случай ptrace_scope=1, умолчание многих дистрибутивов, на этом ядре воспроизвести нельзя — модуля Yama в нём нет. По документации именно там присоединение к процессу, который не является вашим потомком, требует возможности, и вот тогда нужны cap_add: SYS_PTRACE в Docker или securityContext.capabilities.add в Kubernetes. Но это я взял из документации, а не измерил.
Практический вывод: выясните это на своей площадке заранее. Обнаружить, что профайлер не присоединяется, посреди инцидента — плохое время для такого открытия.
Два профайлера, одна нагрузка, разные картины
Дальше интереснее. Инструменты расходятся не только в цене, но и в показаниях.
Нагрузка на стенде построена как ловушка для детерминированного профайлера: две функции сопоставимой суммарной длительности, но одна вызывается 6 000 000 раз, а другая 3000.
| функция | вызовов | доля по cProfile | доля по py-spy |
|---|---|---|---|
tiny_step |
6 000 000 | 18,2% | 15,2% |
chunky_step |
3 000 | 64,2% | 77,7% |
cProfile приписывает мелкой частой функции большую долю, а крупной редкой — меньшую. Направление постоянно во всех семи кругах из семи. А вот множитель называть нельзя: у tiny_step он гуляет от 1,07 до 1,37. Разброс идёт от шума сэмплирования — у cProfile доли из круга в круг почти не меняются (18,0–18,5%), а py-spy на меньшей доле имеет пропорционально меньше сэмплов.
И главное, что нужно понимать про эту таблицу: эталонной доли здесь не существует. Измерить «истинную» долю функции можно только ещё каким-нибудь профайлером, у которого будут свои искажения. Поэтому корректная формулировка — «инструменты расходятся», а не «cProfile ошибается». Оба правы каждый в своих терминах: один отвечает на вопрос «сколько времени приходится на вызовы этой функции», другой — «как часто процессор заставали внутри неё».
Практический вывод: если два профайлера показывают разное, это не повод выбирать удобный. Это повод понять, какой вопрос вы задаёте.
Что делать с показаниями
Профиль показал функцию, которая вызывается миллионы раз. Классический совет — убрать вызов. Сколько это даёт на самом деле?
Цикл, состоящий только из вызовов тривиальной функции, семь кругов:
| вариант | медиана | к варианту с вызовом |
|---|---|---|
| вызов функции | 0,084 с | 1,00x |
| тело прямо в цикле | 0,073 с | 1,15x |
| весь цикл одним вызовом | 0,070 с | 1,20x |
Контрольные суммы всех трёх вариантов совпадают — сравнивается скорость, а не объём работы.
Пятнадцать процентов — величина реальная, но скромная, и цена за неё известна: код становится хуже читаемым. Причём здесь важна оговорка, без которой число вводит в заблуждение: замер сделан на цикле из одних только вызовов. В настоящей нагрузке доля такого цикла меньше, и выигрыш разбавляется пропорционально. Перемножать долю из профиля на этот множитель нельзя — получится число, которого никто не измерял.
Отсюда честный порядок приоритетов. Устранение вызовов — это единицы и десятки процентов. Смена алгоритма или структуры данных — это разы. Векторизация счёта через NumPy или polars, когда работа ложится на массивы, — тоже разы, потому что цикл уезжает в нативный код и заодно перестаёт удерживать GIL. Начинать стоит с того, что даёт разы.
Где проходит граница GIL
Подробный разбор — в статье про asyncio и GIL, здесь только то, что нужно для решений о производительности.
На счётной задаче восемь потоков дают 1,12x, восемь процессов — 6,53x. Граница проходит между потоками и процессами. Значит для счётного горячего пути в обычной сборке есть два традиционных пути: пул процессов либо нативный код, отпускающий GIL. На стенде проверен первый. Есть и третий, тоже не измеренный здесь: в Python 3.14 появился InterpreterPoolExecutor — пул отдельных интерпретаторов в одном процессе, у каждого свой GIL. Данные между ними передаются сериализацией, как и между процессами, а совместимы с ним не все расширения на C.
Второй вариант объясняет, почему NumPy и подобные библиотеки не упираются в GIL: тяжёлая часть у них исполняется вне интерпретатора. Это же объясняет и обратное — почему замер «потоки не ускоряют счёт» надо ставить на чистом Python-байткоде: если нагрузка уйдёт в библиотеку, отпускающую GIL, вы измерите библиотеку, а не GIL.
Free-threaded сборка снимает ограничение: потоки выходят на 6,76x. В Python 3.14 она официально поддержана — PEP 779 перевёл её из экспериментального статуса, — но сборкой по умолчанию не стала, и экосистема расширений ещё догоняет. Цена — порядка 4–7% в однопоточном коде по моим замерам, 10–15% по процессору и 15–20% по памяти по оценке самого PEP.
И отдельная ловушка ровно для этой статьи: C-расширение без поддержки free-threading включает GIL обратно всему процессу. CPython при этом печатает предупреждение, так что молчаливым это не назовёшь, но в логах старта его легко пропустить. Надёжнее проверять в момент работы — sys._is_gil_enabled() после импорта всех модулей, а не по тому, какой интерпретатор вы запустили.
Нативные расширения
Здесь я обязан обозначить границу: этот раздел не измерен. Стенд серии меряет модели конкурентности и профилирование, но собственного нативного модуля не собирает. Дальше — устройство вариантов и критерии выбора, без чисел; замеры под конкретную задачу придётся ставить самостоятельно.
Cython — постепенная типизация существующего Python-кода. Наименьший порог входа: горячую функцию можно типизировать, не переписывая остальное. Платой становится шаг сборки и то, что код перестаёт быть просто Python.
C-расширения напрямую и обёртки через ctypes/cffi — вариант, когда быстрая реализация уже существует и её надо просто позвать. Писать новое ядро на C ради скорости сегодня редко оправдано.
Rust через PyO3 — сегодня основной выбор для нового нативного кода: безопасность памяти без сборщика мусора и вменяемая сборка через maturin. Именно на этом пути построены polars и pydantic-core.
Общий критерий один и он не про язык. Нативное расширение оправдано, когда горячий путь узкий и стабильный: небольшой объём кода, который вызывается очень часто и меняется редко. Если горячий путь размазан по всей кодовой базе или переписывается каждый спринт, нативный модуль добавит сборку, отладку и кросс-платформенные сложности, а выигрыш растворится.
Стоит помнить и про то, что нативное расширение делает с конкурентностью. Правильно написанное — отпускает GIL на время тяжёлой работы, и тогда потоки вокруг него начинают работать. Написанное без этого — держит GIL всё время и превращается в узкое место для всей службы. А на free-threaded сборке расширение, не заявившее поддержку, вернёт GIL всему процессу.
Порядок действий
Собирая всё вместе:
- Измерить сэмплирующим профайлером. Он почти бесплатен (1,03x) и работает по живому процессу. Детерминированный оставьте для локального разбора, где 1,29x не мешают.
- Понять, что за нагрузка. Ожидание — вопрос модели конкурентности, а не скорости кода; см. соседнюю статью. Счёт — читайте дальше.
- Сначала алгоритм и структуры данных. Разы против единиц процентов.
- Потом векторизация, если работа ложится на массивы.
- Потом процессы для счётного пути — проверенный на стенде способ получить настоящий параллелизм в обычной сборке.
InterpreterPoolExecutorиз Python 3.14 обещает то же внутри одного процесса, но здесь он не измерялся. - Нативное расширение — последним, и только для узкого стабильного горячего пути.
И на каждом шаге проверяйте не только число, но и его название. На этом стенде дважды получалось так, что число было верным, а вывод из него — нет: «при одном воркере параллелизма нет» оказалось верным лишь для одной модели из трёх, а «free-threading хуже при высокой конкурентности» — шумом на трёх кругах. Профилирование даёт много поводов повторить эту ошибку.
Как это устроено в других языках
Профилирование поперёк языков — общий обзор подходов. Ближайшие соседи по устройству: pprof и бенчмарки в Go и профилирование на JVM, где сэмплирующий подход тоже основной.


Комментарии