
Упаковка исторически — самая болезненная часть Python: «у меня работает», конфликты версий, глобальный интерпретатор. Современные инструменты и дисциплина lock-файлов закрывают большую часть боли, если знать, как ими пользоваться.
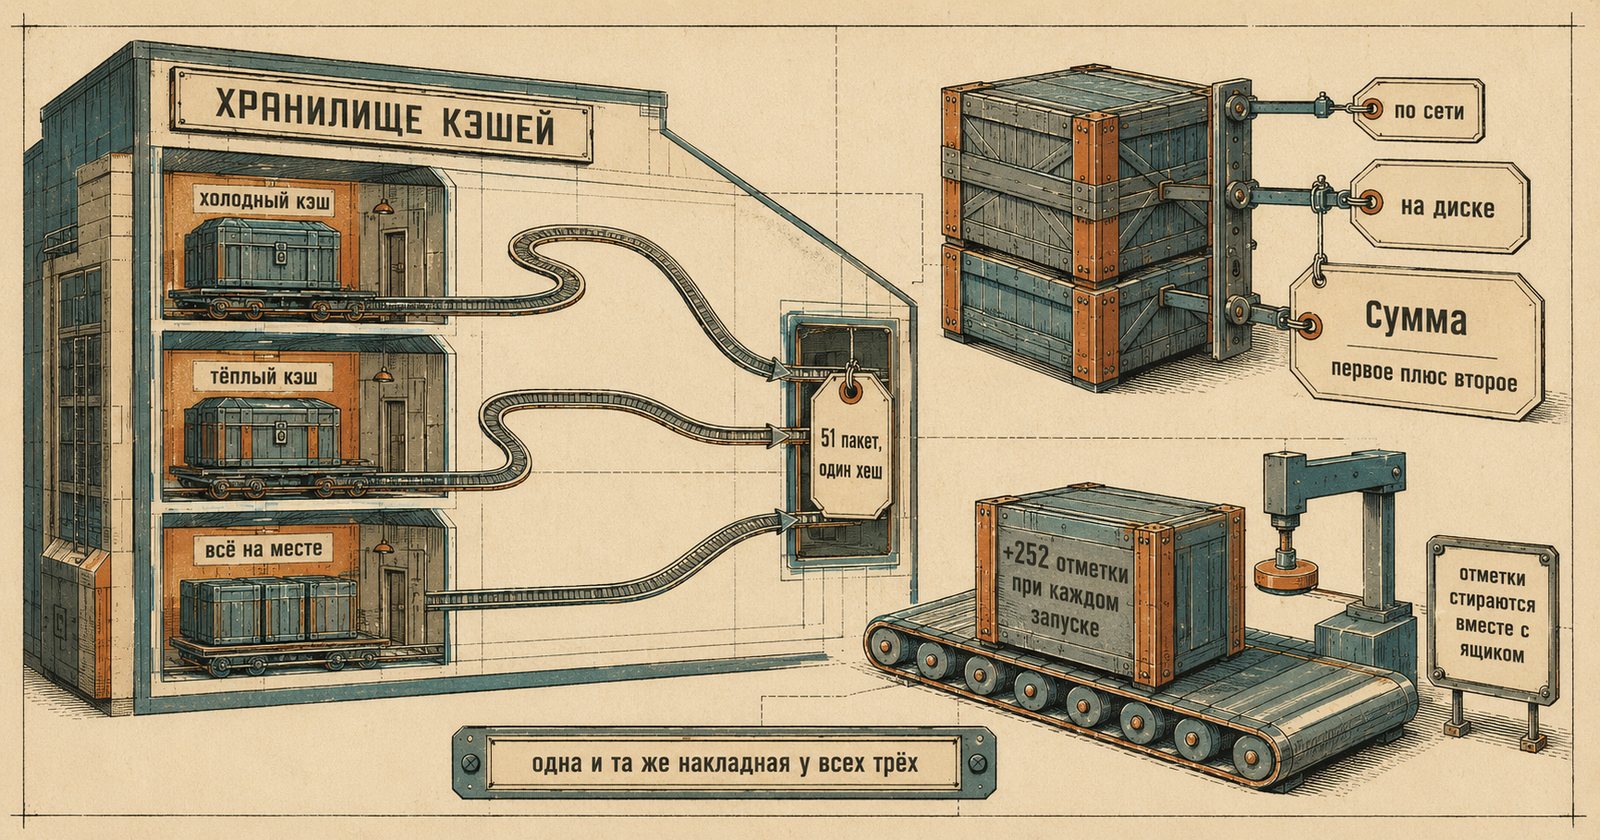
Все числа ниже сняты на стенде: один набор из 51 пакета, три инструмента, три состояния кэша, восемнадцать кругов. Плюс шесть стратегий сборки образа для одного и того же приложения. Главный результат оказался не в том, кто быстрее, а в том, что «установка зависимостей» — это не одна операция, и сравнивать инструменты можно только внутри одной.
digital-cookbook/python/tooling
В статье
- «Установка» — это три разные задачи
- Сколько это стоит
- Что даёт тёплый кэш
- Это эффект кэша или эффект порядка?
- Один порядок или два?
- Что оказалось на самом деле
- Проверка, без которой сравнение бессмысленно
- Сеть: порядок величины и почему только он
- Размер образа — это три разных числа
- Шесть стратегий сборки
- Байт-код: за что платит каждый запуск
- distroless собрался и не запустился
- Что из этого следует
«Установка» — это три разные задачи
Вопрос «сколько занимает install» не имеет ответа, пока не сказано, что лежит на диске в момент запуска. У каждого инструмента свой кэш — скачанные архивы, распакованные колёса, метаданные индекса, — и от его состояния время меняется на порядок.
На стенде состояний три, и каждое отвечает реальному случаю:
cold   кэш пуст, окружения нет        новая машина, первый прогон CI
warm   кэш полон, окружения нет       CI с восстановленным кэшем
noop   кэш и окружение на месте       повторный install у разработчика
Это не «одна операция с разбросом», а три разных задачи. Инструмент, выигрывающий в одной, может проигрывать в другой, и усреднять их между собой — значит получить число, не отвечающее ни на один вопрос.
Задача внутри состояния сформулирована одинаково для всех: от отсутствия окружения до окружения с установленным набором. Не «время команды install». Разница существенна: Poetry управляет окружением сам и чужой путь игнорирует, поэтому либо окружение создают все три плеча, либо у одного этап есть, а у двух других нет.
Разрешение зависимостей вынесено за скобки: все три ставят по готовому описанию — uv.lock, poetry.lock, requirements.txt с пиноваными версиями. Сравнивать uv sync с poetry add значило бы сравнивать разные операции.
Сколько это стоит
Медиана по восемнадцати кругам, секунды. Сеть за скобками — установка идёт из локального индекса.
| инструмент | cold | warm | noop |
|---|---|---|---|
| uv | 2,74 | 0,58 | 0,01 |
| Poetry | 3,59 | 3,03 | 0,75 |
| pip | 11,17 | 10,21 | 0,55 |
Отношения считаются покругово — в круге состояние машины общее, и деление медианы на медиану дало бы другое число по другой причине:
| к uv | cold | warm | noop |
|---|---|---|---|
| Poetry | 1,3x (1,2–1,4) | 5,5x (1,8–6,1) | 55,3x (21,4–64,2) |
| pip | 4,1x (3,8–5,2) | 18,3x (6,1–24,4) | 41,0x (15,4–66,3) |
Первое, что видно: разрыв растёт по мере того, как работы становится меньше. На холодном кэше uv быстрее pip вчетверо, на тёплом — в восемнадцать раз, а на повторном запуске — в сорок. Там, где реальной работы почти нет, остаётся накладной расход самого инструмента, и вот он различается сильнее всего.
Второе — про ожидание, с которым я начинал. Гипотеза была «uv быстрее на порядок при холодном кэше, разница сокращается при тёплом». Она не подтвердилась, причём в обе стороны: на холодном кэше разрыв с pip четырёхкратный, а не десятикратный, и при тёплом он не сокращается, а растёт. Poetry на холодном кэше отстаёт от uv всего на треть — а на тёплом уже в пять с половиной раз.
Отдельно про клетки с широким разбросом. У uv/noop он трёхкратный, но там сотые доли секунды: отношение макс/мин говорит о разрешении таймера, а не о нестабильности. У pip/noop — 1,9x из-за двух выбросов на восемнадцать кругов.
Ни то, ни другое порядок инструментов не меняет, и проверяется это не размахами, а знаком по кругам: pip быстрее Poetry при noop в 17 кругах из 18, а во всех прочих клетках счёт 18 из 18. Размах — статистика по худшему одиночному чтению, и строить на нём утверждение «кто быстрее» неправильно: одного выброса хватает, чтобы забраковать порядок, который держится семнадцать раз подряд.
Что даёт тёплый кэш
Разность cold − warm считается в одном круге и суммируется знаком, а не средним: если бы кэш не помогал, знаки делились бы примерно пополам.
| инструмент | кругов с выигрышем | медиана выигрыша | межквартильный размах |
|---|---|---|---|
| uv | 18 из 18 | +2,18 с | +2,04 … +2,22 |
| Poetry | 18 из 18 | +0,55 с | +0,50 … +0,60 |
| pip | 17 из 18 | +0,98 с | +0,70 … +1,30 |
Кэш помогает всем троим: у uv и Poetry выигрыш во всех восемнадцати кругах, у pip — в семнадцати из восемнадцати. Но у этой таблицы есть вопрос, который важнее самих чисел, и первая версия замера ответить на него не могла.
Это эффект кэша или эффект порядка?
Сперва я гонял состояния строго подряд: cold, warm, noop. Рассуждал так: «тёплый» означает «после холодного», порядок задан смыслом, ротировать нечего.
Рассуждение неверное, и цена ошибки — не в аккуратности, а в выводе. Кэш можно наполнить вне замера, а потом привести окружение к нужному состоянию — и тогда любое состояние достижимо на любой позиции. А пока порядок фиксирован, разность cold − warm включает не только эффект кэша, но и эффект порядка: чем позже идёт замер, тем теплее страничный кэш операционной системы и тем сильнее разогнан процессор.
Переделал так: перед каждым замером выполняется одинаковый неучитываемый прогон, и лишь потом состояние доводится до нужного.
cold   прогон, затем кэш инструмента очищается, окружение удаляется
warm   прогон, затем удаляется только окружение
noop   прогон, и больше ничего
Одинаковая работа перед всеми тремя состояниями выравнивает то, что раньше в них различалось. Дальше вопрос решается счётом: если выигрыш создаётся прогревом машины, то в кругах, где тёплый замер шёл первым, он обязан упасть или сменить знак — там тёплый выполняется на менее прогретой машине, чем холодный.
| инструмент | холодный раньше | тёплый раньше |
|---|---|---|
| uv | +2,22 с, знак 9/9 | +2,04 с, знак 9/9 |
| Poetry | +0,57 с, знак 9/9 | +0,51 с, знак 9/9 |
| pip | +1,06 с, знак 8/9 | +0,85 с, знак 9/9 |
Группы ровно по девять кругов: порядок состояний перебирается по всем шести перестановкам, поэтому холодный идёт раньше тёплого ровно в половине случаев. Выигрыш сохраняется в обоих порядках у всех трёх инструментов, знак почти единогласный.
Это позволяет сказать, что выигрыш от тёплого кэша не создан порядком прогона. Это не то же самое, что «выигрыш целиком объясняется кэшем инструмента»: девять наблюдений в группе — мало для утверждений о причинах, а размер каталога кэша не доказывает, что его содержимое одинаково. Сказать можно ровно первое.
Один порядок или два?
Здесь меня поймали на ошибке, которую стоит показать целиком: она из тех, что выглядят как аккуратность.
Разведя состояния, я решил, что дальше всё честно. Порядок инструментов ротировался латинским квадратом, порядок состояний — тем же квадратом со смещением на номер инструмента; смещение казалось развязкой. Я разложил время uv/warm по позиции состояния, получил 1,66 → 0,56 → 0,47 и написал про страничный кэш.
Обе ротации по отдельности были идеально сбалансированы: каждое состояние побывало на каждой позиции одинаковое число раз, и проверка стенда это подтверждала. А вот различных пар значений набралось три из девяти возможных:
круг 1: pip, poetry, uv   ->  у uv warm на 1-й позиции
круг 2: poetry, uv, pip   ->  у uv warm на 3-й позиции
круг 3: uv, pip, poetry   ->  у uv warm на 2-й позиции
«Состояние на первой позиции» у uv означало ровно «uv запускается третьим, после Poetry и pip». Разложение по позиции состояния было в точности разложением по позиции инструмента. Числа верные, объяснение — не следующее из них.
Лечится разными частотами ключей: порядок инструментов задаётся от (r-1) % 3, порядок состояний — одной из шести перестановок от (r-1) // 3. За 18 кругов каждая пара «сдвиг и перестановка» встречается ровно раз, и все девять пар позиций набираются. Стенд теперь проверяет именно это — не сбалансированность каждого фактора по отдельности, а число различных пар.
Что оказалось на самом деле
С разведёнными факторами картина другая. Вот uv/warm, разложенный по обоим:
| разложение | 1-я | 2-я | 3-я |
|---|---|---|---|
| по позиции инструмента | 0,57 | 0,55 | 1,12 |
| по позиции состояния | 0,60 | 0,59 | 0,53 |
По позиции состояния ровно. Весь эффект сидит в позиции инструмента: тёплая установка uv стоит вдвое дороже, когда uv запускается третьим, после Poetry и pip. Наблюдение то же самое, что и раньше, но теперь оно приписано тому фактору, которому принадлежит.
Механизм я не установил. Напрашивается вытеснение файлов кэша uv из памяти работой двух других инструментов — но неучитываемый прогон перед замером читает те же файлы, и после него они должны быть в памяти. Объяснение не сходится, и выдавать его за причину я не буду.
Что можно утверждать твёрдо: у uv тёплая установка настолько дёшева, что её время зависит от того, что происходило на машине до неё. У Poetry и pip этого не видно — их собственной работы достаточно, чтобы перекрыть эффект.
Практический вывод прямой: измеряя «install с восстановленным кэшем» у быстрого инструмента, одним запуском вы измеряете заодно и историю машины. Гоняйте несколько раз, меняйте порядок и смотрите на разброс, а не на одно число.
Отсюда же широкие размахи в колонке warm предыдущей таблицы: 1,8–6,1 у Poetry и 6,1–24,4 у pip. Соперники стабильны, нестабилен знаменатель.
Проверка, без которой сравнение бессмысленно
Любое «быстрее» обязано сопровождаться доказательством, что сделано то же самое. Иначе побеждает тот, кто сделал меньше.
На стенде после каждой установки снимается срез dist-info — отсортированный список имя==версия — и его хеш пишется в каждую строку фикстуры. Все 162 измерения основного набора — 18 кругов × 3 инструмента × 3 состояния кэша — дали один хеш и 51 пакет.
BOOTSTRAP = frozenset({"pip", "setuptools", "wheel", "pkg-resources"})


def snapshot(venv):
    """Что стоит в окружении — без того, что кладёт туда сам venv."""
    packages = sorted(
        f"{name}=={version}"
        for name, version in dist_info(site_packages(venv))
        if name not in BOOTSTRAP)
    return {"count": len(packages),
            "sha256": sha256("\n".join(packages))[:16]}
Загрузочные пакеты исключены намеренно: python -m venv кладёт свою версию pip, uv venv — не кладёт, и без этого исключения плечи расходились бы на пакете, который к набору отношения не имеет.
Проверку стоит ронять, а не только писать. Первая попытка сломать её подсовывала лишний six — пакет, уже входивший в набор транзитивно. Проверка справедливо ничего не заметила, и предохранитель выглядел бы проверенным, не будучи им. Со второй попытки — удалением dist-info пакета tenacity — она вернула код 2 и назвала пакет.
То же с холодным кэшем. «Мы очистили кэш» — не факт, а намерение. Размеры всех кэшей записываются до каждого прогона и уходят в фикстуру: прогон, в котором очищено три кэша из четырёх, измеряет четвёртый и выглядит совершенно нормально.
Сеть: порядок величины и почему только он
Числа выше сняты с локального индекса, то есть в условиях, которых в жизни не бывает. Чтобы не оставлять вопрос открытым, на стенде есть отдельное плечо против настоящего PyPI — помеченное как невоспроизводимое:
| инструмент | против PyPI, два повтора | локально |
|---|---|---|
| uv | 6,3 и 4,5 с | 2,74 |
| pip | 21,7 и 79,1 с | 11,17 |
| Poetry | не измеряется | — |
Два повтора одной и той же команды, идущие подряд, разошлись у pip в 3,6 раза. В других сеансах тот же замер давал pip 18,6 и 60,8 секунды, а uv — 3,4 и 31,4. Ранжировать инструменты по этому плечу нельзя, и это не оговорка ради приличия: разброс здесь больше, чем измеряемая разница.
Порядок надбавки виден и так: поход в сеть добавляет к установке от половины её длительности до нескольких её длительностей. Чем быстрее инструмент, тем большую долю его времени занимает сеть.
Poetry в это плечо не входит. Источник у него объявлен в pyproject.toml и продублирован в poetry.lock; сменить его снаружи нечем, а правка проекта означала бы другую задачу.
Узнал я это не сразу. Первая версия плеча выставляла POETRY_REPOSITORIES_LOCAL_URL — переменную, которая задаёт адрес для публикации пакета, а не для установки. Poetry её игнорировал, ставил из локального индекса и показывал 4,2 секунды «против PyPI»: ровно столько же, сколько без сети. Ни ошибки, ни предупреждения. Число выглядело правдоподобным выводом — «Poetry не страдает от сети» — и ушло бы в статью.
Отсюда правило, которое стоит унести с собой шире, чем про упаковку: если плечо отличается от базового одной внешней настройкой, проверьте, что настройка вообще действует. Самый дешёвый способ — подставить заведомо негодное значение и потребовать отказа.
def assert_index_honoured(tool):
    """Установка с мёртвого адреса ОБЯЗАНА упасть.

    Если она проходит, инструмент ходил куда-то ещё — и число,
    снятое «против другого индекса», снято против прежнего.
    """
    prepare(tool)
    try:
        install(tool, env_extra=index_env(tool.name, DEAD_INDEX))
    except RuntimeError:
        return True
    raise RuntimeError(f"{tool.name}: переопределение индекса не действует")
Ручка, которая молча ничего не делает, — худший вид неисправности, потому что замер при ней выглядит удавшимся.
Размер образа — это три разных числа
Прежде чем сравнивать стратегии сборки, надо договориться, что называется размером. Docker показывает три разных числа за одним словом, и на стенде они разошлись втрое:
$ python scripts/analyze-images.py
# (сведено: три размера образа slim из таблицы размеров и проверки тождества, с пояснениями)
docker image inspect .Size      108,1 МиБ   сжатые слои: что едет по сети
сумма docker history            235,7 МиБ   распакованные слои: что на диске
docker images                   360 MB      сумма первых двух (343,8 МиБ)
Третье — не ошибка и не альтернативная оценка: при containerd-хранилище узел держит и сжатые блобы, и распакованный снимок, и docker images складывает их. Единицы у него другие: docker images печатает десятичные мегабайты, поэтому 108,1 + 235,7 = 343,8 МиБ выглядят как 360 MB. Тождество сходится на всех шести стратегиях.
Сопоставление чисел с их смыслом зависит от версии Docker и от того, распакован ли образ, — проверяйте его у себя. Таблица снята на Docker 29.7.2. На Docker Desktop 29.8, где я повторял сравнение ниже, docker image inspect .Size отдаёт сжатый размер только до первого запуска контейнера, а после распаковки — ту же сумму, что и docker images. Если образ собран под чужую архитектуру (amd64 на Mac с Apple Silicon), слои не распаковываются до первого запуска, и docker history до этого показывает у собственных слоёв образа нули.
# сжатый размер: столько весит передача из реестра
docker image inspect -f '{{.Size}}' образ

# распакованный: столько занимает на диске узла
docker history --human=false --format '{{.Size}}' образ | awk '{s+=$1} END{print s}'
Флаг --human=false существен: без него docker history печатает «1.02GB», и «воспроизводимые целые числа» превращаются в округление, где разница в десяток мегабайт исчезает.
Первая версия моего сценария смешала два семейства в одной строке: размер образа брался из inspect, а самый толстый слой — из history. Получилось, что отдельный слой весит 87 МБ при образе в 61 МБ. Ни одна проверка не сработала, потому что проверки на это не было. Теперь «часть не больше целого» стоит отдельным пунктом.
Ещё одна оговорка: на classic-графдрайвере inspect отдаёт распакованный размер, и колонки меняются местами. Проверьте, какое у вас хранилище, прежде чем сравнивать свои числа с чужими.
Шесть стратегий сборки
Одно приложение — FastAPI с pydantic, SQLAlchemy и orjson, — собранное шестью способами. Размеры в МиБ, старт — медиана по семи кругам.
| стратегия | сжатый | распакованный | толстый слой | слоёв | старт, с |
|---|---|---|---|---|---|
| naive | 462,4 | 1250,4 | 661,8 | 12 | 0,66 |
| slim | 108,1 | 235,7 | 83,4 | 9 | 0,69 |
slim, колёса через --mount¹ |
58,1 | 185,1 | 83,6 | 8 | — |
| multistage | 58,3 | 188,0 | 83,4 | 7 | 1,23 |
| uv | 48,5 | 156,3 | 83,4 | 7 | 2,35 |
| uv-compiled | 54,6 | 174,7 | 83,4 | 7 | 1,31 |
| distroless | 49,2 | 157,8 | 105,8 | 19 | 2,06 |
Что здесь важнее самих чисел: все шесть образов отвечают побайтово одинаково. У каждого спрашивается один и тот же endpoint, и хеш ответа сверяется; в ответе лежат и результат вычисления, и версии всех зависимостей. Ужать образ, выкинув нужное, — обычный способ выиграть на весах, и без этой проверки таблица была бы украшением.
¹ Строка slim основной матрицы содержит ошибку сборки, о которой ниже: архивы колёс остаются в слое COPY, это 50,9 МиБ из 235,7. Исправленный вариант снят отдельно, на Docker Desktop 29.8 и обновившейся базе, вместе с повторной сборкой прежнего slim и multistage для сверки. Дрейф между прогонами — 0,2–0,3 МиБ на образ: прежний slim дал 108,1 и 236,0, multistage — 58,4 и 188,2. Время старта для исправленного варианта не снималось: от прежнего он отличается только отсутствием каталога /wheels, который при старте не читается.
Переход от наивной сборки к тонкой базе даёт почти всё: 1250 МиБ против 185, в шесть с лишним раз. Многоступенчатая сборка к исправленной тонкой базе по размеру ничего не добавляет: 188,2 против 185,1 МиБ. «Ещё четверть», которую я записал ей в первой редакции, была ровно слоем с колёсами в slim. Её польза в другом: компиляторы и заголовки, нужные для сборки пакетов из исходников, остаются в ступени сборки. В этом приложении все зависимости приходят готовыми колёсами, и разницы нет. Замена pip на uv внутри многоступенчатой сборки снимает ещё шестую часть (188,0 → 156,3), но больше половины этой разницы — байт-код, которого uv по умолчанию не пишет; об этом ниже.
# Ступень сборки может быть какой угодно жирной — в финальный образ
# из неё попадает лишь то, что скопировано явно.
FROM python:3.14 AS build
COPY --from=ghcr.io/astral-sh/uv:0.12.5 /uv /usr/local/bin/uv

COPY requirements.txt /tmp/requirements.txt
RUN uv venv --python "$(command -v python3.14)" /venv \
    && uv pip install --python /venv/bin/python -r /tmp/requirements.txt

FROM python:3.14-slim
COPY --from=build /venv /venv
ENV PATH="/venv/bin:${PATH}"

WORKDIR /srv
COPY service.py /srv/service.py
EXPOSE 8000
CMD ["python", "-m", "uvicorn", "--host", "0.0.0.0", "--port", "8000", \
     "service:app"]
Это целиком рабочий файл: docker build по нему проходит, если рядом лежат requirements.txt и service.py. В стенде к установке добавлены --no-index --find-links /wheels — там пакеты берутся из локального каталога колёс, чтобы убрать из замера сеть; при обычной сборке эти флаги не нужны.
Одна деталь заслуживает отдельного слова, потому что на ней ошибся и сам стенд. Удалять временные файлы нужно в том же слое, где они создавались. В первой редакции slim это правило выглядело соблюдённым:
COPY index/packages /wheels
RUN pip install --no-cache-dir --no-index --find-links /wheels \
        -r /srv/requirements.txt \
    && rm -rf /wheels
Но создаёт каталог не RUN, а предыдущая инструкция COPY, и архивы уже записаны в её слой. rm в следующем слое только прячет их: образ не худеет ни на байт, а docker history честно показывает слой COPY index/packages /wheels весом 50,9 МиБ. Объединение с установкой здесь не помогает.
Чтобы архивы не попали в образ вовсе, у них не должно быть своего слоя. Подходят два способа: многоступенчатая сборка, где колёса живут только в ступени сборки, или временное подключение каталога к одной инструкции через BuildKit:
RUN --mount=type=bind,source=index/packages,target=/wheels \
    pip install --no-cache-dir --no-index --find-links /wheels \
        -r /srv/requirements.txt
Каталог существует только на время этой инструкции, и удалять нечего.
Про воспроизводимость. Распакованный размер после пересборки с --no-cache совпадает побайтово у всех шести стратегий. Сжатый — плавает: до 505 байт от сборки к сборке, потому что сжатие не обязано выдавать побайтово одинаковый поток. Это в три с лишним тысячи раз меньше расстояния между ближайшими стратегиями, так что на выводы не влияет, — но если вы сравниваете сжатые размеры с точностью до байта, вы сравниваете шум.
А вот колонку «старт» переносить к себе не стоит. Размеры воспроизводятся побайтово, время старта — нет: между двумя прогонами этого стенда все медианы выросли почти вдвое, потому что машина была занята другим. Устойчивы отношения: multistage дал 1,76 и 1,78 к базовой стратегии, uv — 3,20 и 3,54. Поэтому дальше я говорю про отношения и знак, а не про секунды.
И оговорка о том, чего эта воспроизводимость не покрывает. Базы в моих Dockerfile заданы тегами, а тег — плавающая ссылка: когда обновится python:3.14-slim, все шесть чисел сдвинутся разом. Поэтому стенд записывает в фикстуру digest каждой базы на момент сборки — это не делает сборку воспроизводимой (для этого теги надо пиновать), но позволяет понять, то же ли самое вы собираете:
$ python scripts/analyze-images.py
# (выдержка из списка digest баз: ссылка и digest в одну строку, digest обрезаны)
python:3.14-slim   индекс     sha256:8a14a31f4bf634c04722154f30eb33998b…
                   linux/amd64 sha256:5b945726c4d7ffe6595dc7498ad17fd039…
Digest тут два, и это не педантизм: тег указывает на индекс — список манифестов под разные платформы, — а собирается ровно один из них.
Существенно и когда снимать. Сперва я спрашивал реестр уже после сборки, а сборка шла без --pull: при локально закешированной базе записанный digest мог относиться к образу, который не собирался. --no-cache тут не помогает — он не переиспользует слои сборки, но базу из локального кэша берёт по-прежнему. Правильный порядок: вытянуть базы явно (docker pull --platform linux/amd64), снять digest с локальных копий и только потом собирать.
Ставить --pull на каждую сборку — плохая идея, и я это проверил на себе: шесть стратегий, каждая собирается дважды, у каждой одна-две базы — под шесть десятков обращений к реестру за прогон, и Docker Hub отвечает 429 Too Many Requests посреди замера.
Байт-код: за что платит каждый запуск
Строчка uv в таблице — 156 МиБ и старт 2,35 с. Строчка uv-compiled — 175 МиБ и старт 1,31 с. Отличаются они одним флагом:
RUN uv pip install --python /venv/bin/python --compile-bytecode \
        -r /tmp/requirements.txt
Девятнадцать мегабайт — это вес файлов .pyc. Почти секунда на старте — то, ради чего их кладут заранее.
Тут легко ошибиться в объяснении, и я едва не ошибся. «Первый импорт медленнее второго» — наблюдение, которое одинаково хорошо объясняется и компиляцией байт-кода, и холодным дисковым кэшем. Разделяют их только сами файлы:
| стратегия | .pyc до импорта | после | новых | переписано |
|---|---|---|---|---|
| naive | 1007 | 1007 | +0 | 0 |
| slim | 1007 | 1007 | +0 | 0 |
| multistage | 1091 | 1091 | +0 | 0 |
| uv | 1 | 253 | +252 | 0 |
| uv-compiled | 688 | 688 | +0 | 0 |
Механизм установлен: uv без флага компилирует 252 файла при первом импорте. И вот следствие, которое важнее самой секунды: дописанный байт-код живёт в записываемом слое контейнера и исчезает вместе с ним. Это не «первый запуск дороже» — это каждый запуск дороже. В Kubernetes — каждый под, при каждом рестарте.
Заметьте колонку «переписано». Считать файлы недостаточно, и первая версия пробы именно считала: устаревший байт-код Python компилирует на месте — файл тот же, число файлов не меняется, и счётчик покажет «+0» ровно там, где работа делается на каждом запуске. Проба смотрит на время изменения каждого файла.
Кстати, pip компилирует байт-код при установке сам, по умолчанию. Поэтому пара «с компиляцией / без» — это uv и uv-compiled, а плечо multistage на pip уже скомпилировано. Прочитать таблицу как «uv даёт образ легче pip» и не заметить этого — значит сравнить образ с байт-кодом и образ без него.
Чего этот замер не объясняет. Плечи с venv (multistage, uv-compiled) стартуют примерно вдвое дольше плеч, ставящих в системный интерпретатор (slim, naive), — и это отношение держится во всех кругах обоих прогонов. Байт-код здесь ни при чём: у всех четырёх он на месте, ничего не дописывается и не переписывается. Разбор импортов через -X importtime показывает, что дороже обходятся те же модули, включая стандартную библиотеку, которая в обоих случаях одна и лежит по одному пути. Это указывает скорее на чтение с диска, чем на работу интерпретатора, — но указывает, а не доказывает, и честный вывод здесь один: наблюдение записано, механизм не установлен.
distroless собрался и не запустился
Distroless — образ без дистрибутива: ни оболочки, ни менеджера пакетов, ни утилит. Смысл не в размере — по весу он проигрывает аккуратной многоступенчатой сборке, — а в поверхности атаки: чего в образе нет, того в нём и не запустить.
Первая сборка прошла безупречно. Контейнер упал при запуске:
$ docker run --rm py-tooling/distroless:bench 2>&1 | tail -1
ImportError: libgcc_s.so.1: cannot open shared object file: No such file or directory
Колёса с нативным кодом — здесь это pydantic-core и orjson, оба на Rust — рассчитывают найти системные библиотеки в дистрибутиве. В distroless дистрибутива нет, и libgcc в базовый образ не входит. Лечится одной строкой:
COPY --from=build /lib/x86_64-linux-gnu/libgcc_s.so.1 /lib/x86_64-linux-gnu/
Общее правило: distroless — это не «то же самое, только меньше». Всё, что зависимости ожидают от дистрибутива, придётся принести руками, и список узнаётся не на сборке, а на первом запуске. Планируя переход, закладывайте на это время.
Вторая особенность: официальный distroless/python3 приносит свою версию Python, и она не 3.14. Окружение, собранное под 3.14, на ней не заведётся, поэтому интерпретатор приходится везти отдельно — автономной сборкой через uv python install. И пути обязаны совпадать: окружение помнит, каким интерпретатором создано, по абсолютному пути. Скопировать его в другое место — получить образ, который собирается без единой жалобы и падает при первом запуске.
Что из этого следует
uv — очевидный выбор, но выигрыш не там, где ожидается. На холодном кэше он быстрее pip вчетверо, а не на порядок. Настоящий разрыв — на тёплом кэше и на повторном запуске: 18x и 41x. Если ваш CI восстанавливает кэш (а он должен), переход на uv экономит не проценты, а разы.
Poetry проигрывает не там, где о нём думают. На холодном кэше он отстаёт от uv на треть — это ничто. На тёплом — в пять с половиной раз, на повторном запуске — в пятьдесят пять. Его цена платится там, где работы почти нет.
Ротируйте порядок — и проверьте, что ротаций действительно две. «Тёплый идёт после холодного» звучит как свойство задачи, а на деле это свойство вашего сценария: кэш можно наполнить вне замера. Но одной ротации мало: если два порядка заданы связанными ключами, они образуют один фактор под двумя именами, и разложение по любому из них ничего не доказывает. Считайте не сбалансированность каждого порядка, а число различных пар позиций.
Задавайте состояние кэша явно, когда меряете сами. «Сколько занимает install» — вопрос без ответа. Три состояния — минимальный набор; какое из них ваше, зависит от того, чиним ли мы CI или ждём у себя на машине.
Не сравнивайте, пока не сверили результат. Хеш набора установленных пакетов, хеш ответа приложения — что угодно, лишь бы «быстрее» не означало «сделано меньше». И роняйте свою проверку нарочно: проверка, ни разу не покрасневшая, не проверена.
Тонкая база — почти весь выигрыш, если временные файлы не оставляют слоя. 1250 МиБ → 185. Многоступенчатая сборка на этом приложении по размеру даёт столько же (188), а COPY с последующим rm возвращает 50,9 МиБ архивов обратно. Дальнейшая борьба за мегабайты приносит проценты и стоит заметно дороже.
--compile-bytecode в образ обязателен. Он добавляет 19 МиБ и снимает почти секунду с каждого старта. Байт-код, скомпилированный внутри контейнера, умирает вместе с ним, поэтому эту работу платит каждый под, а не первый.
Не смешивайте семейства размеров. Сжатый — про реестр и сеть, распакованный — про диск узла. Что показывает docker images, зависит от хранилища.
Границы всего сказанного. Набор — 51 пакет, преимущественно с готовыми колёсами; проект, где что-то собирается из исходников, даст другую картину, и разница между инструментами там будет меньше, потому что время уйдёт в компиляцию. Версии зафиксированы: Python 3.14.7, uv 0.12.5, Poetry 2.3.1, pip 26.0, Docker 29.7.2 с containerd-хранилищем. Числа установки сняты с локального индекса — свои снимайте у себя, потому что канал до индекса влияет сильнее, чем выбор инструмента.
Как это устроено в других языках
Минимальные образы Rust — там та же многоступенчатая схема доведена до логического предела: статическая сборка и scratch без единой системной библиотеки. Python так не умеет принципиально, и libgcc из раздела про distroless — ровно про эту разницу.


Комментарии