
Именно здесь Python по-настоящему незаменим: обработка данных. Но исследовательский notebook и продакшн-сервис — разные миры, и переход между ними ломается предсказуемым образом. Статья — про эту границу и про то, что её пересекает: чтение Parquet, отбор, типы. Про инференс моделей в конце сказано ровно столько, сколько можно сказать без собственного стенда, и не больше.
Про «pandas против polars» обычно спорят секундами. Я решил спросить о другом — не «кто быстрее», а кто вообще не полез в данные, которые ответу не нужны. Этот вопрос отвечается целым «да/нет», переживает перенос на другую машину и, в отличие от секунд, объясняет причину.
digital-cookbook/python/typing-and-data
В статье
- Вопрос без секундомера
- Пять способов задать один вопрос
- Почему ленивость — это не про скорость
- Чего этот замер не говорит
- Что ломается при переносе из notebook
- За границей этого стенда: инференс
- Python как тонкий слой
- Что из этого следует
Вопрос без секундомера
Сперва я собирался мерить прочитанные байты: сколько данных движок затребовал у файловой системы. Счётчик есть — rchar в /proc/self/io, объём, запрошенный системными вызовами чтения. Получилось так:
pandas, чтение целиком     3 181 377 Б
polars, чтение целиком        23 280 Б
Два порядка на одной и той же работе. Не потому, что polars волшебный, а потому, что он отображает файл в память, а счётчик считает только системные вызовы. Оба числа настоящие, и означают они разное.
Обойти не вышло. У scan_parquet нет параметра, отключающего отображение. Подсунуть свой считающий файловый объект тоже нельзя: получив файловый объект вместо пути, polars перестаёт пробрасывать отбор к чтению — то есть ломается ровно то, что измеряется.
Поэтому мера сменилась. Вместо «сколько прочитано» — «а можно ли было прочитать».
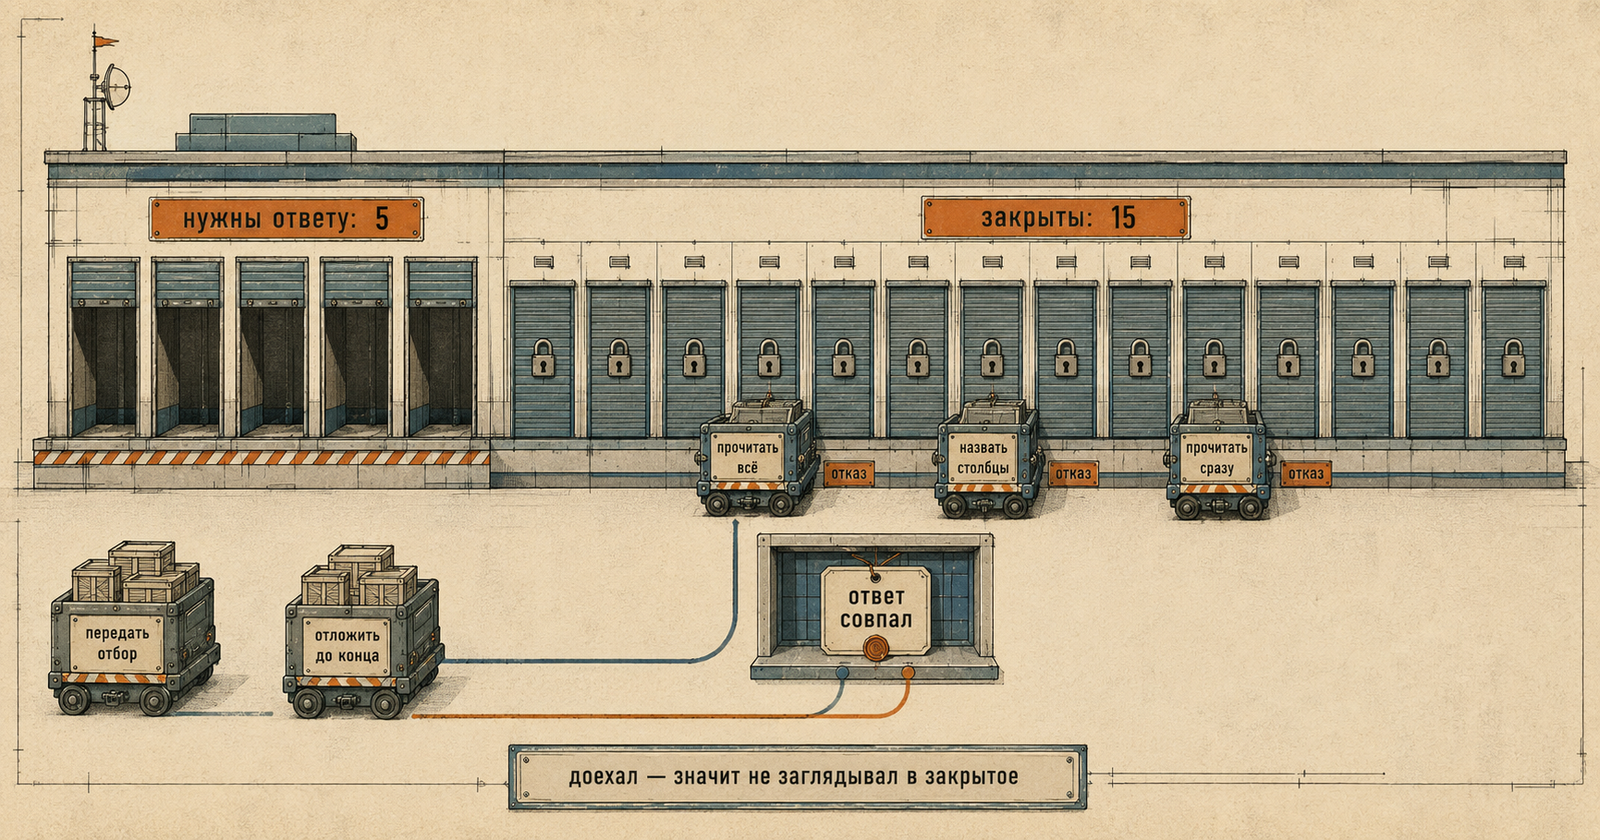
Данные лежат разделами Parquet: 200 000 строк, 20 разделов по дням. Запрос берёт первые пять. Пятнадцать остальных перед прогоном делаются физически нечитаемыми, и дальше всё решается само: движок, который в них не заглядывал, доходит до ответа; движок, который полез читать всё, получает отказ в доступе.
Это устроено одинаково для обоих движков и не зависит ни от способа чтения, ни от страничного кэша.
Пять способов задать один вопрос
Вопрос один: сумма по категориям за ранние дни.
| способ | всё доступно | лишнее закрыто |
|---|---|---|
| pandas, прочитать всё | дошёл | отказ в доступе |
pandas с columns= |
дошёл | отказ в доступе |
pandas с filters= |
дошёл | дошёл |
polars, read_parquet |
дошёл | отказ в доступе |
polars, scan_parquet |
дошёл | дошёл |
Первый столбец — контроль, и без него второй ничего не значил бы: способ, падающий всегда, «избегает лишней работы» ровно так же, как тот, что избегает её по делу.
Ответ у всех дошедших один и тот же — это отдельная проверка, и она главная. Способ, отбросивший лишнее вместе с нужным, выглядит как самый расторопный участник: дошёл там, где другие упали. Без сверки ответа это прошло бы за успех, а было бы потерей данных.
Вот что говорит движок, когда лезет в закрытое:
$ python scripts/analyze-data.py
# (выдержка из «что сказал движок»: плечи pandas-full и polars-eager, у pandas убран хвост «. Detail: …»)
pandas   [Errno 13] Failed to open local file '/data/day_bucket=10/part.parquet'
polars   Permission denied (os error 13): /data/day_bucket=10/part.parquet
Обратите внимание на строку с columns=. Столбцы названы — и это действительно избавляет от чтения ненужных колонок, — но разделы всё равно читаются все. Проекция и отбор строк это разные пробросы, и первый не подразумевает второго.
# читает все 20 разделов, хотя нужны 5
frame = pd.read_parquet(path, columns=["day_bucket", "category", "amount_cents"])
picked = frame[frame["day_bucket"] < 5]

# читает 5 разделов
frame = pd.read_parquet(path, columns=["day_bucket", "category", "amount_cents"],
                        filters=[("day_bucket", "<", 5)])
Разница между этими двумя строками — не в скорости, а в том, что во втором случае отбор доезжает до слоя, который открывает файлы. В первом он выполняется после того, как всё уже прочитано.
Почему ленивость — это не про скорость
У polars те же две строки выглядят так:
# читает все разделы: кадр материализуется целиком, потом фильтруется
frame = pl.read_parquet(path, hive_partitioning=True)
result = frame.filter(pl.col("day_bucket") < 5).group_by("category").agg(...)

# читает 5 разделов: план строится целиком и только потом выполняется
result = (pl.scan_parquet(path, hive_partitioning=True)
          .filter(pl.col("day_bucket") < 5)
          .group_by("category")
          .agg(...)
          .collect())
Разница между read_parquet и scan_parquet — не в том, что второй быстрее считает. Она в том, что scan_parquet не выполняет ничего до collect(), и к моменту выполнения движок знает весь запрос целиком: какие столбцы понадобятся, какие строки отсеются. Это знание он и пробрасывает вниз, к чтению файлов.
read_parquet знать этого не может по построению: когда он читает, фильтра ещё не существует — тот появится строкой ниже.
Отсюда практическое правило, которое стоит запомнить вместо любых чисел: ленивость даёт выигрыш ровно там, где запрос известен раньше, чем начинается чтение. Если вы всё равно материализуете весь кадр и потом работаете с ним в памяти, отбрасывания разделов не будет — именно оно в этом стенде и составляет всю разницу. Прочее ленивость при этом не теряет: проекция названных столбцов, перестановка операций в плане, потоковое выполнение остаются при ней. Пропадает конкретно то, что здесь измерено.
И тот же довод объясняет, почему сравнение «pandas против polars» обычно поставлено неверно. В таблице выше у каждого движка есть строка, где он читает лишнее, и строка, где не читает. Различает их не библиотека, а способ, которым задан вопрос.
Чего этот замер не говорит
Ничего про скорость. Способ, не полезший в закрытые разделы, не обязан быть быстрее — он именно что не сделал работу. Сколько стоит разбор, распаковка и сама группировка, здесь не измерялось вовсе; про счётную часть — в статье про производительность.
Ничего про память. Ленивый план не обязан держать меньше — он обязан меньше читать.
Ничего про большие данные. Набор — 200 000 строк и два с небольшим мегабайта. На таком объёме разница в секундах была бы неразличима, и именно поэтому мера выбрана счётная: она не зависит от размера.
Ничего про сжатые файлы. Сжатие в стенде выключено намеренно, чтобы объёмы не зависели ещё и от того, как хорошо сжались именно эти байты.
Версии зафиксированы: Python 3.14.7, pandas 3.0.5, polars 1.44.0, pyarrow 25.0.1. Умолчания движков меняются от релиза к релизу, и часть строк таблицы держится именно на умолчаниях.
Отдельно стоит сказать про то, что стенд поймал у самого себя. Сперва закрывались поздние разделы, а запрос брал ранние — и падали все пять способов, включая умеющие отбрасывать. Причина в порядке действий: схему набора оба проверенных движка выводят по первому найденному файлу, до всякого отбора, и первым оказывался закрытый раздел. Это не изъян движков — не зная столбцов, план построить не из чего, — но и не закон природы. Откуда берётся схема, решает реализация: движок может взять её из метаданных каталога, из переданного описания, из общего футера — и тогда первого чтения не будет. Проверено здесь одно: pandas 3.0.5 и polars 1.44.0 на наборе без каталога и без объявленной схемы открывают первый файл до отбора. Если вы раскладываете данные по разделам и рассчитываете на отбрасывание, это стоит проверить на своём движке — так же, как проверено здесь: закрыть лишнее правами и посмотреть, дойдёт ли запрос.
Что ломается при переносе из notebook
Замер выше — про одну конкретную ошибку, но она из семейства. Исследовательский код почти весь построен на допущении «данные помещаются и читаются целиком», и в проде это допущение перестаёт выполняться раньше всего остального.
Чтение целиком. В notebook read_parquet(path) — правильный ход: данные нужны все, вы их разглядываете. В сервисе тот же вызов означает, что каждый запрос тянет весь набор.
Индекс как состояние. pandas тащит индекс через все операции, и в интерактивной работе это удобно. В пайплайне индекс — источник сюрпризов при слияниях и конкатенациях; в polars его нет вовсе, и это одна из причин, почему код на нём переносится предсказуемее.
Типы, выведенные по данным. Прочитали CSV — получили типы, которые вывелись из этой конкретной выгрузки. Завтра в столбце появится пустое значение, и int64 станет float64 или object, а код останется прежним. В проде схему надо объявлять, а не выводить; про то, как объявленный тип защищает и где перестаёт, — в статье про типизацию.
Порядок строк. В notebook он случайно стабилен и на него незаметно начинают опираться. Ни один движок его не гарантирует после группировки.
Parquet и Arrow вместо CSV. CSV не хранит типов, и это главное: схему приходится выводить по данным со всеми последствиями из абзаца выше. Со столбцами тоньше. Отбросить лишние на уровне файла формат не даёт — колонки лежат в строках, и строку всё равно надо разобрать целиком; но выбрать нужные при разборе можно, read_csv(usecols=...) именно это и делает, экономя память, а не чтение. Отбрасывание разделов — свойство раскладки по каталогам, а не формата: Arrow Dataset умеет и разделы, и проекцию поверх CSV-набора. Точная формулировка такая: в том виде, в каком мерилось выше — через read_parquet и scan_parquet — с CSV не вышла бы ни одна строка таблицы, а экономия чтения внутри файла для него недостижима в принципе. Arrow при этом стоит воспринимать не как формат файла, а как общий формат в памяти: он и есть причина, по которой данные могут переезжать между pandas, polars и стрелочными библиотеками без копирования. Именно «могут»: без копирования обходится передача буфера, представление которого у обеих сторон уже совпадает. Смена типа, склейка кусков, приведение к внутреннему представлению pandas, работа со строками — каждое из этого способно вернуть копию, и документация polars говорит о возможности zero-copy, а не о гарантии. Практический вывод: рассчитывать на бесплатность перехода можно, только если вы её измерили на своих данных.
За границей этого стенда: инференс
Замеры выше — про обработку данных, и на инференс они не распространяются. Своего стенда для моделей у меня нет, а без него утверждать что-либо о числах я не стану: ни контракта модели, ни проверки совместимости артефакта, ни контроля схемы признаков здесь не проверено. Поэтому раздел не претендует на роль руководства — это перечень мест, где придётся принимать решения, и он нужен, чтобы граница статьи была видна.
Полноценный разбор инференса требует отдельного стенда: версии артефакта, схема признаков на входе, поведение при несовпадении версий модели и сервиса. Это тема самостоятельной статьи, и ставить её в конец статьи про Parquet было бы обещанием, которого текст не выполняет.
Обучение и инференс — разные приложения. У них разные зависимости, разное железо, разный ритм выпуска и разные требования к задержке. Единственное, что их связывает, — артефакт модели, и связывать их сильнее не стоит.
Модель — версионируемый артефакт, а не файл рядом с кодом. У неё должна быть версия, воспроизводимые условия обучения и понятная связь «эта версия сервиса работает с этой версией модели». Иначе первый же откат сервиса оставит вас с моделью, обученной на других данных.
Батчинг решает не ту задачу, что кажется. Он повышает пропускную способность за счёт задержки отдельного запроса. Если у вас интерактивный сценарий с бюджетом в десятки миллисекунд, батчинг может оказаться прямым вредом; если фоновая обработка — почти всегда выигрыш. Величина выигрыша целиком зависит от модели и оборудования, и переносить чужие числа сюда бесполезно.
Синхронный инференс — обычный ASGI-сервис, и все вопросы эксплуатации у него обычные: воркеры, корректное завершение, наблюдаемость. Про это есть отдельная статья серии — production-практики, и ничего специфически «ML-ного» в этой части нет.
Оговорка существенная: синхронный запрос-ответ — не единственная форма. Пакетная обработка по расписанию, потребитель очереди и gRPC-служба с потоковым обменом устроены иначе — у них другая модель нагрузки, другое место для батчинга и другие отказы. Сводить инференс к HTTP-обработчику неверно; здесь я лишь говорю, что эта его форма не требует особого обращения.
Наблюдаемость данных отдельно от наблюдаемости сервиса. Сервис может быть идеально здоров — отвечает быстро, ошибок нет, — и при этом выдавать всё более бессмысленные предсказания, потому что входные данные ушли от тех, на которых модель обучалась. Метрики задержки этого не покажут; нужны метрики распределений входов и выходов.
Python как тонкий слой
Стоит договориться о том, что здесь вообще исполняется. В polars тяжёлая часть написана на Rust, в pandas и NumPy — на C, в pyarrow — на C++. Python в этих сценариях не считает; он строит план и вызывает.
Отсюда два следствия, которые обычно упускают.
Векторизация — это не «быстрее», а «не на Python». Цикл по строкам кадра выполняется интерпретатором, векторная операция — скомпилированным ядром над непрерывной памятью. Разница не в проценте, а в том, кто делает работу.
Границу пересекать дорого, и чем чаще, тем хуже. Вызов Python-функции на каждую строку — например, apply с лямбдой — возвращает вычисление обратно в интерпретатор и обнуляет преимущество ядра. Одна операция над миллионом строк и миллион операций над строкой — это разные вещи, даже если выглядят одинаково.
Про то, где заканчивается «тонкий слой» и начинается смысл писать нативное расширение, — в статье про производительность.
Что из этого следует
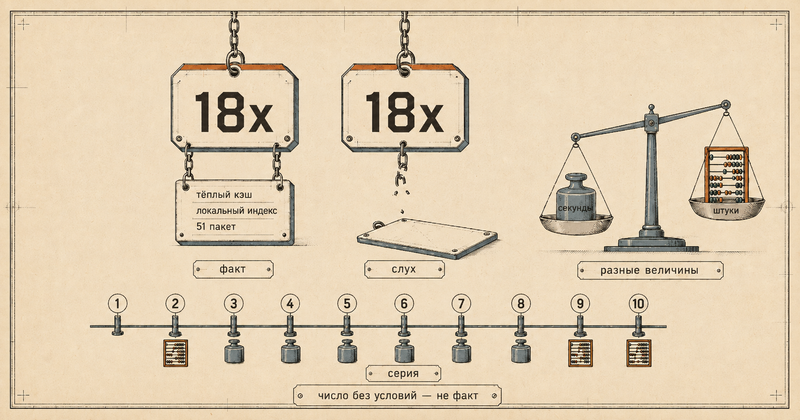
Спрашивайте «сколько работы удалось не сделать», а не «что быстрее». Первое объясняет причину и переносится, второе зависит от машины. В таблице выше нет ни одной секунды, и она при этом отвечает на исходный вопрос лучше, чем любой замер длительности.
Проекция и отбрасывание разделов — разные пробросы. columns= не подразумевает filters=. Строка с названными столбцами в матрице читает все двадцать разделов.
Ленивость выигрывает там, где запрос известен до чтения. scan_parquet полезен не сам по себе, а потому, что к моменту выполнения движок видит запрос целиком. Материализуете кадр сразу — теряете отбрасывание разделов, то есть ровно тот выигрыш, который здесь мерился; проекция и оптимизация плана от этого не исчезают.
Различает не библиотека, а способ. У обоих движков в таблице есть и строка, где они читают лишнее, и строка, где не читают.
Оба проверенных движка открыли первый файл до отбора — чтобы узнать, какие есть столбцы. Набор в стенде был без каталога и без объявленной схемы; откуда движок берёт схему в других условиях, решает реализация. Практический вывод не в том, что первое чтение неизбежно, а в том, что рассчитывать на «не тронет ничего» нельзя, не проверив это на своём движке и своей раскладке.
Данные раскладывайте по разделам так, как их спрашивают. Отбрасывание работает только по тому, что вынесено в разделы; фильтр по столбцу внутри файла его не включит.
У части про инференс нет собственных чисел, и это осознанно. Всё сказанное там — про устройство: разделение обучения и выдачи, версионирование артефакта, батчинг как обмен задержки на пропускную способность, отдельная наблюдаемость данных. Контракт модели, совместимость артефакта и контроль схемы признаков остались за границей статьи целиком — они требуют своего стенда.
Границы всего сказанного. Набор — 200 000 строк, 20 разделов, сжатие выключено, хеш dd606381bdd3474a. Измерено, читал ли движок лишнее, — не время, не память и не поведение на больших объёмах. Версии зафиксированы, и часть выводов держится на умолчаниях этих версий.
Как это устроено в других языках
Данные и аналитика на JVM — там колоночные форматы пришли из Hadoop-мира и стали стандартом раньше; проброс отбора в чтение — базовое ожидание от любого движка. Разница с Python не в возможностях, а в том, что здесь два подхода — жадный и ленивый — сосуществуют в одной экосистеме, и выбирать между ними приходится в каждой строке кода.

Комментарии