
SQLAlchemy — стандарт доступа к реляционным БД в Python, и он же источник половины проблем с производительностью, если использовать его вслепую. Разберём слои — от сырого драйвера до полного ORM — и где проходит граница между удобством и контролем.
Все числа ниже сняты на стенде: пять способов задать вопрос базе, пять разных вопросов, побайтово одинаковый ответ, одиннадцать кругов. Главный результат оказался не про то, насколько ORM дороже, а про то, при каких условиях этот вопрос вообще имеет смысл.
digital-cookbook/python/data-access
В статье
- Четыре слоя и что между ними
- Сколько стоит слой
- Что происходит, когда работает база
- N+1: считайте запросы, а не миллисекунды
- В async ленивая загрузка не работает — и это правильно
- Alembic: что видит автогенерация и что возвращает откат
- Что из этого следует
Четыре слоя и что между ними
Между вашим кодом и PostgreSQL стоит от одного до трёх слоёв, и каждый следующий берёт на себя работу, которую иначе делали бы вы.
Драйвер — минимум. asyncpg отдаёт строки как записи, похожие на кортежи, приводит типы PostgreSQL к типам Python и на этом останавливается.
# драйверу нужен обычный URL PostgreSQL
conn = await asyncpg.connect("postgresql://user:pass@host/db")
rows = await conn.fetch(
    "SELECT id, author_id, title, published, price, pages "
    "FROM books ORDER BY id"
)
SQLAlchemy Core — выражения вместо строк. SQL вы всё ещё описываете сами, но структурой, а не текстом: выражение собирается из объектов, параметры уходят связанными, диалект подставляется под базу. Проверяется при этом структурная корректность — что вы не смешали несовместимое и не склеили строку руками; существование таблиц и столбцов и семантику SQL Core до выполнения не проверяет, это по-прежнему работа базы.
# SQLAlchemy требует URL с диалектом И драйвером — тот же адрес, другая схема
engine = create_async_engine("postgresql+asyncpg://user:pass@host/db")
stmt = (
    select(books.c.id, books.c.author_id, books.c.title,
           books.c.published, books.c.price, books.c.pages)
    .order_by(books.c.id)
)
async with engine.connect() as sa_conn:
    result = await sa_conn.execute(stmt)
ORM — объекты вместо строк. Появляются identity map, отслеживание изменений, связи между сущностями. В версии 2.0 модели типизированы, и это не косметика: mypy наконец видит, что book.price — Decimal, а не Any.
class Book(Base):
    __tablename__ = "books"

    id: Mapped[int] = mapped_column(primary_key=True)
    author_id: Mapped[int] = mapped_column(ForeignKey("authors.id"))
    title: Mapped[str]
    price: Mapped[decimal.Decimal] = mapped_column(Numeric(8, 2))

    author: Mapped["Author"] = relationship(back_populates="books")
    reviews: Mapped[list["Review"]] = relationship(back_populates="book")
Дальше — числа. Но прежде о том, как они получены, потому что без этого их незачем читать.
Сравнивать «SQLAlchemy против asyncpg» напрямую нельзя: у asyncpg нет синхронного интерфейса, поэтому синхронное плечо неизбежно оказывается на другом драйвере, и разница «синхронный против асинхронного» становится неотделима от разницы драйверов. На стенде плеч поэтому пять, и каждое сравнение меняет ровно одну вещь: слой при том же драйвере, драйвер при том же слое, модель при том же и другом.
Все пять обязаны вернуть побайтово одинаковый результат — это блокирующая проверка, и она сразу окупилась. Оказалось, что в SQLAlchemy 2.0 три способа поделить на сто дают три разных SQL:
| в выражении Core | в SQL |
|---|---|
pages / 100 |
books.pages / CAST(100 AS NUMERIC) |
pages // 100 |
books.pages / %(pages_1)s |
pages.op("/")(100) |
books.pages / 100 |
Оператор / честно переносит в SQL семантику Python, где деление истинное. В сыром SQL на целых операндах оно целочисленное. Плечи считали разные величины при одинаковом на вид коде — и это не курьёз стенда, а то, что в обычном проекте живёт годами.
Сколько стоит слой
Пять запросов с разным объёмом материализации: одна строка; пять тысяч строк; тяжёлая агрегация, отдающая дюжину строк; и один и тот же тяжёлый запрос на 516 книг в двух видах — когда ORM отдаёт отображения строк и когда строит из них объекты.
Доля от сырого драйвера — во сколько раз дороже, медиана по одиннадцати кругам и наблюдённый размах:
| плечо | одна строка | 5000 строк | агрегат | 516 строк | 516 объектов |
|---|---|---|---|---|---|
| SQLAlchemy Core | 1,53x (1,46–1,74) | 1,30x (1,07–1,52) | 1,02x (0,99–1,15) | 1,09x (1,00–1,22) | 1,06x (0,91–1,32) |
| ORM, asyncpg | 4,75x (4,55–5,11) | 3,73x (3,38–4,10) | 1,09x (1,03–1,34) | 1,17x (1,07–1,45) | 1,37x (1,16–1,55) |
| ORM, psycopg async | 5,54x (5,20–5,90) | 3,41x (2,78–3,93) | 1,11x (1,03–1,19) | 1,14x (1,07–1,31) | 1,34x (1,17–1,60) |
| ORM, psycopg sync | 4,12x (3,91–4,24) | 3,25x (2,93–3,85) | 1,11x (1,00–1,15) | 1,14x (1,05–1,27) | 1,28x (1,13–1,50) |
Разброс по кругам ни в одной клетке не превысил полутора раз, так что помеченных как непригодные для ранжирования здесь нет.
Первое, что стоит увидеть: Core и ORM — величины разного порядка. Core прибавляет половину на одной строке и треть на пяти тысячах; ORM — впятеро и втрое. Если вы уходите от ORM «ради скорости», а приходите в Core, вы получаете почти всё, что можно получить, не отказываясь от выражений.
Порядок, в котором запросы выполняются внутри плеча, ротируется от круга к кругу — как и порядок самих плеч. А для пары, о которой пойдёт речь ниже, порядок ещё и контрбалансирован: одной ротации там мало, и почему — скажу на месте.
Второе: абсолютные величины. Одна строка через ORM — 0,82 мс против 0,17 мс через драйвер. Разница пятикратная, а в абсолюте — шесть десятых миллисекунды, которые в веб-запросе с походом в базу заметит только профилировщик.
Полезнее смотреть на цену одной строки, очищенную от постоянных издержек запроса. Считается как разность времени на пяти тысячах строк и на одной, делённая на 4999: так уходит путь до базы, разбор ответа и всё, что не растёт с числом строк.
| плечо | мкс на строку |
|---|---|
| asyncpg | 3,53 |
| SQLAlchemy Core | 4,64 |
| ORM | 11,7–13,4 |
Вот это число и стоит держать в голове: каждая строка, превращённая в объект, стоит порядка десятка лишних микросекунд. На двадцати строках — доли миллисекунды, никто не заметит. На пятидесяти тысячах — около полусекунды, и это уже архитектурное решение, а не деталь.
Порядок величины здесь важнее самой цифры, и ниже будет видно, почему: тот же расход, измеренный иначе, выходит почти вдвое меньше.
Отдельно про асинхронность. На одной строке синхронное плечо дешевле асинхронного при том же драйвере и слое: 4,12x против 5,54x, и размахи (3,91–4,24 против 5,20–5,90) не пересекаются. На пяти тысячах строк разница исчезает — 3,25x против 3,41x, размахи перекрываются. Постоянная надбавка цикла событий тонет в работе, которая растёт с числом строк. Это ровно тот же механизм, что описан в статье про asyncio: асинхронность окупается ожиданием, а не вычислением.
Что происходит, когда работает база
Здесь легко сделать вывод шире измеренного, и я его сделал — дважды. Разберу оба раза, потому что случай показательный: числа были верны, а названо ими было не то.
Стенд измеряет не только сами плечи, но и собственную разрешающую способность:
| запрос | клиент, мс | из них сервер, мс | доля сервера |
|---|---|---|---|
| одна строка | 0,180 | 0,008 | 4% |
| 5000 строк | 19,362 | 3,412 | 18% |
| тяжёлый агрегат | 14,939 | 14,592 | 98% |
| 516 строк | 13,711 | 12,423 | 91% |
| 516 объектов | 12,995 | 11,788 | 91% |
Первая версия вывода. На тяжёлом агрегате все плечи улеглись в 0,94–1,23 от сырого драйвера, и напрашивалось: цена слоя растворяется в работе базы. Правдоподобно, укладывается в общую логику — и неверно.
Дело в том, что агрегат не ложится на сущность. Считать среднюю оценку по группам через модель нечем, поэтому ORM-плечи выполняют там то же выражение, что и Core, и отдают строки-отображения. Объектов нет, identity map не работает, материализовать нечего. Измерено было честно, но не то: у скалярного агрегата тонут накладные расходы сессии и драйвера, а вовсе не цена превращения строк в объекты.
Вторая версия. Появился запрос, отдающий 516 книг, и он показал, что цена ORM никуда не исчезает. Но сравнивать его с агрегатом как «тот же запрос, только с объектами» тоже нельзя: это разные запросы, с разной группировкой и разным временем сервера — 13,7 против 11,0 мс.
Третья, и вот она уже контролируемая. Один и тот же запрос выполняется дважды: в первый раз ORM отдаёт отображения строк, во второй строит из них объекты. SQL дословно совпадает, сервер делает ровно одну и ту же работу.
Здесь пришлось повозиться отдельно. Мало ротировать порядок запросов: циклический сдвиг балансирует их позиции, но не относительный порядок пары. В списке из пяти запросов «строки» стоят перед «объектами», и лишь один сдвиг из пяти меняет их местами — за одиннадцать кругов выходило девять к двум. Для контролируемой пары это почти то же самое, что не ротировать вовсе. Поэтому порядок внутри пары задан явно и чередуется: в снятой фикстуре пять кругов одним порядком, шесть другим у каждого плеча.
Разность считается покругово: оба запроса одного круга сняты при общем состоянии машины.
| плечо | знак разности | медиана | межквартильный размах |
|---|---|---|---|
| asyncpg | 7 из 11 | +0,15 мс | −0,66 … +1,16 |
| Core | 3 из 11 | −0,48 мс | −0,81 … +0,05 |
| ORM, asyncpg | 11 из 11 | +2,45 мс | +1,35 … +3,05 |
| ORM, psycopg async | 11 из 11 | +2,76 мс | +2,47 … +2,88 |
| ORM, psycopg sync | 11 из 11 | +2,42 мс | +1,80 … +2,92 |
Верхние две строки — контроль: для сырого драйвера и Core эти два запроса неразличимы по построению, и разность у них обязана гулять вокруг нуля. Так и вышло — семь и три круга из одиннадцати.
У всех трёх ORM-плеч знак положителен во всех одиннадцати кругах, а контрольные такого поведения не показывают. Складывать эти три результата в одно число было бы неправильно: плечи меряются на одной машине, делят кэши и попадают в одни и те же провалы, так что независимыми свидетельствами они не являются. Но каждое по отдельности говорит одно и то же, и ни одно не спорит.
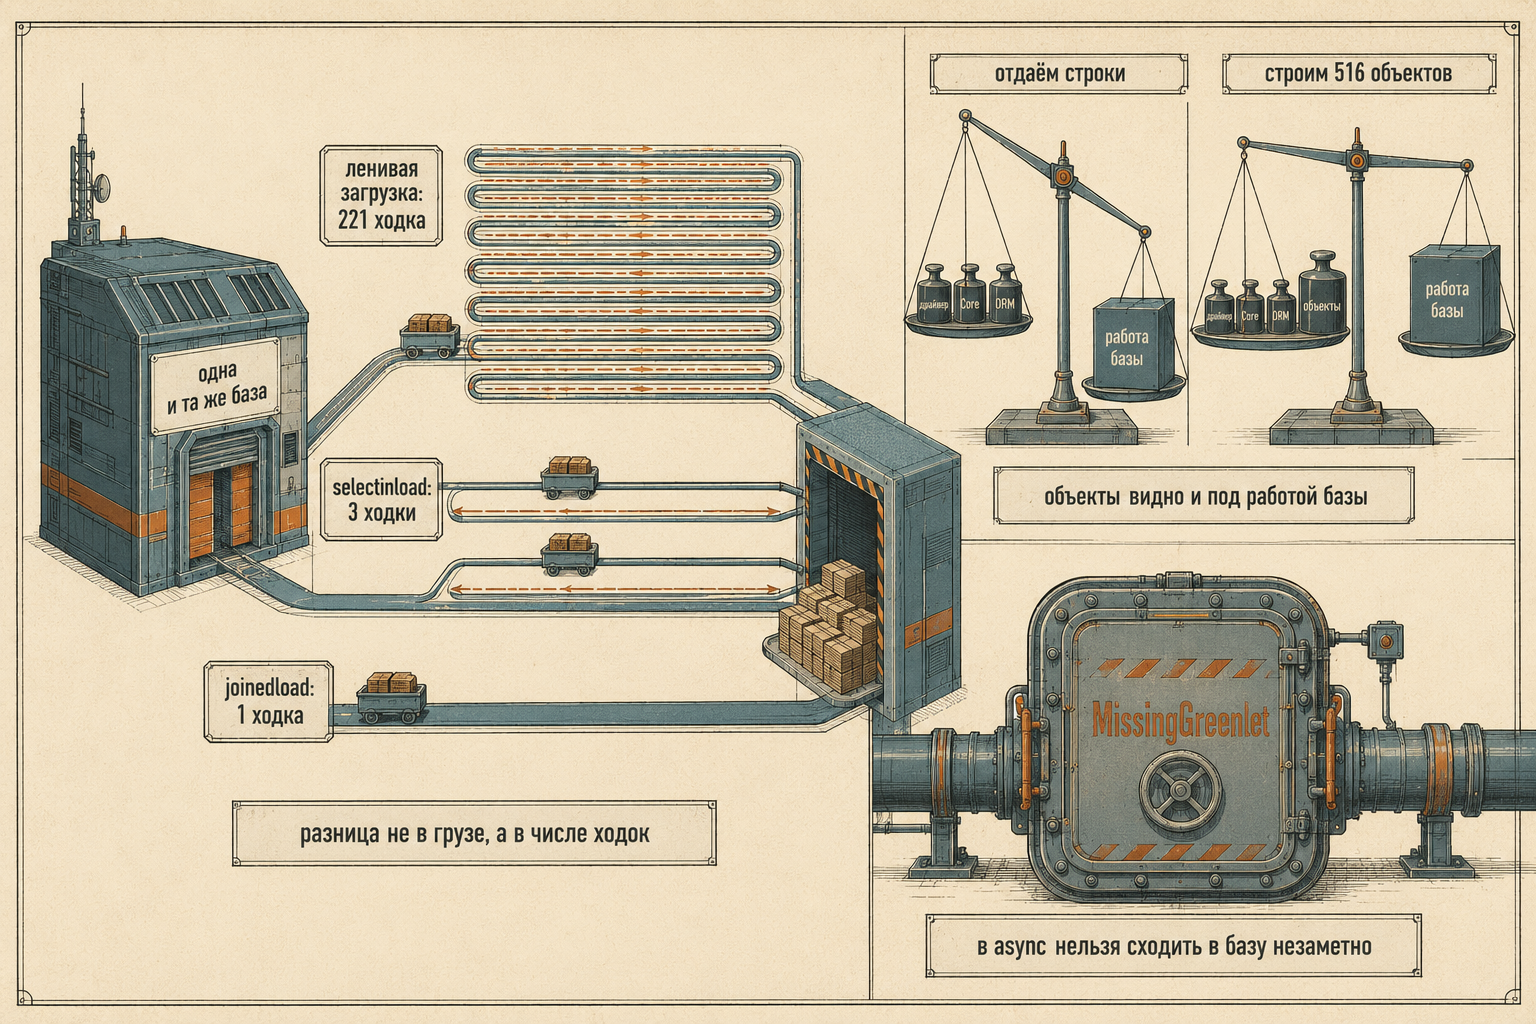
Цена ORM не исчезает, когда работает база. При девяноста одном проценте времени на сервере построение 516 объектов стоит 2,4–2,8 мс. Исчезает эта цена там, где материализовать нечего.
Почему я опираюсь на знак, а не на разброс, стоит сказать прямо. Полные размахи здесь перекрываются: у Core один выпавший круг растянул его до плюс четырёх миллисекунд, и формально этот размах накрывает все ORM-плечи. Межквартильные размахи не пересекаются вовсе. Знак же к выбросам нечувствителен вообще — потому он и вынесен в первый столбец.
А вот дальше — оговорка, которая интереснее самого вывода. Те же объекты обходятся здесь примерно в пять микросекунд каждый, тогда как из замера на пяти тысячах строк выводится восемь-десять. Одна и та же операция, два способа измерить — расхождение почти вдвое. Значит «цена пропорциональна числу строк» — грубое правило, а не закон: порядок величины оно даёт, точное предсказание — нет.
Практический вывод получается такой: цену ORM задаёт объём материализации, а не тяжесть запроса. Отчёт, который считает полчаса и возвращает двадцать строк, через ORM почти ничего не потеряет. Отчёт на сто тысяч строк потеряет заметно — но оценивать это надо замером на своих данных, а не умножением на константу из чужой статьи.
Тот же сюжет был в сравнении web-фреймворков, где цена фреймворка растворялась в двадцати миллисекундах ожидания. Разница в том, что там растворялась вся цена целиком, а здесь — только та её часть, которая не зависит от объёма результата.
N+1: считайте запросы, а не миллисекунды
Здесь стенд меряет не время. Число запросов — целое, и оно одинаково на ноутбуке и на сервере, тогда как миллисекунды зависят от всего подряд. Считается оно на стороне базы, через pg_stat_statements: счётчик по событиям SQLAlchemy видел бы только то, что она сама отправила.
Задача: загрузить двадцать авторов со всеми их книгами и всеми отзывами к каждой книге.
| стратегия | запросов | строк с сервера | мс |
|---|---|---|---|
| ленивая, по умолчанию | 221 | 2215 | 113,1 |
selectinload |
3 | 2215 | 32,6 |
joinedload |
1 | 1995 | 31,4 |
Загружено при этом одинаково — 200 книг, 1995 отзывов, и стенд это проверяет: стратегия, обошедшаяся одним запросом потому, что ничего не загрузила, выглядела бы в таблице лучшей.
221 запрос — это не N+1. Это N+1+M: один за авторами, двадцать за их книгами и двести за отзывами к каждой книге. Уровней вложенности два, и цена растёт по каждому отдельно. На одном уровне вложенности такого не увидеть, и именно поэтому проблема так часто доживает до прода: в тестах связей обычно один уровень.
Важно, что запросы порождает не сам select, а обход связей: без него ленивая загрузка так и останется ленивой.
# сам по себе это ОДИН запрос — за авторами
authors = session.execute(select(Author)).scalars().all()

# а вот обход добирает остальные 220, по одному на каждую связь
for author in authors:              # 20 запросов: книги каждого автора
    for book in author.books:       # 200 запросов: отзывы каждой книги
        total += len(book.reviews)

# те же 220 не нужны, если связи загружены сразу: 3 запроса на всё
authors = session.execute(
    select(Author).options(
        selectinload(Author.books).selectinload(Book.reviews)
    )
).scalars().all()
Разница между selectinload и joinedload — не «какой лучше», а какой чем платит. selectinload делает по запросу на уровень и отдаёт строки без повторов. joinedload обходится одним запросом, но каждая его строка несёт столбцы автора и книги заново — столько раз, сколько у книги отзывов.
И тут честная оговорка: стенд не измеряет байты по проводу. Он видит, что joinedload отдал меньше строк (1995 против 2215), и не видит, что каждая из них шире. Меньшее число строк у него — не признак меньшего трафика, и делать из этой таблицы вывод «joinedload дешевле» нельзя. По времени они на этих данных неразличимы: 31,4 против 32,6 мс.
В async ленивая загрузка не работает — и это правильно
Обращение к незагруженной связи в AsyncSession обычным доступом к атрибуту не идёт в базу, а падает:
$ docker compose exec -T -e PYTHONPATH=/app:/bench -w /bench bench \
    python run_lazy_async.py
# (выдержка: тип и текст исключения одной строкой, перенесены на две, ссылка на документацию убрана)
MissingGreenlet: greenlet_spawn has not been called; can't call await_only()
here. Was IO attempted in an unexpected place?
Выглядит как недоделка, а по существу — единственное честное поведение. Обращение к атрибуту синхронно по своей природе: book.reviews — это не await, и вставить туда ожидание некуда. Синхронная сессия в этот момент молча ходит в базу, и так возникает N+1, которого никто не писал. Асинхронная сходить не может и потому говорит вслух.
Запрещён здесь именно неявный ввод-вывод, а не ленивая загрузка как таковая. Явный путь есть: подмешайте моделям AsyncAttrs и обращайтесь через awaitable_attrs, где ожидание видно в коде.
class Base(AsyncAttrs, DeclarativeBase):
    pass

reviews = await book.awaitable_attrs.reviews   # видно, что это поход в базу
Разница ровно в этом: book.reviews умалчивает о запросе, await book.awaitable_attrs.reviews — нет. То есть async-сессия не отнимает возможность догрузить связь, а требует, чтобы поход в базу был написан явно, и тем превращает скрытую проблему производительности в видимую строку кода. Всё равно предпочтительнее грузить заранее — selectinload, joinedload; awaitable_attrs уместен там, где связь нужна редко и по условию.
Проверено на SQLAlchemy 2.0.52, и версия здесь существенна: текст и тип исключения версионны. Та же связь, предзагруженная selectinload, в той же сессии отдаётся без ошибки — это вторая половина проверки, без неё было бы доказано лишь то, что код умеет падать.
Alembic: что видит автогенерация и что возвращает откат
Про автогенерацию спрашивают обычно одно: заметит ли она изменение. Вопросов на самом деле три, и между ними лежат разные неприятности.
Девять изменений схемы, два режима сравнения, Alembic 1.19.1:
| изменение схемы | умолчания | compare_type + compare_server_default |
|---|---|---|
| контроль: изменений нет | операций нет | операций нет |
столбец с server_default |
откат вернул | откат вернул |
смена типа integer → bigint |
откат вернул | откат вернул |
| переименование индекса | откат вернул | откат вернул |
ограничение CHECK |
откат вернул | откат вернул |
| частичный индекс | откат вернул | откат вернул |
сужение text → varchar(64) |
откат вернул | откат вернул |
| смена умолчания у столбца | не видит | откат вернул |
| переименование столбца | видит, не смог | видит, не смог |
Семь строк из девяти — хорошие новости, и их стоит проговорить: на этой версии автогенерация видит смену типа, переименование индекса, CHECK и частичный индекс, а downgrade возвращает схему в исходное состояние. Проверено не текстом миграции, а сравнением снимков системного каталога до и после цикла.
Две оставшиеся строки — разной природы.
Смена server_default у существующего столбца проходит мимо молча. По умолчанию Alembic умолчания не сравнивает; включается это явно:
context.configure(
    connection=connection,
    target_metadata=target_metadata,
    compare_type=True,
    compare_server_default=True,
)
Обратите внимание: добавление нового столбца с умолчанием видно и без флага — умолчание приезжает вместе со столбцом. Слепота проявляется только на изменении умолчания у существующего.
Переименование столбца обнаруживается, но предложенная миграция не исполняется. Автогенерация сравнивает наборы столбцов, а не их судьбу, и видит переименование как «одного не стало, другой появился». Получается drop_column плюс add_column с NOT NULL, и на непустой таблице это падает:
$ python scripts/analyze-alembic.py
# (выдержка из «сгенерировано, но не исполняется»: имя случая и класс psycopg.errors.NotNullViolation убраны)
IntegrityError: column "name" of relation "books" contains null values
Здесь повезло, что упало. Если бы столбец допускал NULL, миграция прошла бы успешно и тихо стёрла данные — схема была бы «правильной», а содержимое потерянным. Переименования пишите руками через op.alter_column(..., new_column_name=...).
Общий вывод про автогенерацию: она хороша ровно настолько, насколько точно ваше описание соответствует базе, и проверять надо не только upgrade, но и downgrade — на данных, а не на пустой схеме. Как это делать в тестах — в статье про тестированиеготовится, с 23 октября, там же про Testcontainers.
Что из этого следует
Берите Core, если уходите от ORM. Разница между сырым драйвером и Core — половина на дешёвых запросах и четверть на объёмных. Разница между Core и ORM — втрое-впятеро. Отказ от объектов даёт почти всё; отказ от выражений — почти ничего сверх этого, зато вы теряете структурную сборку запроса и связывание параметров.
Считайте не запросы, а материализованные строки. Превращение строки в объект стоит единицы микросекунд — на этом стенде от пяти до тринадцати в зависимости от того, как мерить. Прикидка по этому порядку показывает, где ORM уместен, а где это архитектурная ошибка; точное число берите своим замером.
Считайте запросы, а не время. Число запросов — целое, воспроизводимое и не зависит от машины. Ленивая загрузка на двух уровнях вложенности даёт 221 запрос там, где хватает трёх; поймать это по времени в тестах трудно, по счётчику запросов — тривиально.
Async-сессия — это ещё и проверка на этапе разработки. MissingGreenlet неприятен ровно один раз и стоит на месте будущего N+1.
Включите compare_server_default и проверяйте откат. Первое — одна строка в env.py. Второе — прогон upgrade и downgrade на непустой копии данных, потому что именно данные теряются, а не схема.
И самое общее. Цена слоя доступа определяется не тяжестью запроса, а объёмом того, что вы из него материализуете. На тяжёлом запросе, отдающем дюжину строк, все способы обратиться к базе неразличимы; на том же по тяжести запросе, отдающем пятьсот объектов, ORM снова дороже на треть. Выбирать между слоями надо не по скорости запроса, а по объёму результата — и по тому, сколько кода вы готовы написать сами и сколько ошибок хотите ловить до продакшена.
Границы всего сказанного. Модель на стенде простая: шесть скалярных полей, без JSON и UUID, без TypeDecorator, без отложенных колонок, без связей и событий на самой сущности. Каждое из перечисленного добавляет работы на строку, и цена материализации вырастет. Версии тоже зафиксированы — SQLAlchemy 2.0.52, asyncpg 0.31.0, psycopg 3.3.4, PostgreSQL 18.4, — а поведение слоёв от них зависит. Переносить сюда числа с чужой модели нельзя ровно так же, как нельзя переносить отсюда на свою.
Как это устроено в других языках
Доступ к данным на JVM — там ORM тяжелее, но и инструменты вокруг него зрелее. pgx против database/sql в Go — противоположный полюс: полноценного ORM в экосистеме почти нет, и слой доступа обычно останавливается на уровне выражений.
Комментарии