
Про Python спорят одними и теми же фразами: «медленный и без типов» против «на нём построена половина мира данных и куча продакшн-сервисов». Обе стороны правы ровно настолько, насколько неточен вопрос.
Эта статья открывает серию из десяти, но написана она последней — и намеренно. Все остальные девять стоят на стендах: воспроизводимых замерах с фикстурами, контрольными плечами и разбором, который отказывается печатать числа, если замер негоден. Писать вводную первой значило бы снова пересказывать общие места; теперь под каждым утверждением здесь лежит либо число из конкретной статьи, либо честная пометка, что числа нет.
В статье
- Как читать числа этой серии
- Где Python силён
- Компромисс первый: GIL
- Компромисс второй: слои
- Компромисс третий: типы и данные
- Компромисс четвёртый: упаковка
- Когда брать другой язык
- Карта серии
- Что из этого следует
Как читать числа этой серии
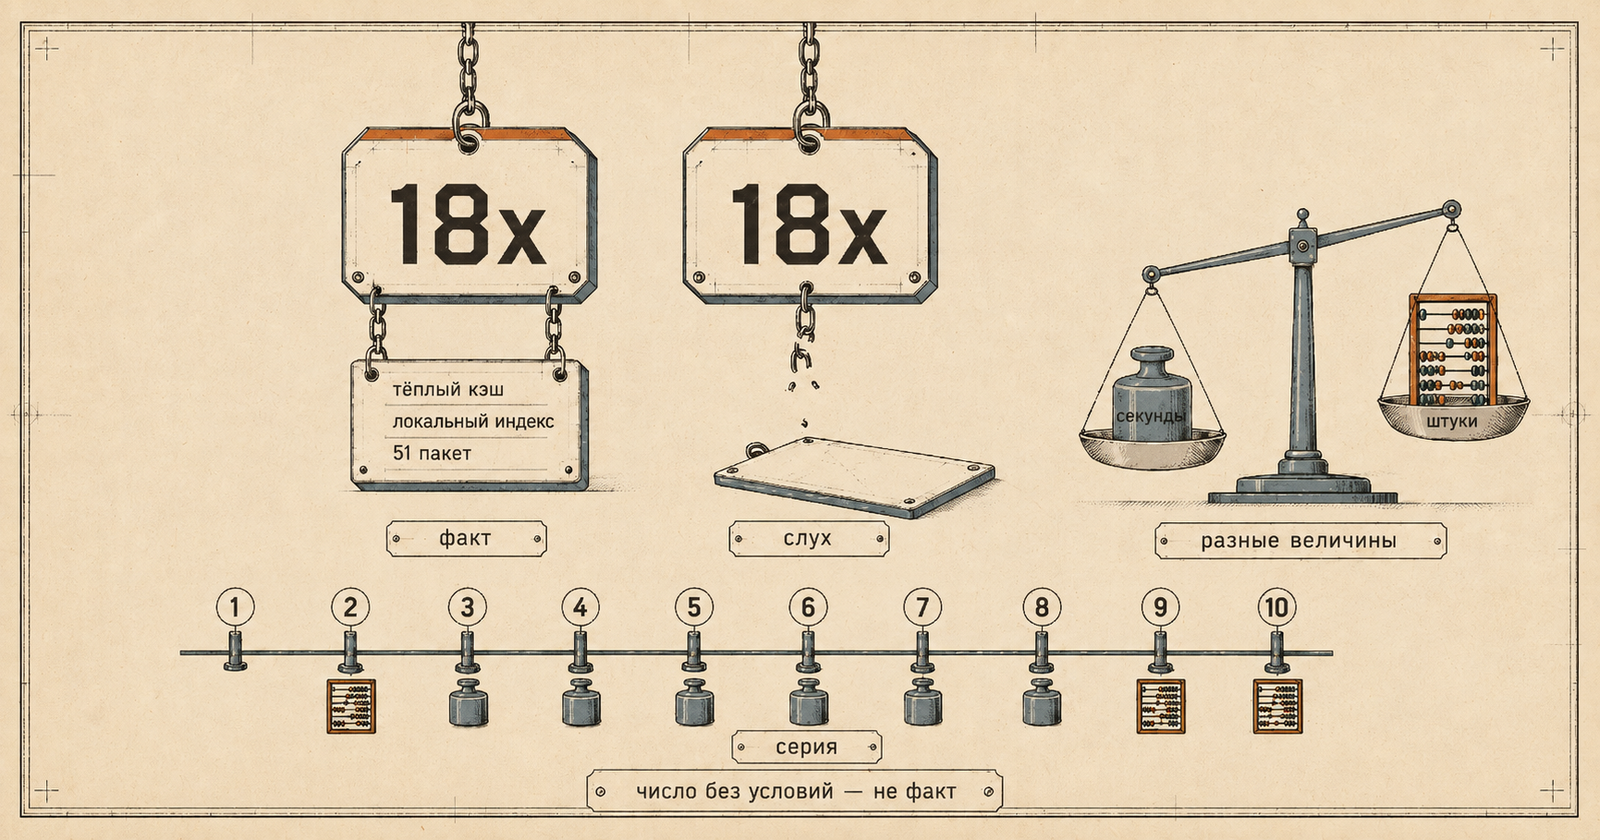
Каждое число ниже приведено вместе с условиями, при которых оно получено, и ссылкой на статью, где стоит замер целиком. Это не педантизм: число без условий — не факт, а слух.
Пример из этой же серии. «uv быстрее pip в восемнадцать раз» — верно при тёплом кэше, на локальном индексе, для набора из 51 пакета с готовыми колёсами. На холодном кэше разрыв четырёхкратный, при походе в сеть картина снова другая. Одна и та же пара инструментов, три разных ответа, и все три настоящие.
Второе, что стоит знать заранее: не всё, что важно, измеряется временем. Часть самых устойчивых результатов серии — целые числа: сколько запросов ушло в базу, сколько раз поднялся контейнер, поймал ли инструмент подсунутый дефект. Такие факты переживают перенос на другую машину, в отличие от секунд.
Где Python силён
Три ниши, где он выигрывает не по производительности, и это не оправдание, а описание.
Данные и ML. Экосистема здесь не «одна из», а фактически общая: NumPy, pandas, polars, Arrow, Parquet, весь инструментарий обучения и инференса. Причём тяжёлая часть давно не на Python: у polars ядро на Rust, у pandas и NumPy на C, у pyarrow на C++. Python строит план и вызывает — и именно поэтому вопрос «быстрый ли Python» в этой нише почти всегда поставлен неверно.
Веб-сервис, где фреймворк не оказался узким местом. Замер из статьи про фреймворки: при обработчике, который ждёт 20 миллисекунд, FastAPI выдаёт 102% (94–107) от собственного контрольного плеча — голого ASGI-приложения, — а Flask 99% (97–101). Оба размаха перекрывают сто процентов: на этом профиле фреймворк не различим на фоне того, чего он ждёт.
Про Python в этом месте принято говорить другое — что на нём быстрее написать сервис. Возможно, но это утверждение про людей, а не про машину, и я его не мерил: скорость разработки зависит от команды и задачи сильнее, чем от языка, и честного замера у меня нет. Доказанное здесь скромнее и проверяемо: на этом профиле — одно ожидание в 20 мс на запрос, 64 одновременных запроса, медиана по одиннадцати кругам против собственного контрольного плеча — накладные расходы фреймворка не различимы на фоне ожидания. Переносить вывод на любую базу, драйвер и форму нагрузки нельзя: настоящий запрос к базе даёт разброс, которого у искусственного ожидания нет, доля времени на самом Python растёт вместе с числом объектов в ответе, а хвосты распределения этот замер не трогал вовсе. Утверждение ровно одно: довод «фреймворк съест производительность» на таком профиле не подтверждается, и проверять его надо своим контрольным плечом, а не чужой таблицей.
Автоматизация и связывание систем. Здесь выигрывает не язык, а то, что у почти любой системы есть готовый Python-клиент: облачные API, базы, очереди, сетевое оборудование, научные форматы. Связывающему коду обычно не нужны ни скорость, ни надёжность типов — ему нужно, чтобы обе стороны уже были описаны чужой библиотекой. Проверить это утверждение легко и на своём наборе систем: посчитайте, для скольких из них клиент существует, и сравните с любым другим языком, который вы рассматриваете.
Компромисс первый: GIL
Самый известный и самый неверно понимаемый. Точная формулировка такая: GIL сериализует работу с объектами Python — в каждый момент байт-код исполняет один поток. Отсюда всё остальное. На ожидании ввода-вывода блокировка отпускается, поэтому потоки на I/O работают параллельно. Нативное расширение тоже вправе отпустить её на время счёта — так делают NumPy и подобные, — и тогда счётная нагрузка внутри расширения может масштабироваться потоками. Именно «может»: отпущенный GIL снимает лишь одно препятствие из нескольких. Расширение способно иметь собственную блокировку, однопоточное ядро или упереться в пропускную способность памяти раньше, чем в число ядер, — и тогда потоки не дадут ничего, хотя GIL им не мешает. Связано без вариантов оказывается только то, что считает на самом Python; всё остальное надо проверять замером.
У сборок без GIL есть своя оговорка: расширение, не объявившее поддержку свободных потоков, заставляет интерпретатор включить блокировку обратно — уже во время работы. Одна такая зависимость отменяет выигрыш всей сборки, и проверять это надо не по документации пакета, а на своём наборе зависимостей. Подробности — в документации CPython.
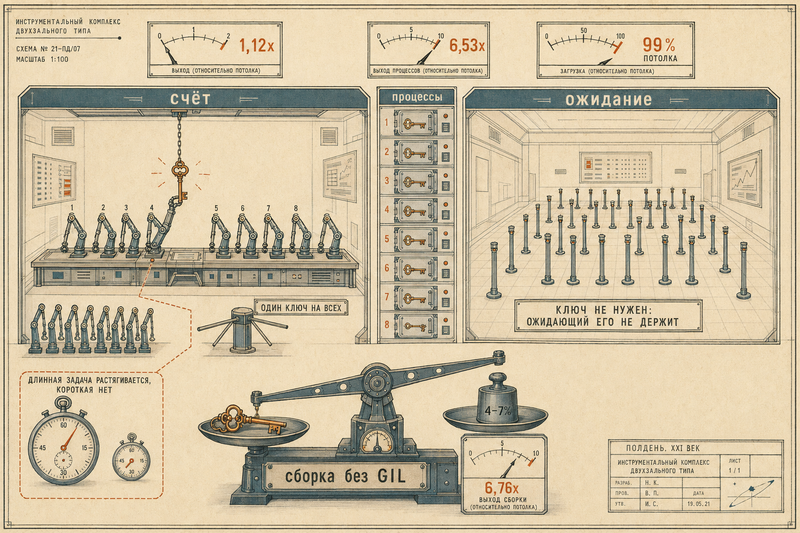
Числа из статьи про asyncio и GIL, счётная нагрузка, восемь воркеров:
| модель | сборка с GIL | сборка без GIL |
|---|---|---|
| потоки | 190,9 → 213,3 ops/s (1,12x) | 201,1 → 1359,3 ops/s (6,76x) |
| процессы | 187,0 → 1220,6 ops/s (6,53x) | 201,2 → 1265,2 ops/s (6,29x) |
Потоки под GIL на счётной задаче дают 1,12x при восьмикратном росте числа воркеров. Процессы дают 6,53x — то есть обходной путь работает и работал всегда.
Но интереснее другое. Пропускная способность выросла на 12%, а задержка при этом:
| плечо | p50 при 1 воркере | p50 при 8 | рост задержки | рост пропускной |
|---|---|---|---|---|
| потоки под GIL, задача ~50 мс | 50,1 мс | 354,6 мс | 7,1x | 1,06x |
| потоки под GIL, задача ~5 мс | 5,14 мс | 10,02 мс | 1,9x | 1,12x |
| потоки без GIL, задача ~50 мс | 48,4 мс | 57,0 мс | 1,2x | 6,70x |
Семикратный рост задержки при шести процентах прироста пропускной способности. Это и есть настоящая цена GIL: не «медленно», а очередь. Запросы не выполняются одновременно, они ждут.
Вторая строка показывает, отчего это зависит: та же работа, разбитая на участки по 5 мс вместо 50, растягивает задержку всего в 1,9x. Интервал переключения GIL — 5 мс, и задача, укладывающаяся в один-два таких кванта, успевает завершиться почти без помех. Пропускная при этом не выросла ни в том, ни в другом случае.
Границы. Числа сняты на конкретной счётной задаче в двух сборках CPython 3.14. На задаче другой формы — с обращениями к диску или сети — картина другая, потому что GIL отпускается на время ожидания. Подробнее — в статье про asyncio и GIL.
Компромисс второй: слои
Python поощряет удобные абстракции, и они не бесплатны. Вопрос в том, где именно они стоят дорого.
Замер из статьи про доступ к данным, отношение к голому драйверу:
| плечо | одна строка | агрегат | 516 объектов |
|---|---|---|---|
| SQLAlchemy Core | 1,53x | 1,02x | 1,06x |
| ORM | 4,75x | 1,09x | 1,37x |
ORM дороже сырого драйвера впятеро — на запросе, возвращающем одну строку. На запросе с агрегацией, где работает база, разница исчезает: 1,09x, то есть её нет. А вот там, где надо построить пятьсот объектов, она возвращается — 1,37x, и уже не из-за запроса, а из-за материализации.
Отсюда правило, которое стоит унести: цена слоя определяется не тяжестью запроса, а объёмом того, что вы из него материализуете.
И рядом — результат, который не зависит ни от машины, ни от версии, потому что это счёт событий:
| способ загрузки | запросов в базу |
|---|---|
| ленивая, по умолчанию | 221 |
selectinload |
3 |
joinedload |
1 |
Двести двадцать один запрос там, где хватает одного. Поймать это по времени в тестах трудно, по счётчику запросов — тривиально. Подробности — в статье про доступ к данным.
Компромисс третий: типы и данные
Динамическая типизация — не «отсутствие типов», а перенос проверки на другое время и в другое место. Вопрос в том, что каким рубежом ловится.
Из статьи про типизацию: пять подсунутых дефектов, пять способов их искать.
| дефект | mypy | --strict |
pyright | pydantic | выполнение |
|---|---|---|---|---|---|
| ошибка в теле функции без аннотаций | нет | да | да | нет | нет |
X | None без проверки |
да | да | да | нет | нет |
| в данных строка вместо булева | нет | нет | нет | да | нет |
| скидка больше суммы, итог в минус | нет | нет | нет | нет | да |
Четыре рубежа, и ни один не покрывает соседний. Самая поучительная строка — третья: поле объявлено bool, аннотация верна, ошибки в коде нет, а в данных лежит строка "false". Все анализаторы зелёные и все правы — они проверяют код, а не данные. Выполнение тоже молчит: непустая строка истинна, итог получается неверным, но правдоподобным.
Вторая по поучительности — четвёртая: «итог не бывает отрицательным» не следует ни из типов, ни из схемы. Это утверждение о предметной области, и написать его придётся руками.
То же разделение — в тестах. Из статьи про тестирование:
| дефект | моки | фейк на SQLite | настоящая база | hypothesis |
|---|---|---|---|---|
| регистр в поиске | нет | нет | да | да |
| лишние запросы к базе | да | нет | нет | нет |
Запрос на каждого автора вместо одного не меняет результат — поэтому его не видит ни фейк, ни настоящая база. Видит только тест, считающий обращения. Подробности — про типизацию и про тестированиеготовится, с 23 октября.
Компромисс четвёртый: упаковка
Историческая болевая точка, и здесь за последние годы изменилось больше всего.
Из статьи про упаковку, установка одного набора из 51 пакета, медиана по 18 кругам:
| инструмент | холодный кэш | тёплый кэш | всё на месте |
|---|---|---|---|
| uv | 2,74 с | 0,58 с | 0,01 с |
| Poetry | 3,59 с | 3,03 с | 0,75 с |
| pip | 11,17 с | 10,21 с | 0,55 с |
Разрыв растёт по мере того, как работы становится меньше: вчетверо на холодном кэше, в восемнадцать раз на тёплом, в сорок один на повторном запуске. Там, где реальной работы почти нет, остаётся накладной расход самого инструмента.
Образ сервиса — та же история про дисциплину, а не про язык: 1250 МиБ при наивной сборке против 156 МиБ при многоступенчатой, при побайтово одинаковом ответе приложения.
Границы. Числа сняты на локальном индексе, для набора с готовыми колёсами. Проект, где что-то собирается из исходников, даст другую картину. Подробности — в статье про упаковку.
Когда брать другой язык
Здесь у меня нет замеров — сравнения языков в этой серии нет, и выдумывать его я не буду. Но у перечисленных выше компромиссов есть форма, и из неё следуют довольно чёткие показания.
Берите компилируемый язык, когда счётная работа в горячем пути и её нельзя вынести в ядро. Если задача сводится к векторным операциям, Python уже вызывает C или Rust, и менять нечего. Если это ваша собственная логика в цикле по миллиону элементов — интерпретатор становится потолком.
Берите, когда бюджет задержки — единицы миллисекунд и он жёсткий. Не из-за средней скорости, а из-за хвостов: сборщик мусора, GIL при счётной работе в потоках, накладные расходы слоёв.
Не берите ради «просто быстрее». На измеренном профиле — обработчик с ожиданием 20 мс, 64 одновременных запроса — фреймворк переставал быть различим на фоне ожидания. Прежде чем менять язык, стоит выяснить, какую долю времени занимает у вас код на Python: если её не измеряли, довод «будет быстрее» ни на чём не стоит.
Не берите ради типов. Разница между «типы обязательны» и «типы объявлены и проверяются анализатором» гораздо меньше, чем кажется со стороны; таблица из раздела про типы — про то, где эта разница есть.
Самый частый правильный ответ — не «другой язык вместо», а другой язык под тонким слоем Python: горячий путь в нативном модуле, остальное на Python. Именно так устроены polars, pydantic и NumPy.
Карта серии
Что где измерено, чтобы не искать.
| # | статья | что измеряется | стенд |
|---|---|---|---|
| 2 | Типизация | кто ловит дефект: mypy, pyright, pydantic, выполнение | счётный |
| 3 | asyncio и GIL | потоки, процессы и сборка без GIL на счётной и ждущей нагрузке | замеры |
| 4 | Web-фреймворки | FastAPI, Django, Flask против собственных контрольных плеч | замеры |
| 5 | Доступ к данным | цена слоя, N+1 в запросах, откат миграций | замеры |
| 6 | Упаковка | установка в трёх состояниях кэша, шесть стратегий сборки образа | замеры |
| 7 | Production | способы запуска, корректное завершение под нагрузкой | замеры |
| 8 | Производительность | искажение профайлером, нативные расширения | замеры |
| 9 | Тестированиеготовится, с 23 октября | кто ловит дефект: моки, фейк, база, property-based | счётный |
| 10 | Обработка данныхготовится, с 24 октября | кто не читает лишнего при отборе по разделам | счётный |
Отдельно отмечу статью 8: она про то, что измерительный прибор искажает измеряемое. cProfile замедляет прогон в 1,29 раза и смещает доли функций — chunky_step он оценивает в 64,2%, а py-spy в 77,7%. Если вы принимаете решения по профилю, это стоит знать до, а не после.
Что из этого следует
Вопрос «быстрый ли Python» почти всегда поставлен неверно. Правильные вопросы: какая работа в горячем пути, кто её делает — интерпретатор или ядро на C, и сколько объектов вы материализуете.
GIL бьёт по обоим показателям, и по задержке это видно раньше. Пропускную он ограничивает наглухо: восемь потоков на счётной нагрузке дали 1,12x — прироста, считайте, нет, — тогда как восемь процессов на той же работе дают 6,53x. По задержке всё зависит от длины счётного участка: задача около 50 мс растянула p50 в 7,1x (и пропускной не прибавила вовсе — 1,06x), а задача около 5 мс уложилась в 1,9x. Разница в заметности: выросшая задержка бросается в глаза сразу, а недобранное масштабирование видно только рядом с контрольным плечом. Обходится он процессами, причём давно.
Цена абстракций зависит от объёма материализации, а не от тяжести запроса. ORM впятеро дороже на одной строке и неразличим на агрегате.
Считайте события, а не секунды, где это возможно. 221 запрос против одного, 252 файла байт-кода, один старт контейнера против трёх, «поймал / не поймал» — эти факты переживут перезамер на вашей машине, в отличие от любых миллисекунд.
Четыре рубежа проверки не заменяют друг друга. Анализатор ловит код, граница — данные, инварианты — нарушенное правило, тесты — то, что случилось. На пяти дефектах стенда у каждого рубежа нашлась строка, где он сработал единственным.
Упаковка перестала быть болью, если вы этого захотели. uv, lock-файл, многоступенчатая сборка — три решения, каждое на один вечер, и восьмикратная разница в распакованном размере образа: 1250 МиБ у наивной сборки против 156 у многоступенчатой с uv.
Каждое число здесь имеет условия. Я старался приводить их рядом; там, где приведён только порядок величины, так и сказано. Если вы уносите отсюда одно число без условий — вы уносите слух.
Комментарии