
Конкурентность в Python — источник вечной путаницы: «asyncio против потоков против процессов», и над всем этим — GIL. Разберёмся без мифов: что GIL реально запрещает, где asyncio помогает, а где бесполезен, и что меняет free-threaded режим.
Все числа ниже сняты на стенде, который прогоняет одну и ту же нагрузку в трёх моделях исполнения на двух интерпретаторах одной версии — обычном и без GIL.
digital-cookbook/python/concurrency
В статье
- Что GIL запрещает и чего не запрещает
- Как GIL проявляется в задержке
- asyncio и event loop
- Ожидание: где GIL ни при чём
- Сборка без GIL и её цена
- Как выбирать
Что GIL запрещает и чего не запрещает
GIL — Global Interpreter Lock — это блокировка, которую поток обязан удерживать, чтобы исполнять байткод Python. Отсюда единственное следствие: в один момент времени байткод исполняет один поток. Всё остальное, что обычно про GIL говорят, — либо уточнение, либо неправда.
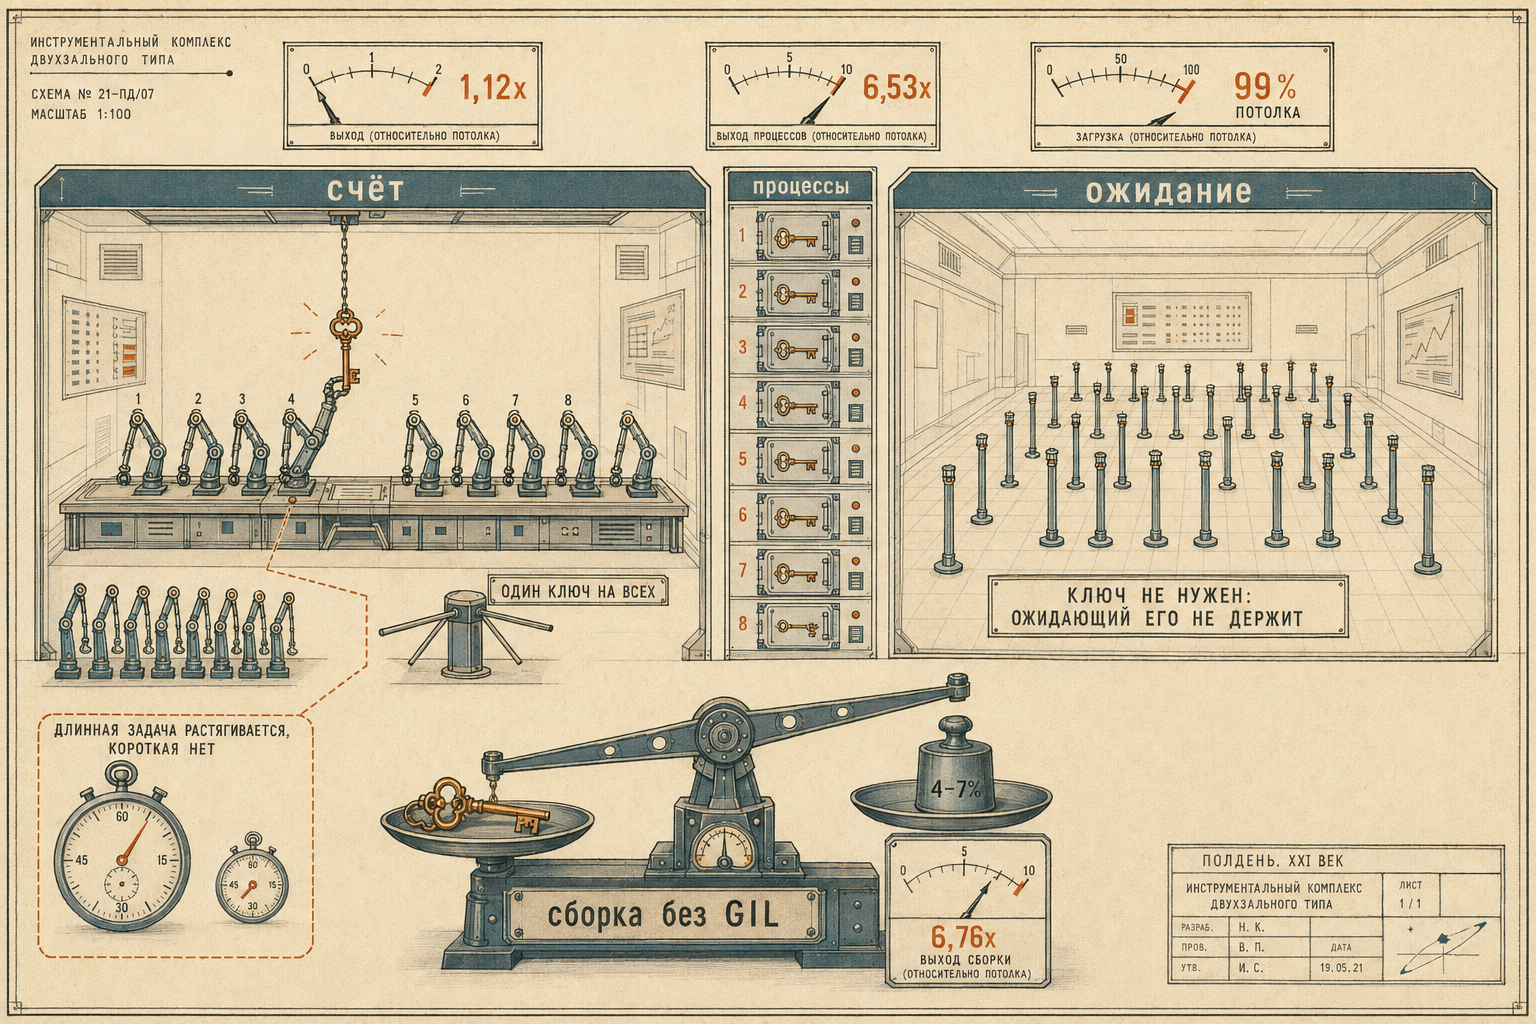
Проверим на счётной задаче: чистая арифметика на Python-байткоде, никаких библиотечных вызовов. Пропускная способность при росте числа воркеров с одного до восьми, медианы трёх кругов на 16 ядрах:
| модель | сборка с GIL | сборка без GIL |
|---|---|---|
| asyncio | 212,2 → 208,9 ops/s (0,98x) | 196,5 → 201,4 ops/s (1,02x) |
| потоки | 190,9 → 213,3 ops/s (1,12x) | 201,1 → 1359,3 ops/s (6,76x) |
| процессы | 187,0 → 1220,6 ops/s (6,53x) | 201,2 → 1265,2 ops/s (6,29x) |
Восемь потоков на счётной задаче дают 1,12x — то есть практически ничего, хотя ядер шестнадцать. Восемь процессов дают 6,53x. Это и есть граница GIL в чистом виде: она проходит между потоками и процессами, а не между «быстро» и «медленно».
Важна оговорка про саму задачу. Она намеренно написана на чистом Python-байткоде, потому что многие библиотечные функции GIL отпускают: пока hashlib считает хеш, а zlib жмёт, интерпретатор свободен. Если бы нагрузка ушла в такую библиотеку, замер показал бы поведение библиотеки, а не границу GIL. На стенде это отдельная проверка: если под GIL потоки вдруг дадут заметный рост, разбор объявит замер негодным, а не выдаст сенсацию.
Как GIL проявляется в задержке
Пропускная способность — половина картины. Вторая половина: что происходит с длительностью одной операции.
Напрашивающееся объяснение звучит так: восемь потоков делят один GIL, значит каждая операция идёт в восемь раз дольше, а суммарно выходит то же самое. Оно неверно, и это видно из замеров.
| плечо | p50 при 1 воркере | p50 при 8 | рост задержки | рост пропускной способности |
|---|---|---|---|---|
| потоки под GIL, задача ~5 мс | 5,14 мс | 10,02 мс | 1,9x | 1,12x |
| потоки под GIL, задача ~50 мс | 50,1 мс | 354,6 мс | 7,1x | 1,06x |
| потоки без GIL, задача ~50 мс | 48,4 мс | 57,0 мс | 1,2x | 6,70x |
Разница между первыми двумя строками — только в длине задачи. Интервал переключения GIL по умолчанию — 5 мс (sys.getswitchinterval()). Задача, которая укладывается в один-два таких кванта, успевает завершиться почти без помех, и рост задержки едва заметен. Задача вдесятеро длиннее кванта растягивается почти пропорционально числу потоков.
Практический вывод не про числа, а про диагностику. Если ваша служба под нагрузкой держит прежнюю пропускную способность, но задержка выросла в разы — короткие CPU-участки в потоках объяснить этого не могут, а длинные могут. И наоборот: отсутствие роста задержки не доказывает, что GIL ни при чём: пропускная способность в обеих строках не выросла одинаково.
asyncio и event loop
asyncio решает совсем другую задачу, и путаница обычно начинается здесь.
Цикл событий — однопоточный. Корутина выполняется, пока сама не дойдёт до await, который её действительно приостанавливает, и только тогда отдаёт управление. Оговорка не придирка: await уже готового результата продолжается синхронно, не отдавая управление никому, — переключение происходит лишь тогда, когда ожидание не завершено. Никто её не вытесняет. Это кооперативная многозадачность, и у неё есть прямое следствие: одна корутина, которая долго считает и ни разу не ждёт, останавливает весь цикл.
Замер это подтверждает буквально: в таблице выше плечо asyncio даёт 0,98x и 1,02x — то есть при росте числа одновременных операций с одной до восьми пропускная способность не меняется вовсе. На счётной задаче asyncio не даёт ничего.
И — что важнее — отсутствие GIL этого не меняет. На сборке без GIL asyncio показывает те же 1,02x. Цикл событий остался однопоточным, свободные ядра ему не помогают. Ожидание «уберут GIL, и async станет параллельным» ни на чём не основано.
import asyncio, time

async def blocking():
    # Ни одного await: цикл событий стоит целиком, пока это считается.
    total = 0
    for i in range(10_000_000):
        total += i
    return total

async def heartbeat():
    while True:
        print("жив", time.strftime("%H:%M:%S"))
        await asyncio.sleep(0.5)

async def main():
    asyncio.create_task(heartbeat())
    await blocking()      # heartbeat замолчит на всё это время
Лечится это выносом счётной работы из цикла через loop.run_in_executor. А вот какой исполнитель туда передать — зависит от сборки, и одной рекомендации на всех здесь не существует.
Оба исполнителя на одной и той же работе, 400 операций, медианы трёх кругов:
| воркеров | gil / потоки | gil / процессы | nogil / потоки | nogil / процессы |
|---|---|---|---|---|
| 1 | 200,3 | 188,9 | 188,2 | 192,0 |
| 2 | 202,4 | 358,7 | 387,2 | 377,9 |
| 4 | 199,7 | 668,7 | 718,0 | 725,5 |
| 8 | 201,1 | 1067,6 | 1221,7 | 1214,5 |
На обычной сборке выбор однозначен: пул потоков не даёт ничего — работа ушла из цикла событий, цикл ожил, но считаться быстрее не стала. Нужен ProcessPoolExecutor, он даёт 5,3x против потоков.
На free-threaded сборке оба исполнителя равны по пропускной способности: 1221,7 против 1214,5 операций в секунду, различие в пределах разброса между кругами. Это не «потоки лучше» — это «оба работают», и выбирать надо по другим свойствам: пул процессов требует, чтобы аргументы и результаты пиклились, и стоит заметно больше памяти (об этом ниже), зато изолирует падение воркера. Пул потоков проще и легче, но делит с вами всю память, включая возможность её испортить.
Ожидание: где GIL ни при чём
Теперь нагрузка, ради которой asyncio и существует: ожидание. Здесь удобнее смотреть не на голые операции в секунду, а на долю от теоретического потолка. При w одновременных ожиданиях по d секунд идеальная модель выдаёт w/d операций в секунду; отставание от этого потолка и есть накладные расходы модели.
Задержка 20 мс, слева сборка с GIL, справа без него:
| модель | 1 | 8 | 64 | 256 |
|---|---|---|---|---|
| asyncio | 99% / 100% | 99% / 99% | 93% / 94% | 84% / 88% |
| потоки | 99% / 100% | 99% / 99% | 95% / 96% | не сравнимо |
| процессы | 99% / 99% | 98% / 99% | 64% / 75% | не запускалось (PROC_MAX=64) |
До 8 одновременных операций все три модели держат 98–100% потолка, и обе сборки идут вровень. На 64 asyncio и потоки остаются на 93–96%, а процессы уже проседают. На ожидании GIL действительно не узкое место: поток, который ждёт ввода-вывода, GIL не удерживает.
Расходятся модели с ростом одновременности, и первым отваливается плечо процессов — 64% потолка (75% без GIL) там, где asyncio держит 93%. Вероятная причина прозаична: у процессов число воркеров равно числу процессов операционной системы, и каждый стоит памяти и переключений. При 256 одновременных операциях это плечо на стенде не запускалось вовсе: скрипт намеренно ограничивает процессы 64 воркерами (PROC_MAX=64) в расчёте на то, что 256 процессов на 16 ядрах мерили бы скорее исчерпание памяти хоста, чем модель конкурентности. Это ограничение стенда, а не измеренный отказ — в фикстуре клетка отмечена строкой «ПРОПУЩЕНО».
Клетку «256 потоков» я оставил пустой намеренно, и это стоит объяснить. По трём кругам оттуда получалось, будто сборка без GIL хуже обычной: 50% потолка против 65%. Прицельная проверка на пятнадцати кругах показала, что в этой точке пропускная способность гуляет более чем вдвое — от 4238 до 9190 операций в секунду, — а различие сборок статистически неразличимо. Красивый вывод оказался шумом на малой выборке.
Сборка без GIL и её цена
Free-threaded сборка (PEP 703) существует с Python 3.13, в 3.14 развивается, и на счётной задаче она делает ровно то, чего от неё ждут: потоки начинают масштабироваться как процессы — 6,76x против 1,12x.
Дальше начинается вопрос цены, и с ним надо быть осторожным.
Соблазн измерить цену просто: взять один воркер, где параллелизма ни у кого нет, и сравнить сборки. Так я и сделал — и получил бессмыслицу: asyncio на сборке без GIL медленнее, а потоки и процессы быстрее. Разнонаправленный результат — признак того, что измеряется не то, что названо.
Причина обнаружилась подсчётом потоков в родительском процессе при workers=1: у asyncio их один, у потоков два, у процессов три. Пул исполнителей заводит собственные служебные потоки независимо от числа воркеров. Значит «один воркер» вовсе не означает «один поток», и в двух плечах из трёх сборка с GIL, вероятно, уже платит за его передачу между потоками — но это гипотеза, а не измерение.
Изолирует цену интерпретатора только asyncio — единственное действительно однопоточное плечо. Там сборка без GIL медленнее примерно на 4%. Точнее сказать не берусь: предыдущая серия замеров в менее чистой среде дала 7%, и между сессиями разброс оказался больше, чем внутри одной. Честная величина — порядка 4–7%, того же порядка, что заявленные в PEP 779 10–15% по процессору (плюс 15–20% по памяти, которые стенд не измеряет).
Сравнение внутри одной сборки, где цена интерпретатора сокращается сама, с гипотезой согласуется: плечо потоков при одном воркере медленнее asyncio на 6,0% под GIL и не медленнее без него. Но изолированной цены передачи GIL это не даёт. Между asyncio и ThreadPoolExecutor меняется не только число потоков: другие диспетчеризация задач и очереди, создание Future, сбор результатов. У ProcessPoolExecutor вычисление вообще идёт в отдельном процессе, и к GIL родителя оно отношения не имеет. Гипотеза «GIL берёт плату уже за второй поток» объясняет, почему 6% пропадают без GIL, но чтобы её подтвердить, нужен контроль, который меняет только число потоков при той же диспетчеризации, — в стенде его нет.
И отдельная ловушка для тех, кто будет пробовать. Путь интерпретатора не доказывает, что GIL выключен. Он возвращается обратно — и через переменную PYTHON_GIL=1, и автоматически, если загруженное C-расширение не заявило поддержку free-threading. Во втором случае CPython печатает предупреждение, так что незамеченным это не проходит — но в логах старта его легко пропустить. Проверять надёжнее в момент работы:
import sys
print(sys._is_gil_enabled())   # после импорта всех модулей, а не в начале файла
Как выбирать
Правило выходит короткое, и оно про природу нагрузки, а не про моду.
Ожидание — asyncio или потоки. Сетевые вызовы, база, файлы, очереди. Обе модели держат 93–96% теоретического потолка при 64 одновременных операциях. А вот стоят они разного — пиковая память и дескрипторы при тех же 64 одновременных ожиданиях:
| модель | сборка с GIL | сборка без GIL |
|---|---|---|
| asyncio | 22,9 МБ, 7 дескрипторов | 37,8 МБ, 7 |
| потоки | 48,1 МБ, 7 дескрипторов | 320,2 МБ, 7 |
| процессы | 340,3 МБ, 988 дескрипторов | 517,4 МБ, 988 |
Здесь важно, чем измерена память, иначе таблица врёт. Считается PSS — доля физических страниц, приходящаяся на процесс с учётом того, что общие страницы разделены между всеми, кто их использует. Наивная сумма RSS по процессам для этого не годится: она учитывает интерпретатор, библиотеки и страницы после fork заново в каждом процессе. На плече процессов, где их 67, эта сумма даёт 1329,8 МБ вместо 340,3 — завышение в 3,9 раза. Независимая проверка по cgroup контейнера (366,8 МБ) согласуется с PSS, а не с суммой RSS.
Читается таблица так. Держать одновременность процессами дорого: в 7,1 раза больше памяти, чем потоками, и 988 дескрипторов против семи. Между лёгкими моделями asyncio выигрывает у потоков вдвое на обычной сборке.
Отдельно стоит заметить, во что обходятся потоки на free-threaded сборке: 320,2 МБ против 48,1 МБ, то есть в 6,7 раза больше на те же 64 потока. Заявленные для free-threading 15–20% памяти относятся к интерпретатору, а не к цене одного потока. Настолько, что на этой сборке разрыв между потоками и процессами почти исчезает — 320,2 против 517,4 МБ.
Цена asyncio — вся библиотека должна быть асинхронной: один синхронный вызов останавливает цикл целиком. Цена потоков — память, и на free-threaded сборке заметно бóльшая.
Практически это означает: если асинхронного драйвера для вашей базы или очереди нет, потоки — полноценный выбор, а не компромисс. Переписывать библиотеки ради asyncio, чтобы «стало дешевле», этот стенд оснований не даёт.
Счёт — процессы. Единственная модель, которая на обычной сборке даёт настоящий параллелизм: 6,53x на восьми воркерах. Цена — межпроцессный обмен и память; на ожидании это плечо проигрывает всем.
Счёт в потоках — только на сборке без GIL, и с открытыми глазами. В Python 3.14 этот режим уже не экспериментальный: PEP 779 переводит его в официально поддерживаемый статус. Но сборкой по умолчанию он не стал, экосистема расширений ещё догоняет, и он медленнее в однопоточном коде. Расширение без поддержки free-threading вернёт GIL всему процессу — с предупреждением, которое надо не пропустить.
Отдельно стоит сказать, чего в этом списке нет. Здесь нет пункта «переписать на async, чтобы стало быстрее». asyncio не ускоряет счёт ни на одной сборке — это видно из первой же таблицы. Он позволяет дешёво ждать многого одновременно, и всё.
Что делать, когда ни одна модель не помогает, — вопрос уже не выбора модели, а поиска места, где теряется время. Об этом следующая статья про производительность: профилирование, цена самих инструментов и нативные расширения.
Как это выглядит в других языках
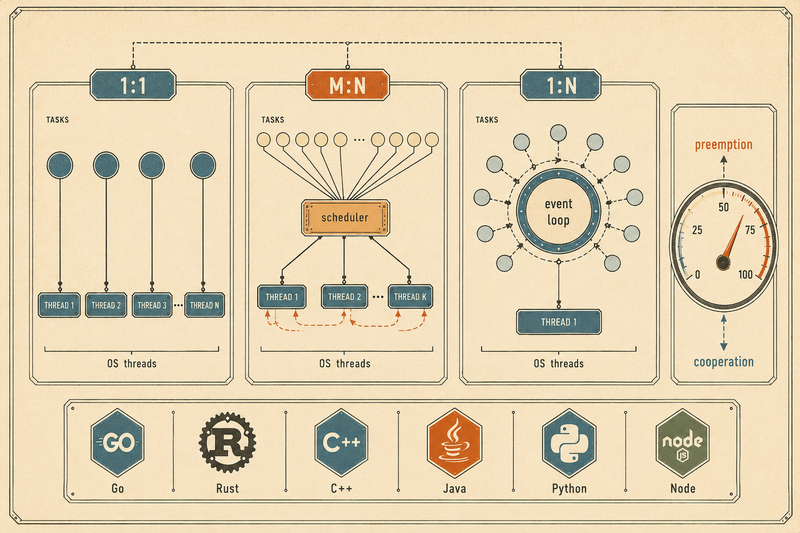
Python здесь не уникален, но его компромисс — свой. Стоит посмотреть, как ту же задачу решают соседи: модели конкурентности поперёк языков, горутины и каналы в Go, virtual threads на JVM, Tokio в Rust и async/await в C#Скоро. Отдельный сюжет — однопоточный событийный цикл в Redis: та же архитектура, что у asyncio, но выбранная сознательно и на другом уровне.

Комментарии