
«Оптимизировал по интуиции» почти всегда значит «оптимизировал не то». Профилирование в любом языке отвечает на один вопрос: где на самом деле уходит время, память и аллокации. Вопрос общий — но инструменты и их ловушки в каждой экосистеме свои: где-то sampling-профайлер снимает стек по таймеру, где-то микробенчмарк врёт из-за разогрева JIT, где-то компилятор просто выкидывает измеряемый код, а «замерил один раз» не значит ничего ни в одном из языков.
Это статья серии «Поперёк языков» (одна задача — разные языки), сиблинг статей про ошибки и управление памятью. Как и там, цель не справочник по инструментам, а одна дисциплина измерения на шести языках — Go, Java, C++, C#, Python и Node — и честный разбор того, чем каждый инструмент способен ввести в заблуждение. Отдельными колонками не вынесены Scala и Rust не потому, что их обошли: Scala профилируется теми же инструментами JVM, что и Java (async-profiler, JMH), а Rust — нативными, что и C++ (perf, флеймграфы), — их читателю адресованы соответствующие колонки. Она задаёт рамку и служит картой-анонсом к по-языковым разборам профилирования: по отдельному глубокому разбору на каждый язык. Часть уже вышла (Go, JVM), остальные готовятся — ссылки ниже отмечают их статус; эта статья стоит впереди серии как общий обзор.
В статье
- Две оси: что мерять и как
- Флеймграф: общий язык чтения
- Go: pprof и честный бенчмарк
- Java/JVM: async-profiler, JFR, JMH
- C++: perf и микробенчмарк, который не наврёт
- C#/.NET: dotnet-trace и BenchmarkDotNet
- Python: cProfile, py-spy и тень GIL
- Node: clinic и лаг event loop
- Микробенчмарки без самообмана
- Сводная таблица
- От профиля к выводу
- Что дальше
Две оси: что мерять и как
Прежде чем брать инструмент, стоит различить две независимые оси. Первая — что мы вообще измеряем, потому что «медленно» и «жрёт память» — это разные профили:
- CPU-время — где процессор реально проводит такты. Не путать с wall-time (временем по часам): поток может стоять в ожидании блокировки или I/O, тратя wall, но не CPU. Оптимизировать CPU-профиль, когда узкое место — ожидание, бесполезно.
- Аллокации — сколько и где создаётся объектов. Часто настоящая причина «тормозов» не вычисления, а давление на аллокатор и, следом, на сборщик мусора.
- Heap-снимок — что лежит в куче сейчас: где живёт память и кто её удерживает. Это про утечки и раздутый резидент, а не про скорость.
- Блокировки и contention — сколько потоки ждут друг друга (mutex, каналы). В Node у этой оси свой аналог — лаг event loop.
Вторая ось — как снимаем данные, и здесь два принципиально разных механизма:
- Sampling — профайлер по таймеру (частота настраивается, типично десятки–сотни герц) снимает текущий стек. Оверхед обычно мал и предсказуем, поэтому sampling чаще всего безопасен под нагрузкой — но и частота, и цена зависят от профайлера, рантайма и способа снятия стека (раскрутка стека, символизация). Картина статистическая: редкие или очень короткие функции могут не попасть в выборку.
- Instrumentation — счётчики, встроенные в код (компилятором, агентом или вручную): точные числа вызовов и времени каждой функции. Плата — большой оверхед, который сам искажает то, что мерит (observer effect): инструментированная мелкая функция «толстеет» на своих же счётчиках.
Правило выбора простое: sampling — чтобы найти, где горит под реальной нагрузкой; instrumentation — чтобы посчитать точно в изолированном эксперименте, помня, что тайминги он смещает.
Флеймграф: общий язык чтения
Результат sampling-профиля почти везде читают через флеймграф — и это тот редкий инструмент, что выглядит одинаково в Go, JVM, C++ и Node. По горизонтали — доля семплов (не время по порядку!), по вертикали — глубина стека вызовов. Ширина рамки функции = какая доля выборки пришлась на неё и её потомков. Читается он так: ищешь широкие плато — это и есть то, где горит. Порядок слева направо смысловой нагрузки не несёт (обычно просто алфавитный), поэтому «раньше/позже» по флеймграфу читать нельзя — только «больше/меньше». Один раз научившись читать его в одном языке, читаешь во всех.
Go: pprof и честный бенчмарк
В Go профилирование встроено в рантайм и тесты. pprof даёт несколько важных профилей: CPU (sampling), heap (что живёт в куче; тот же профиль в представлении alloc_space показывает суммарные аллокации, а не отдельный профиль), block и mutex (сколько горутины ждут на синхронизации) — плюс есть goroutine и threadcreate. block и mutex — сильная сторона Go: contention видно из коробки. Бенчмарки — часть go test: go test -bench . -benchmem меряет наносекунды и аллокации на операцию, а benchstat сравнивает прогоны статистически, а не «на глаз».
Главная ловушка микробенчмарка в Go — устранение мёртвого кода: если результат вычисления никуда не идёт, компилятор вправе выкинуть весь цикл, и ты меряешь пустоту. Лечится присваиванием результата в пакетную переменную (sink) и b.ResetTimer после подготовки:
var sink uint64 // пакетная переменная — результат «используется»

func BenchmarkHash(b *testing.B) {
    data := make([]byte, 1024)
    b.ResetTimer()      // не мерить подготовку выше
    b.ReportAllocs()    // показать аллокации/оп
    var acc uint64
    for i := 0; i < b.N; i++ {
        acc = hash(data)
    }
    sink = acc          // без этого цикл может быть удалён как мёртвый
}
Подробно — CPU/heap/block-профили, честные микробенчмарки и benchstat — в статье «Профилирование и бенчмаркинг в Go».
Java/JVM: async-profiler, JFR, JMH
На JVM три опоры. async-profiler — sampling с малым оверхедом, умеет CPU, wall, аллокации и локи, рисует флеймграфы без модификации кода. JFR (Java Flight Recorder) встроен в JVM и рассчитан на постоянную запись даже в проде. А для микробенчмарков есть JMH — и на JVM он не роскошь, а необходимость.
Причина — разогрев JIT. Свежий код исполняется интерпретатором, и только после тысяч вызовов JIT компилирует его в машинный, применяя инлайнинг и другие оптимизации. Наивный микробенчмарк, замеряющий «холодный» метод, меряет интерпретатор и сам процесс компиляции — то есть что угодно, кроме установившейся производительности. JMH делает это правильно: прогоны прогрева, форки в отдельных JVM (чтобы профиль компиляции не «протёк» между тестами) и Blackhole, чтобы результат нельзя было выкинуть как мёртвый.
@Benchmark
@Warmup(iterations = 5)      // дать JIT скомпилировать горячий путь
@Measurement(iterations = 10)
@Fork(2)                     // изолировать профиль компиляции
public void hash(Blackhole bh) {
    bh.consume(hash(data));  // «потребить» результат — не оптимизируется прочь
}
Почему микробенчмарк на JVM особенно коварен и как читать async-profiler и JFR — в «Профилировании JVM: async-profiler, JFR и JMH».
C++: perf и микробенчмарк, который не наврёт
В C++ основной sampling-профайлер — системный perf (Linux): снимает стеки и, главное, читает аппаратные счётчики процессора — промахи кэша, ошибки предсказания ветвлений, IPC. Это уровень, которого в управляемых рантаймах обычно не видно. Санитайзеры (ASan/TSan/UBSan) — не про скорость, а про корректность (use-after-free, гонки), но в профилировочный набор входят: невалидная программа «быстрая» бессмысленно.
Ловушка та же, что в Go, но злее из-за силы оптимизатора: на -O2 мёртвый код удаляется агрессивно — компилятор видит, что результат не используется, и вырезает всё измерение. Спасает benchmark::DoNotOptimize (из google/benchmark), заставляющий считать значение «наблюдаемым». И обратная крайность: мерять на -O0 бессмысленно — это не тот код, что поедет в прод.
static void BM_Hash(benchmark::State& state) {
    std::vector<char> data(1024);
    for (auto _ : state) {
        auto h = hash(data.data(), data.size());
        benchmark::DoNotOptimize(h);   // результат «наблюдаем» — цикл не удалят
    }
}
BENCHMARK(BM_Hash);perf, флеймграфы, санитайзеры и микробенчмарки без самообмана — в «Профилировании C++»Скоро.
C#/.NET: dotnet-trace и BenchmarkDotNet
В .NET набор кросс-платформенный: dotnet-trace собирает трейсы (CPU, аллокации, события GC), dotnet-counters показывает живые метрики (GC, пул потоков, exceptions/sec) без остановки процесса, а BenchmarkDotNet — стандарт для микробенчмарков. Как и на JVM, у .NET есть разогрев: tiered compilation сначала быстро компилирует в неоптимизированный код (Tier 0), потом перекомпилирует горячее в оптимизированный (Tier 1). Наивный замер поймает Tier 0. BenchmarkDotNet сам делает прогрев, множественные запуски, статистику и глушит устранение мёртвого кода — писать микробенч руками на .NET так же наивно, как на JVM.
Инструменты, счётчики GC и BenchmarkDotNet подробно — в «Профилировании .NET»Скоро.
Python: cProfile, py-spy и тень GIL
В Python два разных инструмента под две задачи. cProfile — инструментированный профайлер из стандартной библиотеки: точные счётчики вызовов каждой функции, но заметный оверхед, который смещает тайминги. py-spy — sampling-профайлер, который умеет подключаться к уже запущенному процессу без единой строки в коде: идеален для прода и для «оно висит прямо сейчас, а рестартовать нельзя». Оговорка: attach к чужому процессу почти всегда требует повышенных прав — root или SYS_PTRACE/ptrace_scope, а в контейнере — соответствующей capability.
Две особенности искажают картину именно в Python. Первая — GIL: на обычном CPython потоки не исполняют байткод параллельно, поэтому CPU-профиль многопоточной программы вводит в заблуждение (потоки конкурируют за один интерпретатор, а не считают вместе) — см. разбор GIL и asyncioготовится, с 17 октября. Оговорка: с CPython 3.13 появились экспериментальные free-threaded сборки без GIL, где потокам доступен настоящий параллелизм; но это пока опциональная конфигурация, а не дефолт — на стандартном интерпретаторе с GIL сказанное в силе. Вторая — накладные расходы интерпретатора доминируют: микрооптимизировать чистый Python-цикл обычно бессмысленно, реальный рычаг — вынести горячий путь в нативный код (C-расширение, numpy). Профиль это и показывает: время не в «вашей» функции, а в интерпретации.
py-spy, cProfile и нативные расширения — в «Производительности Python: GIL, профилирование и нативные расширения»готовится, с 22 октября.
Node: clinic и лаг event loop
В Node CPU-профиль (через --cpu-prof, clinic.js, 0x) рисует флеймграф V8 — но в одиночку он отвечает лишь на часть вопроса. Модель исполнения особая: один поток, событийный цикл, и синхронная работа на нём (тяжёлый JSON.parse, криптография, регэксп) задерживает всё. Поэтому ключевая метрика Node — лаг event loop (event-loop delay, ELD): насколько задерживается обработка следующего тика (perf_hooks.monitorEventLoopDelay). Но ELD — это симптом, а не первопричина: он говорит, что цикл встал, но не почему. Причины ELD живут на главном потоке: синхронная CPU-работа, тяжёлые callbacks, паузы GC и планирования; неблокирующий сетевой I/O сам по себе цикл не останавливает. Отдельная, не связанная с ELD беда — насыщение worker pool libuv (криптография, zlib, файловый I/O): очередь пула раздувает latency при совершенно нормальном event-loop delay, и ловится она своими метриками — длиной очереди и временем задач, а не через ELD. Диагноз даёт связка: ELD и CPU-профиль V8 — для главного потока, метрики пула — для фоновых задач.
Профиль V8, clinic/0x, измерение лага и нативные аддоны — в «Производительности Node»Скоро.
Микробенчмарки без самообмана
Сведём ловушки, которые повторяются во всех колонках, в одну дисциплину:
- Разогрев. На JVM и .NET — JIT (холодный код = интерпретатор/Tier 0). Везде — предсказатель ветвлений и кэш инструкций. Первые итерации мерят не то. JMH/BenchmarkDotNet делают прогрев за вас; в Go/C++ — прогрейте руками.
- Устранение мёртвого кода. Компилятор выкидывает вычисление, чей результат не используется. Sink-переменная (Go),
Blackhole(JMH),DoNotOptimize(C++), consumer (BenchmarkDotNet). - Шум. Turbo/частотный троттлинг, фоновая нагрузка, тепловой троттлинг. Фиксируйте частоту CPU, изолируйте ядро, гоните на тихой машине.
- Распределения, а не среднее — но какое, зависит от задачи. В микробенчмарке важен статистический вывод самого harness: повторные форки, доверительный интервал, разброс выборок (
benchstat, встроенная статистика JMH) — вопрос не «какой p99», а «значимо ли различие прогонов». Хвосты p95/p99 — это методология сервисной латентности (перцентили и хвосты): там важен медленный конец распределения под нагрузкой. Путать их — искать p99 там, где harness отвечает на другой вопрос.
Один общий закон: замер без повторов и без контроля условий не значит ничего.
Сводная таблица
| Язык | Sampling-профайлер | Микробенч-харнес | Что ловит особенно хорошо | Главная ловушка |
|---|---|---|---|---|
| Go | pprof (CPU) |
go test -bench + benchstat |
block/mutex-профили из коробки | устранение мёртвого кода |
| Java | async-profiler, JFR | JMH | alloc-профиль без правки кода | разогрев JIT |
| C++ | perf |
google/benchmark | аппаратные счётчики (кэш, ветвления) | DCE на -O2, бессмысленный -O0 |
| C# | dotnet-trace | BenchmarkDotNet | живые счётчики GC/пула | разогрев tiered JIT |
| Python | py-spy | timeit / pytest-benchmark | attach к живому процессу | GIL искажает потоки; доминирует интерпретатор |
| Node | --cpu-prof, clinic/0x |
— | лаг event loop (ELD) | ELD — симптом, не причина: нужна связка с CPU-профилем и метриками пула |
От профиля к выводу
Инструмент — половина дела; вторая половина — не обмануть себя выводом. Дисциплина одна на все языки:
- Цикл, а не «покрутил». Измерить → сформулировать гипотезу («горит в сериализации») → внести одно изменение → перемерить тем же способом. Меняете сразу три вещи — не узнаете, какая помогла (или навредила).
- Закон Амдала. Оптимизируйте то, что доминирует. Ускорить вдвое участок, дающий 5% времени ответа, — это сокращение времени ответа всего на 2.5%; те же усилия на участке в 60% сокращают время ответа на 30%. Профиль как раз и показывает, где эти 60%.
- Мерьте в условиях, близких к бою. Профиль на пустой локальной машине с крохотными данными оптимизирует фантом: и разогрев, и кэши, и contention в проде — другие.
Профиль не заменяет мышление — он направляет его на настоящее узкое место вместо придуманного.
Что дальше
Каждый язык заслуживает отдельного погружения — вот к чему ведёт эта карта (ещё не вышедшие разборы помечены как готовящиеся): pprof, benchstat и честный бенчмарк в Go, async-profiler, JFR и JMH на JVM, perf, санитайзеры и микробенчмарки в C++Скоро, dotnet-trace и BenchmarkDotNet в .NETСкоро, py-spy, GIL и нативные расширения в Pythonготовится, с 22 октября и лаг event loop и профиль V8 в NodeСкоро.
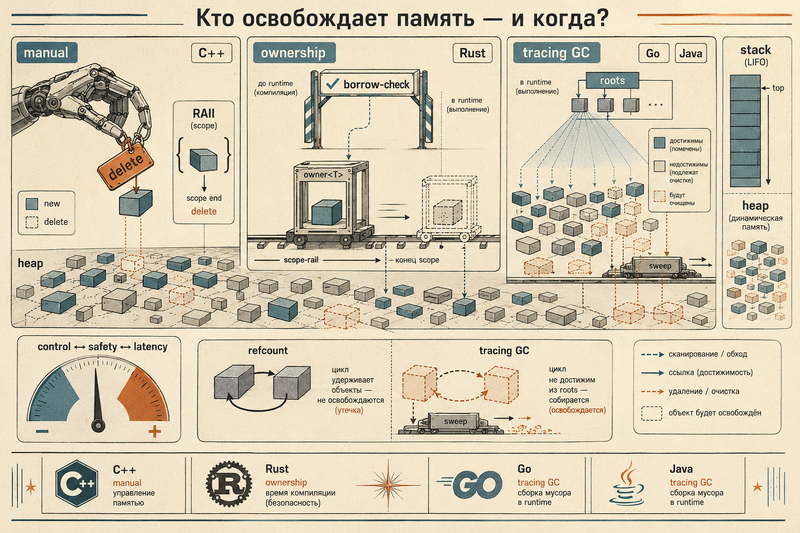
Соседние срезы той же серии — «Управление памятью в разных языках» (аллокации, за которыми и охотится профайлер) и «Ошибки, паники и исключения». Если тема интересна — напишите в Telegram-группе, какой язык разобрать подробнее в первую очередь.
Комментарии