
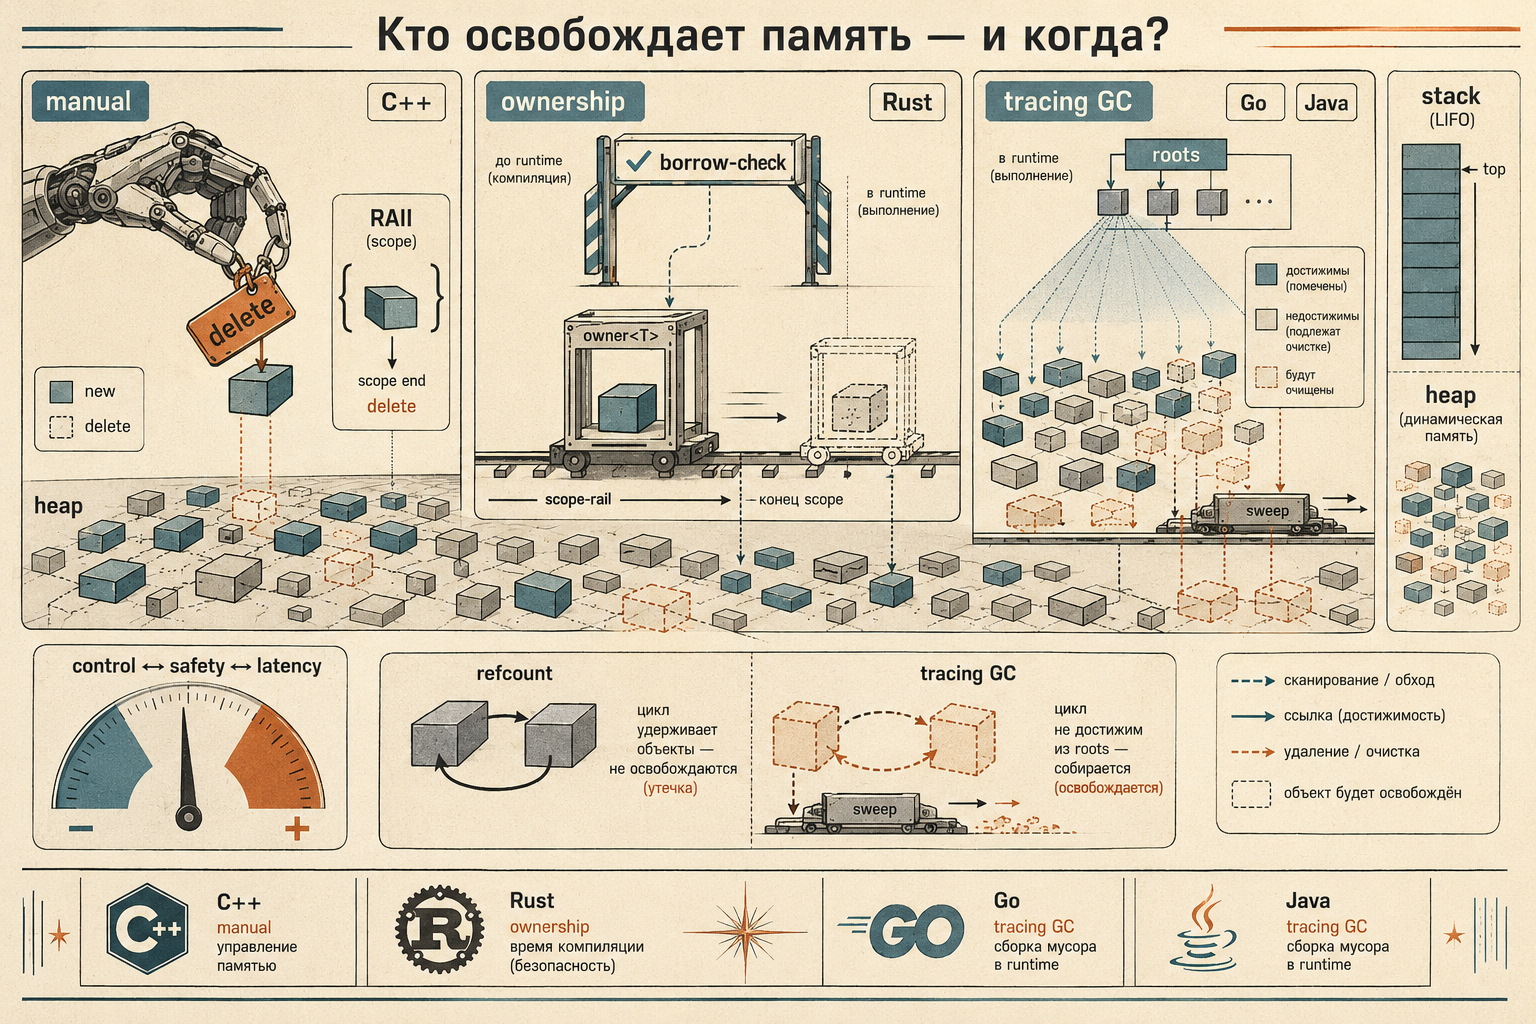
Управление памятью в каждом языке выглядит как вопрос синтаксиса и привычек: где-то new/delete, где-то Box и заимствования, где-то «просто выделяй, сборщик уберёт». Но синтаксис — следствие. За ним стоит одно решение, которое язык либо навязывает, либо оставляет программисту: кто и в какой момент решает, что участок памяти можно освободить. Из ответа на этот вопрос вырастает всё остальное — контроль над раскладкой данных, класс возможных ошибок, стоимость аллокации и предсказуемость латентности.
Эта статья — про то, как C++, Rust, Go и Java отвечают на него по-разному, и чем за каждый ответ приходится платить. Это сиблинг статьи «Ошибки, паники и исключения»: там язык навязывал модель отказов, здесь — модель памяти. Как и там, цель не справочник по синтаксису, а разбор одной оси и её следствий. Ключевые утверждения проверены на живом коде — весь стенд лежит в digital-cookbook/performance/memory-management/across-languages (C++, Rust, Go, Java — по одной команде на демонстрацию).
В статье
- Стек, куча и один общий вопрос
- Ось «кто и когда освобождает»
- C++: ручное управление и RAII
- Rust: владение, заимствование, время жизни
- Go: escape analysis и конкурентный GC
- Java/JVM: поколенческий GC и зоопарк сборщиков
- Цикл ссылок: где течёт, а где нет
- Контраст: Python, C#, Swift
- Сводная таблица
- Сквозные принципы
- Из практики: кэш, который держит слишком много
- Что дальше
Стек, куча и один общий вопрос
Прежде чем сравнивать языки, стоит договориться о двух областях, между которыми распределяется почти всякая память программы.
Стек — область, растущая и убывающая вместе с вызовами функций. Выделение — это сдвиг указателя стека на несколько байт, освобождение — обратный сдвиг при выходе из функции. Дёшево, детерминированно, без всякого «сборщика»: время жизни данных жёстко привязано к кадру вызова, дисциплина строго LIFO. Ограничение ровно в этом — данные не могут пережить функцию, которая их создала, и их размер обычно должен быть известен заранее.
Куча — область для всего, что не укладывается в дисциплину стека: объектов с динамическим или заранее неизвестным размером, данных, которые должны пережить свой кадр вызова, разделяемого владения. Гибкость стоит дороже: аллокатор ищет подходящий блок, следит за фрагментацией, синхронизирует доступ между потоками. И главное — раз данные живут дольше кадра, кто-то должен решить, когда их вернуть. Вот здесь языки и расходятся.
Что заставляет данные уходить в кучу — в целом одни и те же причины во всех четырёх: динамический или заранее неизвестный размер (срез/список, растущий в рантайме), время жизни за пределами кадра (объект, возвращаемый наружу), разделяемое владение (на объект ссылаются из нескольких мест). Но «в целом» не значит «одинаково в деталях»: у каждого языка своя семантика размещения. В Java всякий объект по модели языка живёт в куче — вернуть его на стек может только JIT через escape analysis и scalar replacement уже в рантайме; в Go в кучу выталкивает ещё и боксинг в interface{}; в C++ и Rust размещение прямо в руках программиста — тип-значение на стеке против Box/make_unique в куче. Куча обычно дороже стека (поиск блока, синхронизация, а потом ещё и освобождение), поэтому переносимый совет по производительности везде один — меньше аллокаций в куче: держать данные на стеке, где можно, переиспользовать буферы, не плодить временных объектов на горячем пути.
Важно с самого начала не смешивать два разных вопроса. Первый — где лежат данные, на стеке или в куче (размещение); его в Go частично решает компилятор автоматически (escape analysis, см. ниже), а в C++ и Rust им управляют выбором типа. Второй — кто и когда освобождает то, что попало в кучу (утилизация). Это разные оси: escape analysis отвечает на «где разместить», а не «когда собрать heap-объект». Статья построена вокруг второй оси.
Ось «кто и когда освобождает»
Речь именно про освобождение кучи — со стеком вопроса нет (кадр ушёл, данные исчезли). И здесь важно не смешивать ещё два вопроса: чем определены точки освобождения и кто гарантирует их корректность. Само освобождение почти всегда происходит в рантайме — даже в Rust деструктор выполняется во время работы программы, а не «на компиляции»; различается то, чем эти точки заданы и проверяет ли их кто-то заранее. Получается спектр из четырёх механизмов.
Ручное освобождение (C++ new/delete). Точки ставит программист, никто их не проверяет. Максимум контроля и максимум способов ошибиться.
Привязка к области видимости (C++ RAII, Rust Drop). Освобождение привязано к выходу объекта из области: деструктор (C++) или drop (Rust) вызывается детерминированно, и точки расставляет сама структура кода, а не отдельный сборщик. C++ RAII и владение в Rust — по механизму это одно и то же; разница в проверке: Rust доказывает корректность ссылок компилятором (borrow checker), а C++ полагается на дисциплину. То есть «Rust решает на этапе компиляции» — это про проверку, а не про момент освобождения: он в обоих случаях рантаймовый, по выходу из области.
Подсчёт ссылок (std::shared_ptr, Rc/Arc). Точка освобождения — обнуление счётчика ссылок в рантайме; детерминированно и без отдельного сборщика, но цикл ссылок так не собирается (об этом отдельный раздел).
Трассирующий сборщик мусора (Go, Java). Заранее расставленных точек нет: рантайм-сборщик периодически обходит граф от корней и возвращает память недостижимого. Момент освобождения недетерминирован, зато циклы собираются, а целый класс ошибок исчезает — ценой пауз, накладных расходов и меньшего контроля над раскладкой.
Языки не сидят каждый в своей клетке: C++ покрывает первые три механизма, Rust — владение и подсчёт ссылок (Rc), Go и Java — трассирующий GC. Ось — это компромисс трёх свойств: контроль над памятью, безопасность от ошибок и предсказуемость латентности. Ручное управление даёт контроль без безопасности; трассирующий GC — безопасность ценой предсказуемости (паузы) и контроля; привязка к области и подсчёт ссылок дают детерминированное освобождение, а Rust добавляет к нему проверенную компилятором безопасность. Дальше — по языкам, а в конце сведём в таблицу.
C++: ручное управление и RAII
C++ в базе кладёт решение на программиста: new и delete, парные вручную. Это даёт полный контроль над тем, где лежат данные и когда они исчезают, — и открывает весь классический набор ошибок: забытый delete (утечка), двойной delete, разыменование указателя на уже освобождённый объект (use-after-free), висячие указатели.
Дисциплина, которая делает ручное управление выносимым, — RAII (Resource Acquisition Is Initialization): ресурс захватывается в конструкторе объекта и освобождается в его деструкторе. Время жизни ресурса привязано к времени жизни объекта на стеке, а деструктор вызывается детерминированно при выходе из области — в том числе при раскрутке стека исключением (об этом — в сиблинге про обработку ошибок).
{
    std::lock_guard<std::mutex> lock(mtx);      // захват в конструкторе
    auto buf = std::make_unique<char[]>(size);  // владелец буфера
    process(buf.get());
}   // выход из блока: buf освобождён, mtx разблокирован — гарантированно
Поверх RAII стоят умные указатели, кодирующие модель владения в типе:
std::unique_ptr— единоличное владение, освобождает при разрушении, копировать нельзя (только перемещать). С делитером по умолчанию не занимает лишней памяти поверх сырого указателя (stateful или захватывающий состояние делитер это меняет — объект тогда несёт и его).std::shared_ptr— разделяемое владение через счётчик ссылок: объект живёт, пока счётчик > 0; последний владелец обнуляет счётчик и освобождает. За удобство платим атомарным счётчиком и блоком управления.std::weak_ptr— «наблюдатель» без владения: не увеличивает счётчик, умеет проверить, жив ли объект. Нужен, чтобы разрывать циклы (об этом ниже).
Ключевое ограничение подсчёта ссылок мы разберём отдельно в разделе про циклы: два объекта, ссылающиеся друг на друга через shared_ptr, не освобождаются никогда — их счётчики держат друг друга. Для нагрузок с тонким контролем над памятью в C++ есть ещё уровень — кастомные аллокаторы и пулы объектов, отдающие блоки из заранее выделенной арены и снимающие давление на системный аллокатор.
Rust: владение, заимствование, время жизни
Rust берёт RAII-идею «освобождение привязано к области видимости» и делает её проверяемым компилятором инвариантом. Три правила владения: у значения ровно один владелец; когда владелец выходит из области — значение освобождается (drop); передача значения перемещает владение (после перемещения прежней переменной пользоваться нельзя).
Чтобы данными можно было пользоваться, не передавая владение, есть заимствования (&T, &mut T), а их корректность проверяет borrow checker: одновременно допускается либо любое число неизменяемых ссылок, либо ровно одна изменяемая, и ни одна ссылка не должна пережить данные, на которые указывает. Именно это ловит use-after-free — не в рантайме, как санитайзер в C++, а на этапе компиляции: программа с висячей ссылкой просто не собирается.
fn main() {
    let mut v = vec![1, 2, 3];
    let first = &v[0];   // неизменяемое заимствование
    v.push(4);           // изменяемое заимствование: push может реаллоцировать буфер
    println!("{first}"); // ...а здесь ссылка на старый буфер ещё нужна
}
// error[E0502]: cannot borrow `v` as mutable because it is also borrowed as immutable
В стенде этот файл вынесен из сборки и компилируется отдельно: rustc завершается с кодом 1 и не создаёт бинарь. Ровно тот же паттерн в C++ — сохранить указатель на элемент std::vector, затем push_back, реаллоцирующий буфер, — компилируется молча и ловится лишь санитайзером в рантайме (heap-use-after-free); демонстрация есть в стенде.
Куча в Rust явная и типизированная: Box<T> — единоличное владение в куче (аналог unique_ptr); Rc<T> — разделяемое владение через счётчик ссылок в одном потоке, Arc<T> — его потокобезопасный (атомарный) вариант; RefCell<T> переносит проверку заимствований в рантайм, когда компилятору не хватает статической информации. «Без GC ценой строгости» — это про то, что компилятор буквально спорит с вами, пока модель владения не станет корректной; зато в безопасном подмножестве (safe Rust) в проде нет ни пауз сборщика, ни целого класса ошибок памяти — use-after-free, double-free, гонок по данным. За границей блока unsafe эти гарантии уже на совести программиста.
Важная честность: Rust не защищает от утечек. Утечка — это «памяти не вернули», а не «обратились к чужой памяти»; безопасность памяти её не запрещает. Цикл Rc (два Rc, ссылающихся друг на друга) течёт ровно как цикл shared_ptr в C++, а std::mem::forget или Box::leak протекают намеренно. Лечение циклов то же — Weak для обратной ссылки.
Go: escape analysis и конкурентный GC
Go идёт по пути сборщика мусора, но с важной оговоркой на входе: компилятор старается не отправлять в кучу то, что может жить на стеке. Это escape analysis — анализ, «убегает» ли значение за пределы своего кадра. Если компилятор доказал, что указатель на локальную переменную не переживёт функцию, переменная остаётся на стеке, и сборщику про неё думать не придётся.
//go:noinline
func stackLocal(a, b int64) int64 {
    p := &point{x: a, y: b}   // адрес берём, но за пределы кадра не выпускаем
    return p.x*p.x + p.y*p.y  // ./escape.go: &point{...} does not escape — на стеке
}

//go:noinline
func heapEscape(a, b int64) *point {
    p := point{x: a, y: b}
    return &p                 // ./escape.go: moved to heap: p — указатель уходит наружу
}
То, что всё-таки попало в кучу, собирает конкурентный mark-sweep сборщик Go. Его инженерный приоритет — не пропускная способность, а короткие паузы: фазы разметки и очистки идут в основном параллельно с работающей программой, а stop-the-world окна проектируются суб-миллисекундными. В стенде аллокационно-тяжёлый ворклоад на linux/amd64 в каноническом прогоне дал медиану STW-паузы ~140 мкс, p99 ~330 мкс, максимум ~370 мкс; в других прогонах отдельные паузы заходили в низкие миллисекунды (0.5–3 мс). Это замер одного прогона, не свойство языка: абсолютные числа плавают от машины и ОС на порядки (на Windows короткие паузы вообще тонут в разрешении системного таймера и читаются как ноль — отдельная ловушка измерения). Официальное руководство по GC в Go прямо перечисляет несколько источников задержек и не обещает единого «диапазона пауз». Устойчиво лишь качественное: медиана в сотнях микросекунд против десятков миллисекунд у throughput-ориентированных stop-the-world сборщиков. Плата за короткие паузы — сборщик работает чаще и потребляет CPU конкурентно с приложением.
Главная метрика, за которой стоит следить в Go, — давление на аллокатор (allocation pressure): сколько объектов в куче создаётся в единицу времени. Чем оно выше, тем чаще запускается сборщик и тем больше CPU уходит на разметку. Разница видна на счётчике allocs/op: тот же цикл, аллоцирующий буфер на каждой операции, показывает 1 аллокацию на операцию; он же с переиспользованием через sync.Pool — 0 аллокаций в этом бенчмарке. Важно понимать статус этого нуля: sync.Pool вправе очиститься при любой сборке мусора, поэтому ноль — результат конкретного прогона под нагрузкой, а не гарантия на каждый вызов; но само направление (снятие давления на аллокатор) устойчиво, и allocs/op для этого куда надёжнее, чем ns/op, который зависит от машины. Отсюда практический инструментарий:
pprof(профильalloc_space/inuse_space) — где и сколько аллоцируется;sync.Pool— переиспользование временных объектов вместо создания новых на горячем пути;- сокращение аллокаций — предвыделенные срезы, отказ от лишнего боксинга в
interface{}, буферы вместо конкатенаций.
Отдельная честность про утечки: GC не спасает от логических утечек. Если вы держите ссылку на объект — в глобальной мапе-кэше без вытеснения, в незакрытой горутине, в слайсе, который только растёт, — сборщик считает объект достижимым и не тронет. Память течёт при живом сборщике.
Java/JVM: поколенческий GC и зоопарк сборщиков
JVM довела сборку мусора до отдельной инженерной дисциплины, причём с несколькими сменными сборщиками. Классическая модель — поколенческая, в основе поколенческая гипотеза: большинство объектов умирает молодыми. Отсюда деление кучи на молодое поколение (young), где аллокация дёшева — просто сдвиг указателя в буфере, а сборка частая и быстрая, и старое (old), куда переживших несколько сборок объектов продвигают и собирают реже. Так устроены Parallel и G1; но не все современные сборщики строго поколенческие — об этом ниже.
Выбор сборщика — это выбор компромисса «пропускная способность против пауз»:
- G1 (по умолчанию) — регионный поколенческий, балансирует throughput и паузы: старается уложиться в настраиваемую цель (
-XX:MaxGCPauseMillis, по умолчанию 200 мс — это цель, а не потолок и не гарантия), умеет уплотнять (compaction) кучу, борясь с фрагментацией. - ZGC и Shenandoah — сборщики с прицелом на суб-миллисекундные паузы почти независимо от размера кучи; уплотняют конкурентно, ценой большего CPU и барьеров на доступ к памяти. Их «поколенчность» зависит от версии JDK, и это важная деталь. В JDK 21 (на нём собран стенд)
-XX:+UseZGC— это непоколенческий ZGC, поколенческий включается флагом-XX:+ZGenerational(preview). Дальше маятник качнулся к поколениям: в JDK 23 поколенческий ZGC стал дефолтным (JEP 474), в JDK 24 непоколенческий режим удалён (JEP 490), а в JDK 25 появился штатный generational Shenandoah (JEP 521, пока не по умолчанию). То есть «поколенческий» — свойство конкретного сборщика конкретной версии, а не всей JVM. - Parallel — наоборот, максимум throughput ценой заметных stop-the-world пауз; для батчей, где латентность не важна.
В стенде на одном прогоне (куча 512 МБ) G1 дал паузы молодого поколения порядка единиц миллисекунд, ZGC — сотые доли миллисекунды. Это соотношение конкретного прогона, а не гарантия: цель паузы G1 лишь настраивается (см. выше), часть работы идёт конкурентно, а абсолютные числа зависят от кучи, нагрузки и железа. Устойчиво лишь направление: сборщики с прицелом на паузы (ZGC/Shenandoah) держат stop-the-world окна много меньше throughput-ориентированных, и ради этого на latency-критичных сервисах переходят с G1 на ZGC.
Отдельная тема — толщина памяти JVM: у каждого объекта есть заголовок (mark word + указатель на класс). В стенде простой узел графа с одним int и одной ссылкой занимает 24 байта: 12 из них — заголовок, 8 — сами поля (int плюс сжатая ссылка), остаток — выравнивание. А autoboxing превращает примитив в объект в куче: массив из 10 000 Integer весит впятеро больше, чем int[] той же длины — каждый элемент из четырёхбайтового int становится 16-байтовым объектом плюс ссылка на него. Когда это критично, данные выносят off-heap (прямые буферы, Unsafe/Foreign Memory API), где раскладку контролируют вручную, как в C++.
Цикл ссылок: где течёт, а где нет
Здесь ось освобождения даёт самый наглядный контраст, и он же — ядро стенда к статье. Возьмём простейшую циклическую структуру: два узла, ссылающихся друг на друга (a.other = b; b.other = a), после чего внешние ссылки на оба узла отброшены. С точки зрения программы оба узла — мусор, до них снаружи не дойти. Собираются ли они?
Подсчёт ссылок — нет. shared_ptr в C++ и Rc в Rust считают входящие ссылки; у каждого узла из пары счётчик держит второй узел, поэтому ни один не падает до нуля. Память утекает, и это видно детерминированно: деструкторы не вызываются ни разу.
Трассирующий GC — да. Go и Java не считают ссылки, а обходят граф от корней (стек, глобальные переменные) и собирают всё, до чего не дошли. Циклический островок, отрезанный от корней, недостижим целиком — и собирается целиком. Это видно по возврату памяти после форсированной сборки.
Стенд собирает один и тот же сценарий на четырёх языках и снимает свидетельство:
| Механизм | Язык | Цикл собран? | Свидетельство из стенда |
|---|---|---|---|
| подсчёт ссылок | C++ (shared_ptr) |
нет | 0 вызовов деструктора; LeakSanitizer: 80 байт в 2 аллокациях |
| подсчёт ссылок | Rust (Rc) |
нет | 0 вызовов Drop |
| трассирующий GC | Go | да | 32 МБ и ~400 000 объектов освобождены после runtime.GC() |
| трассирующий GC | Java | да | 34 МБ освобождены, все 400 000 Cleaner сработали |
Мораль не «GC лучше». Подсчёт ссылок даёт детерминированное освобождение в точке обнуления счётчика (важно для не-памятных ресурсов — файлов, сокетов) и не требует отдельных пауз сборщика — хотя и он не бесплатен по латентности: разрушение большого связного графа идёт по цепочке синхронно в точке освобождения (каскадное обнуление счётчиков), и это может дать всплеск. Трассирующий GC решает проблему циклов, но платит паузами и недетерминизмом момента освобождения. Цикл — это конкретная нагрузка, на которой их разница проявляется в лоб. Чинится подсчёт ссылок разрывом цикла через слабую ссылку: владелец держит потомка сильной ссылкой (shared_ptr, Rc), а обратную ссылку делают слабой (weak_ptr, Weak) — тогда счётчик не зацикливается и оба узла освобождаются. Но это ручное решение, о котором надо не забыть.
Контраст: Python, C#, Swift
Чтобы ось была видна целиком — три языка одним абзацем. Python и Swift используют подсчёт ссылок как основной механизм (CPython — refcount плюс отдельный циклический сборщик поверх; Swift — ARC, автоматический подсчёт ссылок, расставляемый компилятором). Это значит, что в Swift цикл сильных ссылок течёт ровно как в C++, и лечится он тем же — слабыми ссылками (weak/unowned); Python же держит дополнительный сборщик именно ради циклов. C# ближе к Java: трассирующий поколенческий GC (циклы собирает), но с важным добавлением — тип-значения (struct) и stackalloc вместе со Span<T> позволяют работать со стековой памятью без heap-аллокации (сам Span<T> — стековый дескриптор, который может смотреть и на стек, и на кучу, и на unmanaged-память), а IDisposable/using дают детерминированное освобождение не-памятных ресурсов поверх недетерминированного GC. Один и тот же вопрос — «кто освобождает» — и снова весь спектр ответов.
Сводная таблица
| Язык | Механизм(ы) утилизации кучи | Момент освобождения | Собирает цикл? | Проверка ссылок компилятором |
|---|---|---|---|---|
| C++ | ручное new/delete · RAII · счётчик (shared_ptr) |
детерминированный (по области / счётчику) | нет (счётчик) | нет |
| Rust | владение/Drop · счётчик (Rc/Arc) |
детерминированный (по области / счётчику) | нет (Rc) |
да (borrow checker) |
| Go | трассирующий конкурентный GC | недетерминированный (решает сборщик) | да | нет |
| Java | трассирующий GC (G1 поколенческий; ZGC/Shenandoah — зависит от версии JDK, см. текст) | недетерминированный | да | нет |
Освобождение во всех случаях происходит в рантайме — водораздел не «компиляция против рантайма», а механизм: привязка к области и подсчёт ссылок дают детерминированный момент (но подсчёт ссылок течёт на циклах), трассирующий GC берёт циклы и снимает класс ошибок ценой недетерминизма и пауз. Ортогонально этой оси — два других вопроса: размещение (стек/куча; в Go им отчасти управляет escape analysis на этапе компиляции) и кто проверяет корректность ссылок (в Rust — компилятор, у остальных — программист или рантайм).
Сквозные принципы
Независимо от модели языка работают одни и те же правила.
- Меньше аллокаций в куче. Самый переносимый совет: держи данные на стеке, где уместно (escape analysis, тип-значения/
struct), переиспользуй буферы (sync.Pool, пулы объектов), не плоди временных объектов на горячем пути. Это снижает и стоимость аллокации, и давление на сборщик. (Оговорка: RAII и владение — это про детерминированное освобождение, а не про стек;unique_ptr/Boxпрекрасно управляют и кучей.) - Утечки бывают и при GC. Сборщик спасает от «забыл освободить», но не от «держу ненужную ссылку»: кэши без вытеснения, незакрытые слушатели/подписки, растущие коллекции,
ThreadLocal. Утечка через достижимость — самая частая в управляемых языках. - Фрагментация и уплотнение. Аллокаторы без compaction (ручной C++, базовый malloc) со временем фрагментируют кучу; уплотняющие сборщики (G1, ZGC, Shenandoah) её дефрагментируют, но платят за перемещение объектов.
- Латентность против детерминизма. Ручное/владельческое освобождение детерминированно (важно для жёсткой латентности и не-памятных ресурсов); GC снимает класс ошибок, но вносит паузы. Выбор — не «что быстрее», а «что критичнее под вашу нагрузку».
- Локальность данных. Вне зависимости от модели памяти, cache-friendly раскладка (массивы структур против структур указателей, отсутствие лишнего боксинга) — общий рычаг производительности: промах кэша дороже любой удачной аллокации.
Из практики: кэш, который держит слишком много
Самый частый способ устроить утечку в языке со сборщиком мусора выглядит невинно — добавить кэш. Сервис кладёт результаты в map/HashMap, «чтобы не считать дважды», ключей со временем становится всё больше (по пользователю, по запросу, по идентификатору сессии), а вытеснения нет. Память растёт линейно с трафиком, RSS ползёт вверх, и однажды процесс упирается в лимит: OutOfMemoryError на JVM, OOM-kill пода в Kubernetes на Go. При этом ни одного «забытого free» в коде нет — с точки зрения языка всё корректно.
Корень — ровно тот, о котором вся статья, только этажом выше синтаксиса. Сборщик мусора отвечает на вопрос «достижим ли объект», а не «нужен ли он ещё». Пока запись лежит в живом кэше, объект достижим от корней — и для трассирующего GC он не мусор, сколько бы времени к нему ни обращались. «Логически мёртв, но синтаксически жив» — это и есть утечка через достижимость, от которой GC не защищает по построению. Лечится она не сборщиком, а политикой времени жизни, заданной явно: ограниченный размер с вытеснением (LRU), TTL, слабые ссылки для необязательных записей (WeakHashMap, weak-значения). Показательно, что это тот же вопрос, что решают delete в C++ и drop в Rust, — «когда это больше не нужно». GC снял его с уровня каждого объекта, но на уровне кэша решение о времени жизни всё равно принимает человек; просто теперь цена ошибки — не use-after-free, а неограниченный рост.
Что дальше
Каждый из языков заслуживает отдельного погружения: escape analysis и pprof в Go, тюнинг G1/ZGC и heap-профили в JVM, модель владения и границы panic в Rust, кастомные аллокаторы и профилирование памяти в C++Скоро. Профилирование памяти по языкам — тема сиблинга «Профилирование в разных языках: как измерять без самообмана». Весь код этой статьи — в стенде digital-cookbook/performance/memory-management/across-languages: один сценарий, четыре языка, каждое демо запускается одной командой. Если тема интересна — напишите в Telegram-группе, какой язык разобрать подробнее в первую очередь.

Комментарии