
etcd — не in-memory система в том смысле, что Redis, Tarantool, Picodata, Aerospike или Ignite из предыдущих статей серии. Там данные, которые нужно быстро отдавать, физически резидентны в оперативной памяти — это и даёт throughput. У etcd наоборот: физические значения и вся история их ревизий хранятся в persistent B+tree — bbolt, файл на диске, к которому etcd обращается через memory-mapped I/O. В памяти постоянно держится только вторичный индекс (etcd называет его treeIndex) — B-tree, где каждому пользовательскому ключу сопоставлен указатель на нужную ревизию в этом файле, а не само значение. Задача etcd — ответить на вопрос «какое значение сейчас истинно во всём кластере», причём так, чтобы после сетевого разрыва, падения узла или гонки клиентов ответ не разошёлся с реальностью, — и решается она через Raft-консенсус поверх этой дисковой MVCC-модели, а не через резидентность данных в RAM. Поэтому в этой статье нет раздела про throughput: пропускная способность здесь не была ни целью дизайна etcd, ни предметом измерения стенда.
Это пятая статья серии «Вычисления в оперативной памяти», и она стоит особняком не только по теме, но и по месту в самой таксономии серии: четвёртая статья про Aerospike и Ignite закрывала тему масштаба — там память всё ещё служила данным и их пропускной способности. Здесь память не служит данным вовсе: пять предыдущих систем серии в разной степени держат в RAM сами данные ради скорости к ним, а etcd данные в RAM не держит — резидентен только маршрутизирующий индекс, обслуживающий Raft и линеаризуемое чтение. Именно поэтому статья про etcd в серии — не шестой пример «данные в памяти → скорость», а её граница: точка, где эта таксономия перестаёт объяснять систему, и ровно поэтому она здесь ценна как контраст. Все числа ниже — из живого стенда etcd-coord (четыре сценария: watch, lease, lock, revisions; etcd v3.7.0, клиент go.etcd.io/etcd/client/v3 v3.7.0) — единственного стенда серии, который воспроизвёлся дословно по брифу с первого прогона, без единого отклонения от compose и интерфейса.
В статье
- Raft и линеаризуемые чтения
- MVCC-ревизии: история ключа
- Watch: подписка без потерь
- Lease: TTL-ключи и keepalive
- Распределённая блокировка
- Компакция: логическое место против физического файла
- Почему etcd не ускоритель
- Что дальше
Raft и линеаризуемые чтения
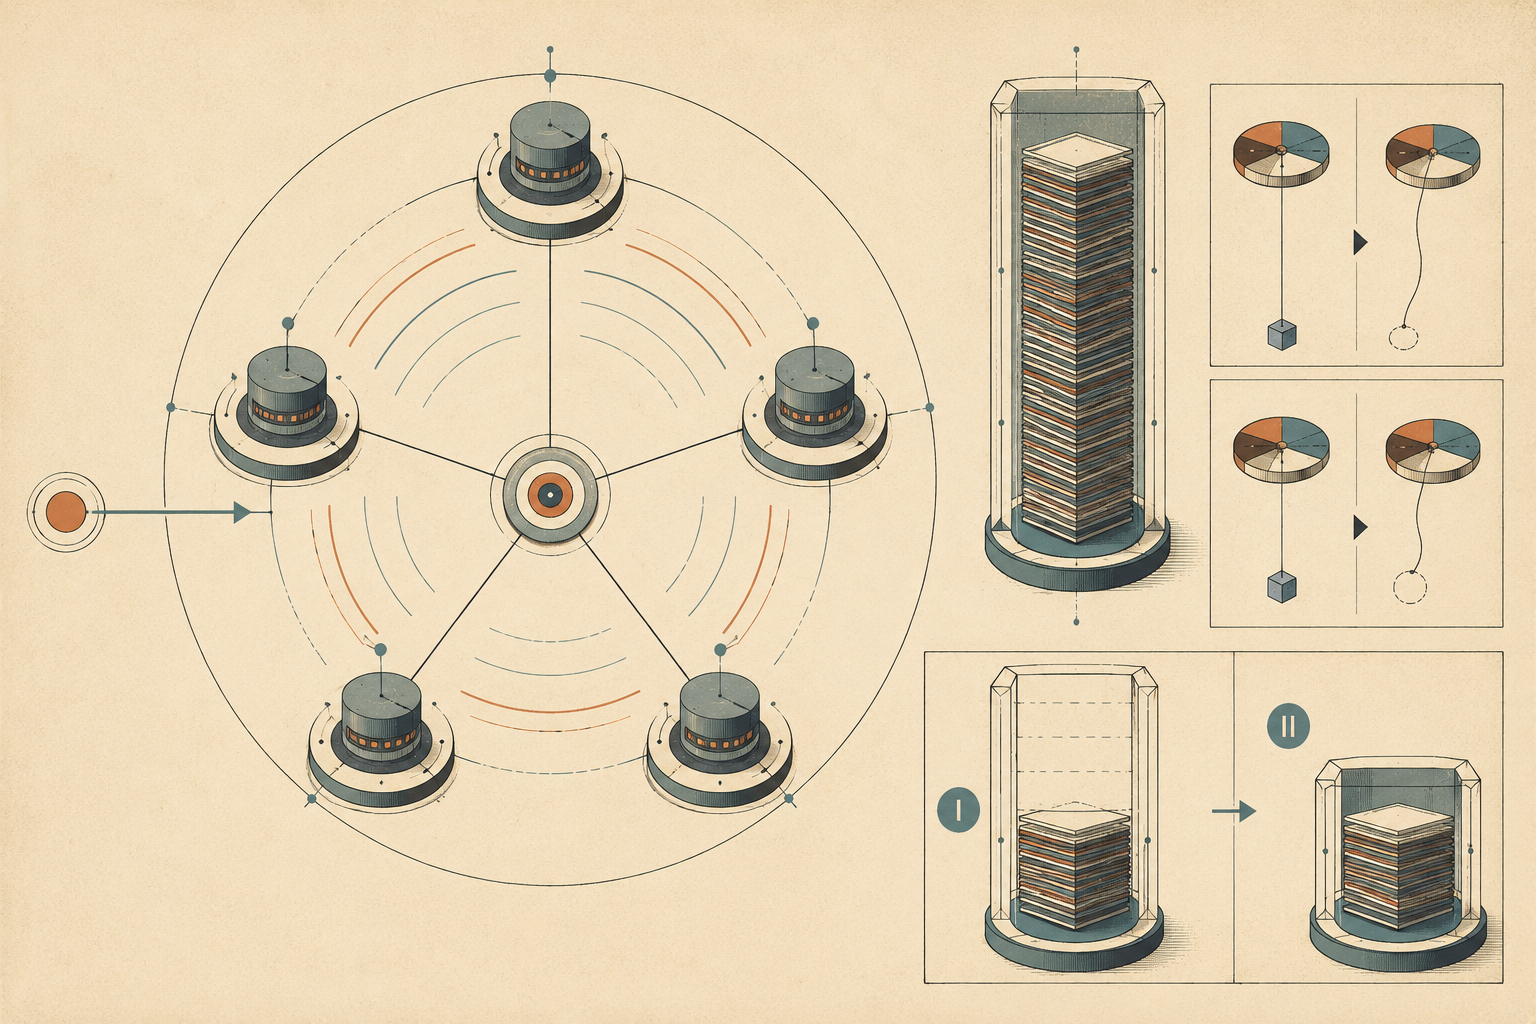
Каждая запись в etcd проходит через Raft: лидер реплицирует запись на большинство узлов кластера и только после этого подтверждает клиенту — отсюда рекомендация держать нечётное число узлов (3 или 5) и цена в виде дополнительного сетевого раунд-трипа на кворум. Чётное число узлов не запрещено и работает: просто кластер из четырёх переживает отказ одного узла — ровно как кластер из трёх, — но платит за это большим кворумом, то есть даёт ту же устойчивость дороже. Чтение по умолчанию тоже линеаризуемо: клиент получает гарантированно самое свежее подтверждённое значение, а не то, что конкретный узел успел локально применить к моменту запроса, — за это etcd платит собственным раунд-трипом подтверждения лидерства, а не просто локальным чтением. Полный разбор того, как разные алгоритмы консенсуса (Raft, Paxos, Zab, EPaxos) решают эту задачу и какими trade-off’ами при этом жертвуют, — в отдельном туре «Consensus Landscape»; здесь достаточно одного вывода: кворумная запись и линеаризуемое чтение — это то, что делает etcd надёжным источником истины для небольшого состояния, и то же самое, что делает его плохим выбором для высокого throughput.
Физические данные, которыми оперирует этот Raft-слой, резидентны не в памяти, а в persistent b+tree backend’е (bbolt) — файле на диске: документация etcd прямо описывает это как «etcd stores the physical data as key-value pairs in a persistent b+tree», а ключ такой пары — трёхкомпонентный (major, sub, type), где major — это ревизия хранилища. Резидентен постоянно только вторичный B-tree-индекс (treeIndex): «etcd also keeps a secondary in-memory btree index to speed up range queries over keys», и «the value is a pointer to the modification of the persistent b+tree» — то есть указатель на ревизию, а не само значение. Порядок чтения ровно такой: «etcd gets the revision information from btree and then uses the revision as key to fetch value from b+tree» — сначала индекс в памяти отдаёт номер ревизии, затем по этому номеру значение читается с диска. Отсюда практическое следствие: память etcd растёт с числом ключей и ревизий, а не с объёмом самих значений — крупное значение почти не увеличивает резидентную память, потому что индекс хранит про него только указатель. Durability при этом обеспечивает не резидентность данных и не сам backend-файл, а WAL на диске: каждая запись фиксируется в write-ahead log до подтверждения клиенту, и именно это отличает etcd от Redis из второй статьи серии — там персистентность опциональна и небезболезненна, здесь она обязательна и встроена в сам протокол согласования.
MVCC-ревизии: история ключа
etcd не перезаписывает значение на месте — каждая запись создаёт новую ревизию, и до компакции старые ревизии остаются доступны по запросу. Сценарий revisions стенда перезаписывает один и тот же ключ 2000 раз подряд и запоминает номер ревизии после каждой записи:
payload := strings.Repeat("x", 256)
for i := 0; i < overwrites; i++ {
	resp, err := cli.Put(ctx, key, fmt.Sprintf("%s-%d", payload, i))
	if err != nil {
		log.Fatalf("Put #%d: %v", i, err)
	}
	revisions = append(revisions, resp.Header.Revision)
}
Ревизия из середины истории (revisions[len(revisions)/2]) читается через WithRev и до компакции возвращает ровно то значение, которое было записано на этом шаге:
oldGet, err := cli.Get(ctx, key, clientv3.WithRev(oldRev))
if err != nil {
	log.Fatalf("Get по старой ревизии %d (до компакции): %v", oldRev, err)
}
if len(oldGet.Kvs) != 1 {
	log.Fatalf("АССЕРТ: старая ревизия %d недоступна ДО компакции — история MVCC не работает", oldRev)
}
Живой прогон подтверждает это побитово: значение по старой ревизии совпадает с ожидаемым payload-<индекс>. Это ровно то свойство, на котором строится watch ниже — клиент, отставший от потока событий, может запросить историю с конкретной ревизии, а не только «текущее» значение.
Watch: подписка без потерь
Реактивная конфигурация и обнаружение изменений — самое частое применение etcd на практике: сервис подписывается на ключ или префикс и получает поток событий вместо периодического опроса. Сценарий watch проверяет главное требование к этому механизму — ни одно изменение не должно потеряться, даже если подписка временно оборвалась:
func collectWatchEvents(ctx context.Context, wch clientv3.WatchChan, want int, timeout time.Duration) []watchEvent {
	var events []watchEvent
	deadline := time.After(timeout)
	for len(events) < want {
		select {
		case wresp, ok := <-wch:
			if !ok {
				log.Fatalf("АССЕРТ watch: канал закрылся раньше, чем получено %d событий (получено %d)", want, len(events))
			}
			if err := wresp.Err(); err != nil {
				log.Fatalf("watch ошибка: %v", err)
			}
			for _, ev := range wresp.Events {
				events = append(events, watchEvent{
					rev: ev.Kv.ModRevision,
					key: string(ev.Kv.Key),
					typ: ev.Type.String(),
				})
			}
		case <-deadline:
			log.Fatalf("АССЕРТ watch: таймаут %s, получено %d из %d событий", timeout, len(events), want)
		}
	}
	return events
}
Сам сценарий в две фазы: сначала watch слушает вживую и ловит 12 изменений через канал, затем подписка обрывается по-настоящему — вызовом cancel() контекста, а не имитацией — и, пока живого канала нет, происходит ещё 8 изменений мимо него. После разрыва клиент пересоздаёт watch не с текущего момента, а с WithRev(lastRev1+1) — досматривает историю с той ревизии, на которой остановился:
events1 := collectWatchEvents(ctx, wch1, changesBeforeGap, 10*time.Second)
lastRev1 := events1[len(events1)-1].rev
cancel1() // симулируем разрыв подписки — watcher больше не слушает

// Пока watch1 остановлен, продолжаем менять ключи — эти изменения
// НЕ увидены никаким живым watch-каналом в момент своего появления.
for i := changesBeforeGap; i < changesMade; i++ {
	key := fmt.Sprintf("%skey-%02d", prefix, i)
	if _, err := cli.Put(ctx, key, fmt.Sprintf("v%d", i)); err != nil {
		log.Fatalf("put %s: %v", key, err)
	}
}

// Фаза 2: пересоздаём watch с WithRev(lastRev1+1) — досмотр истории
// с прошлой ревизии, как после переподключения после сбоя.
// ... (создание watchCtx2 с отменой опущено)
wch2 := cli.Watch(watchCtx2, prefix, clientv3.WithPrefix(), clientv3.WithRev(lastRev1+1))
events2 := collectWatchEvents(ctx, wch2, changesAfterGap, 10*time.Second)
Живой результат: фаза 1 (живой канал) — 12 событий, последняя увиденная ревизия — 13; разрыв; 8 изменений сделано мимо живого канала; фаза 2 (WithRev=14, досмотр истории) — ещё 8 событий. Итого 20 событий на 20 изменений — потерь нет, и ревизии по всему склеенному потоку строго возрастают от 2 до 21, включая границу между «живой» фазой и досмотром через WithRev. Сценарий воспроизведён дважды, включая повторный прогон тем же процессом на контейнере с уже накопленной историей (абсолютные номера ревизий там другие — накопились от предыдущих прогонов, — но картина та же: 20/20 событий без потерь, монотонный рост).
Честная граница: этот стенд не проверяет случай, когда разрыв подписки происходит одновременно с компакцией — то есть когда к моменту переподписки нужная ревизия уже вычищена Compact. По документированной механике MVCC (см. раздел про компакцию ниже) Watch в этом случае должен вернуть ошибку компакции, а не тихо потерять события, — но это заключение по документации, не проверенное живым прогоном в рамках этой серии. Не стоит подавать это как проверенный факт.
Lease: TTL-ключи и keepalive
Lease — это TTL, привязанный к ключу через сервер, а не через клиентский таймер: сервер сам решит, когда ключ пора удалить, даже если клиент, который его создал, давно недоступен. Это база для heartbeat, лидер-элекшена и service discovery — сервис регистрирует себя ключом с lease и продлевает его через keepalive, пока жив; как только keepalive прекращается (процесс упал, сеть легла), ключ исчезает сам, без дополнительной логики очистки на стороне наблюдателей.
Сценарий lease стенда проверяет обе половины этого поведения при TTL=3 секунды. Без keepalive:
leaseA, err := cli.Grant(ctx, ttlSeconds)
...
if _, err := cli.Put(ctx, keyA, "alive", clientv3.WithLease(leaseA.ID)); err != nil {
	log.Fatalf("Put (A) с lease: %v", err)
}
...
time.Sleep(time.Duration(ttlSeconds+graceSeconds) * time.Second)

getResp, err = cli.Get(ctx, keyA)
existsAfterExpiry := len(getResp.Kvs) != 0
if existsAfterExpiry {
	log.Fatalf("АССЕРТ: ключ пережил истечение lease — TTL не работает")
}
Живой прогон: ключ существует сразу после Put, и после ожидания TTL+запас (3+2=5 секунд) без keepalive — исчезает, ровно как ожидалось. С активным keepalive та же проверка даёт обратный результат — ключ переживает исходный TTL:
kaCh, err := cli.KeepAlive(kaCtx, leaseB.ID)
...
go func() {
	defer kaWG.Done()
	for range kaCh {
		atomic.AddInt64(&kaResponses, 1)
	}
}()

time.Sleep(waitBeyondTTL) // больше исходного TTL

getResp, err = cli.Get(ctx, keyB)
survivedPastTTL := len(getResp.Kvs) == 1
if !survivedPastTTL {
	log.Fatalf("АССЕРТ: ключ с активным keepalive исчез раньше срока — keepalive не работает")
}
После этого keepalive останавливается явным cancel(), и на следующей проверке тот же ключ B тоже исчезает — TTL снова начинает действовать, как только продление прекращается. Число откликов keepalive за время ожидания стенд тоже печатает, но здесь стоит честная оговорка: это число оказалось недетерминированным между прогонами (наблюдались и 4, и 5) — не системное свойство etcd, а зависимость от таймингов конкретного прогона, поэтому в статье оно не публикуется как значимая величина. Значим только качественный факт: ключ пережил TTL под активным keepalive и снова начал исчезать сразу после остановки keepalive.
Распределённая блокировка
Пакет concurrency строит взаимное исключение поверх тех же примитивов — lease и ревизий: сессия держит lease, а Mutex создаёт ключ с растущим суффиксом ревизии и ждёт, пока не станет первым в очереди. Сценарий lock намеренно ослабляет критическую секцию, чтобы расширить окно гонки, если блокировка на самом деле не держит:
sess, err := concurrency.NewSession(cli)
...
mu := concurrency.NewMutex(sess, prefix)
if err := mu.Lock(ctx); err != nil {
	log.Fatalf("run %d worker %d: Lock: %v", runID, workerID, err)
}

// ---- критическая секция ----
cur := atomic.AddInt32(&inCritical, 1)
maxSeenLock.Lock()
if cur > maxSeen {
	maxSeen = cur
}
maxSeenLock.Unlock()

counterVal++ // намеренно НЕ atomic — инкремент защищён (по гипотезе) самим mutex'ом
time.Sleep(5 * time.Millisecond) // расширяет окно гонки, если блокировка не держит

atomic.AddInt32(&inCritical, -1)
// ---- конец критической секции ----

if err := mu.Unlock(ctx); err != nil {
	log.Fatalf("run %d worker %d: Unlock: %v", runID, workerID, err)
}
Здесь важна конструкция проверки: инкремент счётчика (counterVal++) намеренно небезопасен сам по себе — итог counter=10 в принципе мог бы совпасть и в том случае, если бы Mutex не держал вовсе, просто по случайному стечению планировщика на конкретном прогоне. Поэтому взаимное исключение проверяется отдельным атомарным счётчиком одновременных входов в критическую секцию (maxConcurrent) — он ловит сломанную блокировку даже тогда, когда counter случайно сошёлся правильно. Это не тавтология с самим мьютексом: maxConcurrent не использует Mutex для своего подсчёта, он независимо фиксирует, сколько горутин физически находятся внутри критической секции одновременно.
Живой результат — 20 из 20 прогонов (10 внутри одного процесса и ещё 10 отдельным процессом, каждый на своём ключе-префиксе, без переиспользования состояния между прогонами) дали counter=10 и maxConcurrent=1 без единого отклонения.
Компакция: логическое место против физического файла
История ревизий из раздела выше не бесплатна: без периодической очистки MVCC-хранилище растёт с каждой записью, даже если ключей в системе немного, а перезаписывается один и тот же ключ. Compact помечает старые ревизии как удалённые логически; физическое место на диске освобождает только Defragment. Сценарий revisions стенда снимает размер базы (endpoint status: dbSize — физический файл, dbSizeInUse — логически занятое место) на каждом шаге:
compactTo := latestRev - 1
if _, err := cli.Compact(ctx, compactTo); err != nil {
	log.Fatalf("Compact(%d): %v", compactTo, err)
}
...
// АССЕРТ: старая ревизия, ушедшая под компакцию, больше недоступна.
_, err = cli.Get(ctx, key, clientv3.WithRev(oldRev))
if err == nil {
	log.Fatalf("АССЕРТ: старая ревизия %d осталась доступна ПОСЛЕ компакции до %d — компакция не сработала", oldRev, compactTo)
}
...
// Defragment — физически сжимает файл базы на диске.
if _, err := cli.Defragment(ctx, endpoint); err != nil {
	log.Fatalf("Defragment(%s): %v", endpoint, err)
}
Живые цифры (первый прогон, чистый --data-dir): после 2000 перезаписей ключа — dbSize=897024, dbSizeInUse=897024. После Compact, до Defragment — dbSize не изменился (897024), а dbSizeInUse упал до 200704: место помечено свободным логически, но файл на диске не тронут. После Defragment — dbSize=24576, dbSizeInUse=16384: сокращение физического файла на -97,3% относительно размера после записей. Запрос старой ревизии после Compact возвращает mvcc: required revision has been compacted — ровно ту ошибку, которую АССЕРТ выше и ожидал получить.
Это иллюстрация задокументированного поведения etcd, а не открытие стенда: Compact освобождает логическое пространство для переиспользования будущими записями, а возвращает место операционной системе только Defragment. Практический вывод отсюда прямой: Compact без Defragment не остановит рост файла на диске сам по себе — он лишь позволяет etcd переиспользовать освобождённое пространство под новые записи; без регулярного выполнения обеих операций MVCC-история будет расти неограниченно на любом профиле нагрузки, где ключи часто перезаписываются.
Почему etcd не ускоритель
Кворумная запись через Raft и линеаризуемое чтение — это ровно то, что делает etcd надёжным источником истины, и одновременно то, что структурно ограничивает его throughput: каждая запись — не локальная операция в памяти, а раунд-трип до большинства узлов кластера. У Redis, Tarantool или Aerospike из предыдущих статей серии throughput — цель дизайна; у etcd throughput — цена, которую платят за консистентность, и снижать эту цену дальше означало бы жертвовать самим свойством, ради которого etcd вообще используют.
Роль etcd — небольшие критичные метаданные: конфигурация, service discovery, координация между инстансами, распределённые блокировки, лидер-элекшен. Не датасеты приложения, не кэш перед базой, не очередь сообщений. «Распределённые конфигурации: etcd, Consul, Vault и когда они действительно нужны» разбирает, когда до этой роли вообще стоит дорастать (env и файлы часто достаточно) и чем etcd в ней отличается от Consul и Vault; «Распределённые блокировки и координация» — отдельно про распределённые блокировки, fencing token и то, почему наивный Redlock вызвал многолетний спор, а concurrency.Mutex из раздела выше — не единственный и не всегда лучший способ решить задачу взаимного исключения.
Что ломается, если etcd нагрузить не по назначению — большими значениями, высокой частотой записи, раздуванием MVCC-истории без компакции до жёсткой квоты, — эта статья намеренно не измеряет: полный сценарий с квотой, отказом database space exceeded и восстановлением через Compact → Defragment → AlarmDisarm — в шестой, заключительной статье серииготовится, с 26 сентября. Здесь важно только зафиксировать границу: то, что делает etcd надёжным для небольшого числа критичных ключей, не масштабируется на роль горячего хранилища данных приложения — не потому что etcd плохо написан, а потому что кворумная запись и полная MVCC-история любой перезаписи — это осознанная цена за линеаризуемость, а не недоработка.
Общая карта, где etcd стоит рядом с остальными подходами к хранению и координации, — в хабе «Данные: карта хранилищ и подходов».
Что дальше
Следующая, шестая и заключительная статья серии — «Нагрузочный стенд и карта выбора in-memory систем»готовится, с 26 сентября — сводит Redis, Tarantool, Aerospike и Ignite в единый прикладной бенчмарк и отдельно измеряет, что происходит с etcd под несвойственной ему нагрузкой: жёсткая квота вместо стандартных 2 ГиБ, отказ database space exceeded на профиле, который тот же Redis держит без единой ошибки, и восстановление после него. Здесь этот сценарий был только обещан — там он будет измерен.
Комментарии