
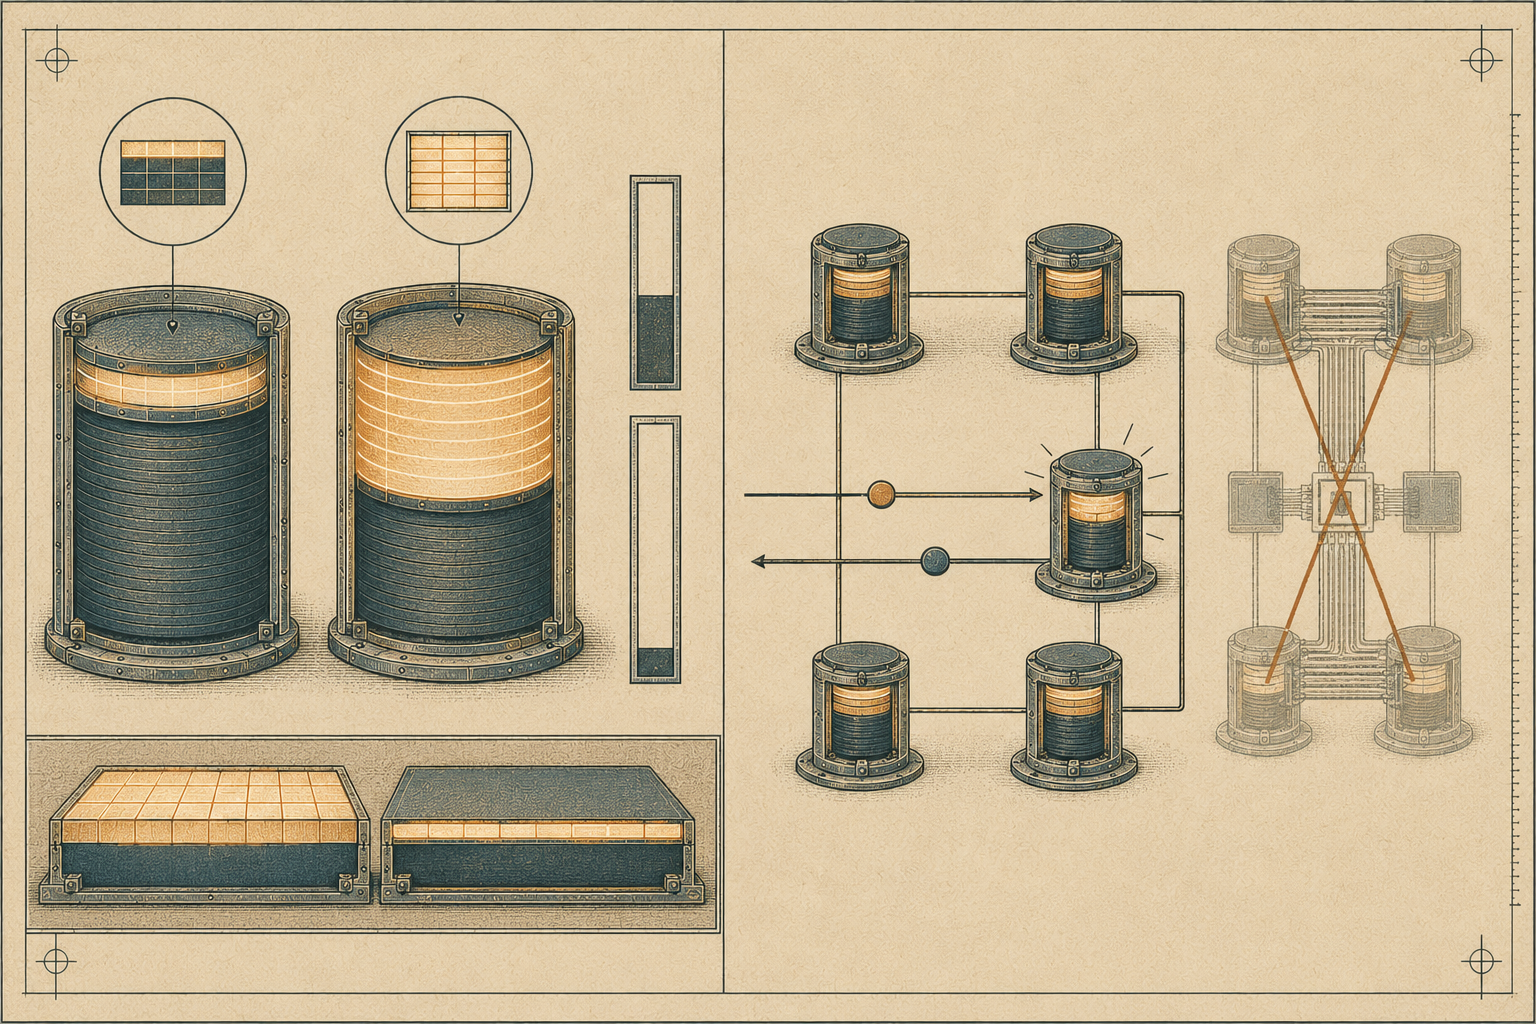
Когда данных больше, чем разумно держать целиком в RAM, а латентность всё равно должна быть низкой и предсказуемой, чистый in-memory перестаёт быть ответом. Aerospike и Apache Ignite обе решают задачу масштаба, но по-разному. Aerospike по умолчанию держит первичный индекс в DRAM, а сами данные — в RAM либо на flash: гибрид на уровне одного узла, где RAM тратится не на весь датасет, а на фиксированную метадату записи. Размещение индекса конфигурируемо — помимо DRAM по умолчанию Aerospike поддерживает первичный индекс в Persistent Memory (PMem) либо на устройстве NVMe flash, но ниже разобрана только конфигурация по умолчанию. Ignite масштабируется вширь — это распределённый data grid, который умеет ещё и compute grid: партиционированный кэш на нескольких узлах и возможность отправить вычисление на узел, где физически лежит нужная партиция (collocated compute), вместо того чтобы тянуть данные к вычислению по сети.
Это четвёртая статья серии «Вычисления в оперативной памяти», продолжение третьей статьи про Tarantool и Picodata. Там перенос вычисления к данным был внутрипроцессным — хранимка на Lua в том же адресном пространстве, что и tuples. Здесь та же идея повторяется на распределённом кластере: Ignite отправляет по сети саму задачу, а не данные. Все числа ниже — из живого стенда aerospike (три сценария: namespaces, hybrid, index-cost, Aerospike CE 8.1.2.3) и ignite (три сценария: cache, affinity, compute, Apache Ignite 2.18.0 — единственный не-Go стенд серии, пример на Java) на том же датасете серии — 200 000 товаров.
В статье
- Aerospike: гибрид RAM/flash
- Когда flash дешевле «всё в RAM»
- Ignite: data grid
- Collocated compute: задача едет к данным
- Почему Java
- Чем платим
- Что дальше
Aerospike: гибрид RAM/flash
По умолчанию (и на этом стенде) первичный индекс Aerospike резидентен в DRAM — но это конфигурируемая настройка, а не архитектурная константа без альтернативы: Aerospike официально поддерживает размещение первичного индекса и в Persistent Memory (PMem), и на устройстве NVMe flash — отдельные режимы хранения индекса, вынос которых меняет саму арифметику расхода памяти на индекс (стенд их не проверял — дальше в статье речь только про DRAM-размещение по умолчанию). Сами данные (бины записи) можно направить в RAM (storage-engine memory) либо на устройство (storage-engine device — реальный файл на диске или NVMe). Стенд поднимает два namespace на одном сервере с одним и тем же датасетом: ram держит и индекс, и данные в памяти, flash — индекс в DRAM (конфигурация по умолчанию), данные на файле flash.dat. Это позволяет сравнить цену одного и того же набора данных в двух конфигурациях напрямую, в байтах, без абстракций.
ramMemUsed := ramStats.IndexUsed + ramStats.DataUsed // и индекс, и данные — в RAM (storage-engine memory)
flashMemUsed := flashStats.IndexUsed                 // в RAM у flash остался ТОЛЬКО индекс
flashDeviceUsed := flashStats.DataUsed               // данные — на устройстве (файл flash.dat)
На 200 000 записей: ram держит в RAM 41 598 000 байт (index_used_bytes=12 800 000 + data_used_bytes=28 798 000), flash — только 12 800 000 байт (тот же индекс; данные того же объёма, 28 798 000 байт, лежат на устройстве). Сопоставимость этих двух чисел не случайна: у flash в RAM резидентен ровно index_used_bytes, у ram — index_used_bytes + data_used_bytes, это прямое следствие того, что именно namespace держит в памяти при каждом варианте storage-engine. Отношение — 30,8% (12 800 000 / 41 598 000): гибрид тратит на этот же набор данных 30,8% от RAM, которую потребовало бы полное in-memory хранение, то есть экономит 69,2%.
Второй сценарий — index-cost — растит flash-namespace ступенями (10 000 → 50 000 → 100 000 → 200 000 записей) и на каждом шаге снимает index_used_bytes:
записей | index_used_bytes(RAM) | байт/запись (накопл.) | байт/запись (Δ)
  10000 |         640000 |    64.00 |    64.00
  50000 |        3200000 |    64.00 |    64.00
 100000 |        6400000 |    64.00 |    64.00
 200000 |       12800000 |    64.00 |    64.00
fmt.Printf("index-cost: ПУБЛИКУЕМОЕ — байт RAM на запись (по полному диапазону 0..%d): %.2f\n",
	last.records, float64(last.indexUsed)/float64(last.records))
64,00 байта на запись, идеально линейно на всех четырёх точках, на 12 прогонах подряд без единого отклонения. Важная оговорка: это не открытие стенда, а живое подтверждение задокументированного факта — Aerospike официально описывает фиксированный оверхед первичного индекса (digest 20 байт + generation + void-time + last-update-time + состояние репликации + указатель), не зависящий от размера самих бинов записи.
Что именно проверил стенд, а что взято из документации — это стоит развести. Четыре точки (10k, 50k, 100k, 200k) варьируют число записей на одном и том же датасете, поэтому измерение подтверждает две вещи: 64,00 байта на запись и линейность по количеству записей в этой DRAM-конфигурации. Независимость от размера и содержимого бинов — утверждение документации, а не результат этого эксперимента: чтобы проверить её живьём, нужно зафиксировать число записей и менять размер бина, чего мы не делали. Линейность здесь обязана быть идеальной по построению; ценность измерения — что она действительно идеальна на реальном датасете, а не только в документации. Практический вывод для планирования ёмкости: при DRAM-размещении индекса (конфигурация по умолчанию и этого стенда) RAM под индекс растёт строго с числом записей и не растёт от того, что в записи лежит — 64 байта на миллион записей планируются так же надёжно, как 64 байта на сто. Это арифметика конкретно DRAM-индекса; вынос индекса в PMem или на flash меняет её, но по-другому — стенд такую конфигурацию не мерил.
Отдельно hybrid-сценарий проверяет, что flash-namespace не деградация, а полноценное хранилище: 1000 случайных ключей (фиксированный seed, воспроизводимая выборка) на каждом из 12 прогонов сверяются с PostgreSQL по всем полям — 0 расхождений из 12 000 сверок.
fmt.Printf("hybrid: сверено %d ключей (seed=%d) из flash-namespace с PostgreSQL, расхождений=%d\n", sampleSize, seed, mismatches)Честная оговорка по интерфейсу: бриф стенда ожидал info-поля memory_used_bytes/device_used_bytes — живой прогон asinfo -v "namespace/<ns>" на 8.1.2.3 показал, что таких полей не существует (сверено полным дампом ~450 полей). Вместо них сервер отдаёт index_used_bytes и data_used_bytes, и именно из них выше пересчитаны публикуемые величины. Кто пишет мониторинг поверх asinfo, не может полагаться на имена полей из документации без проверки на фактической версии сервера.
Когда flash дешевле «всё в RAM»
Числа выше сходятся арифметически. Данные одного набора занимают 28 798 000 байт независимо от того, где они лежат — в RAM или на устройстве (data_used_bytes идентичен у обоих namespace); индекс — 12 800 000 байт (64,00 байта × 200 000 записей) резидентен в RAM при DRAM-размещении индекса (конфигурация по умолчанию у обоих namespace стенда). Отсюда: RAM ram-namespace = 64,00 + 143,99 = 207,99 байта на запись (28 798 000 / 200 000 = 143,99 байта данных на запись в среднем); RAM flash-namespace = фиксированные 64,00 байта на запись. Отношение 64,00 / 207,99 = 30,8% — та же цифра, что дал прямой замер namespace целиком, только выведенная из цены одной записи.
Из этой арифметики следует не только «на сколько дешевле сейчас», но и «когда становится ещё дешевле». Индекс не зависит от размера бинов — это утверждение документации Aerospike, а не вывод из наших замеров: стенд варьировал только число записей (64,00 байта на 10 000, 50 000, 100 000 и 200 000), но не размер и содержимое бинов, и потому такую независимость проверить не мог. А вот RAM полного in-memory хранения растёт линейно с размером данных в записи: чем толще бины (больше атрибутов, длиннее текстовые поля), тем дороже ram-namespace на запись, тогда как flash-namespace держит в RAM ровно те же 64,00 байта — вне зависимости от того, 144 байта в записи или в разы больше. На этом конкретном датасете (144 байта данных на запись) экономия — 69,2%; структурно она растёт вместе с размером записи, потому что числитель дроби (индекс) неподвижен, а знаменатель (индекс + данные) — нет. Обратная сторона медали — плата за flash не бесплатна: латентность обращения к устройству, а не к RAM, для тех операций, которые действительно читают бины, а не только индекс. Эта разница — не абсолютное время (серия его не публикует — см. первую статью серии), а сам факт дополнительного скачка через устройство, который ram-namespace не делает никогда. Что происходит с обеими конфигурациями Aerospike, когда рабочий набор упирается в жёсткую границу памяти, — отдельный вопрос эксплуатации, разобранный количественно в шестой статье серииготовится, с 26 сентября.
Ignite: data grid
Ignite распределяет данные партициями по серверным узлам через кэш в режиме PARTITIONED с настраиваемым числом бэкапов (в стенде — BACKUPS=1, одна резервная копия каждой партиции на другом узле). Топология стенда — 2 сервера. Заливка через тонкий клиент (Ignition.startClient) и сверка с источником: cache.size() совпал с числом залитых товаров (200 000 = 200 000), 50 случайных ключей (фиксированный seed) сверены с PostgreSQL — 0 расхождений.
Коллокация — ключевая идея грид-подхода: ключ кэша здесь не просто id, а AffinityKey<Long>(id, category), и GridCacheDefaultAffinityKeyMapper Ignite считает партицию по affinityKey() (категория), а не по key() (id) — это задокументированная механика Affinity Collocation, не открытие стенда. Эффект: все товары одной категории физически лежат на одном узле, одной партиции.
Map<String, ClusterNode> catNode = new LinkedHashMap<>();
for (String cat : categories) {
    catNode.put(cat, aff.mapKeyToNode(new AffinityKey<>(0L, cat)));
}
Живое распределение шести категорий по двум узлам:
category=auto     -> node <A>   products=33239
category=books    -> node <A>   products=33550
category=garden   -> node <B>   products=33495
category=kitchen  -> node <A>   products=32944
category=sport    -> node <A>   products=33496
category=tools    -> node <B>   products=33276
node <A> -> 133229 ключей
node <B> -> 66771 ключей
flowchart TB
    subgraph A["Узел A — 133 229 ключей"]
        C1["auto (33 239)"]
        C2["books (33 550)"]
        C3["kitchen (32 944)"]
        C4["sport (33 496)"]
    end
    subgraph B["Узел B — 66 771 ключ"]
        C5["garden (33 495)"]
        C6["tools (33 276)"]
    end
133 229 против 66 771 — заметный перекос, но это не свойство Ignite и не дисбаланс данных. Сами категории почти равны по объёму (32 944–33 550 записей, разброс не больше 2%): при идеально равных четырёх категориях на одном узле и двух на другом получилось бы то же самое ~133k/66k. Причина — низкая кардинальность ключа коллокации: RendezvousAffinityFunction раскладывает всего шесть значений категории по двум узлам, и это жребий на шесть бросков, зависящий от хеша строк-категорий, а не от объёма данных за ними. Числа стабильны — идентичны на 10 прогонах подряд и на полностью пересозданном с нуля кластере, — но стабильность здесь означает «детерминированная функция хеша», а не «сбалансированный шардинг»: коллокация по ключу низкой кардинальности предсказуемо даёт видимый перекос узлов при почти равных данных, и это стоит держать в голове при выборе ключа коллокации для собственной схемы.
Collocated compute: задача едет к данным
Раз все товары категории tools физически лежат на одном узле, топ-10 по просмотрам внутри категории можно посчитать двумя способами: вычитать всю категорию клиенту (ScanQuery с предикатом) и отсортировать на стороне приложения, либо отправить задачу на тот самый узел и получить обратно только результат.
static final class CategoryFilter implements IgniteBiPredicate<AffinityKey<Long>, Product> {
    private final String category;

    CategoryFilter(String category) {
        this.category = category;
    }

    @Override
    public boolean apply(AffinityKey<Long> key, Product val) {
        return val.category.equals(category);
    }
}
@Override
public List<TopEntry> call() {
// Ignition.localIgnite() — доступ к Ignite-инстансу УЗЛА, на
// котором сейчас исполняется job (это и есть "compute к данным":
// задача приехала на сервер по сети, а не данные — к задаче).
Ignite local = Ignition.localIgnite();
IgniteCache<AffinityKey<Long>, Product> cache = local.cache(cacheName);
List<TopEntry> all = new ArrayList<>();
for (Cache.Entry<AffinityKey<Long>, Product> e : cache.localEntries(CachePeekMode.PRIMARY)) {
Product p = e.getValue();
if (p.category.equals(category)) {
all.add(new TopEntry(p.id, p.title, p.views));
}
}
all.sort(TOP_ORDER);
return all.size() > limit ? new ArrayList<>(all.subList(0, limit)) : all;
}ignite.compute().affinityCall(CACHE_NAME, PROBE_CATEGORY, new TopByCategoryTask(...)) отправляет саму задачу на узел категории tools; CachePeekMode.PRIMARY берёт только первичные копии партиций этого узла, не бэкапы, — иначе записи задвоились бы. Результат печатается ровно так:
System.out.println("compute: объектов уехало по сети — наивно=" + naiveOverNetwork
        + ", compute=" + computeOverNetwork
        + " (в " + String.format("%.1f", naiveOverNetwork / (double) computeOverNetwork) + "x меньше)");
На живом кластере: наивный путь гонит по сети всю категорию — 33 276 объектов (совпадает с числом товаров категории tools в PostgreSQL); compute-путь — 10 (запрошенный limit). Отношение — 3327,6× меньше объектов по сети. Топы обоих путей сверены побитово и совпали на каждом из прогонов. Это число объектов, не байты — шестая статьяготовится, с 26 сентября меряет и реальный трафик отдельно (метрики TcpCommunicationSpi classic client-node), и отношение байт там не совпадает с отношением объектов.
Здесь стоит сразу назвать границу этого числа. В категории tools есть настоящая ничья — id=84 и id=85, у обоих views=93 — и при limit=10 оба члена попадают в топ независимо от правила тай-брейка: следующий по рангу id=105 имеет views=74, разрыв большой. Совпадение топов между наивным и compute-путём здесь гарантировано тем, что оба пути используют один и тот же компаратор внутри одного и того же стенда — эта проба не проверяет устойчивость самого правила тай-брейка на границе (в отличие от Tarantool из третьей статьи серии, где на limit=9 тай-брейк реально решал состав топа). Не стоит подавать эту находку как «Ignite подтвердил устойчивость тай-брейка» — стенд проверяет совпадение результата, а не тай-брейк как таковой.
И вторая, более важная граница: 3327,6× — это отношение числа объектов, не времени и не байт. Отправить задачу вместо данных однозначно сокращает трафик, но у affinityCall есть собственная цена — сериализация задачи, диспетчеризация на нужный узел, вызов внутри JVM, — которой нет у прямого чтения. Шестая статья серииготовится, с 26 сентября прогоняет ту же самую пару путей на время и даёт честный контраст: у Ignite отношение по времени — 0,90–1,92×, и в части замеров compute-путь оказывается медленнее наивного — выигрыша по времени на этом стенде нет вовсе. Три тысячи крат меньше объектов по сети (и ещё больше — по измеренным байтам, там же) — реальный и полезный эффект, но не синоним «в три тысячи раз быстрее»; выдавать одно за другое было бы неточностью.
Почему Java
Ignite нативен для JVM — сервер и есть JVM-процесс, поэтому showcase собран на Java (ignite-core), а не на Go, как остальные стенды серии. Из этого следует не только выбор языка, но и выбор типа клиента: живой прогон показал, что тонкий клиент (org.apache.ignite.client.IgniteClient, Ignition.startClient) в 2.18.0 не имеет ни Affinity API (ignite.affinity(...) на нём просто не существует), ни IgniteCompute.affinityCall — у ClientCompute есть только обычный, не affinity-aware execute. Это сверено javap по фактическому ignite-core-2.18.0.jar, а не по документации. Обе операции — часть «толстого» API (org.apache.ignite.Ignite), доступного узлу в классическом клиент-режиме (IgniteConfiguration.setClientMode(true) — узел присоединяется к discovery-кольцу, но не хранит данные). Поэтому сценарий cache в стенде — на тонком клиенте, как и планировалось, а affinity/compute — на классической клиент-ноде.
Ветка выбрана намеренно: Ignite 3.x переписан практически полностью, API несовместим с 2.x, а тег latest на момент подготовки стенда указывал на устаревшую сборку — поэтому пин стенда явный, apacheignite/ignite:2.18.0.
Самая дорогостоящая находка фазы касается именно JDK. Тег образа сообщает только про версию Ignite; про JDK внутри — ничего. docker run --rm apacheignite/ignite:2.18.0 java -version на живом образе отдаёт Temurin-11.0.31+11 — образ несёт JDK 11, хотя весь остальной тулчейн серии пинует JDK 21. Классы, собранные под JDK 21 (class file version 65), убивают оба серверных контейнера немедленно при первом вызове compute — UnsupportedClassVersionError внутри FailureProcessor вызывает Runtime.halt(), и оба узла падают одновременно, не по одному. Фикс — явный maven.compiler.release=11 при сборке классов задачи (TopByCategoryTask, CategoryFilter), которые деплоятся на classpath серверных нод заранее (а не через peer class loading — тот же живой прогон показал, что P2P-деплой пропускает affinityCall, но не десериализует ScanQuery-предикат на сервере). Сопутствующая деталь, которая тоже стоила времени: mvn package без clean молча оставляет старый байткод в целевой директории — после смены compiler.release обязателен mvn clean package, иначе фикс не применяется, а ошибка выглядит так, будто ничего не изменилось.
Чем платим
- Aerospike: планирование ёмкости под индекс, а не под данные. 64,00 байта на запись — константа, но она умножается на число записей независимо от того, сколько данных долетело до самой записи; для датасетов с большим числом мелких записей индекс в RAM может стать заметной статьёй расхода сам по себе. Часть данных стенда на flash-namespace физически лежит на устройстве — это дополнительный компонент инфраструктуры (SSD/NVMe вместо только RAM) и дополнительный скачок при чтении бина, а не только индекса.
- Aerospike: имена info-полей нестабильны между версиями. Мониторинг, написанный по документации, а не сверенный с фактическим
asinfoна конкретной версии сервера, рискует опрашивать несуществующие поля —memory_used_bytes/device_used_bytesиз брифа этого же стенда не существовали в 8.1.2.3 вовсе. - Ignite: вес JVM и GC. Каждый узел кластера — полноценный JVM-процесс с собственной сборкой мусора; тема GC на JVM в production разобрана отдельно, вне этой серии, в статье про профилирование JVM java-серии.
- Ignite: несовместимость сборки между сервером и клиентом — не абстрактный риск, а живой отказ. Расхождение JDK внутри серверного образа и JDK, под которым собран код задачи, уронило оба сервера синхронно при первом реальном вызове — не деградацию, а полную остановку кластера. Версия Ignite в теге образа ничего не говорит про версию JDK внутри — это нужно проверять отдельно, тем же способом, каким это сделано здесь.
- Ignite: коллокация по ключу низкой кардинальности предсказуемо перекашивает узлы. Не баг и не повод отказываться от affinity — но при проектировании ключа коллокации стоит заранее прикинуть, сколько различных значений он принимает относительно числа узлов кластера, иначе перекос вроде 133k/66k окажется сюрпризом в проде, а не осознанным трейдофом.
- Обе системы — про горизонтальный масштаб, а не про «поставить один инстанс». Гибридная память Aerospike экономит RAM на одном узле; data grid и compute grid Ignite экономят сеть между несколькими узлами. У обеих цена — не в throughput отдельной операции, а в операционной сложности: устройство и его мониторинг у Aerospike, JVM-флот и совместимость версий у Ignite.
Общая карта, где Aerospike и Ignite стоят рядом с остальными подходами к хранению данных, — в хабе «Данные: карта хранилищ и подходов».
Что дальше
Следующая статья серии — контраст, а не продолжение масштаба: Статья 5 — etcd: координация ≠ ускорениеготовится, с 25 сентября разбирает систему, которая в этой серии стоит особняком по другой причине — её данные физически лежат на диске, в памяти резидентен только индекс, а согласованность кластера обеспечивает Raft, а не резидентность самих данных.
Честный разрыв между отношением числа объектов (3327,6×, эта статья), измеренными байтами трафика и экономией по времени (0,90–1,92×, местами compute-путь медленнее наивного) — с методикой измерения на обеих системах, включая Tarantool из третьей статьи, — в шестой, заключительной статье серииготовится, с 26 сентября, вместе с тем, что происходит с гибридной памятью Aerospike на границе доступной RAM.
Комментарии