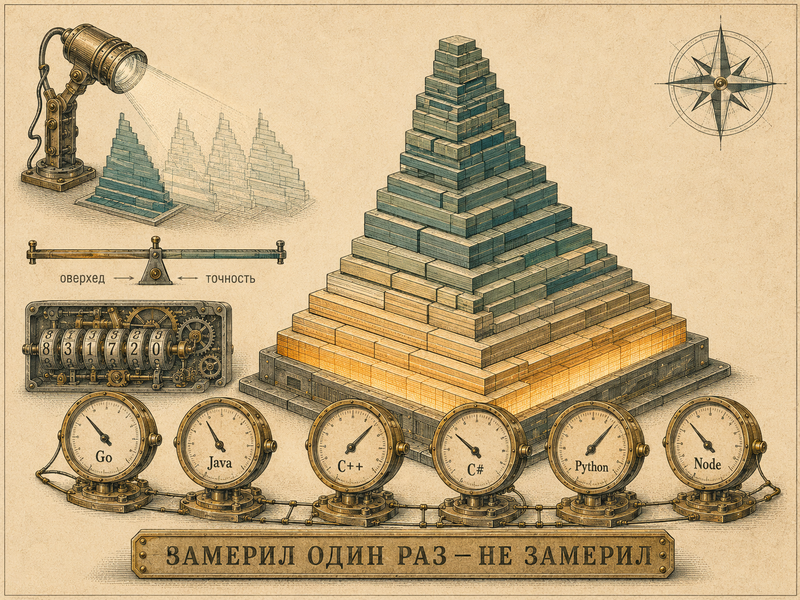
28.09.2026 Профилирование в разных языках: как измерять без самообмана Один и тот же вопрос — где на самом деле уходит время и память — в Go, Java, C++, C#, Python и Node: sampling против instrumentation, CPU/alloc/heap-профили, флеймграфы, микробенчмарки без самообмана и как из профиля сделать вывод #profiling #go #java +2 #cpp #python
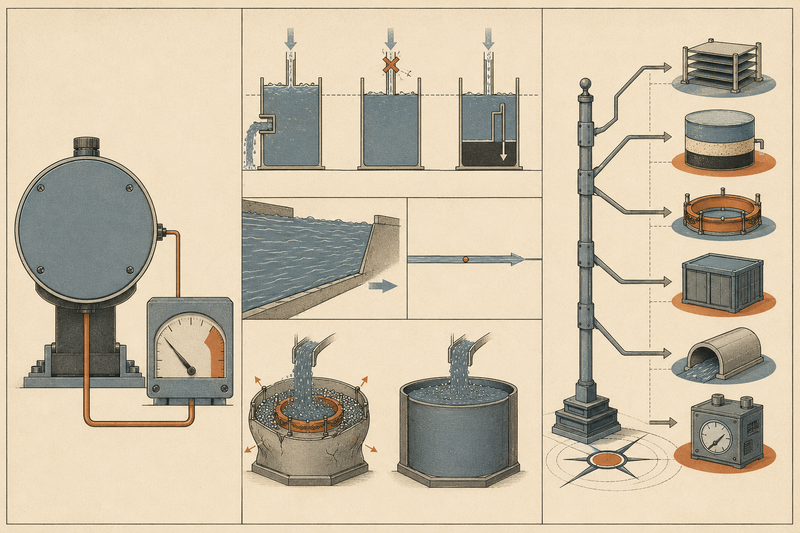
26.09.2026 Нагрузочный стенд и карта выбора in-memory систем Финал серии: три сценария, которые переживают оверхед платформы, — рабочий набор за границей RAM (Redis против двух конфигураций Aerospike), цена выноса вычислений к данным (Tarantool против Ignite) и etcd под несвойственной нагрузкой. Почему абсолютной latency здесь нет и почему это делает выводы прочнее — и итоговая карта выбора «задача → система → способ ускорения» #caching #benchmarking #redis +2 #tarantool #in-memory-store
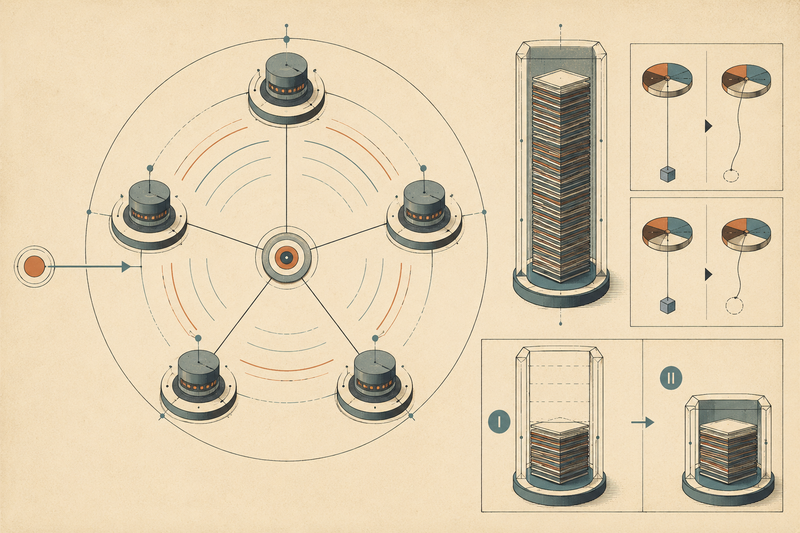
25.09.2026 etcd: координация ≠ ускорение Не всё в памяти — про скорость: физические данные etcd лежат на диске (persistent B+tree), в памяти — только вторичный индекс путей к ним; согласованность обеспечивает Raft, а не резидентность данных. Raft, линеаризуемые чтения, MVCC-ревизии, watch и leases — и честный разбор того, почему etcd в этой серии не шестая in-memory система, а граница таксономии, и что ломается при использовании не по назначению #caching #etcd #consensus +1 #go
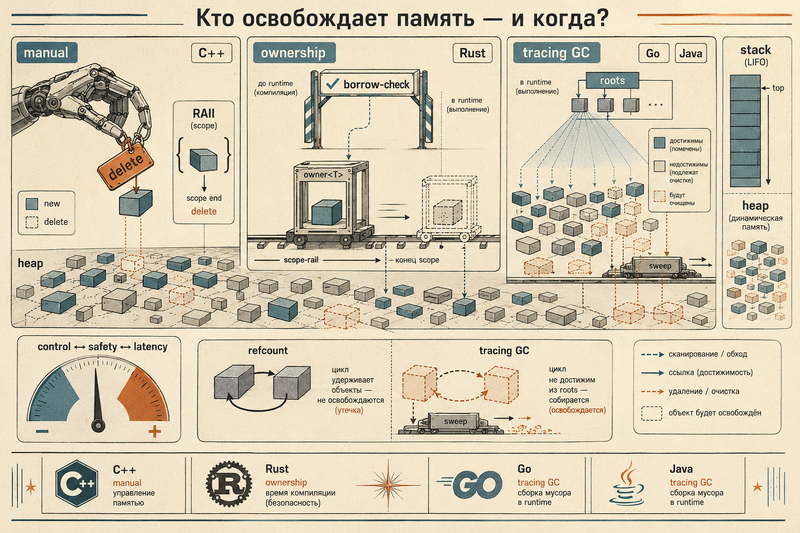
24.09.2026 Куча, стек и сборщик мусора: как языки управляют памятью Как C++, Rust, Go и Java решают один и тот же вопрос — кто и когда освобождает память: вручную, детерминированно по владению (корректность проверяет компилятор) или в рантайме через сборщик мусора. Стек против кучи, стоимость аллокации, паузы сборщика, утечки и фрагментация — и на что смотреть под свою нагрузку #performance-tuning #gc #go +4 #rust #cpp #java #jvm
24.09.2026 Aerospike и Apache Ignite: масштаб и грид Две системы для масштаба: Aerospike с гибридной архитектурой памяти (индекс в DRAM по умолчанию, данные в RAM или на flash) — и живая цена индекса в байтах; и Apache Ignite как in-memory data grid + compute grid, где вычисление едет к данным через affinity colocation, а экономия сети измеряется в объектах #caching #in-memory-store #go +1 #java
23.09.2026 Tarantool и Picodata: данные и вычисления рядом Tarantool как in-memory DB со встроенным Lua application server: stored procedures выполняются рядом с данными — перенос вычислений к данным, а не наоборот. Движки memtx и vinyl, persistence через WAL и snapshot. И Picodata — самостоятельная СУБД на форке того же ядра, где вычисления рядом с данными живут иначе: PostgreSQL-протокол снаружи, плагины на Rust внутри, метрики Prometheus и веб-интерфейс из коробки #caching #tarantool #picodata +2 #go #redis
22.09.2026 Redis: кэш и структуры данных в памяти как ускоритель Redis под углом ускорения: паттерны кэширования (cache-aside, write-through, TTL, инвалидация, защита от cache stampede) и структуры данных под задачи (sorted set для leaderboard и rate-limit, HyperLogLog) — и честные трейдофы кэша. Внутреннее устройство Redis сюда намеренно не входит: оно разобрано в отдельной серии deep-dive #caching #redis #go
21.09.2026 Вычисления в оперативной памяти: зачем, какой ценой и таксономия систем С чего начинается in-memory computing: почему память ускоряет (иерархия памяти, latency RAM vs SSD vs сеть), главные трейдофы (durability, стоимость RAM, консистентность, объём) и карта шести систем по ролям — от кэша до координации #caching #redis #tarantool +2 #in-memory-store #etcd
17.09.2026 Сжатие данных: zstd, lz4, gzip и компромисс CPU ↔ размер Матрица zstd/lz4/gzip/brotli по уровням на одном корпусе и три режима выбора, проверенных живым стендом: порог окупаемости на транспорте, точка амортизации по числу перечитываний и поведение разжатия на read-heavy пути. С картой решения и разбором того, что не воспроизвелось #compression
08.08.2026 22 минуты вместо двух: как контейнер на каждый тест съедал прогон — и что помогло Интеграционные тесты Go-сервиса шли 22 минуты и случайно падали по таймауту — списывали на медленную машину. Причина оказалась арифметической: 266 вызовов тестового хелпера поднимали 266 контейнеров Postgres. Разбираем переход на один контейнер и CREATE DATABASE … TEMPLATE, замеры до и после (×10 и ×36), воспроизводимый стенд, границы приёма — права, FORCE, размер шаблона, параллельность пакетов — и честную границу между тем, что измерено, и тем, что осталось правдоподобной гипотезой #performance-tuning #go #testing +2 #postgresql #docker