
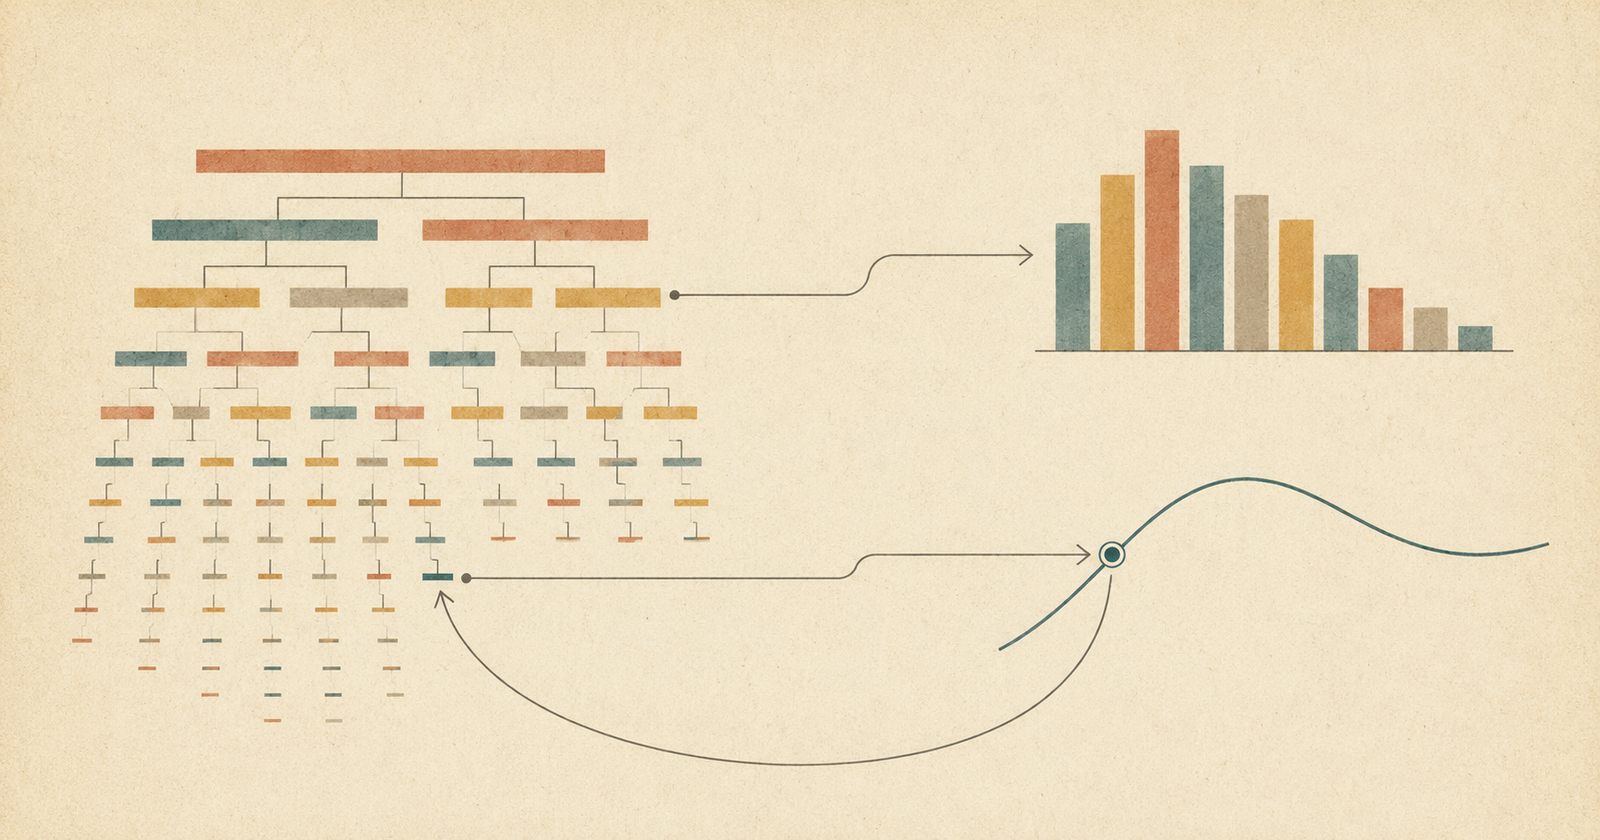
Трейс обычно смотрят как waterfall: нашёл длинную полоску — нашёл виноватого. Это работает, но использует малую часть того, что есть. Спан — структурированная запись с именем, атрибутами, событиями и статусом; трейс — дерево таких записей. А значит из трейсов можно считать метрики, из точки на графике — прыгать в конкретный запрос, и строить SLO не на отдельном инструментировании, а на том, что уже собрано.
Это седьмая статья серии «Наблюдаемость на практике». Вторая статья была про то, как трейс собрать и не порвать. Эта — про то, что с ним делать дальше.
Главное, что я вынес, собирая этот модуль: два проверенных пути к постоянным Prometheus-метрикам из спанов дают несовместимые между собой метрики. Числа сходятся до единицы, а имена, единицы измерения и даже имя лейбла с сервисом — разные, и это свойство самих реализаций, а не моей конфигурации. Дашборд, написанный на одном пути, на другом не работает. И отдельно: при включённом сэмплировании span-метрики занижают объём в разы — измеренно в 9,43 раза при доле 10 %, — причём это не поломка, а свойство, которое надо знать заранее.
В статье
- Спан — это запись, а не полоска
- Семантические конвенции и почему их соблюдают неравномерно
- Дизайн спанов: что спаном, что атрибутом, что событием
- Span-метрики двумя путями
- Два генератора несовместимы по форме
- Сходятся ли span-метрики с RED
- Сэмплинг занижает span-метрики в 9,43 раза
- Exemplars: три звена, каждое рвётся молча
- Trace-based SLO и когда он врёт
- Анти-паттерны: 33 лейбла из ничего
- Итог
- Документация и первоисточники
Спан — это запись, а не полоска
У спана есть имя операции, набор атрибутов (ключ-значение), события с временными метками, статус и ссылки на другие спаны. Всё это — данные, по которым можно фильтровать, группировать и агрегировать.
Вот один запрос со стенда, разложенный по спанам:
go-frontend    POST /order                    SPAN_KIND_SERVER      160.1 мс
go-frontend    create_order                   SPAN_KIND_INTERNAL    160.0 мс
go-frontend    HTTP GET                       SPAN_KIND_CLIENT      159.6 мс
java-backend   GET /inventory/{sku}           SPAN_KIND_SERVER      158.2 мс
java-backend   SELECT orders.inventory        SPAN_KIND_CLIENT      153.9 мс
java-backend   orders.created process         SPAN_KIND_CONSUMER      3.3 мс
java-backend   INSERT orders.orders           SPAN_KIND_CLIENT        2.1 мс
java-backend   orders                         SPAN_KIND_CLIENT        1.3 мс
java-backend   orders                         SPAN_KIND_CLIENT        0.3 мс
go-frontend    orders.created publish         SPAN_KIND_PRODUCER      0.0 мс
Обратите внимание на SPAN_KIND: он не украшение, а признак роли. SERVER — сервис принял запрос, CLIENT — сам куда-то пошёл, INTERNAL — внутренняя операция, PRODUCER/CONSUMER — асинхронная граница. Именно по этому признаку дальше отбираются спаны для метрик: считать RED надо по SERVER, иначе в одну кучу попадут и входящие запросы, и исходящие вызовы, и они посчитаются дважды.
Семантические конвенции и почему их соблюдают неравномерно
OTel описывает стандартные имена атрибутов: http.request.method, http.route, http.response.status_code, db.system, messaging.destination.name и так далее. Смысл соглашения простой: дашборд, алерт или запрос, написанный на стандартных именах, переносится между сервисами и языками без переписывания.
Соблюдается это соглашение неравномерно, и вот тому измеренное подтверждение. В коннектор span-метрик я задал размерность http.route. Что доехало:
span_name=POST /order            http_route=ОТСУТСТВУЕТ       status=201
span_name=POST /order            http_route=ОТСУТСТВУЕТ       status=404
span_name=POST /order            http_route=ОТСУТСТВУЕТ       status=502
span_name=GET /inventory/{sku}   http_route=/inventory/{sku}  status=200
Java-агент проставляет http.route, Go-сервис — нет. Обе стороны понимают соглашение одинаково, но заполняет атрибут только одна. Практическое следствие: панель «латентность по маршрутам» для Go-сервиса окажется пустой при полностью исправной телеметрии, и причина будет не в конвейере, а в том, что атрибута никто не проставил.
Отсюда правило, которое стоит проверять руками, а не предполагать: прежде чем строить дашборд на атрибуте, посмотрите, есть ли этот атрибут у всех сервисов, которые попадут в панель. Автоинструментирование щедро на стандартные атрибуты там, где знает фреймворк, и молчит там, где не знает.
Дизайн спанов: что спаном, что атрибутом, что событием
Три вопроса, которые решаются при разметке.
Что делать спаном. Спан на операцию, а не на строчку кода. В примере выше create_order — один внутренний спан на бизнес-операцию, внутри которой уже видны вызов бэкенда и публикация в брокер. Спан на каждую функцию дал бы дерево из сотен узлов, в котором ничего не найти, и стоил бы кратно дороже.
Проверяемый признак «спан лишний»: если он всегда занимает почти всё время родителя и никогда не ветвится, он ничего не сообщает. В таблице выше create_order (160,0 мс внутри 160,1 мс) на границе этого критерия — он оправдан только тем, что несёт бизнес-атрибуты.
Что делать атрибутом. Всё, что описывает конкретный экземпляр операции: идентификатор заказа, SKU, размер payload. Высокая кардинальность здесь не создаёт серий — спаны не индексируются по всем полям, как метрики, и уникальное значение не множит ничего.
Это не значит «клади что угодно». Границы у свободы три, и все практические: атрибуты увеличивают размер спана, а значит объём хранилища трейсов и цену ретеншена; поиск по неиндексированному атрибуту — это скан, и на большом окне он дорог; а персональные данные в атрибуте живут ровно столько, сколько живёт трейс, и попадают всем, у кого есть доступ к трейсингу. Верная формулировка: кардинальность атрибута спана дешевле кардинальности лейбла метрики на порядки, но не бесплатна.
attrs := []attribute.KeyValue{
    attribute.String("order.sku", req.SKU),
    attribute.Int("order.quantity", req.Quantity),
}
ctx, span := s.tracer.Start(ctx, "create_order", trace.WithAttributes(attrs...))
defer span.End()

// ...

span.SetAttributes(
    attribute.String("order.id", order.OrderID),   // в спан — можно
    attribute.Bool("order.reserved", order.Reserved),
)
order.id уникален на каждый запрос. В атрибуте спана это нормально и полезно: по нему потом найдётся конкретный заказ. В лейбле метрики то же самое значение обошлось бы взрывом кардинальности — про это статья 8, там есть замер.
Что делать событием. Событие — точка во времени внутри спана, с сообщением и атрибутами: получена ошибка, сработал retry, освободился коннект. Здесь важна деталь, которую легко пропустить:
span.SetStatus(codes.Error, err.Error())  // делает трейс НАХОДИМЫМ по признаку ошибки
span.RecordError(err)                     // добавляет событие с подробностями
Первое влияет на выборку — по статусу отбирает tail sampling и по нему же считаются ошибки в span-метриках. Второе даёт подробности для чтения человеком. Поставить только второе — значит получить трейс с описанием ошибки, который не находится фильтром «покажи ошибочные».
Span-метрики двумя путями
Из спанов можно посчитать те же RED-метрики, что в статье 4 считались по HTTP-инструментированию. Инструментировать второй раз не нужно — данные уже есть.
Дальше речь о двух путях генерации постоянных Prometheus-метрик — именно их я поднимал и сравнивал на стенде. Оба штатные.
Оговорка про третий путь, который в это сравнение не входит: у Tempo есть TraceQL metrics — полноценные метрические запросы по трейсам, с rate, count_over_time, квантилями и exemplars. Это не урезанный вариант: те же величины, что даёт коннектор, там можно получить запросом.
Разница в том, где живёт результат. Коннектор и генератор материализуют постоянные Prometheus-серии: они существуют независимо от того, смотрит ли на них кто-нибудь, и стоят места в TSDB. TraceQL metrics не создаёт серий вовсе — цена переносится в хранение самих трейсов и в выполнение запроса каждый раз, когда его открывают. Отсюда и практические следствия: алерт поверх такого запроса устроен иначе, чем алерт Prometheus, а долгие исторические окна упираются в ретеншен трейсов, а не метрик.
В сравнение ниже он не входит по простой причине: стенд мерил форму и согласованность того, что уходит в Prometheus и остаётся там жить. Сравнивать по имени метрики и единицам измерения то, что серий не материализует, попросту не с чем.
Путь первый: коннектор в Collector. Коннектор — компонент, который для одного пайплайна выглядит экспортёром, а для другого приёмником: спаны входят, метрики выходят.
connectors:
  spanmetrics:
    dimensions:
      - name: http.route
      - name: http.response.status_code
    histogram:
      explicit:
        buckets: [5ms, 10ms, 25ms, 50ms, 100ms, 250ms, 500ms, 1s, 2s]
    exemplars:
      enabled: true

service:
  pipelines:
    traces:
      receivers: [otlp]
      exporters: [otlp/tempo, spanmetrics]   # и в Tempo, и в коннектор
    metrics/spanmetrics:
      receivers: [spanmetrics]
      exporters: [prometheus]
Границы гистограммы заданы явно, и это не педантизм: по умолчанию коннектор берёт свой набор, который не обязан совпадать с бакетами метрик статьи 4, — а сравнивать перцентили из двух источников с разной сеткой бакетов бессмысленно. Почему сетка и есть точность квантиля, разобрано там же.
Путь второй: генератор в самом Tempo. Бэкенд трейсов считает метрики сам и отправляет их в Prometheus по remote-write.
metrics_generator:
  registry:
    external_labels:
      source: tempo          # иначе серии двух генераторов не различить
  storage:
    path: /var/tempo/generator/wal
    remote_write:
      - url: http://prometheus:9090/api/v1/write
        send_exemplars: true

overrides:
  defaults:
    metrics_generator:
      processors: [span-metrics, service-graphs]
Секция overrides обязательна, и вот почему это стоит запомнить: процессоры генератора по умолчанию выключены для всех tenant. Без неё Tempo принимает конфигурацию генератора, стартует без единой ошибки и не делает ничего. Молча. Я потратил на это отдельный подход, прежде чем полез в overrides.
Со стороны Prometheus нужен приёмник: --web.enable-remote-write-receiver.
Два генератора несовместимы по форме
Оба пути я поднял одновременно, на одном потоке спанов — иначе сравнение мерило бы разницу нагрузки, а не разницу генераторов. Числа сошлись (об этом ниже), а вот форма результата разошлась во всём, на что опирается дашборд:
Разделю то, что различается само по себе, и то, что различается из-за моей конфигурации, — иначе легко принять настройку за свойство инструмента.
Несовместимо по умолчанию — и только частично сближается настройкой:
| Что | Collector (по умолчанию) | Tempo | Можно ли сблизить |
|---|---|---|---|
| префикс имени | traces_span_metrics_* |
traces_spanmetrics_* |
да: у коннектора namespace: traces.spanmetrics |
| единица латентности | миллисекунды | секунды | да: у коннектора histogram.unit: s |
| имя латентности | ..._duration_* |
..._latency_* |
нет: у обоих имя фиксировано |
| лейбл сервиса | service_name |
service |
у Tempo service — фиксированный интринсик; лейбл из атрибута service.name можно добавить через dimensions, но на стенде я это не проверял |
Различие в префиксе — на один символ подчёркивания, и это самая коварная часть: span_metrics против spanmetrics глазами не отличишь, а PromQL молча вернёт пустоту. Сближать настройкой можно только со стороны Collector: у генератора Tempo имена и единица фиксированы. Но и после этого имя метрики латентности различается, так что запросы к ней придётся переписывать в любом случае.
А вот это — следствие того, как настроен мой стенд, и у вас будет иначе:
| Что | Collector (у меня) | Tempo (у меня) | Отчего зависит |
|---|---|---|---|
| границы бакетов | 5, 10, 25 … 2000 | 0.002, 0.004 … 16.384 | я задал явно; у Tempo дефолт |
| всего лейблов | 33 | 7 | resource_to_telemetry_conversion: true у экспортёра Collector тащит в лейблы все ресурсные атрибуты |
| HTTP-статус | http_response_status_code есть |
отсутствует | я перечислил его в dimensions коннектора; у генератора Tempo dimensions тоже есть, но я его туда не добавил |
Практический вывод от разделения не меняется, но становится точнее: переезд с одного пути на другой требует переписывания запросов в любом случае — как минимум из-за имени метрики латентности, а без перенастройки Collector ещё и из-за префикса и единиц. Разница в лейблах и бакетах — вопрос настройки, и её как раз можно свести к общему знаменателю, если задаться целью.
Практический вывод: переключение пути генерации — это переписывание того, что поверх. В конфигурации по умолчанию не совпадает ни имя метрики, ни единица измерения, ни имя лейбла с сервисом. Панель, которая показывала латентность в миллисекундах, на втором пути покажет числа в тысячу раз меньше — и не сломается, просто соврёт. Единицы и префикс можно выровнять заранее, задав их в коннекторе, — это дешевле, чем переписывать панели при переезде.
Отдельно про HTTP-статус: в текущей конфигурации стенда у пути Tempo его в лейблах нет, и разложить ошибки на «сколько было 404, а сколько 502» через этот путь не выйдет — только на ERROR/UNSET по статусу спана. Это не ограничение Tempo: атрибут http.response.status_code можно перечислить в dimensions генератора, как я сделал у коннектора.
Сходятся ли span-метрики с RED
Теперь главный вопрос: означают ли span-метрики то же, что метрики из HTTP-инструментирования. Проверка сравнивает три источника — факт нагрузки, span-метрики и RED-правила статьи 4.
Прогон 200 запросов. Нагрузка намеренно неидеальна: в ней 8 ответов 404 и 6 ответов 502.
ГОДЕН   Collector: учтено запросов        200 (ожидалось 200)
ГОДЕН   Tempo: учтено запросов            200 (ожидалось 200)
ГОДЕН   два генератора согласны по объёму 200
ГОДЕН   Collector: ошибок = число 502       6 (ожидалось 6)
ГОДЕН   Tempo: ошибок = число 502           6 (ожидалось 6)
ГОДЕН   доля ошибок: span против факта   0.03 (эталон 0.03, допуск 0.005)
ГОДЕН   доля ошибок: RED против факта    0.03 (эталон 0.03, допуск 0.03)
Сходятся до единицы. И попутно подтвердилось приятное: 404 не считается ошибкой ни span-метриками, ни RED-правилом. Ошибка ставится только на 502 — отказ сервера. Это то же правило, по которому бюджет ошибок SLO не тратится на 404: ненайденный товар — не отказ сервиса.
Согласие двух генераторов между собой — отдельный критерий, и он не формальность. Если бы один из путей считал внутренние спаны или терял ошибки, размеченные только статусом, числа разошлись бы, а дашборды серии начали бы показывать разное при одинаково исправном виде.
Сэмплинг занижает span-метрики в 9,43 раза
А вот и главная ловушка темы. Span-метрики считаются по спанам, дошедшим до генератора. Включаем head-сэмплинг 10 % и повторяем тот же прогон:
ручной прогон:     учтено 102 из 1000 = 10.2 %, множитель 9.80x
прогон проверкой:  учтено 106 из 1000 = 10.6 %, множитель 9.43x
Два независимых замера согласуются друг с другом и с долей сэмплирования. Это не поломка конвейера, а свойство: метрика описывает не трафик, а сэмплированный трафик.
Восстановить настоящее число умножением на 1/доля нельзя. Доля известна только для равномерного сэмплирования и только в среднем — а при tail sampling, где решение принимается по содержимому трейса, никакого единого множителя не существует вовсе: ошибочные трейсы сохраняются чаще нормальных, и доля ошибок в span-метриках оказывается завышенной.
Отсюда практическое следствие, ради которого стоило мерить: RED из HTTP-инструментирования и RED из спанов при сэмплировании расходятся в разы, и оба числа при этом верны. Они отвечают на разные вопросы. Ставить их на один дашборд рядом, не подписав разницу, — готовить будущее расследование на пустом месте.
Почему 1000 запросов, а не 200: в статье 2 тот же сэмплер на прогонах по 200 запросов давал 13,5 % и 14,0 % против заявленных 10 %, и только на 1000 — 11,8 %. На сотнях запросов разброс того же порядка, что измеряемая величина.
Проверка, которая приняла сломанный опыт за открытие
Первый автоматический прогон этого опыта выдал: «учтено 1000 из 1000 (100 %), множитель 1.0x». Выглядело как результат — мол, сэмплирование на span-метрики не влияет, вот и славно.
На самом деле сэмплер не применился вовсе: контейнер поднялся с пустыми переменными. Опыт не состоялся, а число выглядело ровно как ответ на вопрос.
Лечение — двойной контроль, и обе части обязательны: после подъёма проверяется, что внутри контейнера действительно стоит traceidratio, и отдельно — что доля учтённого заметно ниже 100 %. Не выполнено — проверка падает со словами «опыт не состоялся», а не печатает число.
Это общее правило для любого опыта «включим настройку и посмотрим»: отсутствие эффекта и отсутствие настройки выглядят одинаково, и различить их можно только явной проверкой, что настройка применилась.
Exemplars: три звена, каждое рвётся молча
Exemplar — ссылка на конкретный трейс, прикреплённая к наблюдению в гистограмме. На графике это ромбик: кликнул по выбросу латентности — открыл трейс запроса, который этот выброс создал. Метрика говорит «что», трейс — «где именно».
Цепочка собирается из трёх условий, и каждое ломает её молча: метрики при этом остаются исправными, панель просто не показывает ромбиков.
# 1. Prometheus: хранение exemplars включается флагом
--enable-feature=exemplar-storage

# 2. Collector: exemplars существуют только в формате OpenMetrics
exporters:
  prometheus:
    enable_open_metrics: true

# 3. Коннектор: прикреплять exemplars к гистограмме
connectors:
  spanmetrics:
    exemplars:
      enabled: true
Четвёртое звено — уже в Grafana, для самого перехода:
- name: Prometheus
  jsonData:
    exemplarTraceIdDestinations:
      - name: trace_id
        datasourceUid: tempo
Проверка цепочки — три отдельных критерия, потому что рвётся она в трёх местах:
ГОДЕН   exemplars хранятся в Prometheus     5 (нужно не меньше 1)
ГОДЕН   trace_id из exemplar непустой      да
ГОДЕН   трейс найден в Tempo, спанов        8 (нужно не меньше 1)
ГОДЕН   трейс содержит нужный сервис       да
ГОДЕН   трейс содержит нужную операцию     да
Последние два критерия — не педантизм. Первая редакция проверки брала exemplar у метрики без фильтра по серии, то есть у любой из десятков: внутренних спанов, спанов Java-сервиса. Трейс исправно находился — и относился к другой операции. Проверка честно объявила отказ и поймала неверную посылку в себе самой: чтобы утверждать «прыжок ведёт в нужный трейс», прыгать надо из той самой точки, про которую утверждаешь.
Кстати, о том же в терминах инцидента: exemplar может указывать на трейс, которого в хранилище нет. Метрика посчитана по спану, а сам спан не сохранён — отброшен сэмплированием. Ромбик на графике есть, клик ведёт в пустой экран. Это второе звено, и проверять его надо отдельно от первого.
Trace-based SLO и когда он врёт
Раз span-метрики согласуются с RED, поверх них работают те же правила SLO, что в статье 5: доступность как доля не-ошибочных, латентность как доля быстрее порога, burn rate как расход бюджета. Новых правил писать не нужно — меняется только источник.
Плюс подхода: SLO появляется у любой операции, размеченной спаном, включая внутренние и асинхронные, где HTTP-инструментирования нет вовсе. Например, у orders.created process — обработки сообщения из брокера.
Минус ровно один, но он перечёркивает всё, если про него забыть: при head-сэмплировании такое SLO считается по доле трафика. При 10 % бюджет ошибок расходуется по выборке из каждого десятого запроса, и попадание в пороги становится вопросом статистики, а не факта. Trace-based SLO имеет смысл при полном сборе спанов — либо при tail sampling с явным пониманием, что ошибки в выборке представлены чаще.
Анти-паттерны: 33 лейбла из ничего
Вернёмся к таблице сравнения: у метрик Collector 33 лейбла против 7 у Tempo. Откуда столько?
container_id, host_arch, host_name, os_description, os_type, os_version,
process_command_args, process_executable_path, process_pid,
process_runtime_description, process_runtime_name, process_runtime_version,
service_instance_id, service_name, service_version,
telemetry_distro_name, telemetry_distro_version, telemetry_sdk_language, ...
Это resource_to_telemetry_conversion: enabled: true — настройка, которая переносит каждый ресурсный атрибут в лейбл метрики. Удобно для отладки: сразу видно, с какого хоста и какой сборки пришли данные. И разорительно в проде, потому что среди этих лейблов есть process_pid и service_instance_id, которые меняются при каждом перезапуске процесса. Каждый рестарт сервиса порождает полный новый набор серий.
Тот же механизм в статье 3 измерен на лейблах Loki: service.instance.id в индексных лейблах давал новый поток на каждый рестарт. Здесь он работает на метриках, где серия дороже. Замер — в статье 8.
Второй анти-паттерн — over-instrumentation. Спан на каждую функцию даёт дерево, в котором не найти причину, и в span-метриках превращается в десятки серий по span_name, большая часть которых никому не нужна. Дешёвый признак: если по метрике операции никто ни разу не построил панель и не завёл алерт, эта операция не нуждалась в отдельном спане.
Итог
Что стоит забрать:
- Спан — структурированная запись, а не полоска на waterfall. Из него считаются метрики, по нему строятся SLO, через него делается прыжок с графика в конкретный запрос.
SPAN_KINDопределяет, что можно считать. RED считают поSERVER; смешать сCLIENT— посчитать каждый вызов дважды.- Семантические конвенции соблюдаются неравномерно. Java-агент проставил
http.route, Go-сервис — нет: панель по маршрутам для одного из сервисов пуста при исправной телеметрии. Проверяйте наличие атрибута до того, как строить на нём дашборд. - Высокая кардинальность в атрибутах спана — нормально, в лейблах метрики — разорительно.
order.idв спане полезен, в лейбле метрики — взрыв. SetStatusиRecordError— разные вещи. Первое делает трейс находимым по признаку ошибки и попадает в span-метрики, второе добавляет подробности.- Два проверенных пути к постоянным Prometheus-метрикам несовместимы по форме:
span_metricsпротивspanmetricsв имени, миллисекунды против секунд,service_nameпротивservice,durationпротивlatency. Префикс и единицы можно выровнять настройкой коннектора (namespace,histogram.unit: s), имя метрики латентности — нет, так что переключение пути всё равно означает переписывание запросов. А вот разница в числе лейблов (33 против 7 у меня) и в бакетах — следствие конфигурации:resource_to_telemetry_conversionи заданныеdimensions. Третий путь, TraceQL metrics, в сравнение не входит: он не материализует постоянных серий, перенося цену в хранение трейсов и выполнение запроса. - Процессоры генератора Tempo выключены по умолчанию. Без секции
overridesон стартует без ошибок и молча ничего не делает. - Span-метрики сходятся с RED до единицы — 200 из 200, 6 ошибок при 6 фактических 502 — но только при полном сборе спанов.
- При сэмплинге 10 % span-метрики занижают объём в 9,43 раза. Это свойство, а не дефект; восстановить настоящее число умножением на 1/доля нельзя, а при tail sampling единого множителя не существует.
- Trace-based SLO при head-сэмплировании считается по выборке. Имеет смысл при полном сборе или с явной оговоркой про смещение выборки.
- Цепочка exemplars состоит из четырёх звеньев, и каждое рвётся молча. Флаг Prometheus, OpenMetrics у экспортёра,
exemplars.enabledу коннектора,exemplarTraceIdDestinationsв Grafana. Метрики при отказе любого выглядят исправными. - Exemplar может указывать на трейс, которого нет в хранилище — если спан отброшен сэмплированием. Ромбик есть, клик ведёт в пустоту.
resource_to_telemetry_conversionтащит в лейблыprocess_pidиservice_instance_id. Каждый рестарт — новый набор серий. Удобно для отладки, разорительно в проде.- Отсутствие эффекта и отсутствие настройки выглядят одинаково. Опыт «включим и посмотрим» обязан проверять, что настройка применилась, — иначе сломанный опыт выдаст себя за открытие. У меня выдал: «множитель 1.0x» при неприменившемся сэмплере.
Дальше — кардинальность и стоимость телеметрии: сколько всё это стоит и что резать в первую очередь.
Документация и первоисточники
- OTel: semantic conventions — стандартные имена атрибутов и их значения.
- OTel: span kind — роли спанов и что из них следует.
- Spanmetrics connector — размерности, гистограммы, exemplars.
- Tempo: metrics-generator — span-metrics и service graphs на стороне бэкенда, и
overridesдля их включения. - Prometheus: exemplars — флаг хранения и ограничения.
- OpenMetrics: exemplars — почему без OpenMetrics их не передать.
- Grafana: exemplars — настройка перехода metric → trace.
- Стенд, конфиги и сырые выводы замеров —
digital-cookbook/observability/practice-stack.
Комментарии