
Событийный поток невидим. В отличие от таблицы в базе, которую можно открыть и посмотреть, сообщения в брокере находятся в движении: они производятся, партиционируются, реплицируются, потребляются группами, а при ребалансе партиции переезжают между потребителями. Понять это «на глаз» сложно, и поэтому регулярно появляются инструменты, которые обещают «показать» Kafka.
Проблема в том, что слово «визуализатор» слишком общее. Браузерная анимация вроде Kafka Traffic Visualizer от Evoura или симуляции SoftwareMill и корпоративный Stream Lineage решают совершенно разные задачи, хотя оба «визуализируют Kafka». Спутать их — значит выбрать не тот инструмент: пытаться учить новичка по прод-дашборду или, наоборот, мониторить production игрушечной анимацией.
Эта статья — про смысл и цели таких инструментов: зачем вообще визуализировать потоки, какие классы визуализаторов существуют и как выбрать подходящий под конкретную задачу.
В статье
- Почему событийные потоки тянет визуализировать
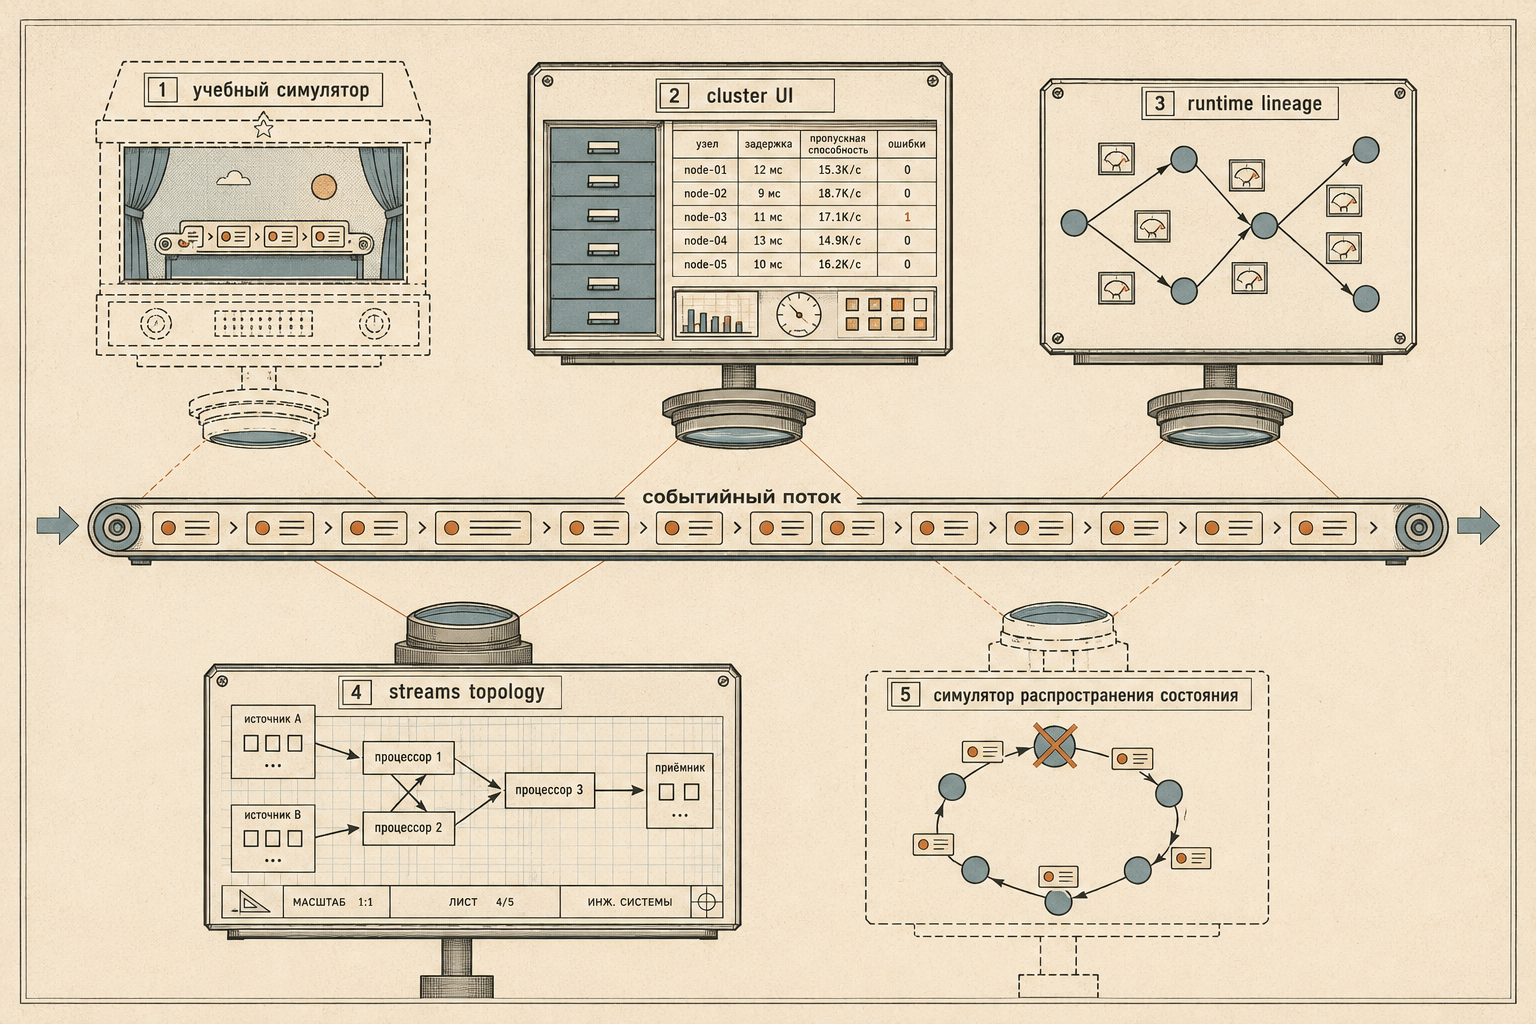
- Пять разных «визуализаторов»
- Что визуализация реально даёт
- Чего визуализатор не заменяет
- Как выбрать под задачу
- Checklist: какой визуализатор вам нужен
Почему событийные потоки тянет визуализировать
Три свойства событийных систем делают их трудными для понимания «из кода»:
- невидимость — сообщение живёт в брокере между producer и consumer, его нельзя «открыть и посмотреть» как строку в таблице;
- асинхронность — нет линейного «вызвал → получил ответ»; producer не знает, кто и когда прочитает событие;
- распределённость — партиции, реплики, consumer groups, ребаланс: поведение возникает из взаимодействия многих компонентов.
Отсюда «intuition gap»: даже понимая теорию (партиции, consumer groups, replication factor), сложно представить, что происходит в конкретный момент. Визуализация закрывает этот разрыв — превращает абстрактную механику в наблюдаемую картину. Но в зависимости от того, чей разрыв закрывается — новичка, оператора прода или проектировщика pipeline — нужны разные инструменты.
Пять разных «визуализаторов»
Под одним словом скрываются как минимум пять классов инструментов с разными целями.
1. Учебные симуляторы
Браузерные анимации, моделирующие поведение Kafka без реального кластера. Примеры: Evoura Kafka Traffic Visualizer, SoftwareMill Kafka Visualisation.
- Цель: обучение, онбординг, демонстрация концепций.
- Что показывают: как ключ влияет на партицию, как работают стратегии назначения (sticky, round-robin, range, cooperative), что происходит при падении брокера, как меняется распределение при ребалансе.
- Не для: production — это модель, а не ваш кластер.
2. Cluster UI / management-инструменты
Веб-интерфейсы к реальному кластеру: просмотр топиков, сообщений, consumer groups, лагов. Примеры: Kafka-UI (kafbat-ui / бывший provectus), AKHQ, Kafdrop, Redpanda Console, Conduktor.
- Цель: оперативная работа с кластером — посмотреть сообщения, проверить лаг, при необходимости отправить сообщение, сбросить offset или поправить конфиг топика.
- Что показывают: фактические данные вашего кластера в табличном/браузерном виде.
- Не для: «красивой» анимации потока — это рабочий инструмент, а не наглядное пособие.
Здесь стоит провести границу, которую сам интерфейс не проводит, — и она проходит не по линии «чтение против записи», а по трём уровням.
Метаданные и лаг — список топиков, размеры партиций, отставание групп. Кластер это не меняет, и обычно такие данные менее чувствительны, чем содержимое сообщений, — но не безусловно. Имена топиков, consumer groups и client ID часто и есть карта домена: по ним читаются клиенты, внутренние сервисы и структура компании, особенно если в имя топика вынесено название заказчика. Поэтому уровень доступа сюда определяется классификацией самих метаданных, а не презумпцией «это же просто список».
Просмотр самих сообщений уже не безобиден, хотя технически это тоже чтение. В payload лежат персональные данные, токены, коммерческие условия — всё то, ради чего в остальной системе выстроены права доступа. Интерфейс же показывает их одной кнопкой «посмотреть сообщения», и по журналу доступа к базе такой просмотр не пройдёт. Это отдельное право, а не бесплатное приложение к диагностике.
Запись — отправить сообщение, сбросить offset группы, изменить конфиг топика. Последствия расходятся дальше нажатой кнопки: дубликат уедет всем потребителям топика, сброшенный offset заставит группу перечитать или пропустить данные. В интерфейсе это лежит в двух кликах от просмотра.
Практический вывод простой: минимальные привилегии и аудит нужны не только на запись, но и на доступ к содержимому сообщений — а «зашёл посмотреть и заодно поправил» не должно быть возможным в принципе.
3. Runtime lineage / topology
Граф «данных в движении» по живому кластеру: кто производит, кто потребляет, как связаны топики, коннекторы, stream-приложения — с метриками. Примеры: Confluent Stream Lineage, Lenses Topology, Kpow.
- Цель: наблюдаемость и понимание реального потока в проде, поиск bottleneck, аудит зависимостей.
- Что показывают: producer → topic → consumer как граф с наложенными метриками (rate, lag, status).
- Не для: обучения с нуля — предполагает, что у вас уже есть работающая система.
4. Streams topology visualizers
Визуализация структуры обработки (DAG) Kafka Streams / stream-processing приложения. Примеры: kafka-streams-viz, KSTD, topology visualization в Spring Cloud Stream.
- Цель: проектирование и ревью топологии обработки — увидеть source → processor → sink, state stores, репартиционирование.
- Что показывают: статическую структуру pipeline, а не трафик в реальном времени.
- Не для: мониторинга нагрузки — это про дизайн, а не про runtime.
5. Учебные инструменты распространения состояния
Первые четыре класса выросли вокруг брокера, и то же деление повторяется за пределами Kafka: management UI у RabbitMQ, dashboard у NATS, схемы потоков в async-инструментах. Пятый класс устроен иначе — он отвечает на вопрос уровнем ниже: как узлы вообще договариваются о том, что произошло.
Инструменты здесь объединены целью, а не устройством, и носитель у них разный — это стоит держать в голове при выборе:
-
браузерная модель протокола — raft.github.io (кластер прямо во вкладке) и The Secret Lives of Data (тот же Raft, но с проводником), демо протокола Scuttlebutt;
-
калькулятор свойств — калькулятор consistency level у ScyllaDB ничего не моделирует во времени: по числу узлов, фактору репликации и паре CL на чтение и запись он показывает, пересекаются ли кворумы. Рамку стоит держать в голове: это утверждение про пересечение кворумов в его собственной модели, а не доказательство линеаризуемости операций или изоляции транзакций — недаром в самом калькуляторе среди уровней есть ONE, TWO, THREE, QUORUM и ALL, но нет
SERIAL, которым в Scylla и Cassandra отдельно обслуживаются лёгкие транзакции; -
одноразовый настоящий кластер — консольное демо CL поднимает три реальных узла ScyllaDB в Docker и гасит их по одному, показывая трассировку запросов. Это не модель: узлы настоящие. Но и не ваша система — стенд поднимается ради урока и выбрасывается.
-
Цель: понять поведение распределённой системы при отказе — то, чего не видно ни в одном UI кластера.
-
Что показывают: выборы лидера, репликацию журнала, кворумы, расхождение и схождение реплик.
-
Не для: вашего прод-кластера — где-то это модель протокола, где-то одноразовый стенд, но ваших данных здесь нет ни в одном случае.
Название важнее, чем кажется: это не «симуляторы консенсуса». Внутри класса ценен именно контраст. Raft-визуализатор показывает, как договориться о едином порядке: есть лидер, термы, журнал, и всё вращается вокруг того, кто сейчас главный. Scuttlebutt показывает противоположную стратегию — лидера нет вовсе, узлы обмениваются версиями и сходятся сами. Приём визуализации при этом один и тот же: кликнуть по узлу и смотреть, как изменение расходится по сети. Один жанр обслуживает две разные модели согласованности, и сузить его до консенсуса значит потерять половину.
Отдельный пример этого класса — Consensus Landscape: тур по Raft, Paxos, Zab и EPaxos, в котором перевыборы, сетевые разрывы и цена latency между дата-центрами воспроизводятся руками. Там же видно, зачем классу нужны сразу несколько алгоритмов: разница между ними проявляется не в описании, а в конкретный момент отказа.
и понимать"] --> C1 LEARN --> C5 OPS["Эксплуатировать"] --> C2 OPS --> C3 DESIGN["Проектировать"] --> C4 C1["1. Учебные симуляторы
Evoura, SoftwareMill"] C5["5. Учебные инструменты
распространения состояния
Raft, CL-калькулятор, демо-кластер"] C2["2. Cluster UI
Kafka-UI, AKHQ, Redpanda Console"] C3["3. Runtime lineage
Stream Lineage, Lenses, Kpow"] C4["4. Streams topology
kafka-streams-viz, kstd"] classDef model stroke-dasharray:5 5,stroke-width:2px; classDef real stroke-width:2px; class C1,C5 model; class C2,C3,C4 real;
flowchart LR
    LEARN["Учить
и понимать"] --> C1
    LEARN --> C5
    OPS["Эксплуатировать"] --> C2
    OPS --> C3
    DESIGN["Проектировать"] --> C4

    C1["1. Учебные симуляторы
Evoura, SoftwareMill"]
    C5["5. Учебные инструменты
распространения состояния
Raft, CL-калькулятор, демо-кластер"]
    C2["2. Cluster UI
Kafka-UI, AKHQ, Redpanda Console"]
    C3["3. Runtime lineage
Stream Lineage, Lenses, Kpow"]
    C4["4. Streams topology
kafka-streams-viz, kstd"]

    classDef model stroke-dasharray:5 5,stroke-width:2px;
    classDef real stroke-width:2px;
    class C1,C5 model;
    class C2,C3,C4 real;
Две оси, по которым класс выбирает сам себя
Из этого деления видны две закономерности, полезнее любого списка инструментов.
Чем сложнее модель согласованности, тем нужнее симулятор. У Redis преобладают операционные GUI вроде RedisInsight, а учебных симуляторов почти нет — модель достаточно проста, чтобы удержать её в голове. У систем с кворумами, репликацией и выборами лидера всё наоборот: там симулятор — основной способ понять поведение, и он появляется сам собой. Так же устроены визуализации внутренностей PostgreSQL — от B-tree до PGSimCity, где сервер показан как город и на живой нагрузке видно буферный пул, checkpointer и autovacuum.
Отказы — самый наглядный сценарий, хотя и не единственный. Проектирование топологии, поиск зависимостей и онбординг живут и без единого отказа — это отдельные, вполне самостоятельные поводы. Но именно отказ показывает то, чего текст не передаёт: статическую схему понять легко и по описанию — вот брокеры, вот партиции. Не понятно другое, что произойдёт, когда одно из этих звеньев исчезнет. Поэтому во всех сильных инструментах жанра главная кнопка одна и та же: убить лидера в raft.github.io, выключить брокер в симуляции SoftwareMill, погасить узел в демо ScyllaDB. Инъекция отказа здесь работает как приём обучения, а не как тестирование — с Jepsen у этого общее только слово «отказ».
Отсюда практический вывод: «визуализатор» без уточнения цели — почти бесполезное слово. Спрашивать надо не «есть ли визуализатор», а «какой из пяти».
Что визуализация реально даёт
- Понимание и интуиция — увидеть ребаланс или распределение по ключу нагляднее, чем прочитать про них.
- Онбординг — новый человек в команде быстрее схватывает, как устроен поток.
- Отладка — граф lineage или UI помогает найти «кто на самом деле читает этот топик» и где копится лаг.
- Коммуникация — картинкой проще объяснить поток не-инженеру (продукту, аналитику), чем конфигом.
- Проектирование — topology-визуализатор ловит проблемы дизайна (лишнее репартиционирование) до прода.
Чего визуализатор не заменяет
Здесь чаще всего возникают завышенные ожидания:
- учебный симулятор ≠ ваш кластер — он показывает модель с дефолтными настройками, а не ваше поведение под нагрузкой;
- визуализация ≠ наблюдаемость — красивый граф не заменяет метрики, алерты и distributed tracing; для прода нужны измеримые сигналы (lag, throughput, error rate), а не только картинка;
- картинка ≠ понимание архитектуры — инструмент покажет «что есть», но не ответит «почему так спроектировано»;
- single pane ≠ полнота — ни один визуализатор не покрывает все пять целей сразу; попытка найти «один на всё» обычно заканчивается компромиссом во всём.
Визуализатор — это линза под конкретную задачу, а не замена observability-стека. Связку метрик и трассировки для событийных систем разбирает отдельный материал про наблюдаемость событийных паттернов.
Как выбрать под задачу
| Задача | Класс инструмента | Примеры |
|---|---|---|
| Научить(ся) концепциям Kafka | Учебный симулятор | Evoura, SoftwareMill |
| Посмотреть реальные топики/сообщения/лаг | Cluster UI | Kafka-UI, AKHQ, Redpanda Console |
| Понять поток данных в проде, найти bottleneck | Runtime lineage | Confluent Stream Lineage, Lenses, Kpow |
| Спроектировать/отревьюить pipeline обработки | Streams topology | kafka-streams-viz, kstd |
| Понять, как система ведёт себя при отказе узла | Учебный инструмент распространения состояния | raft.github.io, CL-калькулятор ScyllaDB, консольное демо ScyllaDB |
Главный вопрос перед выбором — не «какой визуализатор лучше», а «какой разрыв в понимании я закрываю». Учу новичка, смотрю данные, наблюдаю прод, проектирую обработку или разбираюсь в поведении при отказе — это пять разных ответов.
Checklist: какой визуализатор вам нужен
- Вы учите концепциям или работаете с реальным кластером? (симулятор vs всё остальное)
- Вам нужны фактические данные топиков или граф зависимостей? (UI vs lineage)
- Вам важен runtime-трафик или статическая структура обработки? (lineage vs topology)
- Вопрос вообще про брокер — или про то, как узлы договариваются при отказе? (всё перечисленное vs учебный инструмент распространения состояния)
- Вы не пытаетесь подменить визуализацией метрики/трейсинг прода?
- Готовы ли вы держать несколько инструментов под разные цели вместо одного «универсального»?
Если на пункт 1 нет чёткого ответа — сначала определите, чью именно «слепоту» вы лечите. От этого зависит всё остальное.
Комментарии