
Kubernetes прекрасно управляется со stateless-подами: убил, пересоздал, отскейлил — состояние нигде не потеряно. Со stateful всё иначе: под должен помнить, кто он, сохранять диск между рестартами и не терять данные при переезде на другую ноду. Здесь на сцену выходят StatefulSet и подсистема хранилища — и главный вопрос: стоит ли вообще держать БД в кластере. Ответ на него зависит не от Kubernetes, а от того, какое под ним хранилище, и это лучше всего видно на живых замерах.
Это пятая статья серии «Kubernetes на практике». Ресурсы и QoS из «Ресурсы в Kubernetes: requests, limits и QoS» для stateful-нагрузок критичнее вдвойне: OOMKill базы данных — это не то же самое, что рестарт stateless-реплики. Все числа ниже сняты на живом стенде kubernetes/stateful в публичном репозитории digital-cookbook: Kubernetes 1.36.2 на узлах Talos Linux, containerd, образы busybox:1.37 и postgres:18.4. Хранилище в кластере ровно одно — StorageClass nfs-csi с провижинером nfs.csi.k8s.io поверх NFS, и его свойства определили половину наблюдений: где-то помогли показать редкое, где-то честно упёрлись в ограничение. Кластер собран так же, как в статье про четыре отказа при bootstrap на Talos: SSH на узлы нет, всё наблюдение идёт через API-сервер — kubectl get, kubectl exec, kubectl describe.
В статье
- StatefulSet против Deployment
- Идентичность и headless-сервис
- Порядок раскатки
- Хранилище: PV, PVC, StorageClass
- volumeClaimTemplates и судьба томов
- Reclaim policy и расширение
- Бэкап и восстановление
- БД в Kubernetes: когда оправдано
StatefulSet против Deployment
Deployment исходит из того, что реплики взаимозаменяемы. Имя пода — случайный суффикс, порядок запуска не определён, том (если он есть) один на всех или вовсе эфемерный. Для сервиса без состояния это удобно: любую реплику можно убить, любую заменить, разницы нет.
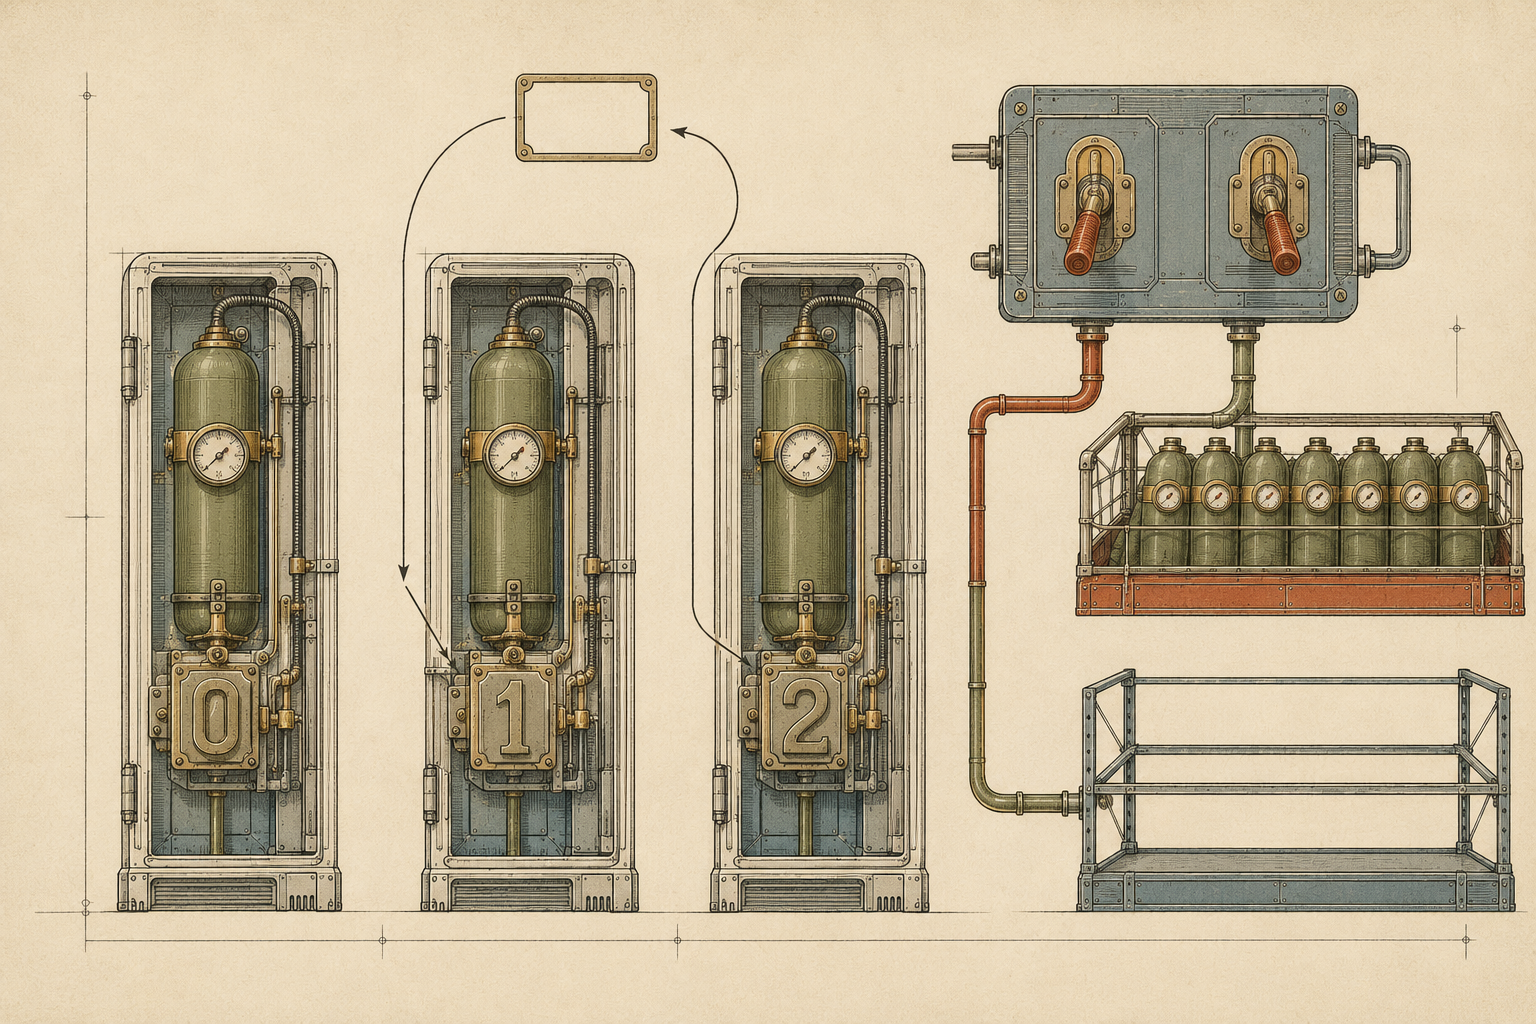
StatefulSet меняет три вещи сразу: имена становятся порядковыми и устойчивыми, у каждой реплики появляется собственный том, а операции идут по одной. Три реплики стенда выглядят так:
$ kubectl get pod,pvc -n cookbook-k8s -l app=demo -o wide | head -4
NAME         READY   STATUS    RESTARTS   AGE   IP             NODE
pod/demo-0   1/1     Running   0          11s   10.244.3.84    k8s-volga-wk01
pod/demo-1   1/1     Running   0          10s   10.244.6.122   k8s-volga-wk03
pod/demo-2   1/1     Running   0          9s    10.244.4.47    k8s-volga-wk02
Имена — demo-0, demo-1, demo-2, без случайных суффиксов. Разница в возрасте (11, 10 и 9 секунд) — не случайность: поды поднимались по одному, снизу вверх по индексу.
Томов при этом три, а не один:
$ kubectl get pod,pvc -n cookbook-k8s -l app=demo -o wide | tail -4
NAME                                STATUS   VOLUME                                     CAPACITY   ACCESS MODES   STORAGECLASS
persistentvolumeclaim/data-demo-0   Bound    pvc-435cbbcd-dc71-44f4-ab84-092fc2d51fed   1Gi        RWO            nfs-csi
persistentvolumeclaim/data-demo-1   Bound    pvc-5e4879c6-5ebc-41d2-bec2-0808faf31d7b   1Gi        RWO            nfs-csi
persistentvolumeclaim/data-demo-2   Bound    pvc-bc189be0-f55a-449d-85d1-65aa3e053189   1Gi        RWO            nfs-csi
Три разных PersistentVolume, по одному на реплику. Изоляция проверяется тривиально: каждый под при старте дописывает строку в /data/journal.txt на своём томе, и в журнале demo-0 видна только его собственная запись — соседей там нет. Это принципиально отличается от «прикрутить один общий том к Deployment»: реплики StatefulSet не делят состояние, а владеют своими кусками.
Главное же свойство — устойчивость идентичности к пересозданию. Под demo-1 удалён вручную, контроллер поднял его заново:
$ kubectl -n cookbook-k8s get pod demo-1 -o wide
NAME     READY   STATUS    RESTARTS   AGE   IP             NODE
demo-1   1/1     Running   0          1s    10.244.6.112   k8s-volga-wk03
Это новый объект Pod — возраст 1 секунда, счётчик рестартов нулевой, IP сменился с 10.244.6.122 на 10.244.6.112. А вот заявка на том осталась прежней, буквально до идентификаторов. Снимок PVC data-demo-1 до удаления пода и после:
$ kubectl -n cookbook-k8s get pvc data-demo-1 \
    -o jsonpath='uid={.metadata.uid} created={.metadata.creationTimestamp} volume={.spec.volumeName}{"\n"}'
uid=5e4879c6-5ebc-41d2-bec2-0808faf31d7b created=2026-07-23T11:01:41Z volume=pvc-5e4879c6-5ebc-41d2-bec2-0808faf31d7b
Обе строки совпали посимвольно: uid, creationTimestamp и связанный PV не изменились, возраст PVC на контрольном выводе — 13 минут, то есть счётчик не сбрасывался. PVC не пересоздавался — новый под просто переподключился к тому же тому.
Данные это подтверждают напрямую. В журнале после пересоздания три строки:
$ kubectl exec -n cookbook-k8s demo-1 -- cat /data/journal.txt
demo-1 первая запись 2026-07-23T11:01:42Z
метка до удаления 2026-07-23T11:14:09Z
demo-1 первая запись 2026-07-23T11:14:46Z
Первая — от исходного запуска, вторая поставлена руками за секунды до удаления, третья написана стартовым скриптом нового пода. Если бы под получил новый пустой том, первых двух строк бы не было. Отсюда практический критерий выбора между двумя контроллерами: Deployment достаточен там, где реплике нечего помнить между перезапусками; StatefulSet нужен там, где «эта реплика» и «её данные» — одно целое: узел кластера БД, брокер с журналом, шардированный кеш с прогретым состоянием.
Идентичность и headless-сервис
Устойчивое имя пода само по себе бесполезно, если по нему нельзя обратиться. Обычный Service даёт один ClusterIP и балансирует запросы между всеми репликами — ровно то, что не нужно кластеру БД, где реплики не равны и клиент хочет попасть в конкретную.
Headless-сервис решает это одной строкой:
apiVersion: v1
kind: Service
metadata:
  name: demo
  namespace: cookbook-k8s
spec:
  clusterIP: None
  selector:
    app: demo
  ports:
    - port: 80
      name: http
clusterIP: None означает «виртуального адреса не надо». Вместо него DNS-сервис кластера (kube-dns — так называется сам сервис, а реализует его CoreDNS) отдаёт адреса самих подов, а каждому поду StatefulSet заводит собственную A-запись вида <под>.<сервис>.<namespace>.svc.cluster.local. Одно условие тут легко упустить: эти пер-подовые записи появляются, только если поле spec.serviceName у StatefulSet указывает на headless-сервис (в манифесте стенда — serviceName: demo). Без этой связки индивидуальных DNS-имён у подов просто не будет — самая частая причина недоумения «а где имена подов». Проверка изнутри кластера:
$ for p in demo-0 demo-1 demo-2; do \
    kubectl -n cookbook-k8s exec demo-0 -- nslookup $p.demo.cookbook-k8s.svc.cluster.local \
    | grep -A1 '^Name:'; echo; done
Name:	demo-0.demo.cookbook-k8s.svc.cluster.local
Address: 10.244.3.84

Name:	demo-1.demo.cookbook-k8s.svc.cluster.local
Address: 10.244.6.122

Name:	demo-2.demo.cookbook-k8s.svc.cluster.local
Address: 10.244.4.47
Три имени — три разных адреса, ровно те, что стоят в выводе kubectl get pod (снимок DNS снят до показанного выше пересоздания demo-1, поэтому его адрес здесь — прежний 10.244.6.122, а не 10.244.6.112). Тот же список отдаётся и разом, через EndpointSlice сервиса:
$ kubectl -n cookbook-k8s get endpointslice -l kubernetes.io/service-name=demo -o wide
NAME         ADDRESSTYPE   PORTS   ENDPOINTS
demo-pb8x8   IPv4          80      10.244.3.84,10.244.6.122,10.244.4.47
Отсюда типовой сценарий сборки кластера с фиксированными пирами: список участников известен заранее и не зависит от того, какие IP выдаст CNI. Postgres-реплика знает мастера как pg-0.pg.<ns>.svc.cluster.local, брокер знает соседей по индексам, а не по адресам — и переезд пода на другой узел ничего в конфигурации не меняет.
Одна деталь, на которой легко потерять час. Изнутри контейнера busybox короткое имя demo-1 не резолвится — работает только полный FQDN. Причина не в headless-сервисе: DNS-запись у пода корректная и рассчитана на обращение по полному имени. Дело в резолвере busybox и в том, как он перебирает search-суффиксы из /etc/resolv.conf: он пробует demo-1.cookbook-k8s.svc.cluster.local, demo-1.svc.cluster.local, demo-1.cluster.local — и ни один из вариантов не совпадает с настоящей записью demo-1.demo.cookbook-k8s.svc.cluster.local, где имя сервиса стоит отдельной второй меткой. Такой цепочкой суффиксов нужное имя просто не собирается. Вывод сугубо прикладной: в конфигурации пиров пишите FQDN целиком и не полагайтесь на догадливость резолвера конкретного образа.
Порядок раскатки
Третье отличие StatefulSet от Deployment — операции идут по одной реплике. Обновление на стенде запущено самым безобидным способом: патч аннотации в шаблоне пода, снимок состояния каждые 10 секунд. Картина по опорным точкам:
$ kubectl -n cookbook-k8s patch statefulset demo \
    -p '{"spec":{"template":{"metadata":{"annotations":{"rollout":"1"}}}}}'
# далее каждые 10 с: kubectl -n cookbook-k8s get pod -l app=demo --no-headers
# (ниже — опорные снимки, сжато в одну строку)
t= 10s demo-0 1/1 Running  demo-1 1/1 Running       demo-2 1/1 Terminating
t= 50s demo-0 1/1 Running  demo-1 1/1 Terminating   demo-2 1/1 Running  (10s)
t= 80s demo-0 1/1 Terminating  demo-1 1/1 Running (8s)   demo-2 1/1 Running
t=110s demo-0 1/1 Running (8s)  demo-1 1/1 Running       demo-2 1/1 Running
Порядок — от старшего индекса к младшему: сначала demo-2, затем demo-1, затем demo-0. Ни на одном из снимков не встретилось двух подов одновременно в Terminating или не в состоянии Ready — контроллер не берётся за следующую реплику, пока предыдущая не поднялась и не прошла проверку готовности. К снимку t=110s все три пода были новыми и работали, итог подтвердился явно:
$ kubectl -n cookbook-k8s get statefulset demo
NAME   READY   AGE
demo   3/3     18m
$ kubectl -n cookbook-k8s rollout status statefulset/demo --timeout=10s
partitioned roll out complete: 3 new pods have been updated...
В манифесте стенда никаких полей про порядок нет: podManagementPolicy: OrderedReady и updateStrategy: RollingUpdate с partition: 0 — значения по умолчанию. Именно эта последовательность и делает StatefulSet пригодным для кластеров БД: обновление реплики за репликой с ожиданием готовности не даёт погасить слишком много узлов разом. Важно только не переоценить контроллер: StatefulSet знает лишь про порядок (стабильные имена, последовательное создание и удаление) и про readiness — он даёт стабильную идентичность и привязку к тому, но сам кворум, консистентность данных и выбор лидера обеспечивает уже сама СУБД, а не StatefulSet. Обратная сторона — время: три реплики раскатывались около ста десяти секунд, примерно по полминуты на каждую, а на кластере из десятка узлов с медленным прогревом это уже десятки минут, в течение которых сосуществуют две версии. Ускорить это через podManagementPolicy: Parallel не выйдет: это поле управляет только созданием и удалением подов при масштабировании и замене, а на updateStrategy: RollingUpdate не влияет — обновление всё равно идёт по одному поду от старшего индекса к младшему. Настоящий рычаг параллельной раскатки — updateStrategy.rollingUpdate.maxUnavailable, разрешающий обновлять несколько подов разом; он спрятан за feature gate MaxUnavailableStatefulSet, который в Kubernetes 1.36 остаётся в статусе beta и по умолчанию выключен (короткое время в 1.35.0–1.35.3 дефолт был true, но в 1.35.4 его вернули на false). Впрочем, для кворумных систем ускорять раскатку обычно невыгодно: смысл последовательного обновления с ожиданием готовности как раз в том, чтобы кворум не разваливался.
Побочное наблюдение, которое стоит узнать заранее, чтобы не пугаться. На снимке t=40s demo-2 показал STATUS=Error (0/1, счётчик рестартов нулевой) вместо ожидаемого Terminating, а на следующем снимке был уже нормально пересоздан. Событий уровня Warning или BackOff для этого перехода в kubectl get events нет, список событий обычный: SuccessfulDelete → Killing → SuccessfulCreate → Started. Наиболее вероятное объяснение — контейнер стенда выполняет sleep infinity, сигнал SIGTERM не перехватывает и потому завершается с ненулевым кодом, а kubectl на пару секунд отображает это как Error; код завершения предыдущего контейнера в этом замере не снимался, так что это объяснение, а не доказанный факт. Практический смысл всё равно есть: краткий Error посреди раскатки не обязательно означает сбой, и первое, на что стоит смотреть, — события пода, а не статус в одной строке kubectl get.
Хранилище: PV, PVC, StorageClass
Модель хранилища в Kubernetes намеренно разделена на три объекта, и это разделение отвечает на три разных вопроса.
PersistentVolume (PV) — сам том: кусок хранилища, у которого есть размер, режимы доступа и способ подключения. Это объект уровня кластера, и в норме его никто не создаёт руками.
PersistentVolumeClaim (PVC) — заявка приложения: «мне нужен том на столько-то, с такими режимами доступа, такого класса». Объект уровня namespace, живёт рядом с подом и от подробностей бэкенда не зависит.
StorageClass — правило, по которому заявка превращается в том: какой CSI-драйвер вызывать, что делать с томом после удаления заявки, когда именно провижинить. Это и есть динамический провижининг: разработчик пишет PVC, контроллер создаёт PV.
Свойства единственного класса на стенде:
$ kubectl get storageclass nfs-csi -o custom-columns=NAME:.metadata.name,\
PROVISIONER:.provisioner,RECLAIM:.reclaimPolicy,BINDING:.volumeBindingMode,\
EXPAND:.allowVolumeExpansion
NAME      PROVISIONER      RECLAIM   BINDING     EXPAND
nfs-csi   nfs.csi.k8s.io   Retain    Immediate   <none>
Три колонки справа — это три решения, принятые за приложение: удалённая заявка не стирает том (Retain), том создаётся сразу при появлении PVC, а не при первом поде (Immediate), расширение не разрешено (пустое EXPAND). Ни одно из них не является свойством Kubernetes — все три задаются в StorageClass, и на соседнем кластере набор может быть противоположным.
Режимы доступа — отдельная тема, где интуиция обычно подводит. ReadWriteOnce (RWO) означает «монтируется на запись одним узлом», ReadOnlyMany (ROX) — «на чтение многими», ReadWriteMany (RWX) — «на запись многими одновременно». RWX доступен далеко не на всяком хранилище, и причина техническая: блочное устройство — облачный диск, том Ceph RBD — физически подключается к одному узлу, и файловая система на нём не рассчитана на параллельную запись с разных машин.
На NFS всё иначе, и это можно показать. Отдельный PVC с accessModes: ["ReadWriteMany"] и два обычных пода, разведённых по разным узлам через podAntiAffinity, чтобы замер не свёлся к случаю «оба на одном хосте»:
$ kubectl -n cookbook-k8s get pvc shared \
    -o custom-columns=NAME:.metadata.name,MODES:.spec.accessModes,STATUS:.status.phase
NAME     MODES             STATUS
shared   [ReadWriteMany]   Bound

$ kubectl -n cookbook-k8s get pod rwx-writer rwx-reader \
    -o custom-columns=NAME:.metadata.name,NODE:.spec.nodeName
NAME         NODE
rwx-writer   k8s-volga-wk02
rwx-reader   k8s-volga-wk01
Писатель дописал строку в /shared/shared.txt, читатель на другом узле прочитал ровно её:
$ kubectl -n cookbook-k8s exec rwx-reader -- cat /shared/shared.txt
запись из writer 2026-07-23T11:51:03Z
Это подтверждение, что том действительно смонтирован на двух узлах одновременно, а не «два пода по очереди подключаются к одному PVC». Оговорка важнее самого замера: RWX здесь доступен потому, что nfs-csi — файловое хранилище, и разделяемый доступ заложен в самом протоколе NFS. На блочном хранилище такой демонстрации не получится вообще, и закладываться на RWX при проектировании — рискованная ставка: она привязывает приложение к типу бэкенда. Обычная альтернатива — не разделять том, а разделять данные: объектное хранилище для файлов, БД для состояния, а на локальный том каждой реплики — только то, что принадлежит ей одной.
volumeClaimTemplates и судьба томов
Собственный том у каждой реплики появляется не сам собой, а из шаблона заявки:
  volumeClaimTemplates:
    - metadata:
        name: data
      spec:
        accessModes: ["ReadWriteOnce"]
        storageClassName: nfs-csi
        resources:
          requests:
            storage: 1Gi
Контроллер разворачивает этот шаблон в отдельный PVC на каждую реплику, по правилу <имя шаблона>-<имя пода>: data-demo-0, data-demo-1, data-demo-2. Заявка при этом принадлежит не поду, а StatefulSet, и живёт своей жизнью — что и делает возможным всё описанное выше про пересоздание. «Принадлежит StatefulSet» при этом не значит «удаляется вместе с ним»: по умолчанию удаление StatefulSet заявки не трогает — том pg на стенде пережил kubectl delete statefulset и остался Bound без владельца. Уносит PVC за собой только явная политика persistentVolumeClaimRetentionPolicy, о которой ниже.
Дальше начинается самое неочевидное: что происходит с томами при масштабировании. По умолчанию — ничего. Скейл с трёх реплик до одной оставляет все три PVC на месте:
$ kubectl get pod,pvc -n cookbook-k8s -l app=demo | tail -4
NAME                                STATUS   VOLUME                                     CAPACITY   ACCESS MODES   AGE
persistentvolumeclaim/data-demo-0   Bound    pvc-435cbbcd-dc71-44f4-ab84-092fc2d51fed   1Gi        RWO            30m
persistentvolumeclaim/data-demo-1   Bound    pvc-5e4879c6-5ebc-41d2-bec2-0808faf31d7b   1Gi        RWO            30m
persistentvolumeclaim/data-demo-2   Bound    pvc-bc189be0-f55a-449d-85d1-65aa3e053189   1Gi        RWO            30m
Команда скейла до одной реплики отработала, а заявки все три и все в Bound. Возврат наверх подхватывает старый том, а не создаёт новый, — и это видно по журналу demo-2 после возвращения реплики:
$ kubectl -n cookbook-k8s exec demo-2 -- cat /data/journal.txt
demo-2 первая запись 2026-07-23T11:01:43Z
demo-2 первая запись 2026-07-23T11:16:18Z
метка перед скейлом вниз 2026-07-23T11:29:11Z
demo-2 первая запись 2026-07-23T11:31:21Z
метка перед скейлом вниз 2026-07-23T11:32:01Z
demo-2 первая запись 2026-07-23T11:33:12Z
Метка 11:32:01Z поставлена руками до скейла вниз, строка 11:33:12Z дописана контейнером, стартовавшим уже после возврата наверх. Между ними — минута, за которую реплику сняли и вернули, а данные никуда не делись.
Поведение по умолчанию — осознанная защита: случайный kubectl scale не должен стирать данные. Оборотная сторона — тома копятся. Уменьшили реплики один раз, забыли — и место в хранилище занято заявками, за которыми не стоит ни один под.
Штатный способ это изменить — поле persistentVolumeClaimRetentionPolicy:
  persistentVolumeClaimRetentionPolicy:
    whenDeleted: Delete
    whenScaled: Delete
Второй StatefulSet на стенде, demo-rp, — независимая копия первого со своим именем, лейблом app: demo-rp, собственным headless-сервисом и двумя репликами; к базовому набору он добавляет ровно эти три строки политики. Скейл с двух реплик до одной у него действительно уносит заявку освободившейся реплики — но не мгновенно: через полминуты после скейла PVC data-demo-rp-1 ещё был Bound, и пропал он только к следующим снимкам. Удаление StatefulSet целиком забирает и оставшиеся заявки. Здесь замер снят с отметками времени, опрос — каждые 5 секунд:
$ date -u +%FT%TZ; kubectl -n cookbook-k8s delete statefulset demo-rp
# далее каждые 5 с: date -u +%FT%TZ; kubectl -n cookbook-k8s get pvc -l app=demo-rp
2026-07-23T11:43:59Z  (kubectl delete statefulset demo-rp)
2026-07-23T11:44:27Z  data-demo-rp-0 Terminating ... data-demo-rp-1 Terminating
2026-07-23T11:44:32Z  No resources found in cookbook-k8s namespace.
Через 28 секунд после удаления заявки ещё в Terminating, через 33 — их уже нет. Точнее сказать нельзя: шаг опроса 5 секунд, и реальный момент лежит где-то внутри этой вилки. Порядок величины важнее точного числа — удаление не мгновенное, и скрипт, который сразу после kubectl delete statefulset проверяет «а всё ли убралось», нормально получит Terminating и решит, что что-то сломалось.
Практическая раскладка получается такая. whenScaled: Delete уместен там, где реплика без пода не нужна: кеш, воркер с восстановимым состоянием, распараллеленная обработка. whenDeleted: Delete — там, где жизненный цикл данных совпадает с жизненным циклом StatefulSet целиком, например у окружения, которое поднимается и сносится целиком. Для БД и любого состояния, которое дороже восстановить, чем хранить, обычно оставляют поведение по умолчанию, а заявки подчищают осознанно и руками.
Reclaim policy и расширение
Удаление заявки и удаление тома — разные события, и связывает их reclaimPolicy в StorageClass. Значений два: Delete — том удаляется вслед за заявкой, Retain — остаётся. На стенде действует Retain, и его поведение видно на отдельном RWX-томе, который специально подняли для этого демо. До удаления PVC:
$ kubectl get pv pvc-db95e396-9deb-40b8-9c36-7337287b19a9 \
    -o custom-columns=NAME:.metadata.name,CLAIM:.spec.claimRef.name,\
RECLAIM:.spec.persistentVolumeReclaimPolicy,STATUS:.status.phase
NAME                                       CLAIM     RECLAIM   STATUS
pvc-db95e396-9deb-40b8-9c36-7337287b19a9   shared    Retain    Bound
Через пятнадцать секунд после удаления PVC — тот же самый PV, с тем же именем:
$ kubectl get pv pvc-db95e396-9deb-40b8-9c36-7337287b19a9 \
    -o custom-columns=NAME:.metadata.name,CLAIM:.spec.claimRef.name,\
RECLAIM:.spec.persistentVolumeReclaimPolicy,STATUS:.status.phase
NAME                                       CLAIM     RECLAIM   STATUS
pvc-db95e396-9deb-40b8-9c36-7337287b19a9   shared    Retain    Released
Том не исчез, данные на бэкенде не тронуты, статус сменился на Released — «заявки больше нет, но и переиспользовать меня нельзя». То же самое происходит и с томами StatefulSet, у которого заявки удалила политика whenDeleted: Delete: PVC ушли, а PV перешли в Released и остались в кластере.
Отсюда неприятная арифметика эксплуатации: Retain защищает от потери данных, но каждое удаление оставляет след, который никто не уберёт автоматически. Released-тома не переиспользуются даже под заявку с тем же именем — их нужно либо удалять вручную, либо чистить у них claimRef, если содержимое действительно нужно вернуть в работу. В долго живущем общем кластере такие тома со временем копятся — за них платят, но ими не пользуются. Практика простая: инвентаризация kubectl get pv с фильтром по статусу — такая же регулярная операция, как проверка свободного места.
Второй параметр того же класса — расширение. Попытка увеличить заявку с 1 ГиБ до 2 ГиБ отклоняется на уровне API:
$ kubectl -n cookbook-k8s patch pvc data-demo-0 \
    -p '{"spec":{"resources":{"requests":{"storage":"2Gi"}}}}'
Error from server (Forbidden): persistentvolumeclaims "data-demo-0" is forbidden: only dynamically provisioned pvc can be resized and the storageclass that provisions the pvc must support resize
Размер PVC после попытки — по-прежнему 1Gi. Формулировка ошибки перечисляет два условия, и невыполнено здесь второе: у StorageClass nfs-csi не задано allowVolumeExpansion: true (в выводе выше колонка EXPAND пуста). Kubernetes расширять тома умеет, и на классе с включённым флагом изменение размера в PVC подхватывается контроллером, а файловая система расширяется при следующем монтировании или на лету. Это ограничение конкретного класса хранилища, а не платформы.
Практический вывод от этого не смягчается. Если расширение недоступно, объём тома под БД становится решением, которое принимается один раз и меняется только через миграцию данных на новый том. Значит, allowVolumeExpansion — то, что проверяют до выкатки stateful-нагрузки, а не в тот вечер, когда на томе кончилось место.
Бэкап и восстановление
Защит от потери данных две, и их регулярно путают.
Первая — уровень тома: снапшот CSI. В Kubernetes это штатный механизм на объектах VolumeSnapshotClass/VolumeSnapshot, но работает он только там, где установлены snapshot-контроллер и соответствующие CRD. На этом кластере их нет:
$ kubectl api-resources --api-group=snapshot.storage.k8s.io
NAME   SHORTNAMES   APIVERSION   NAMESPACED   KIND
$ kubectl get crd | grep -i snapshot
(пусто — совпадений нет)
Ни одного ресурса группы snapshot.storage.k8s.io, ни одной CRD. Показать снапшот тома здесь нечем — и это именно конфигурация конкретного кластера, а не свойство Kubernetes: на установке со снапшот-контроллером и нужными CRD этот способ доступен и работает быстро.
Вторая защита — уровень приложения: логический дамп. Его и разбираем на временном StatefulSet с postgres:18.4. В таблице notes — тысяча строк:
SELECT count(*) FROM notes;
-- 1000
Дамп в кастомном формате pg_dump -Fc занял 6957 байт. Дальше — типовая авария, воспроизведённая руками:
DROP TABLE notes;
SELECT count(*) FROM notes;
$ kubectl -n cookbook-k8s exec pg-0 -- psql -U postgres -c 'SELECT count(*) FROM notes;'
ERROR:  relation "notes" does not exist
LINE 1: SELECT count(*) FROM notes;
                             ^
command terminated with exit code 1
Восстановление из дампа через pg_restore возвращает счётчик к 1000 — те же строки, а не пересозданные заново.
А теперь то, ради чего это демо ставилось рядом. Пересоздание пода — тоже «восстановление», но принципиально другого класса. Под БД удалён, контроллер поднял его заново, и после возврата в 1/1 запрос сразу вернул 1000 строк без единого шага восстановления: PVC data-pg-0 остался привязан к тому же тому pvc-b85e3eb7-…, под потерял процесс, но не диск.
Разница между двумя механизмами — это разница между двумя классами инцидентов. Том переживает перезапуск пода, эвакуацию с узла, обновление StatefulSet — всё, что относится к жизненному циклу вычислений. От DROP TABLE, UPDATE без WHERE, кривой миграции и логической порчи данных приложением том не спасает вообще: файлы на диске меняются штатно, ошибки нет, реплика послушно повторит изменение за мастером. Спасает только бэкап, снятый до инцидента, — и умение его развернуть, проверенное заранее. Снапшот тома, где он доступен, стоит между этими двумя: он быстрее логического дампа и восстанавливает состояние целиком, на момент снимка, но сам по себе даёт лишь crash-consistent копию на уровне блоков. Тут важно не перегибать. Атомарный снимок одного тома, где лежат и файлы данных, и WAL, — это crash-consistent копия, эквивалентная аварийному отключению питания: при старте PostgreSQL штатно проходит WAL recovery и поднимается консистентным, это нормальный и поддерживаемый режим (filesystem-level backup). CHECKPOINT перед снимком сокращает время recovery, но сам по себе не делает копию application-consistent — восстановление по WAL всё равно идёт. Реальный риск порчи возникает в других случаях: снимок неатомарный; в него попал неполный набор файлов или WAL; данные и WAL лежат на разных томах, а снимки этих томов сняты вразнобой — вот тогда получается «рваное» состояние. Практический вывод: атомарный снимок одного тома с данными и WAL — это рабочий filesystem-бэкап, PostgreSQL поднимет его через WAL recovery, и CHECKPOINT перед ним лишь сокращает время этого восстановления, консистентности не добавляя. Отдельные меры — quiesce, заморозка файловой системы (FLUSH+FREEZE), снимок из реплики или средствами самой СУБД — нужны там, где требуется application-consistency сверх crash-consistent, либо где все тома одним атомарным снимком снять нельзя (данные и WAL на разных томах): именно там несинхронный снимок и даёт «рваное» состояние, и его надо предотвращать явно.
Отсюда рабочая комбинация для БД в кластере: регулярный логический или физический бэкап с проверенной процедурой восстановления и, отдельно, понимание, что PVC — это не бэкап. Детали эксплуатации самой СУБД — репликация, PITR, проверка восстановимости — разбираются в статье «HA PostgreSQL: Patroni, репликация и PITR-бэкапы»; здесь важно лишь, что Kubernetes ни одну из этих задач за вас не решает.
БД в Kubernetes: когда оправдано
Разговор «держать ли БД в кластере» обычно ведётся на уровне общих аргументов. Стенд даёт конкретный, и он поучительнее любых рассуждений.
Первый запуск Postgres на этом хранилище не удался. NFS-экспорт сквошит любой клиентский uid и gid к фиксированной паре 1024:100 — это настройка конкретной шары в духе «map all users to admin». Проверено отдельным подом со штатным для образа postgres идентификатором:
# id внутри пода
$ kubectl -n cookbook-k8s exec nfs-ownership-check -- id
uid=999 gid=999 groups=999

# ls -lan на смонтированном томе после записи файла
$ kubectl -n cookbook-k8s exec nfs-ownership-check -- \
    sh -c 'echo test > /data/testfile; ls -lan /data' | grep -Ev '^total| \.\.$'
drwxrwxrwx    1 1024     100             16 Jul 23 12:20 .
-rwxrwxrwx    1 1024     100              5 Jul 23 12:20 testfile
Процесс писал под 999:999, а файл на диске оказался с владельцем 1024:100 — и каталог тоже. Postgres сверяет владельца PGDATA с эффективным uid процесса побайтово и на несовпадении отказывается стартовать. Тот же отказ дёшево воспроизвели отдельным подом postgres:18.4 с тем же 999:999 и PGDATA на этом томе — путь /data/pgfail в логе выдаёт, что это именно контрольная реплика сбоя, а не запись того самого первого запуска:
$ kubectl -n cookbook-k8s logs nfs-ownership-pg-fail | grep -E 'FATAL|HINT|child process'
2026-07-23 12:20:57.007 UTC [69] FATAL:  data directory "/data/pgfail" has wrong ownership
2026-07-23 12:20:57.007 UTC [69] HINT:  The server must be started by the user that owns the data directory.
child process exited with exit code 1
Лечится это явным securityContext — контейнер обязан стартовать ровно под теми идентификаторами, в которые сквошит шара:
      securityContext:
        runAsUser: 1024
        runAsGroup: 100
        fsGroup: 100
Плюс отдельная деталь той же природы: PGDATA пришлось вынести в подкаталог тома (/var/lib/postgresql/data/pgdata), а не в его корень, — иначе инициализация на смонтированном каталоге NFS не проходит.
Полезно тут не само решение, а форма проблемы. Kubernetes отработал безупречно: под создан, том смонтирован, StatefulSet исправно перезапускал контейнер. Не сошлись СУБД и бэкенд хранилища — на владельце файлов, о котором в манифесте нет ни слова. Ровно так и выглядит большинство сложностей с БД в кластере: не «оркестратор плохой», а «в стек добавился слой со своими свойствами, и они всплывают на инициализации, под нагрузкой или при восстановлении».
Отсюда трейдофы, часть которых подкреплена замерами выше.
За. Единый поток поставки: манифест БД лежит в том же репозитории и раскатывается тем же способом, что и приложение. Self-service: команда поднимает себе экземпляр без заявки в инфраструктуру. Устойчивость идентичности и томов, которую мы видели: пересоздание пода, переезд, обновление — данные на месте. Наконец, оператор снимает рутину: развернуть реплику, переключить мастера, снять бэкап по расписанию — этим занимается контроллер, а не человек с плейбуком; механика операторов разбирается в «Операторы и CRD: расширяем Kubernetes под себя»готовится, с 27 октября.
Против. Хранилище становится частью архитектуры БД, а не деталью инфраструктуры: сетевой том добавляет задержку на каждой операции ввода-вывода, и для нагруженной OLTP-базы это самая важная характеристика системы. Возможности бэкенда придётся принимать как данность — на стенде это allowVolumeExpansion, которого нет, отсутствующие снапшоты и сквош идентификаторов. Радиус поражения при инциденте шире: проблема на уровне узла или CNI задевает и приложение, и его базу разом. И операционная нагрузка не исчезает, а меняет форму — вместо «настроить БД» получается «настроить БД и оператора и понимать оба».
Практический критерий. Небольшие и сопутствующие базы — очередь, справочник, БД внутреннего сервиса, тестовые окружения, поднимаемые и сносимые целиком, — в кластере оправданы: выигрыш в единообразии поставки перевешивает накладные расходы. Критичная нагруженная база требует честного сравнения с managed-сервисом или выделенными узлами, и первым в этом сравнении идёт не Kubernetes, а параметры хранилища: тип тома, задержка, наличие снапшотов, возможность расширения, процедура восстановления. Если на все пять вопросов ответ найден и устраивает — кластер тут ни при чём, работать будет. Если хотя бы один остался без ответа — начинать надо с него, а не с манифеста StatefulSet.
Отдельно и без исключений: пароль БД в манифесте стенда лежит открытым текстом в переменной окружения, потому что это демонстрационное окружение. В любом другом случае секреты выносятся — как именно, разбирается в «Секреты в Kubernetes: Sealed Secrets и External Secrets».
Дальше по серии: числа requests/limits, которые для БД важнее вдвойне, — в статье «Ресурсы в Kubernetes: requests, limits и QoS»; вопрос «куда именно поедет реплика с томом» и как удержать её рядом с нужным узлом — в «Планирование подов вглубь: taints, affinity, topology и приоритеты»; механика контроллера, который всё это сводит к желаемому состоянию, — в «Архитектура Kubernetes: control plane и reconciliation loop» и «Операторы и CRD: расширяем Kubernetes под себя»готовится, с 27 октября; горизонтальное масштабирование, которое для stateful работает совсем не так, как для stateless, — в «Автоскейлинг в Kubernetes: HPA, VPA и KEDA». Если же вопрос стоит шире — нужен ли вообще кластер под вашу задачу, — на него отвечает «Kubernetes для домашней лаборатории», а про вход трафика в кластер есть отдельная статья про API-шлюз.
Источники
- Kubernetes Documentation — StatefulSets, Persistent Volumes, Storage Classes, Volume Snapshots, DNS for Services and Pods
- CSI driver for NFS · Container Storage Interface
- PostgreSQL Documentation — pg_dump, pg_restore
- Стенд:
kubernetes/stateful(Kubernetes 1.36.2, Talos Linux, StorageClassnfs-csi/nfs.csi.k8s.io,busybox:1.37,postgres:18.4)
Комментарии