
Контейнер по умолчанию запускается куда привилегированнее, чем нужно приложению: часто от root, с широким набором capabilities (на этом кластере — 14 штук; это не полный набор ядра, которого набирается за 40, но всё равно куда больше необходимого) и записываемой файловой системой. Доступ к системным вызовам при этом уже урезан: на containerd здесь по умолчанию действует seccomp-профиль (Seccomp: 2 в статусе процесса), так что «ко всем syscalls» дефолт не даёт. Но и того, что даёт, с лихвой хватает, чтобы наделать бед. А поскольку ядро у контейнера общее с хостомСкоро, пробитое приложение в такой конфигурации — это заявка на побег из контейнера. Hardening разворачивает логику: дать процессу минимум прав, урезать всё лишнее и уменьшить площадь атаки заранее. Эта статья собирает воедино то, что обычно раскидано по разным гайдам, в практический чеклист.
Часть серии «Kubernetes на практике». Опирается на внутренности контейнераСкоро (namespaces/capabilities) и смыкается с zero-trustготовится, с 7 января 2027 и supply-chainготовится, с 28 декабря.
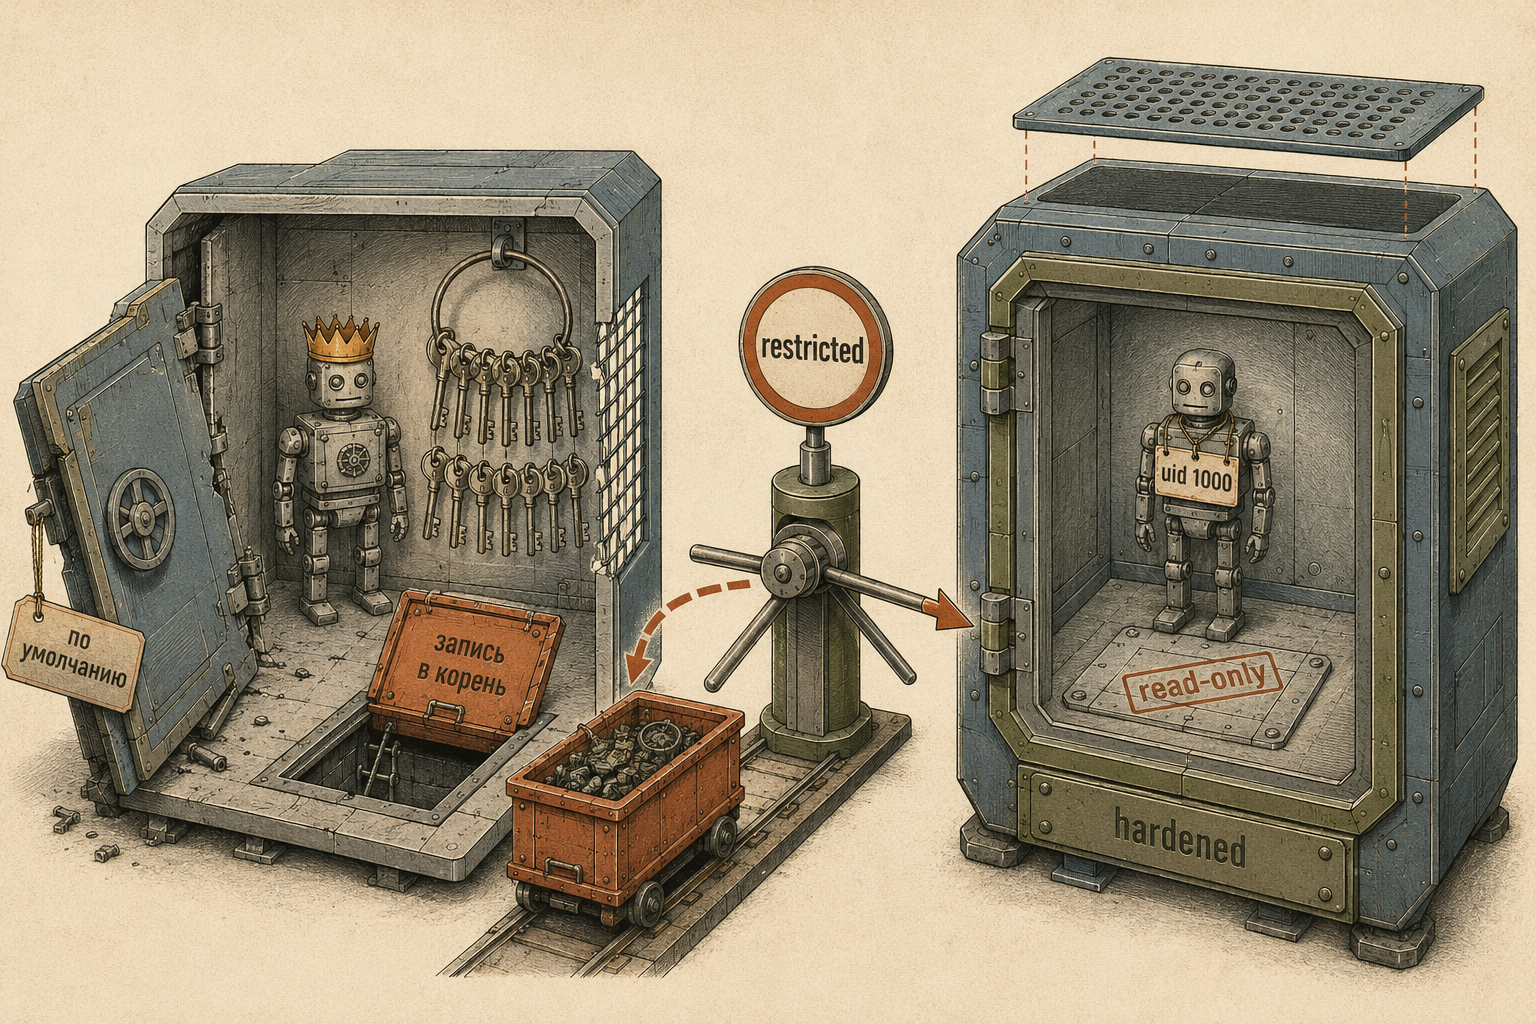
Это десятая и последняя статья серии «Kubernetes на практике». Все наблюдения ниже сняты на живом стенде kubernetes/hardening: Kubernetes v1.36.2 на кластере k8s-volga, узлы Talos v1.13.6 с ядром 6.18.38-talos, среда исполнения containerd 2.2.5. У стенда два своих namespace с разными уровнями Pod Security — cookbook-hardening (enforce: restricted) и cookbook-hardening-baseline (enforce: baseline), — потому что весь материал строится на контрасте: один и тот же под, отклонённый профилем restricted, проходит под baseline. Ни одно число ниже не взято из документации: маски прав и режимы seccomp сняты изнутри подов через /proc, тексты отказов — из вывода kubectl. И сразу честная граница: побег из контейнера здесь не демонстрируется — показаны его права (маски capabilities), а не эксплуатация. На общем живом кластере это осознанное ограничение, а не пробел.
В статье
- Почему дефолт открыт нараспашку
- Security context: контраст в одной таблице
- readOnlyRootFilesystem не ломает, а требует объявить путь
- Pod Security Standards: дословные тексты отказов
- enforce, warn, audit — один профиль, три ключа
- seccomp: фильтр есть даже без профиля
- user namespaces: поле есть, изоляции нет
- Что этот кластер даёт честно
- Hardening-чеклист
- Конец серии: где что смыкается
Почему дефолт открыт нараспашку
Возьмём самый обычный под — образ busybox:1.37, никакого securityContext. В namespace с enforce: baseline он поднимается «как обычно», потому что baseline не требует ни non-root, ни сброса прав. Заглянем внутрь через /proc/self/status:
$ kubectl -n cookbook-hardening-baseline exec default-pod -- id
uid=0(root) gid=0(root) groups=0(root),10(wheel)

$ kubectl -n cookbook-hardening-baseline exec default-pod -- \
    grep -E 'Cap(Eff|Bnd)|NoNewPrivs|Seccomp:' /proc/self/status
CapEff:	00000000a80425fb
CapBnd:	00000000a80425fb
NoNewPrivs:	0
Seccomp:	2
Три вещи здесь стоит прочитать буквально. Процесс идёт от root (uid=0) — как и большинство образов по умолчанию. NoNewPrivs: 0 — процесс может поднять права через setuid-бинарь. А CapEff = 00000000a80425fb — это дефолтная маска capabilities, которую containerd выдаёт контейнеру. Она не «все права» (полный набор ядра был бы 000001ffffffffff), но и далеко не пусто: popcount маски a80425fb равен 14. Часто цитируемое «15 capabilities по умолчанию» — из памяти; фактический разбор битов даёт ровно 14.
В busybox нет capsh, поэтому расшифровку маски привожу как разбор по документации ядра (include/uapi/linux/capability.h), а не как вывод команды — сама маска a80425fb фактическая, из /proc. Из этих 14 прав опаснее всего для сценария «пробили приложение» вот эти:
CAP_SETUID/CAP_SETGID— сменить личность процесса (uid/gid), ключ к смене пользователя;CAP_DAC_OVERRIDE,CAP_CHOWN,CAP_FOWNER— обойти проверки прав на файлы, менять владельца;CAP_NET_RAW— RAW/PACKET-сокеты: не толькоping, но и спуфинг и сниффинг в сети пода.
Остальные в маске — CAP_NET_BIND_SERVICE (порты <1024), CAP_KILL, CAP_SETPCAP, CAP_SETFCAP, CAP_FSETID, CAP_MKNOD, CAP_SYS_CHROOT, CAP_AUDIT_WRITE. И это ещё до записи в файловую систему: touch /testfile в этом поде проходит — корень контейнера открыт на запись.
Почему это важнее, чем кажется: как разобрано во внутренностях контейнераСкоро, ядро у контейнера общее с хостом. Контейнер — это не виртуальная машина со своим ядром, а процесс хоста в наборе namespace с урезанными правами. Поэтому каждое лишнее право, каждый записываемый путь и каждый доступный системный вызов — это площадь атаки не «внутри песочницы», а на границе с узлом. Hardening разворачивает логику: дать процессу минимум и отобрать всё остальное заранее.
Security context: контраст в одной таблице
Тот же образ busybox:1.37, но теперь с усиленным securityContext: runAsNonRoot + runAsUser: 1000, capabilities.drop: ["ALL"], allowPrivilegeEscalation: false, readOnlyRootFilesystem: true, seccompProfile: RuntimeDefault. Это restricted плюс надстройка: сам профиль restricted требует лишь не-root, сброса capabilities, запрета эскалации и seccomp-профиля, а readOnlyRootFilesystem и фиксированный runAsUser: 1000 добавлены здесь вручную сверх профиля (к их роли вернёмся в разделе про PSS и в чеклисте). Тот же кластер, тот же образ — меняется только описание пода. Снимаем те же поля изнутри:
| Показатель | default-pod (baseline) |
hardened-pod (restricted) |
|---|---|---|
uid (id) |
0 (root) |
1000 |
CapEff |
00000000a80425fb — 14 прав |
0000000000000000 — 0 |
CapBnd (bounding set) |
00000000a80425fb |
0000000000000000 |
NoNewPrivs |
0 (можно поднять права) |
1 |
запись в / (touch /testfile) |
разрешена | Read-only file system |
Seccomp |
2 |
2 |
capabilities.drop: ["ALL"] обнуляет маску целиком — и CapEff, и, что важнее, CapBnd (bounding set). Нулевой bounding set означает, что отобранное не вернуть даже setuid-бинарём: право не «временно спрятано», его больше нет в наборе, из которого процесс мог бы его взять. allowPrivilegeEscalation: false даёт NoNewPrivs: 1 — тот же setuid-путь закрыт и на уровне ядра.
Отдельно обратите внимание на последнюю строку: Seccomp: 2 у обоих. Это не опечатка. 2 — это SECCOMP_MODE_FILTER, то есть seccomp-фильтр применён; на дефолтном поде он появился без всякого профиля, потому что узел ставит его сам. К этому вернёмся в разделе про seccomp — а пока достаточно, что hardening здесь не «добавил seccomp», а объявил явно то, что уже было.
readOnlyRootFilesystem не ломает, а требует объявить путь
Самое частое возражение против read-only корня — «оно ломает приложение». На стенде видно, что именно происходит, и почему это не так. Read-only корень не запрещает записывать данные — он требует явно объявить, куда приложение пишет. Типичный кандидат — временный каталог:
# hardened-под, readOnlyRootFilesystem: true
$ kubectl -n cookbook-hardening exec hardened-pod -- sh -c 'echo data > /tmp/cache.dat'
sh: can't create /tmp/cache.dat: Read-only file system
Приложению, кладущему в /tmp кэш, локи или сессии, это мешает — до тех пор, пока путь не объявлен. Штатное решение — смонтировать emptyDir в нужный каталог. Тот же под, плюс emptyDir в /tmp:
$ kubectl -n cookbook-hardening exec hardened-writable -- \
    sh -c 'echo data > /tmp/cache.dat && cat /tmp/cache.dat'
data
# при этом сам корень остаётся закрыт:
$ kubectl -n cookbook-hardening exec hardened-writable -- touch /rootfile
touch: /rootfile: Read-only file system
Разница принципиальная: открыт ровно один объявленный путь, а не вся файловая система. Read-only корень превращает «приложение может писать куда угодно» в «приложение пишет туда, где это разрешено явно» — и заодно заставляет разработчика знать, куда именно его код пишет на диск. Это не потеря функциональности, а её инвентаризация.
Pod Security Standards: дословные тексты отказов
Всё, что выше, — свойства отдельного пода. Но кто заставит команду их выставить? В старом Kubernetes это делала PodSecurityPolicy; её удалили, и замена состоит из двух разных вещей, которые важно не путать. Pod Security Standards (PSS) — это сами наборы требований, три стандартных уровня: privileged (не ограничивает ничего), baseline (базовая гигиена) и restricted (самый строгий из трёх). А применяет их Pod Security Admission (PSA) — встроенный контроллер допуска: он вешается метками на namespace (enforce/audit/warn) и на этапе apply, ещё до записи в etcd, не правит под, а отклоняет тот, что не проходит выбранный уровень. Важная оговорка про restricted: это самый строгий из трёх стандартных уровней, но не весь hardening. Он требует лишь запуска не от root (runAsNonRoot — любой не-root UID), а вот readOnlyRootFilesystem и фиксированный UID он не требует — их добавляют сверх restricted вручную (в hardening-чеклисте ниже они идут отдельными пунктами).
Главная ценность — тексты отказов: admission называет нарушенный пункт дословно и подсказывает фикс. Возьмём четыре пода, каждый нарушает ровно один пункт restricted, и применим их в namespace enforce: restricted:
$ kubectl apply -f manifests/20-psa-violations.yaml -n cookbook-hardening --dry-run=server
pods "run-as-root" is forbidden: violates PodSecurity "restricted:latest": runAsNonRoot != true (pod or container "box" must set securityContext.runAsNonRoot=true)
pods "no-drop-caps" is forbidden: violates PodSecurity "restricted:latest": unrestricted capabilities (container "box" must set securityContext.capabilities.drop=["ALL"])
pods "allow-priv-esc" is forbidden: violates PodSecurity "restricted:latest": allowPrivilegeEscalation != false (container "box" must set securityContext.allowPrivilegeEscalation=false)
pods "no-seccomp" is forbidden: violates PodSecurity "restricted:latest": seccompProfile (pod or container "box" must set securityContext.seccompProfile.type to "RuntimeDefault" or "Localhost")
Каждый отказ содержит и что нарушено (runAsNonRoot != true, unrestricted capabilities, …), и как починить (must set …=…). Это не «под не создался» — это ревью манифеста прямо в ответе apiserver.
Теперь контраст, ради которого у стенда два namespace. Те же четыре пода — но в namespace enforce: baseline:
$ kubectl apply -f manifests/20-psa-violations.yaml -n cookbook-hardening-baseline --dry-run=server
pod/run-as-root created (server dry run)
pod/no-drop-caps created (server dry run)
pod/allow-priv-esc created (server dry run)
pod/no-seccomp created (server dry run)
Все четыре проходят baseline. Root, дефолтные capabilities, отсутствие seccomp-профиля, разрешённое поднятие прав — baseline их не требует. Ровно то, что restricted отверг. Это и есть суть: baseline и restricted проверяют разное. Первая группа нарушений — «мягкая гигиена» самого пода, и её спрашивает только restricted.
Вторая группа опаснее — доступ к узлу: hostPath на /, hostNetwork, hostPID, privileged. Здесь важная оговорка о методе: эти признаки никогда не запускались работающим подом. Кластер живой и общий; под с доступом к узлу — это не демонстрация, а инцидент. Они показаны только через kubectl apply --dry-run=server: server-side dry-run прогоняет admission и возвращает вердикт, но ничего не пишет в etcd. Не --dry-run=client — клиентский dry-run admission вообще не запускает. Вот вердикты обоих профилей рядом:
| под | baseline |
restricted |
|---|---|---|
run-as-root |
проходит | отказ: runAsNonRoot != true |
no-drop-caps |
проходит | отказ: unrestricted capabilities |
allow-priv-esc |
проходит | отказ: allowPrivilegeEscalation != false |
no-seccomp |
проходит | отказ: seccompProfile |
host-path |
отказ: hostPath volumes |
отказ: restricted volume types |
host-network |
отказ: host namespaces |
отказ: host namespaces |
host-pid |
отказ: host namespaces |
отказ: host namespaces |
privileged-pod |
отказ: privileged |
отказ: privileged + allowPrivilegeEscalation |
И здесь — фактическая поправка, которую стенд снял живьём вопреки ходовому утверждению. Часто повторяют: «baseline разрешает hostPath, ограничивает его только restricted». На k8s-volga (k8s 1.36.2) это не подтвердилось: hostPath отклоняют оба профиля. Это не версионный квирк — контроль HostPath Volumes у baseline документирован; просто профили формулируют отказ разными правилами:
baseline   : violates PodSecurity "baseline:latest":   hostPath volumes (volume "node-root")
restricted : violates PodSecurity "restricted:latest": restricted volume types (volume "node-root" uses restricted volume type "hostPath")
privileged-pod под restricted ловит сразу два пункта — privileged и allowPrivilegeEscalation != false; последний не задан в манифесте явно, потому что API-валидация запрещает privileged: true вместе с allowPrivilegeEscalation: false. Практический вывод: группа A (гигиена пода) — забота только restricted, группа B (доступ к узлу) — обоих профилей.
Именно на этом стыке серия смыкается с GitOps-статьёй: там разбирается цепочка «чужой коммит с hostPath → ArgoCD применяет его сам → под с доступом к узлу», и держит эту цепочку не RBAC (граница namespace такое не удерживает — hostPath уводит на узел, а не в соседний namespace), а именно метка Pod Security на namespace. GitOps не отменяет Pod Security — он делает её обязательной.
enforce, warn, audit — один профиль, три ключа
У профиля три режима, и они задаются разными метками одного namespace: pod-security.kubernetes.io/enforce, .../warn, .../audit. Один и тот же restricted на разных ключах ведёт себя по-разному.
enforce— жёсткий отказ, под не создаётся. Ровно это выше:Error from server (Forbidden) … violates PodSecurity.warn— под создаётся, ноkubectlпечатает предупреждение. Проверено во временном namespace сenforce=baseline(пускает) +warn=restricted(предупреждает):
$ kubectl apply -f manifests/20-psa-violations.yaml -n cookbook-hardening-warn
Warning: would violate PodSecurity "restricted:latest": runAsNonRoot != true (pod or container "box" must set securityContext.runAsNonRoot=true)
pod/run-as-root created
Тот же текст нарушения, что при enforce, но с приставкой Warning: would violate — и под живёт: enforce=baseline его пустил, warn=restricted лишь просигналил. Это режим для миграции: включаете warn=restricted на namespace, где пока enforce=baseline, и видите будущие отказы, ничего не ломая.
audit— записи честно не сняты, и это стоит проговорить прямо. Аудит на apiserver включён (в его флагах--audit-log-path=/var/log/audit/kube/kube-apiserver.log), значит нарушения пишутся в файл на control-plane узле. Но узлы Talos не дают SSH/node-shell, а файл не отдаётся черезkubectl— это не stdout пода. Прочитать его можно было бы толькоhostPath- илиprivileged-подом на control-plane — ровно тем, что стенд отказывается создавать. Поэтому audit-записи не показаны и не выдуманы; продемонстрированы только enforce (отказ) и warn (предупреждение). Кластер без SSH к узлам собран в «Четыре отказа при bootstrap на Talos» — там же, почему доступа к файлам узла нет by design.
seccomp: фильтр есть даже без профиля
Вернёмся к загадке из таблицы контраста — Seccomp: 2 у пода без всякого профиля. seccomp ограничивает набор системных вызовов, доступных процессу; RuntimeDefault — профиль от среды исполнения, отсекающий редкие и опасные syscalls. Три режима на одном образе busybox, у всех сброшены caps и закрыта эскалация — различается только профиль:
| под | seccompProfile |
namespace | Seccomp |
|---|---|---|---|
seccomp-default |
не задан | baseline | 2 — узел ставит фильтр по умолчанию (SeccompDefault) |
seccomp-runtimedefault |
RuntimeDefault |
baseline | 2 — тот же фильтр, объявлен явно |
seccomp-unconfined |
Unconfined |
privileged | 0, Seccomp_filters: 0 — фильтра нет |
Seccomp: 2 без профиля — это SeccompDefault, включённый на kubelet узла: «нет профиля» здесь не значит «нет фильтра». Явный RuntimeDefault лишь фиксирует в манифесте то, что узел ставит и так. А Unconfined фильтр снимает — но не в любом namespace. На кластере включён cluster-wide PodSecurity default = baseline: даже namespace без PSA-меток применяет baseline:latest, а baseline запрещает Unconfined. Поэтому в непомеченном, baseline- или restricted-namespace под с seccompProfile: Unconfined отклоняется:
$ kubectl -n default apply --dry-run=server -f - <<'YAML'
apiVersion: v1
kind: Pod
metadata: {name: unconf-probe}
spec:
  restartPolicy: Never
  securityContext: {seccompProfile: {type: Unconfined}}
  containers: [{name: box, image: busybox:1.37, command: ["sleep","3600"], securityContext: {allowPrivilegeEscalation: false, capabilities: {drop: ["ALL"]}}}]
YAML
pods "unconf-probe" is forbidden: violates PodSecurity "baseline:latest": seccompProfile (pod must not set securityContext.seccompProfile.type to "Unconfined")
Снять фильтр всё-таки можно — но для этого namespace надо явно опустить до privileged (PSA штатно позволяет объявить уровень слабее дефолта). В таком временном namespace enforce=privileged тот же под изнутри показывает Seccomp: 0, Seccomp_filters: 0. То есть «Seccomp: 0 недостижим» — неверно: он достижим, просто требует явной метки enforce=privileged, а не отсутствия метки.
Но сам факт «фильтр применён» (Seccomp: 2) ещё не доказывает, что он что-то блокирует. Это доказывается изоляцией. Нужен системный вызов, который: (1) не требует никакой capability — иначе EPERM даст сброс прав, а не seccomp; (2) в дефолтном профиле containerd/moby запрещён. Такой вызов — get_mempolicy(2) (x86_64 syscall № 239). swapon(2) для этой цели не годится: он cap-gated и вернёт EPERM с обеих сторон, ничего не доказав. Берём два пода python:3.13-alpine в одном privileged-namespace, у обоих caps пустые (CapEff: 0, CapBnd: 0), различается только профиль — RuntimeDefault (Seccomp: 2) против Unconfined (Seccomp: 0):
$ PY='import ctypes,os; l=ctypes.CDLL(None,use_errno=True); m=ctypes.c_int(-1); ctypes.set_errno(0); r=l.syscall(239,ctypes.byref(m),None,0,None,0); e=ctypes.get_errno(); print("get_mempolicy(NR=239) ret=%d errno=%d(%s) mode=%d"%(r,e,(os.strerror(e) if e else "OK"),m.value))'
# под RuntimeDefault (Seccomp: 2):
$ kubectl -n cookbook-hardening-privileged exec syscall-runtimedefault -- python3 -c "$PY"
get_mempolicy(NR=239) ret=-1 errno=1(Operation not permitted) mode=-1
# под Unconfined (Seccomp: 0), тот же образ, те же пустые caps:
$ kubectl -n cookbook-hardening-privileged exec syscall-unconfined -- python3 -c "$PY"
get_mempolicy(NR=239) ret=0 errno=0(OK) mode=0
Изоляция доказана. Под Unconfined тот же вызов с теми же пустыми caps проходит (ret=0) — значит capability для него не нужна. Следовательно EPERM под RuntimeDefault даёт не отсутствие права, а seccomp-фильтр: единственная отличающаяся переменная — профиль. Это и есть вызов, заблокированный именно seccomp, отдельно от capabilities. Тонкое перераспределение того, какие syscalls вообще нужны сетевому приложению, смыкается с сетью в Kubernetes, а обнаружение аномального поведения в рантайме через eBPF — с eBPF в безопасности.
user namespaces: поле есть, изоляции нет
Идеальное усиление изоляции — user namespaces: root внутри контейнера маппится на непривилегированного пользователя на узле, так что uid 0 в поде — это условный uid 100000 снаружи. В внутренностях контейнераСкоро это разобрано на уровне Docker; в Kubernetes за это отвечает поле pod.spec.hostUsers: false. И вот здесь стенд честно упирается в границу кластера.
Поле в API 1.36 есть, admission под с hostUsers: false пропускает — но узел создать user namespace не может. Под виснет в ContainerCreating, событие FailedCreatePodSandBox:
$ kubectl -n cookbook-hardening-baseline get events \
    --field-selector involvedObject.name=userns-pod,reason=FailedCreatePodSandBox \
    -o jsonpath='{range .items[*]}{.message}{"\n"}{end}'
Failed to create pod sandbox: rpc error: … failed to start noop process for unshare: fork/exec /proc/self/exe: no space left on device
unshare: … no space left on device — это ENOSPC при попытке создать namespace. Причина снята фактом, а не догадкой:
$ kubectl -n cookbook-hardening-baseline exec seccomp-default -- cat /proc/sys/user/max_user_namespaces
0
# обычный под (hostUsers=true):
$ kubectl -n cookbook-hardening-baseline exec seccomp-default -- cat /proc/self/uid_map
         0          0 4294967295
max_user_namespaces = 0 — ядро запрещает создание user namespace вовсе, отсюда ENOSPC. А обычный под делит user namespace с узлом: uid_map = 0 0 4294967295 — тождественная карта, никакого remap. Показать «uid внутри ≠ uid на узле» на k8s-volga нельзя: hostUsers — это поле API, но на этом кластере (Talos, ядро 6.18.x) фактически неработоспособное. Честный итог: user namespaces — правильное направление, но на этом стенде недоступное; это зафиксировано фактом. Rootless-подход к тому же контуру со стороны Docker — в статье «Rootless Docker».
Что этот кластер даёт честно
Прежде чем сводить чеклист, отделим то, что стенд измерил, от того, чего кластер не даёт. Здесь легко переписать красивый список из гайда — поэтому каждый пункт снят разведкой (только чтение и временные поды), и то, чего нет, названо прямо.
- seccomp — есть и работает. Фильтр применяется даже без профиля (
Seccomp: 2), а изолированныйget_mempolicyдоказывает, что он реально блокирует. Это рабочий инструмент hardening на данном кластере. - AppArmor — на узлах этого кластера выключен. Под с
appArmorProfile: RuntimeDefaultотклоняется kubelet-ом (Cannot enforce AppArmor: AppArmor is not enabled on the host), а изнутри/sys/module/apparmor/parameters/enabled=N: модуль в ядре есть, но выключен. Это ограничение данного кластера, а не утверждение про Talos вообще: раз на узлахenabled = Nи admission отклоняетappArmorProfile, демо AppArmor на этом стенде показать нельзя. - SELinux — включён, но режим не измерен. В
/proc/cmdlineестьselinux=1, а процесс пода несёт меткуsystem_u:system_r:pod_t:s0— SELinux активен и маркирует поды. Но режим (enforcing/permissive) изнутри пода не читается:selinuxfsв контейнер не смонтирован, а к узлу Talos нетtalosctl. Факт включения снят, режим — нет; утверждатьenforcingбыло бы домыслом. - user namespaces — не поддержаны (
max_user_namespaces = 0, см. выше).
Итог: seccomp — рабочий рубеж этого кластера; AppArmor и user namespaces недоступны; SELinux включён, но его режим честно не измерен. Runtime-детект (eBPF/Falco) как последний рубеж — уже за рамками стенда; про eBPF-контур — в отдельной статье.
Hardening-чеклист
Минимальный набор для контейнера — каждый пункт которого стенд измерил, а не переписал из гайда:
Настройка securityContext / PSA |
Что даёт (замер стенда) |
|---|---|
runAsNonRoot: true |
требует профиль restricted: процесс не root — любой не-root uid против uid=0(root) у дефолтного пода |
capabilities.drop: ["ALL"] |
маска обнуляется целиком: CapEff a80425fb (14 прав) → 0, вместе с CapBnd — отобранное не вернуть |
allowPrivilegeEscalation: false |
NoNewPrivs: 0 → 1 — setuid-бинарь больше не поднимет права |
readOnlyRootFilesystem: true (+ emptyDir для записи) |
сверх профиля restricted: корень только на чтение (touch / → Read-only file system); запись открыта ровно в один объявленный путь |
runAsUser: 1000 (фиксированный UID) |
сверх профиля restricted: конкретный не-root UID вместо «любого не-root», которого достаточно для самого restricted |
seccompProfile: RuntimeDefault |
seccomp-фильтр объявлен явно (Seccomp: 2); изолированный get_mempolicy под ним → EPERM, под Unconfined с теми же пустыми caps → OK |
namespace enforce: restricted (PSA) |
admission отклоняет до запуска то, что нарушает профиль restricted (не-root, сброс caps, запрет эскалации, seccomp-профиль), и называет пункт дословно (runAsNonRoot != true, unrestricted capabilities, …); readOnlyRootFilesystem и фиксированный UID из строк выше сам профиль не требует |
| минимум монтирований (в т.ч. секретов) | read-only корень заставляет декларировать каждый путь записи; минимизацию именно секрет-монтирований подробно разбирает статья про секреты |
Набор не «максимальный», а именно минимальный: он не защищает от уязвимости в ядре и не заменяет user namespaces (которых здесь нет). Но он резко уменьшает blast radius пробитого контейнера — от «root с 14 правами и записываемым корнем» до «непривилегированный процесс с пустой маской, read-only корнем и seccomp-фильтром, который admission не пустил бы иначе».
Конец серии: где что смыкается
Это последняя, десятая статья серии «Kubernetes на практике» — и здесь её линии сходятся. Изоляция контейнера, о которой шла речь, стоит на namespaces и capabilities из внутренностей контейнераСкоро; она смыкается с сетевым периметром — zero-trust и NetworkPolicyготовится, с 7 января 2027 — и с доверием к тому, что вообще попадает в кластер, — supply-chain, SBOM и подписи образовготовится, с 28 декабря. Право на запись в репозиторий как право в кластер и роль Pod Security в этой цепочке разобраны в GitOps-статье.
Остальная серия — фундамент, на который ложится hardening: архитектура control plane и ресурсы, requests/limits и QoS, автоскейлинг, stateful-нагрузки и хранилище, секреты, планирование подов и операторы и CRD. Кластер, на котором всё это снято, — «Четыре отказа при bootstrap на Talos»; входящий трафик к hardened-подам — Gateway API; а нужен ли кластер вообще — «Kubernetes для домашней лаборатории».
Источники
- Kubernetes Documentation — Pod Security Standards, Pod Security Admission, Security Context для пода/контейнера, seccomp через Kubernetes, user namespaces
- Linux kernel —
capabilities(7),seccomp(2),user_namespaces(7),get_mempolicy(2) - containerd default seccomp profile
- Стенд:
kubernetes/hardening(Kubernetesv1.36.2, k8s-volga; узлы Talosv1.13.6, ядро6.18.38-talos,containerd 2.2.5)

Обсуждение в Telegram
Присоединиться →