
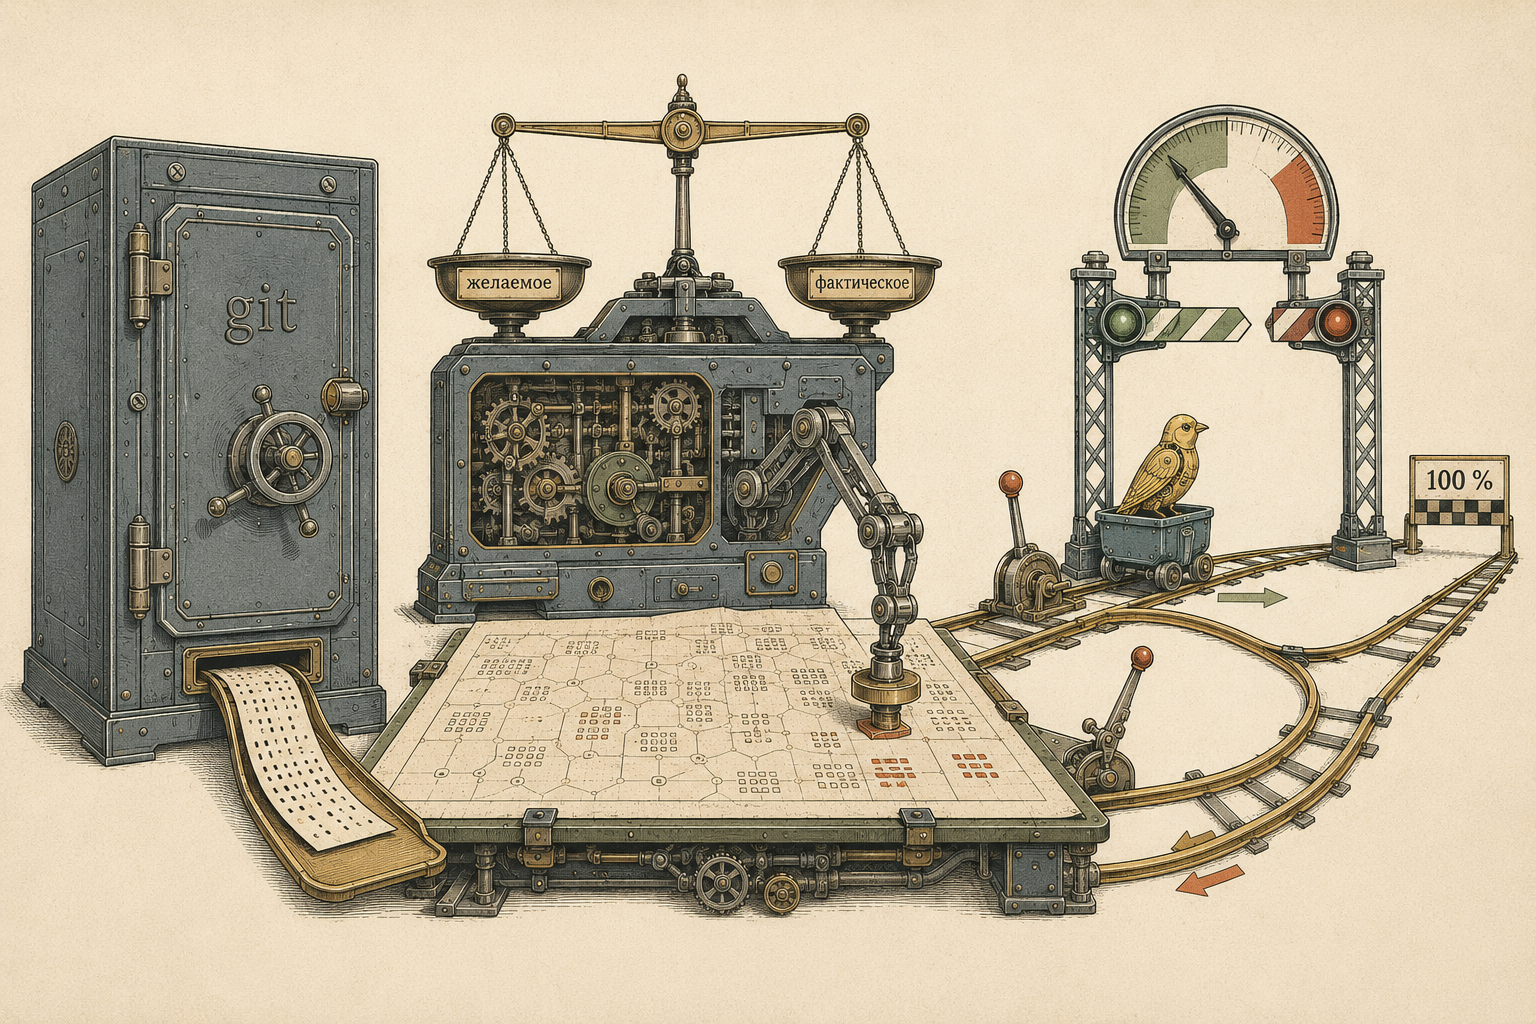
GitOps — это простое обещание: то, что в git, и есть то, что в кластере, а расхождения автоматически устраняются. ArgoCD реализует это обещание, непрерывно сравнивая желаемое (манифесты в репозитории) с фактическим (объекты в кластере). Поверх этого строится progressive delivery: не «выкатил всё и молись», а постепенная раскатка с анализом метрик и автоматическим откатом. Разберём ArgoCD от Applications до canary и blue-green через Argo Rollouts.
Это девятая статья серии «Kubernetes на практике». Она связывает несколько её линий: reconcile-модель из статьи об операторах здесь работает на уровне всего кластера, а секреты из седьмой статьи едут по тому же GitOps-конвейеру. Все наблюдения ниже сняты на живом стенде kubernetes/gitops: Kubernetes v1.36.2 на кластере k8s-volga, отдельный namespace cookbook-argocd, собственный ArgoCD v3.4.1 со своим источником правды — git-сервером, поднятым тут же, в кластере. Ни одного числа ниже не взято из документации: всё снято с отметками времени на этом стенде.
В статье
- GitOps: git как источник правды, а не push из CI
- Application: два конца конвейера
- «Namespace-scoped» — это два решения, а не одно
- Право на запись в кластер, отложенное во времени
- Self-heal: замер возврата и растущий backoff
- Чего self-heal не чинит
- Prune: цена удаления файла из git
- App-of-apps и три исхода при удалении корневого
- Canary с анализом метрик и автоматическим откатом
- Blue-green — честно
- Ограничения стенда
GitOps: git как источник правды, а не push из CI
GitOps переворачивает привычную доставку. В модели «push из CI» пайплайн сам ходит в кластер и делает kubectl apply — кластер пассивен, а право менять его лежит у того, кто держит доступ к CI. GitOps убирает этот apply наружу: желаемое состояние целиком описано манифестами в git, а внутри кластера живёт агент, который непрерывно сравнивает git с тем, что реально запущено, и устраняет разницу сам. Git становится единственным источником правды, а выкатка — не командой, а фактом появления коммита.
Это ровно та же reconcile-модель, что лежит в основе операторов: и оператор из восьмой статьи, и встроенные контроллеры control plane из статьи об архитектуре кластера делают одно — сравнивают desired и actual и сводят одно к другому. ArgoCD берёт эту петлю и растягивает её на весь кластер: desired лежит в репозитории, actual — это объекты в etcd, а расхождение между ними и есть предмет работы. Поэтому «выкатил и молись» здесь неуместно по построению: состояние не выталкивается разово, оно поддерживается.
На стенде источник правды — git-сервер, поднятый внутри того же namespace (git://git-server.cookbook-argocd.svc.cluster.local/demo.git). Это осознанное упрощение ради герметичности: стенд разворачивается одной командой, без аккаунта на хостинге, токена и deploy-ключа. В проде требование к источнику другое — не «внешний» как таковой (репозиторий может быть и self-hosted, вплоть до отдельного инфраструктурного кластера), а независимо восстанавливаемый и долговечный: с ревью, защитой веток, резервированием и отдельной от рабочего кластера моделью доступа. Одноразовый git внутри самого стенда — упрощение, а не образец; к чему обязывает настоящий источник правды, разберём ниже в разделе про эскалацию. Репозиторий стенда отдаёт ровно два файла и держит один seed-коммит d049270d788de26273d85992c271c5994a6d7ca8 — на этот хеш будут ссылаться все дальнейшие замеры, поэтому он сделан воспроизводимым (метки времени коммита прибиты, иначе SHA-1 плыл бы при каждом пересоздании пода).
Application: два конца конвейера
Application — центральный объект ArgoCD, и читать его проще всего как трубу с двумя концами. На одном конце source: откуда брать желаемое — репозиторий, путь внутри него и ревизия. На другом destination: куда класть результат — кластер и namespace. Всё, что ArgoCD делает, — тянет манифесты из source, рендерит (plain YAML, Helm или kustomize) и приводит destination к тому, что получилось.
Первый Application на стенде создаётся без syncPolicy — в ручном режиме. ArgoCD читает репозиторий, видит, что объектов ещё нет, и честно не делает ничего:
$ kubectl -n cookbook-argocd get application demo
NAME   SYNC STATUS   HEALTH STATUS
demo   OutOfSync     Missing

$ kubectl -n cookbook-argocd get application demo -o jsonpath='{"sync.revision = "}{.status.sync.revision}{"\n"}'
sync.revision = d049270d788de26273d85992c271c5994a6d7ca8
$ kubectl -n cookbook-argocd get application demo -o jsonpath=\
'{range .status.resources[*]}{.group}/{.version}  {.kind}/{.name} -> {.status}{"\n"}{end}'
/v1      Service/demo    -> OutOfSync
apps/v1  Deployment/demo -> OutOfSync
Обратите внимание: ревизию d049270… он знает уже здесь, до всякого sync, — это тот самый seed-коммит, который отдаёт наш git-сервер. Запускаем синхронизацию (в UI это кнопка Sync, здесь — правка поля operation), и за секунду (startedAt 16:14:56 → finishedAt 16:14:57) картина меняется:
$ kubectl -n cookbook-argocd get application demo
NAME   SYNC STATUS   HEALTH STATUS
demo   Synced        Healthy

$ kubectl -n cookbook-argocd get application demo -o jsonpath=\
'{"operation.phase    = "}{.status.operationState.phase}{"\n"}'\
'{"operation.revision = "}{.status.operationState.operation.sync.revision}{"\n"}'\
'{"synced revision    = "}{.status.operationState.syncResult.revision}{"\n"}'\
'{range .status.operationState.syncResult.resources[*]}'\
'{.kind}/{.name}  status={.status}  message={.message}{"\n"}{end}'
operation.phase    = Succeeded
operation.revision = HEAD                                        <- о чём просили
synced revision    = d049270d788de26273d85992c271c5994a6d7ca8    <- что применилось
Service/demo     status=Synced  message=service/demo created
Deployment/demo  status=Synced  message=deployment.apps/demo created
Здесь два конца трубы сходятся в одну проверяемую точку. Просили синхронизировать HEAD, а применилась ревизия d049270…, совпадающая с хешем, который отдаёт git-сервер, — это и есть доказательство, что источником правды был именно репозиторий, а не что-то ещё. Namespace объектам в git никто не прописывал — его подставил destination.namespace. А принадлежность ArgoCD помечает не меткой на объекте, а аннотацией argocd.argoproj.io/tracking-id: demo:apps/Deployment:cookbook-argocd/demo — эта деталь окажется важной дальше: именно по tracking-id, а не по ownerReferences, ArgoCD понимает, «кто чей».
«Namespace-scoped» — это два решения, а не одно
Дальше начинается практический материал, который легко проскочить, приняв за одно решение то, что на деле является двумя независимыми. Стенд ставит собственный ArgoCD в общий кластер, где уже работает боевой ArgoCD, и «сделать его namespace-scoped» здесь распадается на две ортогональные задачи.
Решение первое — RBAC. Права контроллеру выданы через Role/RoleBinding в своём namespace, а не через ClusterRole. Граница проходит не по глаголам (GitOps-контроллер обязан уметь создавать произвольные типы — состав манифестов в git заранее неизвестен, поэтому звёздочки в правах остаются), а по namespace, и она проверяемая:
$ kubectl auth can-i <verb> <res> -n <ns> \
    --as=system:serviceaccount:cookbook-argocd:argocd-application-controller
can-i list deployments   -n cookbook-argocd : yes
can-i create deployments -n cookbook-argocd : yes
can-i list deployments   -n argocd          : no
can-i list deployments   -n kube-system     : no
can-i list nodes (кластерный ресурс)        : no
can-i list applications  -n argocd          : no
Решение второе — область наблюдения. Отдельный cluster-scope-секрет описывает контроллеру кластер как namespaces: cookbook-argocd, clusterResources: "false" — то есть сужает кэш, который контроллер строит на старте. Без этого второго решения установка запускается, но не работает: контроллер по умолчанию считает себя хозяином кластера, на старте строит кэш всех типов, включая кластерные, и спотыкается о первый же чужой CRD. Первый Application встаёт в Unknown:
$ kubectl -n cookbook-argocd get application demo -o jsonpath='{.status.conditions[0].message}'
Failed to load live state: ... failed to sync cluster https://10.96.0.1:443: failed to load
initial state of resource ClusterTriggerAuthentication.keda.sh: failed to list resources:
clustertriggerauthentications.keda.sh is forbidden: User
"system:serviceaccount:cookbook-argocd:argocd-application-controller" cannot list resource
"clustertriggerauthentications" in API group "keda.sh" at the cluster scope
Ключевое: штатный namespace-install.yaml даёт только первое решение — ограничивает RBAC. Второе (сужение кэша) в него не входит, и без него namespace-scoped-установка в общем кластере не поднимается. Одного из двух решений недостаточно.
Отдельная деталь, которую полезно знать до того, как раздавать звёздочки: «GitOps-контроллеру нужна звёздочка ["*"]/["*"]/["*"]» верно ровно для одного компонента из трёх. Контроллеру — да, он применяет произвольные манифесты. А argocd-server живое состояние берёт из кэша контроллера и к API ходит только за действиями из UI и CLI, поэтому его апстримная роль по */* даёт не всё, а ровно delete,get,patch — без create и update:
$ kubectl auth can-i <verb> deployments -n cookbook-argocd \
    --as=system:serviceaccount:cookbook-argocd:<sa>
                       controller   server
create deployments   : yes          no
update deployments   : yes          no
delete deployments   : yes          yes
get    deployments   : yes          yes
patch  deployments   : yes          yes
Работоспособность узкой роли сервера проверена не только на can-i: argocd app get, argocd app logs и argocd app actions run demo restart через сервер проходят, Application остаётся Synced/Healthy, forbidden в логах — ноль.
Право на запись в кластер, отложенное во времени
Прежде чем включать автоматику, стоит разобрать одну цепочку — потому что включённая автоматика её замыкает. Git-сервер стенда поднят с --enable=receive-pack, а у протокола git:// нет ни аутентификации, ни авторизации: push принимает любой, кто дотянулся до порта 9418. А дотянуться до закрытия сети мог любой под кластера: семь NetworkPolicy из штатной установки ArgoCD селектят только его собственные поды, git-сервер не попадал ни под одну, а под, не выбранный ни одной политикой, в Kubernetes открыт всем.
Дальше складывается так:
любой под кластера → push в наш git → манифест с hostPath или privileged
                   → ArgoCD применяет его сам → под с доступом к узлу
В ручном режиме цепочка рвётся посередине: между чужим коммитом и подом стоит человек, нажимающий Sync. Включаем automated + selfHeal — и она не рвётся уже нигде. ArgoCD здесь ни при чём: он честно делает ровно то, что ему поручено, — приводит кластер к состоянию из git. Вот формула, которую стоит забрать целиком: источник правды GitOps — это право на запись в кластер, отложенное во времени. Права на репозиторий и права в кластере — одна и та же величина, просто вторая проявляется позже.
Важный нюанс про границы: ограничение прав ArgoCD одним namespace эту цепочку не рвёт. hostPath и privileged — выход не «в другой namespace», а за пределы namespace вообще, на узел; namespace-граница RBAC такое не держит. Держит её Pod Security. Поэтому замка на стенде два, и они на разных звеньях:
NetworkPolicyрешает, кто может запушить. Проверено обоими направлениями: клон из своего namespacecookbook-argocd—0.10 s,rc=0; клон из соседнегоcookbook-k8s— 30 s тишины иrc=15по таймауту.- Метка
pod-security.kubernetes.io/enforce: baselineна namespace решает, что будет, если всё-таки запушил. Под сhostPath: /иprivileged: trueв этом namespace теперь не создаётся вовсе — отказ приходит от admission, а значит, придёт и контроллеру ArgoCD, когда тот попробует применить такой манифест из git:
$ kubectl -n cookbook-argocd run psa-probe --image=alpine/git:v2.49.1 --restart=Never \
    --overrides='{"spec":{
      "volumes":[{"name":"hostroot","hostPath":{"path":"/"}}],
      "containers":[{"name":"probe","image":"alpine/git:v2.49.1",
        "securityContext":{"privileged":true},
        "volumeMounts":[{"name":"hostroot","mountPath":"/host"}]}]}}'
Error from server (Forbidden): pods "psa-probe" is forbidden:
violates PodSecurity "baseline:latest": hostPath volumes (volume "hostroot"),
privileged (container "probe" must not set securityContext.privileged=true)
Для читателя, у которого репозиторий внешний, вывод переносится буквально: доступ на запись в репозиторий, с которого синхронизируется кластер, стоит считать доступом в кластер — со всеми вытекающими про ревью, защиту веток и подпись коммитов. Тема полностью раскрывается в статье про hardeningготовится, с 3 ноября; здесь важно, что GitOps не отменяет Pod Security, а делает её обязательной.
Self-heal: замер возврата и растущий backoff
Первый sync — самое скучное, что есть в GitOps. Интересное начинается после, когда кластер живёт: его правят руками, из репозитория удаляют файлы. Режим сведения включается правкой того же манифеста Application — то есть тоже декларативно:
syncPolicy:
  automated:
    prune: true
    selfHeal: true
Сразу оговорка про таймауты: у этого экземпляра timeout.reconciliation не задан, сверяться с документацией нельзя — значения надо снять. Их печатает сам бинарник при старте: appResyncPeriod=2m0s, appResyncJitter=1m0s. Параметры backoff self-heal — база 2 s, множитель 3, потолок 300 s.
Правим Deployment demo руками — replicas с 1 на 3. Возврат приходит быстро:
17:07:27.775  (часы хоста)    kubectl scale deploy/demo --replicas=3
17:07:29      (часы кластера)  Initiated automated sync to 'd049270d…', SelfHealAttemptsCount:1
17:07:29      (часы кластера)  Applying resource Deployment/demo → configured (duration 0.486 s)
17:07:29.349  (часы хоста)     первое наблюдение spec.replicas=1
17:07:29.349 − 17:07:27.775 = 1.574 s — около 1.6 секунды, и это верхняя граница (цикл наблюдения ходит раз в ~1.2 s, сам apply по логу занял 0.486 s). Две вещи здесь стоит зафиксировать. Первая: ревизия та же, d049270…, — синхронизацию вызвал дрейф внутри кластера, а не новый коммит. Расхождение внутри кластера контроллер видит через watch и реагирует за секунды; это принципиально другой путь, чем обнаружение новой ревизии в git (о нём — следующий раздел). Вторая: SelfHealAttemptsCount:1, и паузы перед этой попыткой не было — backoff отсчитывается от предыдущей попытки, а её не существовало.
Вот где кроется распространённое заблуждение «ArgoCD откатывает правку за пару секунд». Оно верно ровно один раз. Пауза назначается после попытки и придерживает следующую по правилу: после попытки self-heal номер N контроллер выдерживает 2 × 3^(N−1) секунд (но не больше 300) и только потом разрешает попытку N+1. Правим один и тот же объект раз за разом:
| попытка | требовалось выждать | замер возврата |
|---|---|---|
| 1 | ничего: предыдущей попытки нет | 1.6 s |
| 2 | 2 s — пауза после попытки 1 | 1.4 s |
| 3 | 6 s — пауза после попытки 2 | 1.4 s |
| 4 | 18 s — пауза после попытки 3 | 1.6 s |
| 5 | 54 s — пауза после попытки 4 | 54.4 s ← ждали по-настоящему |
| 6 | 162 s — пауза после попытки 5 | 35.8 s ← правка попала в середину паузы |
Потолок 300 s тоже не взят из справки, а показан в работе. Формула для паузы после шестой попытки требует 2 × 3⁵ = 486 s, а контроллер напечатал остаток retrying in 4m59.4s — то есть 299.4 s, упёршись в потолок. Практический вывод: если один и тот же объект правят раз за разом (руками или другим контроллером — HPA из статьи про автоскейлинг умеет ровно это), окно, в котором кластер живёт с чужим состоянием, растёт как 2 → 6 → 18 → 54 → 162 s и упирается в пять минут. Пять минут расхождения self-heal уже не назвать.
Чего self-heal не чинит
Теперь опасная асимметрия. Делаем четыре правки одновременно, чтобы разница была видна в одном и том же проходе self-heal:
| что изменили | что стало |
|---|---|
spec.replicas 1 → 2 — поле объявлено в git |
откатилось |
метка drift-probe=manual на Deployment demo — поля в git нет |
осталась |
аннотация drift-probe=manual там же |
осталась |
ConfigMap manual-not-in-git, созданный руками рядом |
остался, хотя prune: true |
И при всём этом Application показывает Synced. То есть diff у ArgoCD — это не «объект в кластере равен объекту в git», а «всё объявленное в git присутствует в кластере в этом виде». Лишнее в живом объекте в сравнение не входит, а prune удаляет только то, что было в git и оттуда пропало; «не было никогда» — это другое.
Свойство двоякое, и обе стороны важны. Хорошая: ровно на нём держится совместимость с чужими контроллерами — HPA правит replicas, service mesh дописывает аннотации, admission-вебхуки навешивают метки, и всё это выживает, потому что в git не объявлено. Опасная: расхожая формулировка «GitOps гарантирует, что в кластере то же, что в git» — неверна. Гарантия ровно одна: в кластере есть то, что в git. Чего в git нет — не гарантируется ничего, включая целые объекты в том же namespace. «Всё объявленное в git присутствует в кластере» и «всё в namespace описано в git» — разные утверждения, и self-heal обеспечивает только первое.
Prune: цена удаления файла из git
Отдельный сюжет — что происходит, когда файл из репозитория удаляют. Коммит, убирающий apps/demo/service.yaml, делается из пода внутри cookbook-argocd (иначе NetworkPolicy не пустит к git-серверу), даты прибиты — хеш 41e857605e9bf396f20966470d0dea259c4336b4:
17:21:24.905  push коммита 41e8576                                       (часы пода)
17:23:25      Refreshing app status (comparison expired, expiry: 2m0s)
17:23:25      Initiated automated sync to '41e857605e…'
17:23:25      Service/demo → status 'Pruned' (sync занял 0.487 s)         (часы кластера)
~120.6 секунды, из которых собственно работы — 0.487 s. Остальные две минуты — ожидание опроса. И здесь критично не спутать два числа: ~120.6 s — по логу (push и sync), а 121.8 s — верхняя граница по наблюдению (момент, когда цикл впервые заметил пропажу; шаг цикла 3.5 s). Часы хоста и кластера расходятся на +1.53 s, и в наблюдательное число поправка уже внесена — без неё та же верхняя граница читалась бы как 120.3 s (число по логу в поправке не нуждается, оно целиком снято часами кластера).
Соблазн сказать «значит, задержка равна timeout.reconciliation = 2 минуты» — неверен дважды. Во-первых, коммит попадает в случайную точку цикла. Во-вторых, фактическая длина цикла у ненастроенного экземпляра вовсе не «2 минуты»: двадцать подряд идущих плановых сверок дали интервалы
$ kubectl -n cookbook-argocd logs argocd-application-controller-0 \
    | grep 'comparison expired' | grep -oE '"time":"[^"]+"' | head -20
# интервалы между соседними метками времени, в секундах:
+271 +192 +171 +225 +229 +259 +211 +125 +146 +192
+403 +243 +217 +132 +239 +259 +174 +249 +282   (секунды)
— от 125 до 403 секунд при настройке 2m0s + джиттер 1m0s. Наши ~120.6 s — удачный жребий, а не константа. И вот ключевое различие, которое надо унести: опрос репозитория и реакция на дрейф — разные пути. Новую ревизию уже синхронизированного Application контроллер узнаёт только по опросу (эти самые 125…403 s), а расхождение внутри кластера — через watch, за секунды. В проде этот опрос будит webhook от хостинга репозитория; он не ускоряет ArgoCD, а будит его — на стенде тот же эффект дал принудительный refresh, вернувший объект за меньше секунды вместо ожидания опроса.
И prune не бесплатен. После удаления и возврата Service demo — это другой Service:
было   10.105.220.154
стало  10.97.138.219
ClusterIP сменился. Удалить манифест из git и вернуть обратно — это не «ничего не изменилось»: для Service это потерянный адрес (и все, кто закешировал его вместо DNS-имени), для PVC — потерянный том, для Secret — пересозданный секрет. Поэтому prune: true в проде обычно ходит в паре с аннотацией argocd.argoproj.io/sync-options: Prune=false на объектах, потеря которых необратима. Важная оговорка, которая понадобится дальше: Prune=false закрывает объект только от прунинга при синхронизации — от случая «файл пропал из git». От удаления объекта вместе с самим Application он не защищает.
App-of-apps и три исхода при удалении корневого
Паттерн app-of-apps описывает целый набор приложений одним объектом: корневой Application смотрит не на каталог с Deployment, а на каталог с другими Application. Руками применяется ровно один объект — root; дочерние приезжают из git (коммит da7ecdf):
Application root  path: apps/children
  ├── Application child-a  (файл в git) → Deployment payload-a
  └── Application child-b  (файл в git) → Deployment payload-b
Раскатка заняла ~3.1 s, и аннотация refresh не применялась ни разу. Это не противоречит ~120.6 s из раздела про prune: там ждали обнаружения новой ревизии уже синхронизированного приложения, а здесь и корневой, и дочерние — новые объекты, контроллер получает их появление watch-событием за секунды. Разрыв виден в одном и том же выводе: через 3.1 s после apply три новых Application уже Synced/Healthy на ревизии da7ecdf, а соседнее demo, синхронизированное раньше, в том же выводе всё ещё стоит на старом d049270 — новую ревизию для него контроллер подхватит только с опросом.
Самое важное на практике — что случится, когда корневой удалят. Связь «кто чей» существует только внутри ArgoCD: ownerReferences пусты на всех уровнях, родство несёт аннотация tracking-id, а сборщик мусора Kubernetes про неё не знает. Финалайзер resources-finalizer.argocd.argoproj.io ArgoCD сам не навешивает — он попадает в объект, только если его написали в манифесте. Отсюда три исхода, снятые замерами:
| финалайзер стоит | корневой | дочерние Application |
полезная нагрузка |
|---|---|---|---|
| нигде (по умолчанию) | удалён, 0.9 s | остались работать | осталась работать |
| только на корневом | удалён, 0.9 s | удалены, 1.0 / 1.1 s | осталась работать |
| на всех уровнях | удалён, 2.4 s | удалены, 1.5 / 2.5 s | удалена, 1.6 / 1.7 s |
По умолчанию удаляется ровно один объект — тот, который удалили. Дочерние осиротели, но остались живы: 150 s наблюдения — ноль изменений, а осиротевший дочерний Application продолжает работать полноценно (ручной scale на его нагрузке был откачен self-heal за 0.6 s — контроллер его по-прежнему обслуживает). Финалайзер только на корневом обрывает каскад на первом уровне: дочерние Application удаляются, а их нагрузка — нет. Сквозной каскад даёт только финалайзер на всех уровнях. Вывод для прода: каскад — свойство не паттерна app-of-apps, а финалайзера, и идёт ровно на ту глубину, на которую тот проставлен. Фраза «удалил корневой — удалилось приложение» по умолчанию неверна.
Обратная задача — закрыть от каскада отдельный объект (PVC, Secret, базу). Здесь легко ошибиться опцией, и стенд эту ошибку ловит замером. Кандидатов два, и они про разные сценарии: Prune=false отменяет удаление при синхронизации (файл пропал из git), Delete=false — при каскадном удалении самого Application. Проверено на одном каскаде, по одному помеченному объекту в прогоне:
| прогон | payload-a |
payload-b |
что стало |
|---|---|---|---|
| 1 | Delete=false |
не помечен | payload-a пережил каскад (жив через 90 s), payload-b удалён за 1.7 s |
| 2 | не помечен | Prune=false |
удалены оба: 1.7 s и 1.8 s |
Итог однозначный: от каскадного удаления закрывает Delete=false, а не Prune=false — вторая опция про другой сценарий и здесь бесполезна, помеченный ею объект каскад забрал наравне с непомеченным. И ещё одно, видное только на замере: Delete=false сохраняет объект, а не приложение. У выжившего Deployment аннотация tracking-id по-прежнему указывала на child-a, которого в кластере уже нет, — спасённая база превращается в такую же сироту, и прибирать её потом всё равно руками. Про то, стоит ли вообще отдавать базу под GitOps внутри кластера, — статья про stateful-нагрузки.
Canary с анализом метрик и автоматическим откатом
До сих пор речь шла о том, что GitOps приводит кластер к состоянию из git. Но «привёл» и «выкатил безопасно» — не одно и то же. Обычный Deployment тоже катит постепенно: стратегия по умолчанию RollingUpdate с maxUnavailable: 25% и maxSurge: 25% меняет поды пачками, а не все разом. Но Deployment смотрит только на readiness подов — он не умеет ни резать трафик долями, ни поставить паузу на анализ, ни откатиться сам по метрике: плохая версия проходит readiness, встаёт под трафик и остаётся там, пока кто-то не заметит и не откатит руками. Progressive delivery добавляет остальное: пошаговое продвижение версии с паузами между шагами, ворота анализа метрик и — главное — решение «продолжать или откатывать» принимает не человек, а сам контроллер (автоматический abort по результату анализа). Точное разделение трафика по долям, не зависящее от числа реплик, — отдельная возможность, для неё нужен traffic-router (ingress или mesh); с обычным Service разделение уже есть, но грубое — по соотношению реплик через kube-proxy. Этот стенд не ставит ни Service, ни обслуживающего приложения, поэтому трафика в нём нет вовсе, о чём ниже честно оговорено. На стенде это Argo Rollouts v1.9.1.
kind: Rollout заменяет Deployment: тот же PodSpec, но выкатка идёт шагами setWeight+pause с анализом посередине. Первичное создание canary-шаги пропускает (не с чем сравнивать) — сразу две реплики v1, Healthy. Интересна вторая раскатка, v1→v2, снятая пошагово:
20:47:33.659  TRIGGER version v1->v2
20:47:35.457  step=0  pods=[v1 v1 v2]         setWeight 25 — canary-под v2 поднят
20:47:38.039  step=1  Paused                  пауза 20 s
20:47:55.982  step=3  AR=[…2-3=Running]       анализ пошёл
20:48:16.280  step=5  AR=[…2-3=Successful]    анализ успешен, setWeight 75
20:48:36.777  step=7  Healthy pods=[v2 v2]    100 %, раскатка завершена
Триггер→100 % = 63.1 s, из которых 40 s — две заданные паузы по 20 s. Анализ снят как успешный не по слову, а по факту: три замера подряд value=[1] phase=Successful, условие result[0] >= 1, провайдер http://prometheus.cookbook-k8s.svc.cluster.local:9090, запрос max(up{job="cookbook-k8s-pods"}). То есть canary дошёл до 100 % потому что живая метрика прошла порог.
Здесь необходима честная оговорка про природу этой метрики, и обойти её нельзя. max(up{...}) — это доступность постороннего пода из соседнего стенда. На стенде она взята сознательно: это живой сигнал с настоящим числом (up=1), один и тот же шаблон при пороге 1 даёт успех, а при пороге 5 — заведомый провал (1 >= 5 ложно). Так автооткат запускается настоящим измерением, а не подсунутой заглушкой. Но up доступности чужого пода причинно не связана со здоровьем самого canary — версии на стенде вообще крутят один и тот же образ pause:3.10, метрик о себе не отдающий. Метрика здесь — прокси для демонстрации механизма автоотката, а не оценка релиза. В проде анализ целится в собственные сигналы новой версии: error-rate, латентность, success-ratio именно канареечных подов. Не читайте демо как «ArgoCD проверил здоровье v2» — он проверил абстрактный порог, чтобы показать, что происходит, когда порог не пройден.
А не пройден он вот так. Порог переставляется 1 → 5 (метрика up=1 его не берёт), запускается v2→v3, дальше без вмешательства:
20:49:39.317  TRIGGER version v2->v3           <- T0, отсчёт пошёл
20:49:40.536  step=0  pods=[v2 v2 v3]          canary v3 поднят, setWeight 25
20:49:42.516  step=1  Paused                   пауза 20 s
20:50:00.889  step=3  AR=[…3-3=Failed]         анализ отработал и УПАЛ
20:50:02.841  Degraded abort=true pods=[v2 v2] <- T1: v3 удалён, stable v2 снова 2/2
Старт→полный откат = 23.52 s (обе отметки хостовые, вычитание сырое). Но эти 23.52 s почти целиком — сознательно заданная длительность выкатки: 20 s из них это пауза step 1 до шага анализа. Собственно реакция механизма — от провала анализа 20:50:00.889 до завершённого отката 20:50:02.841 — это 1.95 s. Иначе говоря: как только метрика не прошла порог, откат занял около двух секунд; всё остальное — заданная пауза, а не задержка отката.
Откат подтверждён с трёх сторон, не «на глаз»: AnalysisRun — phase=Failed, message: assessed Failed due to failed (1) > failureLimit (0), реальное значение value=[1] против условия result[0] >= 5; условие Rollout — Progressing=RolloutAborted: Rollout aborted update to revision 3; события контроллера — AnalysisRunFailed → RolloutAborted в одну и ту же секунду 20:50:00Z. После аборта Rollout остаётся Degraded: canary снят, обслуживает прежняя стабильная ReplicaSet, состояние застыло на последней рабочей ревизии до ручного retry/undo. Это не поломка, а то поведение, ради которого берут progressive delivery: решение об откате принимает контроллер по факту анализа, а не человек постфактум. На стенде от провала анализа до снятия canary прошло 1.95 s; насколько быстро плохая версия уйдёт в реальной выкатке, зависит от того, что и как часто измеряет анализ — здесь доказана только реакция самого контроллера, здоровья приложения стенд не мерил.
Важная граница стенда, без которой замеры выше переносятся в прод неверно: реального разделения трафика здесь нет. У Rollout не задан ни trafficRouting, ни обслуживающий Service, а поды крутят pause:3.10 и запросов не обслуживают вовсе — поэтому и поле .status.canary.weights осталось пустым. setWeight здесь меняет только соотношение реплик новой и старой версий: наблюдалась смена числа подов [v1 v1 v2] → [v1 v2] → [v1 v2 v2] → [v2 v2], и на шаге [v1 v1 v2] это один канареечный под из трёх подов (~33 %, а не ровные 25 % из спека), а при replicas: 2 доля округляется до целого пода. Механизм при этом не «сломан»: будь у Rollout обычный Service, kube-proxy уже разделял бы запросы между подами примерно по их числу — грубо, но реально (Argo Rollouts официально называет такое распределение best effort); точный процент, не зависящий от числа реплик, требует уже traffic-router’а (ingress или mesh). Что стенд доказывает: механику ступенчатого продвижения ReplicaSet, ворота анализа метрик и автоматический откат по провалу анализа (реакция ~2 s). Чего не доказывает: фактического разделения трафика по процентам — для него понадобились бы обслуживающее приложение, Service, traffic-router (ingress или mesh) и генератор нагрузки, чего стенд не ставил. Как canary-веса реализуются через traffic split на уровне mesh, разбирается в статье про Cilium и service mesh.
Blue-green — честно
Вторая стратегия — blue-green: обе версии живут целиком и одновременно. Активная (blue) держит весь трафик через activeService, новая (green) поднимается рядом на previewService. Окно «обе версии целиком» снято живьём — четыре пода [v1 v1 v2 v2], active=758f744c89 (blue), preview=75bddbdff (green).
Первая редакция манифеста содержала ошибку конфигурации: autoPromotionEnabled: false вместе с autoPromotionSeconds: 20 в расчёте на переключение через 20 s. Так это не работает, и документация говорит об этом прямо: при autoPromotionEnabled: false параметр autoPromotionSeconds игнорируется. Стенд показал ровно документированное поведение: на argo-rollouts v1.9.1 контроллер встал в BlueGreenPause (startTime 20:52:49) и на каждой сверке — включая сверку спустя ~3,5 минуты (20:56:15) — печатал pause incomplete; active остался на blue. Такая пауза снимается только явным продвижением (kubectl argo rollouts promote). Чтобы переключать с задержкой, autoPromotionEnabled оставляют true (значение по умолчанию) и задают autoPromotionSeconds.
Поэтому в манифесте — каноничный autoPromotionEnabled: true (переключить, как только preview Healthy). На нём переключение снято чисто:
20:59:15.807  TRIGGER v1->v2
20:59:17.050  active=758f744c89(blue)   preview=75bddbdff(green)  4 пода [v1 v1 v2 v2]
20:59:19.033  active=75bddbdff(green!)  Healthy                   4 пода — blue ещё жив
20:59:48.416  active=75bddbdff(green)   2 пода [v2 v2]            blue снят
active переключился blue→green за ~3.2 s от триггера (как только green стал Healthy), а старый blue держался ещё ~29 s под scaleDownDelay (дефолт 30 s) — это и есть окно мгновенного отката: обе версии в кластере живы одновременно, activeService можно вернуть на blue одним переключением селектора.
Ограничения стенда
Стенд честнее показывать с его границами — иначе часть замеров переносится в прод неверно.
-
CRD общие с боевым ArgoCD — это свойство кластера, а не рекомендация. k8s-volga общий, в нём уже работает боевой ArgoCD, а
applications,applicationsets,appprojects.argoproj.io— объекты кластерного уровня, они одни на весь кластер и принадлежат Helm-релизу боевого ArgoCD (creationTimestamp 2026-07-19T09:08:17Z). Поэтому ArgoCD стенда установлен без CRD и с пином версииv3.4.1— ровно той, что у боевого: двух версий одного кластерного типа не бывает. Штатныйinstall.yamlтого же тега (1 890 674байта) применять в общем кластере нельзя — в нём триCustomResourceDefinitionи тотальнаяClusterRole["*"]/["*"]/["*"]; такая роль там ровно одна — уargocd-application-controller, и это буквально админ на весь кластер.namespace-install.yaml(88 049байт) не содержит ни одного CRD и ни одной кластерной роли. Обычному читателю на своём кластере подходит штатныйinstall.yamlбез фильтров — ограничение здесь только у нас. -
git-сервер внутри кластера — упрощение ради герметичности, а не рекомендация. Источник правды в GitOps по определению внешний; стенд делает наоборот, чтобы разворачиваться одной командой без аккаунта на хостинге, токена и deploy-ключа. Цена: у
git://нет аутентификации, история не переживает пересоздание пода (emptyDir), webhook-ов и PR-flow нет. Вывод про «доступ на запись в репозиторий = доступ в кластер» от этого только надёжнее. -
Задержка опроса репозитория — 125…403 s (медиана 225), а не «2 минуты». Это фактический разброс для нашего ненастроенного экземпляра. И главное различие ещё раз: новый объект контроллер получает watch-событием за секунды, новую ревизию уже синхронизированного
Application— только по опросу. В проде опрос будит webhook от хостинга.
Дальше по серии тема смыкается с соседними: reconcile-петля, на которой всё держится, — в «Операторы и CRD» и «Архитектура Kubernetes: control plane»; секреты, едущие по тому же конвейеру, — в «Секреты в Kubernetes»; перераспределение трафика между версиями — в «Сеть в Kubernetes: Cilium и service mesh»; цепочка «право на репозиторий = право в кластере» и Pod Security — в «Hardening подов»готовится, с 3 ноября. Кластер, на котором всё это снято и к узлам которого нет SSH, собран в «Четыре отказа при bootstrap на Talos»; входящий трафик, который выкатанные версии в итоге обслуживают, — в статье про Gateway API; а нужен ли вообще кластер под вашу задачу — в «Kubernetes для домашней лаборатории».
Источники
- Argo CD — документация, Application, Automated Sync Policy, Sync Options, Cluster Bootstrapping (app-of-apps)
- Argo Rollouts — документация, Canary, Blue-Green, Analysis и Prometheus
- Kubernetes Documentation — Finalizers, Owners and Dependents, Pod Security Standards, Network Policies
- OpenGitOps — Principles
- Стенд:
kubernetes/gitops(Kubernetesv1.36.2, k8s-volga, namespacecookbook-argocd; ArgoCDv3.4.1, Argo Rolloutsv1.9.1)
Обсуждение в Telegram
Присоединиться →