
Вводную «зачем нужны векторные БД и когда не нужны» мы уже разбирали отдельно — векторные базы данных и эмбеддинги. Эта статья открывает серию «Векторные БД: глубокое погружение» и начинает с фундамента — алгоритмов приближённого поиска ближайших соседей (ANN), на которых стоят и pgvector, и Qdrant, и Milvus.
Точный поиск сравнивает запрос с каждым вектором коллекции. ANN меняет гарантию «найдём ровно ближайших» на «найдём почти всех ближайших, но намного быстрее». Вся инженерия векторного поиска — о том, где провести эту границу и чем за неё заплатить: временем, памятью или долей потерянных соседей. Здесь эти три величины измерены на одном корпусе для каждой ручки каждого алгоритма.
Стенд: digital-cookbook/vector-databases/ann, датасет серии — digital-cookbook/vector-databases/dataset.
В статье
- Стенд: корпус, истина и мера работы
- Точный перебор
- HNSW: граф с этажами
- IVF: разбиение на ячейки
- Квантизация: SQ8 и PQ
- Метрика расстояния
- Сверка с Faiss и jvector
- Компромисс recall ↔ latency ↔ RAM
- Как повторить
- Что из этого выбирают за вас
Стенд: корпус, истина и мера работы
Корпус. BEIR Quora: 522 931 короткий вопрос и 10 000 тестовых запросов.
Эмбеддинги считает self-hosted модель intfloat/multilingual-e5-small в
контейнере на CPU: 384 измерения, векторы нормированы (длина 1), документы с
префиксом passage: , запросы — query: . Ревизия модели и версии библиотек
закреплены в dataset.json стенда датасета. Один и тот же корпус и одни и те
же запросы — во всей серии.
Истина. Для 1000 тестовых запросов точным перебором посчитаны 100 ближайших документов. Все дальнейшие числа — recall@10: доля настоящих десяти ближайших, попавших в выдачу из десяти. Это ANN recall — мера того, сколько индекс теряет относительно точного поиска. Релевантны ли эти десять документов вопросу, он не говорит: это retrieval recall по разметке, его мерит статья о гибридном поискеготовится, с 4 декабря. Высокий ANN recall хорошего RAG не гарантирует, а потеря части соседей не обязательно его портит: пропущенные геометрические соседи могут быть и нерелевантны задаче.
// go/vec/vec.go
func Recall(got []int32, truth []int32, k int) float64 {
	want := make(map[int32]bool, k)
	for _, t := range truth[:k] {
		want[t] = true
	}
	hit := 0
	for i, g := range got {
		if i == k {
			break
		}
		if want[g] {
			hit++
		}
	}
	return float64(hit) / float64(k)
}
Мера работы. Время зависит от железа, языка и того, как скомпилирован цикл. Поэтому, кроме времени, стенд считает число вычисленных расстояний на запрос — это свойство алгоритма и его параметров, а не машины. Поиск меряется в один поток, построение индексов — на всех ядрах (10 ядер VM Docker на Mac, arm64).
Алгоритмы — свои, на Go, без СУБД: короткий код, который можно прочитать,
с ручками наружу. Чтобы «свои» не значило «неправильные», каждая реализация
сверена с Faiss на тех же параметрах, а граф — ещё и с jvector на Java
(раздел сверка). Готовую Go-библиотеку HNSW (coder/hnsw)
пришлось отбросить на пробе: на 20 тыс. векторов её recall@10 держался около
0,17 и не рос с шириной поиска.
Точный перебор
Перебор — скалярное произведение запроса с каждым вектором и отбор десяти лучших. На полном корпусе это и есть истина: контроль стенда сверяет выдачу перебора с истиной датасета.
$ python3 scripts/run-brute.py all
{"variant": "control", "outcome": "match", "detail": "выдача совпала с истиной на 200 запросах из 200"}
{"variant": "scaling", "outcome": "match", "detail": "1212 мкс на 10 тыс. документов … 63 мс на 522931; 120.24 мкс на тысячу документов (медиана)"}
| документов | время на запрос, мс (p50) | расстояний на запрос |
|---|---|---|
| 10 000 | 1,2 | 10 000 |
| 50 000 | 6,1 | 50 000 |
| 100 000 | 12,0 | 100 000 |
| 250 000 | 30,1 | 250 000 |
| 522 931 | 62,8 | 522 931 |
Время растёт строго линейно — около 120 мкс на тысячу документов, и на полном корпусе это 63 мс на запрос в один поток. Меньше двадцати запросов в секунду на ядро — потолок этой реализации: скалярный цикл на Go, один запрос за раз. Векторные инструкции и пакетная обработка (матрица запросов на матрицу корпуса через BLAS, как делает Faiss в точном поиске) сдвигают его в разы, но рост остаётся линейным: каждый запрос по-прежнему сравнивается с каждым документом. Индекс устроен иначе: он сокращает саму работу — число сравнений, — сохраняя выбранный recall.
Подвох, найденный на пробе. Пока истина считала скалярное произведение
одним циклом, а перебор стенда — развёрнутым на четыре суммы, выдачи
совпадали не всегда: на FiQA (57 тыс. документов) — на 191 запросе из 200.
Порядок сложения float32 меняет последние биты, и соседи с почти равным
скором меняются местами на границе десятки. То же давало расстояние 1 − dot
вместо −dot: вычитание из единицы съедает точность. Теперь у истины и у
стенда одна и та же функция и −dot. Если вы сравниваете свой индекс с
«точным» поиском другой системы, часть потерь recall может оказаться не
потерей, а округлением.
HNSW: граф с этажами
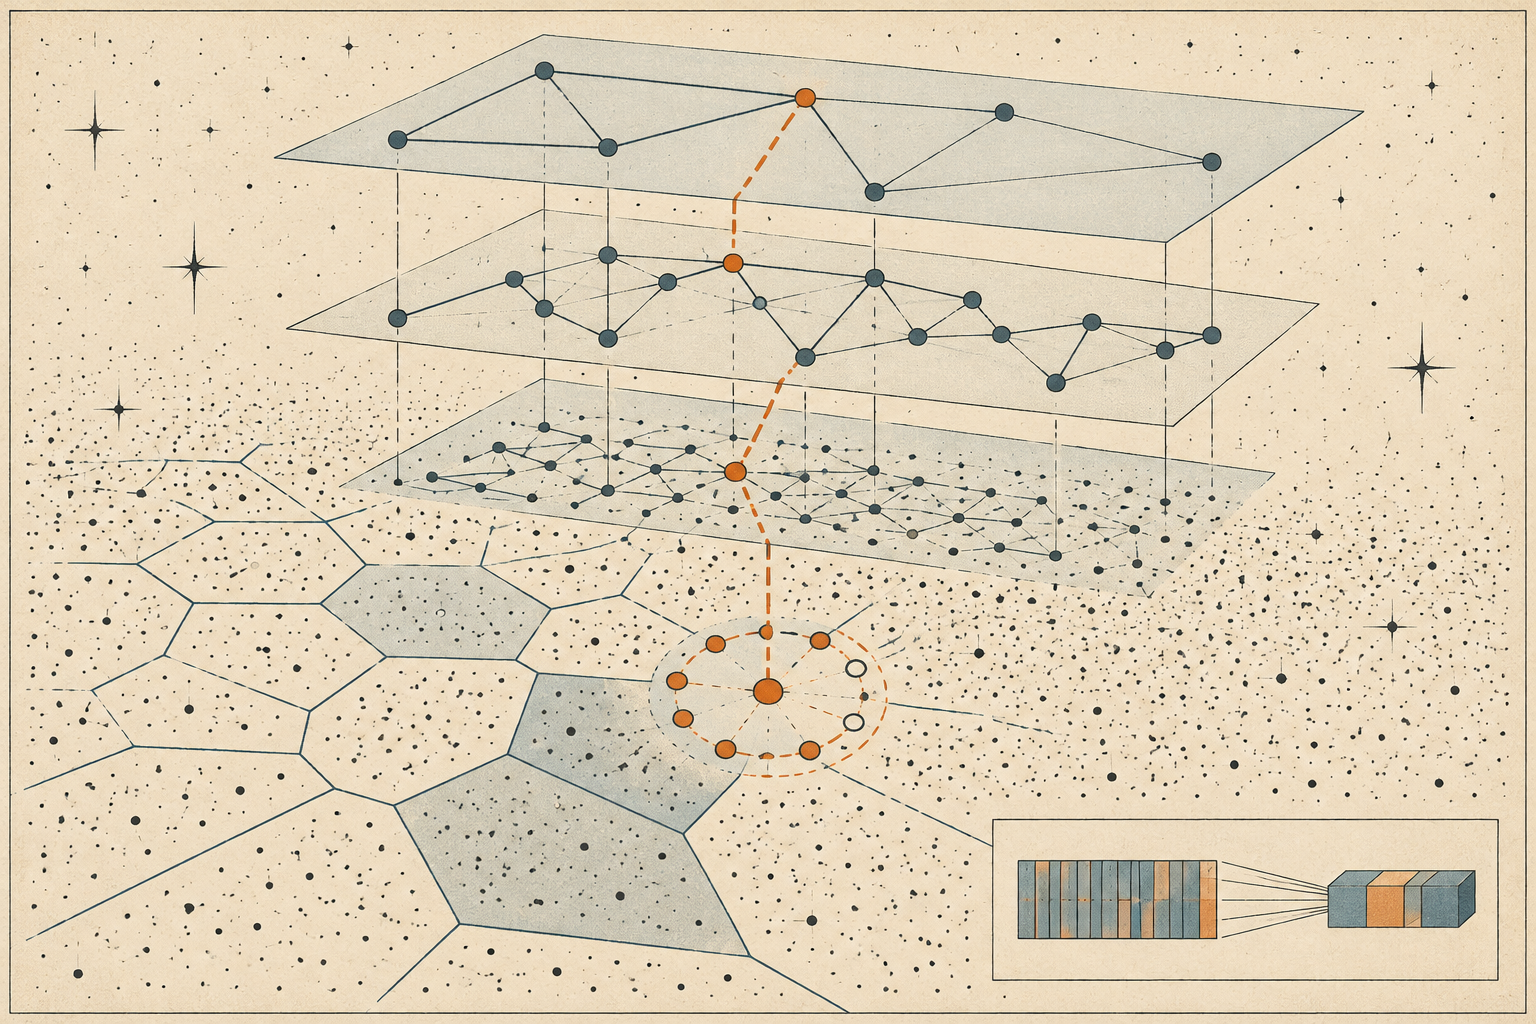
HNSW (Hierarchical Navigable Small World, Malkov и Yashunin) — граф соседства в несколько слоёв. На нижнем слое все векторы, каждый связан с ближайшими. Каждый следующий слой — случайная примерно 1/M-я часть предыдущего, и связи там длиннее. Поиск начинается с единственной точки входа на верхнем слое, жадно идёт к запросу, спускается на слой ниже и так до нижнего, где обходит граф с очередью ширины ef.
flowchart TB
    E[точка входа, верхний слой] -->|жадно к запросу| L2[слой 2: длинные рёбра]
    L2 -->|спуск в ближайший узел| L1[слой 1]
    L1 -->|спуск| L0[слой 0: все векторы, по 2·M связей]
    L0 -->|обход с очередью ef| R[top-10]
У графа с M = 16 на этом корпусе шесть слоёв: 522 931, 32 330, 1960, 140, 12 и 1 узел — каждый следующий примерно в 16 раз меньше.
Три ручки:
- M — сколько связей у узла (на нижнем слое — 2·M). Больше M — граф плотнее, recall выше, построение дольше, памяти больше.
- ef_construction — ширина поиска соседей при вставке узла. Влияет на качество графа и время построения, но не на поиск.
- ef_search (дальше — ef) — ширина обхода при запросе. Главная ручка recall ↔ latency: её крутят в проде, не перестраивая индекс.
Соседей узла выбирает эвристика из оригинальной статьи: кандидат берётся, только если он ближе к узлу, чем к любому уже выбранному соседу. Так у узла остаются связи в разные стороны, а не десяток соседей из одного сгустка.
// go/hnsw/hnsw.go
func (g *Graph) selectNeighbors(cands []item, m int) []int32 {
	sort.Slice(cands, func(i, j int) bool { return cands[i].d < cands[j].d })
	out := make([]int32, 0, m)
	for _, c := range cands {
		if len(out) == m {
			break
		}
		ok := true
		for _, r := range out {
			if g.Dist(g.vecs[c.id], g.vecs[r]) < c.d {
				ok = false
				break
			}
		}
		if ok {
			out = append(out, c.id)
		}
	}
	return out
}
ef: главная ручка. M = 16, ef_construction = 200:
| ef | ANN recall@10 | p50, мкс | p99, мкс | расстояний на запрос |
|---|---|---|---|---|
| 10 | 0,887 | 180 | 354 | 381 |
| 20 | 0,945 | 255 | 596 | 557 |
| 40 | 0,972 | 374 | 598 | 884 |
| 80 | 0,983 | 613 | 937 | 1508 |
| 160 | 0,991 | 1320 | 4289 | 2678 |
| 400 | 0,997 | 2598 | 4299 | 5909 |
Уже при ef = 40 найдено 97% настоящих соседей за 0,4 мс — против 63 мс у перебора, при 884 вычисленном расстоянии вместо 522 931. Дальше каждый следующий процент recall стоит всё дороже: от ef = 40 до ef = 400 работа растёт в шесть с лишним раз, а recall — на 2,5 пункта.
M и ef_construction. Все четыре графа при одном и том же ef = 40:
| граф | построение, с | связи, МБ | ANN recall@10 при ef = 40 | p50 при ef = 40, мкс | recall 0,95 — с ef | недостижимых узлов |
|---|---|---|---|---|---|---|
| M = 8, ef_construction = 200 | 132 | 31 | 0,940 | 297 | 80 | 387 |
| M = 16, ef_construction = 200 | 182 | 49 | 0,972 | 374 | 40 | 26 |
| M = 32, ef_construction = 200 | 215 | 66 | 0,984 | 520 | 20 | 1 |
| M = 16, ef_construction = 100 | 84 | 41 | 0,953 | 317 | 40 | 34 |
M растит recall при том же ef и время построения. ef_construction = 100 строит граф вдвое с лишним быстрее, чем 200, и теряет около двух пунктов recall — это цена, которую платит каждый запрос, пока индекс не перестроят.
Память графа. Связи M = 16 занимают 49 МБ — это 4 байта на ребро, — а сами векторы 766 МБ. Граф HNSW прибавляет к векторам проценты, а не разы: память HNSW — это прежде всего векторы в RAM, поэтому разговор о памяти неизбежно приводит к квантизации. В Go-реализации к этому добавляются заголовки срезов (по срезу на слой каждого узла), и рост кучи после построения — 121 МБ, больше самих связей: накладные расходы структуры тоже память индекса.
Недостижимые узлы. Контроль «при ef ≥ N поиск точный» для HNSW неверен. Эвристика выбора соседей и обрезка переполненных списков могут оставить узел без единого входящего ребра на нижнем слое — до него поиск не дойдёт ни при каком ef. Стенд считает такие узлы обходом графа от точки входа: при M = 8 их 387, при M = 16 — 26, при M = 32 — 1. Тест стенда проверяет и обратное: при ef = N поиск находит всех соседей, кроме недостижимых. Для 523 тыс. документов 26 недостижимых — мелочь, но это документы, которых не найдёт ни один запрос, и их число растёт с удалениями и обновлениями (об этом — в статье серии про фильтрацию и консистентностьготовится, с 10 декабря).
Детали реализации решают при малом ef. На пробе своя HNSW отставала от Faiss при ef = 10 (0,596 против 0,648 на FiQA). Нашлись два отличия. Новому узлу на нижнем слое давалось M соседей, а не 2·M — так делает hnswlib, а Faiss и pgvector дают 2·M. И узлы вставлялись в порядке номеров, а Faiss вставляет от высоких уровней к низким: сначала строится редкий верх графа. Обе правки подтянули recall при малом ef; оставшаяся разница — в сверке. Вывод для практики: «HNSW с M = 16» в двух разных системах — не одна и та же кривая recall, особенно в левой её части.
IVF: разбиение на ячейки
IVF (inverted file) режет пространство k-means на nlist ячеек. Каждый вектор кладётся в список своего ближайшего центроида. Запрос сравнивается со всеми центроидами, берёт nprobe ближайших и перебирает только их списки. Обучение центроидов — на выборке: здесь каждый десятый вектор корпуса, 20 итераций алгоритма Ллойда.
Контроль: nprobe = nlist просматривает весь корпус и обязан дать recall 1.
$ python3 scripts/run-ivf.py nlist723
{"variant": "control", "outcome": "match", "detail": "recall@10 1.0000, просмотрено 523654 векторов на запрос (корпус + 723 центроидов)"}
{"variant": "nlist723", "outcome": "match", "detail": "списки 7…2368 (медиана 691); recall@10 0.520 / 0.653 / 0.741 / 0.808 / 0.866 / 0.909 / 0.947 / 0.972 при nprobe 1/2/4/8/16/32/64/128"}
Две ручки: nlist (на этапе построения) и nprobe (на запросе). Классическая отправная точка — nlist ≈ √N, то есть 723; рядом — 4√N = 2892:
| nprobe | nlist 723: ANN recall@10 | векторов на запрос | nlist 2892: ANN recall@10 | векторов на запрос |
|---|---|---|---|---|
| 1 | 0,520 | 1591 | 0,473 | 3180 |
| 2 | 0,653 | 2458 | 0,603 | 3447 |
| 4 | 0,741 | 4152 | 0,702 | 3979 |
| 8 | 0,808 | 7467 | 0,776 | 4977 |
| 16 | 0,866 | 14 000 | 0,829 | 6884 |
| 32 | 0,909 | 26 846 | 0,878 | 10 631 |
| 64 | 0,947 | 52 294 | 0,911 | 17 886 |
| 128 | 0,972 | 102 165 | 0,939 | 32 011 |
| 256 | — | — | 0,965 | 59 549 |
У nprobe та же природа, что у ef, но цена другая. Recall 0,9 при nlist = 723 стоит nprobe = 32 и 26 846 векторов на запрос, при nlist = 2892 — nprobe = 64 и 17 886: мелкие ячейки точнее отсекают лишнее. Зато при малом nprobe у мелкого разбиения дорог сам выбор ячейки: 2892 центроида надо сравнить с запросом всегда. И главное сравнение — с HNSW: recall 0,97 у IVF-Flat при nlist = 723 стоит 37 мс на запрос, у HNSW — 0,4 мс. IVF выигрывает не скоростью, а другим: простое построение, предсказуемая память, естественное сочетание со сжатием (IVF-PQ) и с хранением на диске.
Нерепрезентативное обучение. Центроиды обучаются один раз, на выборке. Если выборка не похожа на данные — например, индекс обучили на первой партии документов одной темы, а потом залили всё остальное, — ячейки ложатся не туда. Опыт стенда: обучение на 10% корпуса, ближайших к одному случайному документу.
| обучение центроидов | самый короткий список | медиана | самый длинный | ANN recall@10 при nprobe = 1 | векторов на запрос при nprobe = 8 |
|---|---|---|---|---|---|
| каждый 10-й вектор | 7 | 691 | 2368 | 0,520 | 7467 |
| 10% корпуса вокруг одного документа | 1 | 363 | 17 246 | 0,426 | 16 731 |
Самый длинный список вырос до 17 246 векторов — перекос max/медиана в 14 раз больше, чем у обучения на равномерной выборке. При nprobe = 1 recall упал с 0,520 до 0,426, а при каждом nprobe просмотр дороже: запросы, попавшие в раздутую ячейку, перебирают её целиком. В pgvector это объясняет рекомендацию строить IVFFlat после загрузки данных, а не на пустой таблице.
Квантизация: SQ8 и PQ
Векторы float32 — 1536 байт на документ, 766 МБ на корпус. Квантизация хранит вместо них компактные коды:
- SQ8 (скалярная): по каждой координате свой диапазон [min, max] делится на 256 уровней, координата — один байт. Сжатие в 4 раза.
- PQ (product quantization, Jégou и соавторы): вектор режется на m подвекторов, для каждого подпространства k-means обучает 256 центроидов, и подвектор заменяется номером ближайшего — одним байтом. m = 48 — по 8 координат на подвектор, сжатие в 32 раза; m = 96 — по 4, в 16 раз.
Поиск по кодам PQ — асимметричный (ADC): запрос не квантуется. Для него один раз строится таблица m × 256 скалярных произведений его подвекторов с центроидами, а скор каждого кода — сумма m чисел из таблицы:
// go/quant/quant.go
func (p *PQ) Search(query []float32, k, r int, data [][]float32, exact bool) []int32 {
	table := make([]float32, p.M*256)
	for s := 0; s < p.M; s++ {
		qs := query[s*p.Sub : (s+1)*p.Sub]
		for c, cv := range p.Codebooks[s] {
			table[s*256+c] = vec.Dot(qs, cv)
		}
	}
	n := len(p.Codes) / p.M
	cs := topR(n, func(i int) float32 {
		var s float32
		for j, c := range p.Codes[i*p.M : (i+1)*p.M] {
			s += table[j*256+int(c)]
		}
		return s
	}, max(r, k))
	return rescore(query, cs, k, data, exact)
}
Пересчёт (rescoring). Коды дают приближённый скор. Если взять по нему не 10, а r лучших кандидатов и пересчитать их по исходным векторам, ошибка квантизации почти исчезает — при условии, что исходные векторы где-то есть (на диске, в другом хранилище).
$ python3 scripts/run-quant.py pq48
{"variant": "pq48", "outcome": "match", "detail": "коды 23.9 МБ (сжатие в 32 раза); recall@10 0.507 без пересчёта, 0.889 / 0.989 с пересчётом 100 / 1000"}
| способ | коды, МБ | сжатие | ANN recall@10 без пересчёта | пересчёт 100 | пересчёт 1000 | p50 с пересчётом 1000, мс |
|---|---|---|---|---|---|---|
| SQ8 | 191,5 | в 4 раза | 0,988 | 1,000 | 1,000 | 64,2 |
| PQ, m = 48 | 23,9 | в 32 раза | 0,507 | 0,889 | 0,989 | 10,0 |
| PQ, m = 96 | 47,9 | в 16 раз | 0,724 | 0,996 | 1,000 | 22,1 |
SQ8 почти ничего не теряет и без пересчёта. PQ при m = 48 без пересчёта
теряет около половины соседей — сжатие в 32 раза не бесплатно; пересчёт
1000 кандидатов возвращает recall 0,989. Гипотеза стенда до прогона была
строже — «теряет больше половины» — и не устояла на 0,007: порог был взят с
пробы на FiQA, где PQ давал 0,27. Faiss на тех же параметрах дал 0,499 — дело
не в реализации, а в корпусе. Это записано в expected.json стенда как
ревизия гипотезы.
Время здесь — плоский перебор кодов в один поток без SIMD, поэтому SQ8 почти не быстрее перебора float32: выигрыш квантизации — память, а не скорость сканирования. В движках коды сочетают с графом или IVF (HNSW по SQ8-векторам, IVF-PQ), и тогда сжатие оплачивает размещение индекса в RAM.
Метрика расстояния
Модели эмбеддингов обучают под конкретную метрику, и движки спрашивают её при создании индекса: cosine, L2 или скалярное произведение (dot). Для нормированных векторов это одно и то же: L2² = 2 − 2·dot, а cosine = dot. Стенд проверяет это на 100 тыс. документов и 200 запросах — и повторяет на тех же векторах, умноженных на случайную длину от 0,5 до 2:
| векторы | cosine и L2: общих в top-10 | cosine и dot: общих в top-10 |
|---|---|---|
| нормированные | 1,000 | 1,000 |
| длина от 0,5 до 2 | 0,316 | 0,111 |
На нормированных векторах выдачи совпали полностью. На ненормированных cosine и dot делят в среднем один документ из десяти: dot предпочитает длинные векторы, а длина здесь — шум. Практический вывод: нормированы ли векторы, которые отдаёт ваша модель, — надо проверить, а не предположить, и указать индексу ту метрику, под которую модель обучена. Если модель обучена под косинус (как e5), нормировка при записи делает cosine, dot и L2 равнозначными, а dot — самым дешёвым. Если же модель или задача — поиск по максимальному скалярному произведению (MIPS), где длина вектора несёт сигнал (популярность, уверенность), нормировка этот сигнал стирает: выбор метрики — решение о модели, а не только об индексе.
Сверка с Faiss и jvector
Свои реализации прогнаны на тех же данных и параметрах в Faiss 1.10.0:
| алгоритм | точка | своя реализация | Faiss |
|---|---|---|---|
| HNSW, M = 16, ef_construction = 200 | ef 10 | 0,887 | 0,910 |
| HNSW, M = 16, ef_construction = 200 | ef 40 | 0,972 | 0,981 |
| HNSW, M = 16, ef_construction = 200 | ef 160 | 0,991 | 0,993 |
| IVF-Flat, nlist = 723 | nprobe 1 | 0,520 | 0,511 |
| IVF-Flat, nlist = 723 | nprobe 8 | 0,808 | 0,808 |
| IVF-Flat, nlist = 723 | nprobe 64 | 0,947 | 0,948 |
| PQ, m = 48 | без пересчёта | 0,507 | 0,499 |
| PQ, m = 48 | пересчёт 100 | 0,889 | 0,890 |
| PQ, m = 48 | пересчёт 1000 | 0,989 | 0,987 |
| SQ8 | без пересчёта | 0,988 | 0,987 |
| SQ8 | пересчёт 100 | 1,000 | 1,000 |
IVF, PQ и SQ8 сходятся в пределах сотых. HNSW при ef = 10 отстаёт от Faiss на два пункта при почти том же числе вычисленных расстояний (381 против 388) — граф Faiss немного лучше; при ef = 160 разница — 0,002.
Вторая, независимая реализация графа — jvector на Java (граф в духе DiskANN/Vamana с иерархией, как у HNSW), M = 16, ширина при построении 200:
| ширина обхода | jvector: ANN recall@10 | jvector: посещено узлов | своя HNSW: ANN recall@10 | своя HNSW: расстояний |
|---|---|---|---|---|
| 10 | 0,854 | 278 | 0,887 | 381 |
| 20 | 0,916 | 387 | 0,945 | 557 |
| 40 | 0,955 | 591 | 0,972 | 884 |
| 80 | 0,974 | 974 | 0,983 | 1508 |
| 160 | 0,986 | 1696 | 0,991 | 2678 |
| 400 | 0,991 | 3711 | 0,997 | 5909 |
Кривая той же формы и в той же области. У jvector свой счётчик работы — посещённые узлы, он не равен числу расстояний, поэтому сравнивать стоит форму кривых, а не столбцы поштучно.
Компромисс recall ↔ latency ↔ RAM
Сводка по корпусу: для каждого способа — первая точка, где recall@10 не ниже 0,95, время на запрос и память индекса (без учёта исходных векторов там, где они нужны только для пересчёта).
| способ | параметры | ANN recall@10 | p50, мс | память индекса, МБ |
|---|---|---|---|---|
| точный перебор | — | 1,000 | 62,8 | 766 |
| HNSW, M = 8 | ef = 80 | 0,964 | 0,4 | 797 |
| HNSW, M = 16 | ef = 40 | 0,972 | 0,4 | 815 |
| HNSW, M = 32 | ef = 20 | 0,966 | 0,3 | 832 |
| IVF-Flat | nlist = 723, nprobe = 128 | 0,972 | 37,1 | 769 |
| IVF-Flat | nlist = 2892, nprobe = 256 | 0,965 | 26,3 | 772 |
| SQ8, перебор кодов | без пересчёта | 0,988 | 63,0 | 192 |
| PQ, m = 48, перебор кодов | пересчёт 1000 | 0,989 | 10,0 | 24 |
| PQ, m = 96, перебор кодов | пересчёт 100 | 0,996 | 20,1 | 48 |
Три оси нельзя оптимизировать одновременно, и каждая ручка двигает все три:
- ef, nprobe, r — меняются на лету, двигают recall и время, память не трогают. Их подбирают последними, под требуемый recall.
- M, nlist, ef_construction — заданы при построении: время построения, память и потолок recall при данном бюджете времени. Ошибка здесь лечится только перестройкой.
- Квантизация — покупает память за recall, а пересчёт возвращает recall за время и доступ к исходным векторам.
Порядок решения в проде обычно такой: зафиксировать требуемый recall (его мерят на своих данных против точного перебора, как здесь), затем бюджет памяти (влезают ли векторы float32 в RAM узла), и только потом latency — она подбирается ручками поиска.
Как повторить
cd vector-databases/dataset && python3 scripts/make-dataset.py
cd ../ann && bash scripts/run-all.sh
Сборка датасета — около 70 минут на 10 ядрах (почти всё время — эмбеддинги
Quora и FiQA), полный прогон стенда — около 40 минут. Одна ось —
python3 scripts/run-hnsw.py, один вариант без записи фикстуры —
python3 scripts/run-hnsw.py m16-efc200. Гипотезы записаны в
expected.json до прогона, вместе с пробами на FiQA, после которых менялся
код. Фикстуры двух сессий (вторая — с пересборкой всех образов и бинарников)
сравниваются сводками; recall параллельно построенного графа немного
отличается от сессии к сессии, поэтому в сравнение идут исходы проверок, а не
третий знак recall.
Что из этого выбирают за вас
- pgvector — HNSW и IVFFlat внутри PostgreSQL: те же ручки (
m,ef_construction,hnsw.ef_search,lists,ivfflat.probes) плюс halfvec и бинарная квантизация. Разбор — в статье pgvector вглубь. - Выделенные движки — HNSW как основной индекс, квантизация с пересчётом как опция, сегменты вместо одного графа. Сравнение на этом же корпусе — в статье Qdrant, Milvus, Weaviateготовится, с 24 ноября.
- Фильтры по метаданным ломают и граф, и ячейки неочевидным образом — фильтрация и консистентностьготовится, с 10 декабря; точные термины, на которых промахивается любой вектор, — гибридный поискготовится, с 4 декабря.
Итог
- Точный перебор линеен: 63 мс на запрос на 523 тыс. векторов в один поток. ANN снижает работу в сотни раз ценой нескольких процентов соседей.
- HNSW даёт лучший recall на единицу времени; его память — прежде всего векторы, граф прибавляет проценты. Малый ef чувствителен к деталям реализации, а часть узлов графа может быть недостижима.
- IVF проще и предсказуемее по памяти, но медленнее при высоком recall и зависит от того, на чём обучены центроиды.
- Квантизация сжимает векторы в 4–32 раза; пересчёт по исходным возвращает recall. Метрика должна совпадать с той, под которую обучена модель, а на нормированных векторах выбор метрики перестаёт иметь значение.

Обсуждение в Telegram
Присоединиться →