
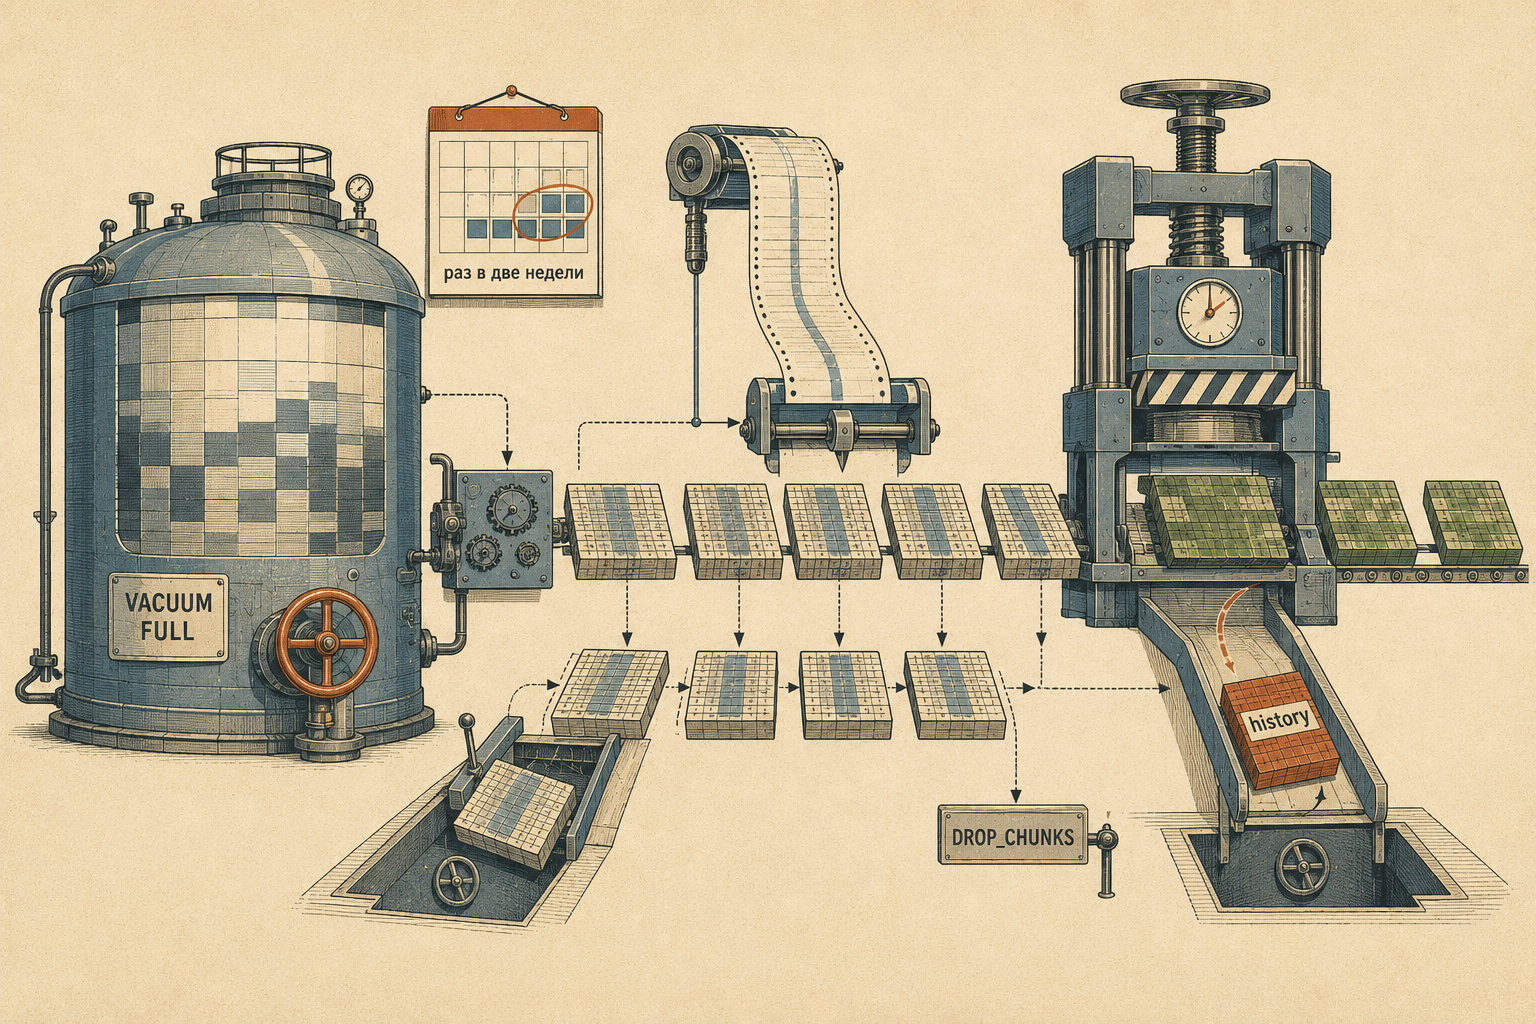
Мониторинг сам стал источником проблемы: БД Zabbix на трёхнодовом Patroni-кластере распухала так, что диски доходили до 88–91%, и приходилось раз в две недели в окно обслуживания гонять VACUUM FULL, возвращая по ~14 ГБ на ноду. Это лечение симптома — построчные DELETE от housekeeper’а копят мёртвые кортежи быстрее, чем autovacuum успевает их убирать, а место ОС всё равно не отдаётся. Настоящее решение меняет не частоту уборки, а саму модель хранения: гипертаблицы TimescaleDB превращают удаление истории в дешёвый drop_chunks, а нативная компрессия ужимает старые чанки в разы. Но у этого решения есть неочевидная грань, на которую легко наступить, — когда порог компрессии совпадает с окном ретеншна, самая тяжёлая таблица не сжимается вообще.
Это пятая статья серии «PostgreSQL в проде». Она продолжает разговор про эксплуатацию хранилища из «Партиционирование, VACUUM и борьба с bloat» — но теперь на конкретном боевом кейсе и с уклоном в TimescaleDB: не «как устроен MVCC-bloat вообще», а «как перестать бороться с ним руками на реальной мониторинговой БД». Базовое устройство гипертаблиц и политик — в «Time-series БД: TimescaleDB и VictoriaMetrics»; здесь оно берётся как данность и разбирается со стороны эксплуатации. В отличие от остальных статей серии, числа ниже — не со синтетического стенда, а с реальной мониторинговой БД: PostgreSQL 18 на трёхнодовом Patroni, TimescaleDB 2.27.2, Zabbix 7.4.12. Честная оговорка про воспроизводимость: этот кейс не поднимается одной командой, как docker-стенды остальных статей, — он живёт на связке Zabbix + TimescaleDB + Patroni. Поэтому команды, проверочные запросы и ожидаемые выводы вынесены в публичный sanitized-runbook postgres-ops/timescaledb-zabbix (полный прод-runbook с внутренними хостами — приватный); адаптируйте под свою установку и проверяйте на своей версии.
В статье
- Симптом: место кончается раз в две недели
- Гипертаблицы меняют модель удаления
- Нативная компрессия: где реальная экономия
- Ловушка: порог сжатия против окна ретеншна
- Обход для конкретной версии: compress_older ниже 7 дней
- Результат, оговорки и чек-лист
Симптом: место кончается раз в две недели
Исходная картина знакома всем, кто держал Zabbix на большом парке: трёхнодовый Patroni (PostgreSQL 18), диски по ~79 ГБ, заполнение доходило до 88–91%. Спасались руками — раз в две недели в окно обслуживания VACUUM FULL на лидере возвращал по ~13–14 ГБ на ноду (88% → 71%), реплики ужимались сами, проиграв тот же WAL. Через две недели всё повторялось.
Почему это костыль, а не решение, разобрано механикой в соседней статье серии про VACUUM и bloat: Zabbix housekeeper удаляет устаревшие метрики построчными DELETE, те копят мёртвые версии быстрее, чем autovacuum успевает убирать, а обычный VACUUM помечает место переиспользуемым, но файл операционной системе не отдаёт. VACUUM FULL отдаёт — ценой эксклюзивной блокировки и планового окна. На растущей мониторинговой БД такая ручная уборка масштабируется плохо: это бесконечная борьба с симптомом.
Корень проблемы — сама модель. history и trends в Zabbix append-only по времени: новые метрики дописываются, старые удаляются по ретеншну. Это идеальный профиль для time-series хранилища, где удаление истории не должно быть построчным DELETE вообще.
Гипертаблицы меняют модель удаления
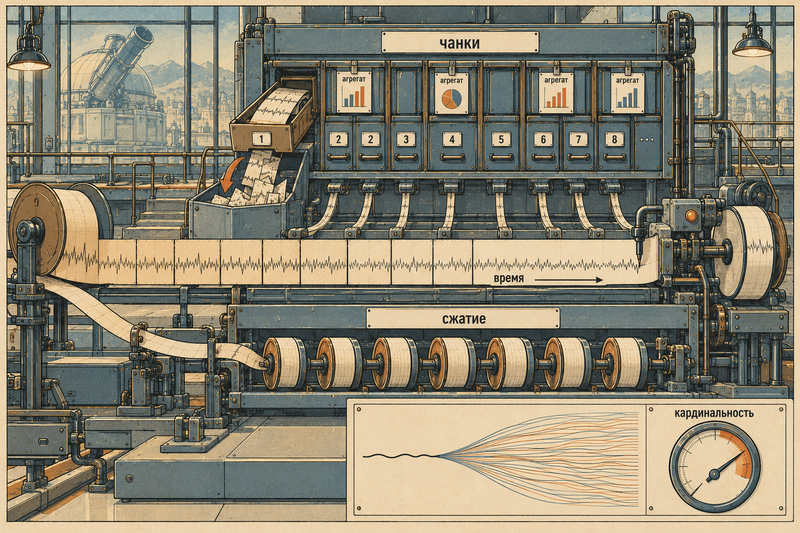
TimescaleDB — расширение PostgreSQL, превращающее обычную таблицу в гипертаблицу: физически она нарезается на чанки по времени (create_hypertable() поверх CREATE EXTENSION timescaledb). Для Zabbix history-чанк — это один день, trends-чанк — 30 дней. Ключевое следствие для эксплуатации: удаление истории перестаёт быть построчным.
Вместо DELETE миллионов строк ретеншн реализуется через drop_chunks — сброс целого чанка как метаданной операции, мгновенно и без мёртвых версий. Разница видна в логе одного и того же сервера, до и после конвертации:
до:    housekeeper [deleted 519533 hist/trends ... in 30.07 sec]
после: housekeeper [deleted 0 hist/trends ... in 0.09 sec]
519 533 удалённых строк за 30 секунд превратились в 0 строк за 0.09 секунды — потому что удаление теперь дропает чанк целиком, а не выгрызает строки поодиночке. Bloat от housekeeper’а исчезает как класс: нечему копиться, если старьё уходит целыми чанками.
Условие корректной работы — глобальный ретеншн (hk_history_global=1, hk_trends_global=1). При per-item override (когда у отдельных метрик своё окно хранения) дропнуть чанк целиком нельзя — в нём осталась бы «живая» строка, — и вся выгода теряется, ретеншн скатывается обратно к построчному DELETE.
Отдельный разовый бонус даёт сама конвертация. migrate_data при создании гипертаблицы переписывает таблицы плотно, без накопленного bloat: БД zabbix сжалась с 13–14 ГБ до 8.2 ГБ ещё до того, как включилась компрессия. То есть значительная часть выигрыша — это единоразовое уплотнение при переезде, эквивалент того самого VACUUM FULL, только один раз и навсегда меняющее модель.
Нативная компрессия: где реальная экономия
Второй механизм TimescaleDB — columnstore-компрессия по чанкам: старые чанки пересобираются в колоночный формат и ужимаются в разы. Управляется декларативной политикой policy_compression (по умолчанию прогон раз в сутки). Цифры со стенда впечатляют:
trends       сжат на 93.6%
trends_uint  сжат на 96.3%
Но здесь важный нюанс, который легко упустить: основной единоразовый выигрыш по месту даёт конвертация, а не компрессия. На небольшой таблице trends конвертация ужала объём с 517 до 256 МБ, а дальнейшая компрессия почти не двигает итоговый размер — таблица уже маленькая. Компрессия «выстреливает» на больших долгоживущих таблицах, где чанки успевают состариться и накопить объём, оправдывающий пересборку в колоночный формат. Процент сжатия сам по себе — не метрика экономии; экономия в гигабайтах зависит от того, к какой таблице этот процент применяется.
Ловушка: порог сжатия против окна ретеншна
Здесь и обнаружилась неочевидная грань. После конвертации history — самая большая таблица, 6.3 ГБ, — показывала 0 из 8 чанков сжато. При этом compression_status=1, а задания компрессии исправно отрабатывали со статусом Success. Компрессия «работает», но самая тяжёлая таблица не сжата.
Разбор сходится на арифметике порогов. Порог сжатия compress_older=7d, окно ретеншна hk_history=7d, чанк — суточный. Суточный чанк дорастает до права быть сжатым (возраст 7 дней) ровно в тот момент, когда ретеншн его дропает. Он не успевает сжаться никогда: становится годным к компрессии и удаляется в одном и том же окне.
trends, наоборот, сжимается прекрасно: ретеншн 365 дней несравнимо больше порога 7 дней, старые чанки живут достаточно долго, чтобы их успела забрать компрессия. Увидеть ловушку заранее можно по timescaledb_information.chunks (is_compressed по гипертаблицам) — сверив compress_after политики с окном ретеншна каждой таблицы. Красный флаг однозначен: у самой большой history-таблицы compressed = 0, при этом задания компрессии Success.
Обход для конкретной версии: compress_older ниже 7 дней
Сразу штатная позиция, чтобы не было двусмысленности: поддерживаемый минимум Zabbix для «Compress records older than» — 7 дней. UI Administration → Housekeeping не даст поставить меньше, и это не баг, а документированное ограничение. Всё, что ниже 7 дней, — неподдерживаемый production-hack, а не рекомендация. Дальше — разбор того, что было сделано на конкретной инсталляции и почему, а не инструкция «делайте так».
Сначала — почему нельзя обойти проблему «мимо» Zabbix. Напрашивающийся ход — подкрутить политику TimescaleDB напрямую через alter_job — держится ненадёжно. compress_older в Zabbix — глобальная настройка в таблице settings (одно значение на history и trends сразу), и Zabbix-сервер сам переприменяет политику TimescaleDB (compress_after у policy_compression) по этому значению. В 7.4.12 это происходит не на каждом цикле housekeeper, а при инициализации сервера и при изменении настроек компрессии (статус или compress_older): сервер сравнивает текущий compress_after с нужным и, если они расходятся, пересоздаёт политику. Прямая правка задания поэтому проживёт до ближайшего рестарта сервера или правки настроек компрессии — и вернётся к значению из settings. Значит, единственная точка, которую Zabbix уважает, — сам compress_older.
В этом кейсе его опустили до 3d прямой правкой БД, минуя UI-валидацию:
UPDATE settings SET value_str = '3d' WHERE name = 'compress_older';
Повторю: это ниже документированного минимума и официально не поддерживается. На Zabbix 7.4.12 обход сработал — housekeeper подхватил политику с compress_after ≈ 266400 (3.08 дня вместо 7-дневных 612000), и компрессия пошла (как это проверить и что значение не перетёрлось обратно — в разделе «Результат»). На другой версии Zabbix вполне может валидировать порог и на стороне сервера, вернув 7 дней, — проверять обязательно. После правки нужно перечитать конфиг и форсировать housekeeper, не дожидаясь ночного прогона:
zabbix_server -R config_cache_reload
zabbix_server -R housekeeper_execute
А чтобы компрессия отработала немедленно по уже годным чанкам, а не на следующем суточном цикле, задания policy_compression вызывают вручную:
CALL run_job(<job_id>); -- для каждого задания policy_compression
Результат, оговорки и чек-лист
Сразу разведём, что здесь обязательное решение, а что — необязательная добавка, иначе легко принять хак за причину успеха. Проблему bloat решил не обход, а сам переход на гипертаблицы. drop_chunks вместо построчного DELETE + плотная перезапись при конвертации (13–14 → 8.2 ГБ) изменили модель удаления навсегда: VACUUM FULL раз в две недели больше не нужен, и это работает на штатных, поддерживаемых настройках. Понижение compress_older до 3d — дополнительная, необязательная оптимизация поверх: она дожала history (6.3 → 3.7 ГБ, сжато 4 из 8 чанков) и history_uint (1.7 → 0.98 ГБ), доведя БД zabbix до 8.8 → 5.4 ГБ (−39%), но она не была причиной, по которой мониторинг перестал распухать. Проверить, что значение не перетёрлось обратно, можно по политикам (ожидать compress_after = 266400 вместо 612000):
SELECT hypertable_name, config->>'compress_after'
FROM timescaledb_information.jobs WHERE proc_name = 'policy_compression';
Оговорки честные. Главная — потеря поздних данных. Сжатые чанки неизменяемы, и по документации Zabbix все поздние данные старше порога компрессии отбрасываются. При 3d значение, пришедшее с опозданием больше трёх суток, — например, буфер прокси после долгого разрыва связи, — в историю не попадёт; при штатных 7 днях окно для таких опозданий вдвое шире. Если прокси могут надолго терять связь с сервером, это и есть цена обхода. Дальше — производительность: порог 3d сжимает уже «тёплые» данные возрастом 3–7 дней — графики за этот период строятся чуть медленнее (чтение из колоночного формата), плюс постоянный расход CPU на компрессию. В этом кейсе давления на диск именно от history не было (таблица ограничена ретеншном и не растёт), реальным драйвером роста дисков были аналитические БД рядом, а не Zabbix, — поэтому обход compress_older тут честнее назвать любопытным экспериментом, чем необходимостью. Если у вас history действительно распухает и упирается в диск — сначала пересмотрите ретеншн и chunk interval штатными средствами, и только осознанно, с оглядкой на версию, идите на понижение порога ниже 7 дней.
Чек-лист переноса на свой мониторинг:
- Диагностика:
timescaledb_information.chunks(сжато/несжато по гипертаблицам),...jobs(политики и ихcompress_after),...hypertables(размеры). - Красный флаг «ловушки»: у самой большой history-таблицы
compressed = 0, при этом задания компрессииSuccess— почти навернякаcompress_older ≈ hk_history. - Порядок правки без простоя: изменить порог →
config_cache_reload→housekeeper_execute→run_jobпо политикам компрессии → проверить рост числа сжатых чанков. - Версии критичны и подвижны: на момент кейса (Zabbix 7.4.12) потолок поддерживаемого TimescaleDB — 2.27.X, поэтому версия жёстко пинуется к 2.27.2 (
apt-mark hold; дефолтный 2.28.x был вне поддержки). Поддержка TimescaleDB 2.27.X появилась только с 7.4.12, а следующая ветка 7.4.13 уже заявляет TimescaleDB 2.28.X — перед повтором сверьте актуальный потолок для своей версии Zabbix, планка сдвигается.
На этом серия «PostgreSQL в проде» охватывает полный цикл эксплуатации: высокую доступность (Patroni и репликация), слой соединений (пулинг), обслуживание хранилища (VACUUM и bloat), чтение планов (EXPLAIN) — и этот боевой кейс, где всё сходится вместе на реальной мониторинговой БД.
Источники
- Timescale Documentation — hypertables,
drop_chunks, compression policies - Zabbix Documentation — TimescaleDB — housekeeping,
compress_older - PostgreSQL Documentation — 25.1. Routine Vacuuming
- Публичный sanitized-runbook:
postgres-ops/timescaledb-zabbix— процедура конвертации, проверочные запросы, ожидаемые выводы, типичные ошибки (полный прод-runbook с внутренними хостами — приватный)

Комментарии