
SQLite привычно считают базой для мобильных приложений и прототипов — и сильно недооценивают. Это, по числу инсталляций, самая распространённая СУБД на планете, и в последние годы она всё увереннее заходит на бэкенд: без сетевого хопа к БД запрос обслуживается за микросекунды, разворачивать нечего, а на краю (edge) это часто единственный вменяемый вариант. Секрет в смене модели: БД не отдельный сервер, а библиотека в вашем процессе. Эта статья — про то, когда файл реально бьёт сервер, как при этом не потерять данные и где проходят честные границы, подтверждённые замером на стенде digital-cookbook/databases/sqlite/.
В статье
- Модель: библиотека, а не сервер
- Три плеча: сколько стоит сеть, а сколько — архитектура
- Долговечность выравнивает всё
- Граница одного писателя
- litestream: восстановление, а не обещание
- SQLite против DuckDB: разные оси
- Репликация и встраиваемые KV — обзорно
- Чек-лист выбора
- Источники
Модель: библиотека, а не сервер
У классической клиент-серверной СУБД запрос идёт по сети (или хотя бы через unix-сокет), парсится отдельным процессом, планируется, исполняется и результат копируется обратно тем же путём. SQLite эту цепочку укорачивает до предела: библиотека линкуется прямо в процесс приложения, файл на диске — это и есть база, а «запрос» — вызов функции в том же адресном пространстве. Нет сериализации протокола, нет переключения контекста между процессами, нет второго процесса вообще.
⚠️ Отсюда соблазнительный, но опасный вывод про деплой: «скопировать файл — это и есть бэкап». Копия одного файла .db безопасна только после штатного закрытия базы: последнее соединение закрылось, checkpoint завершился, и файл -wal удалён или пуст — тогда .db действительно разом даёт и бэкап, и миграцию, и клонирование. «Процесс остановлен» этого не гарантирует: если приложение упало или было убито, закоммиченные транзакции могут остаться в -wal, и копия одного .db их потеряет. В таком случае копируют .db вместе с -wal (при остановленной записи это согласованная пара; -shm не нужен — он восстанавливается) или сначала открывают базу и штатно закрывают её, чтобы checkpoint влил журнал в основной файл. Для живой базы в WAL-режиме это не так: часть уже закоммиченных транзакций может лежать в файле -wal, ещё не влитом в основной файл чекпойнтом. Копия одного .db на живой базе даст неполные данные, а копия всех трёх файлов (.db, -wal, -shm) без остановки записи — рваное, несогласованное состояние. Для работающей базы годится VACUUM INTO, SQLite Backup API или непрерывная репликация — например, litestream, разобранный ниже.
Дальше — не мнение, а три плеча одного и того же бенчмарка на одном стенде.
Три плеча: сколько стоит сеть, а сколько — архитектура
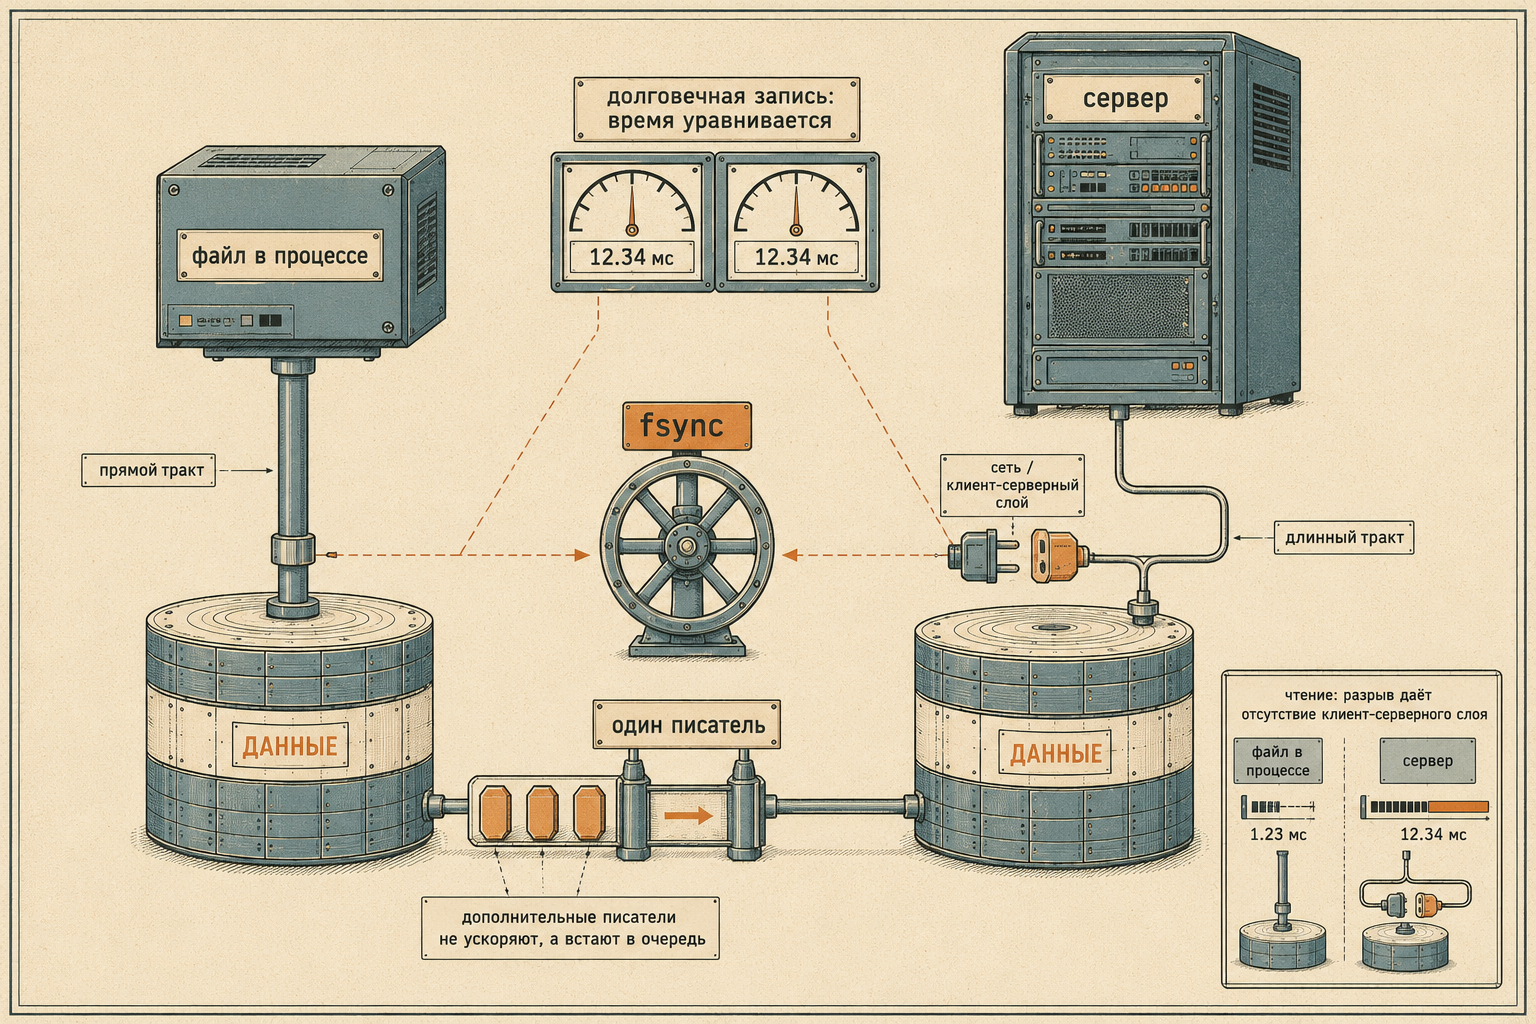
Наивное «SQLite быстрее Postgres» смешивает две разные причины: сетевой хоп и саму архитектуру клиент-сервер. Стенд разводит их явно, гоняя один и тот же клиентский код по трём плечам: SQLite-файл в процессе бенчмарка, Postgres через unix-сокет (сокет проброшен общим томом в контейнер bench, но сервер — тот же самый процесс Postgres), Postgres через TCP до того же сервера. Оба Postgres-плеча бьют в один и тот же контейнер postgres — это не два инстанса и не колокейтед-развёртывание, а один сервер, до которого добираются двумя путями: без сети (сокет, проброшенный общим томом) и по TCP через bridge-сеть Docker (DSN резолвит postgres:5432 в IP соседнего контейнера — bench и postgres разные контейнеры, это не loopback). Три плеча строились именно для того, чтобы разделить эти два вклада — сетевой хоп и клиент-серверный слой как таковой. Ниже — не один прогон, а честный разброс по всем шести кругам обоих замеров латентности с ротацией порядка плеч по латинскому квадрату (fixtures/latency-run1.txt, fixtures/latency-run2.txt, по три круга в каждом; точечное чтение по первичному ключу, n=20000, synchronous=FULL / synchronous_commit=on):
| Плечо | Что изолирует | p50, мкс | ops/sec |
|---|---|---|---|
| SQLite, файл в процессе | библиотека вместо сервера | 11–15 | 48 910–68 550 |
| Postgres, unix-сокет | сервер без сети | 173–210 | 4 100–5 590 |
| Postgres, TCP через bridge-сеть Docker | сервер плюс сетевой хоп | 190–218 | 4 460–5 120 |
Разделить эти два вклада удалось лишь частично. Клиент-серверный слой измерим уверенно: разрыв между SQLite и Postgres через unix-сокет — то есть уже совсем без сети — держится на уровне примерно на порядок с лишним в каждом из шести кругов (посчитано по p50 в своём круге: от 12.6 до 19.1 раза). А вот сетевой хоп в этой топологии измерить не удалось: разница между TCP и unix-сокетом (tcp p50 минус uds p50), посчитанная в каждом круге отдельно, дала шесть значений — −9, +20, +12 мкс в первом прогоне и +8, +13, +20 мкс во втором. Знак меняется: в одном из шести кругов TCP оказался БЫСТРЕЕ unix-сокета. Ротация порядка плеч исключает позиционный артефакт; остаётся шум самого хоста, и на его фоне цена сетевого хопа в bridge-сети Docker меньше разброса измерения. Честный вывод: цену сетевого хопа в этой топологии нельзя назвать числом — она тонет в шуме хоста. Зато это делает более крупный вывод чище: разрыв между библиотекой в процессе и серверной СУБД составляет больше порядка величины, и сетевой хоп в этом разрыве не виден на фоне всего остального — того, что вообще отличает встроенную библиотеку от клиент-серверной модели (протокол, копирование буферов между процессами, переключение контекста) и один движок от другого (MVCC и планировщик Postgres против существенно более простой модели SQLite). На таких масштабах сеть — не тот фактор, о котором стоит думать; куда больше решает сама архитектура.
Долговечность выравнивает всё
Число выше — про чтение, и оно не переносится на запись без оговорки. Сравнивать SQLite с synchronous=NORMAL (fsync только при чекпойнте, риск потерять последние коммиты при отказе ОС) против Postgres с synchronous_commit=on (fsync WAL на каждый коммит) значило бы сравнивать разные обещания, а не разные скорости. На честной паре — оба плеча с полным fsync на коммит — картина меняется кардинально. Вставка одной строки, synchronous=FULL у SQLite и synchronous_commit=on у Postgres, тот же разброс по всем шести кругам обоих прогонов:
| Плечо | Гарантия | p50, мс | ops/sec |
|---|---|---|---|
| SQLite | synchronous=FULL, WAL — fsync на каждый коммит |
1.91–1.97 | 426–464 |
| Postgres, unix-сокет | synchronous_commit=on — fsync WAL на коммит |
1.93–2.04 | 476–538 |
| Postgres, TCP | synchronous_commit=on — fsync WAL на коммит |
1.96–2.03 | 516–539 |
Все три плеча сходятся в один и тот же диапазон 1.91–2.04 мс, и по пропускной способности SQLite на каждом из шести кругов без исключения немного проигрывает обоим Postgres-плечам: даже лучший круг SQLite (464 операции в секунду) ниже худшего круга любого из Postgres-плеч (476). Причина простая: fsync диска — операция, которая ждёт физику, а не архитектуру процесса, и она одна съедает всё преимущество «библиотеки вместо сервера». Это прямое ограничение заголовка статьи: на честной, полностью долговечной записи файл сервер не бьёт. SQLite выигрывает там, где сеть и протокол — заметная доля стоимости запроса (чтение, короткие транзакции с ослабленной долговечностью), а не там, где доминирует физический fsync.
Проверка на постороннюю нагрузку: стенд постоянно держит рядом с SQLite-файлом сервис litestream — он тикает раз в секунду и участвует в чекпойнтах WAL, а у Postgres-плеч такого сайдкара нет. Это могло объяснять весь разрыв. Контрольный прогон (fixtures/latency-no-litestream.txt) снят на той же ротации, что и основной (seed 777, три круга по латинскому квадрату), с остановленным litestream (docker compose stop litestream); остальные сервисы стенда работали как обычно.
Результат: SQLite — 460–475 оп/с по трём кругам, Postgres — 466–544 оп/с (нижняя граница — один просевший круг у pg-uds, где p99 подскочил до 6.3 мс; в двух остальных кругах Postgres держится на 538–544). SQLite проигрывает в каждом из трёх кругов контроля, включая тот, где Postgres просел. Разрыв по кругам тем же методом, что и в основном прогоне (ops/sec SQLite круга против среднего ops/sec двух Postgres-плеч того же круга) — 12.6%, 5.4%, 14.8% (в среднем около 10.9%) — против 12.6–15.8% (в среднем около 13.8%) в основном прогоне при живом litestream. Диапазоны пересекаются, но не совпадают: без litestream средний разрыв не вырос, а слегка сократился, и то за счёт одного шумного круга Postgres, а не из-за ускорения SQLite. Если бы сайдкар litestream объяснял отставание SQLite, его остановка должна была бы заметно сузить разрыв — вместо этого SQLite тем же порядком величины проигрывает и без litestream. Но это отдельный трёхкруговой прогон на другом состоянии хоста, а не парный A/B-тест на одинаковых условиях, и полностью исключить влияние сайдкара он не может. Из него следует ровно одно: контроль не подтвердил, что litestream объясняет отставание SQLite, — что не то же самое, что «litestream ни при чём».
Известное ограничение этого сценария: плечи pg-uds и pg-tcp пишут в одну и ту же таблицу events, поэтому за прогон в неё попадают вставки сразу обоих Postgres-плеч, а в файл SQLite — только одного. На p50 при засеве в 200 тысяч строк и точечных чтениях по первичному ключу это не сказывается, но рабочий набор Postgres в этом сценарии растёт быстрее, чем у SQLite, — и на хвосты вставок (p95, p99) в этой таблице опираться не стоит: перекос играет в пользу SQLite, а не против него.
Ещё одна оговорка: абсолютные значения выше — характерный прогон на одной машине (Docker Desktop на Windows), и стоимость fsync здесь — это стоимость конкретного диска под ней. Опираться стоит на соотношения (все три плеча сходятся к одному порядку, SQLite не выигрывает) и на порядок разрыва, а не на миллисекунды как на универсальную константу: на другом накопителе (NVMe с честным fsync против диска с write-back кешем, sync на облачном томе) абсолютные цифры и даже сам факт «кто чуть впереди» могут сдвинуться.
Граница одного писателя
Модель «библиотека в процессе» имеет прямую цену: блокировка на запись у SQLite одна на весь файл. Стенд растит число конкурентных писателей (1 → 16) двумя парами, согласованными по гарантии — иначе сравнение снова врёт: SQLite с ослабленной долговечностью против Postgres с полной ничего не доказывает, кроме разной строгости обещания.
Полная долговечность (fixtures/writers.txt, SQLite synchronous=FULL / Postgres synchronous_commit=on):
| Писателей | SQLite ops/sec | SQLite busy_errors | SQLite p99, мкс | Postgres ops/sec |
|---|---|---|---|---|
| 1 | 480 | 0 | 4 074 | 554 |
| 2 | 474 | 3 | 4 138 | 612 |
| 4 | 459 | 6 | 5 366 | 1 208 |
| 8 | 438 | 28 | 7 167 | 2 398 |
| 16 | 419 | 56 | 58 165 | 4 646 |
При росте конкуренции с 1 до 16 писателей пропускная способность SQLite не растёт, а падает — 480 → 419 операций в секунду, — а p99 разлетается с 4 074 до 58 165 мкс, в 14 раз. Ошибки блокировки (SQLITE_BUSY) появляются уже при двух одновременных писателях и растут дальше: 0 → 3 → 6 → 28 → 56 — это потерянные вставки, а не задержки: busy_timeout ждёт освобождения блокировки внутри драйвера, но если не дождался, клиент бенчмарка ошибку просто считает, повтора в коде нет, и строка не попадает в базу. ops_per_sec при этом засчитывает и провалившиеся попытки как выполненные операции — на 16 писателях это 56 из 20 000, то есть 0.28%; на вывод раздела не влияет, но называть это честнее. У Postgres в той же паре пропускная способность, наоборот, растёт с ростом конкуренции — с 554 до 4 646 операций в секунду, рост почти в 8.4 раза.
Контрольный прогон подтверждает, что это не артефакт настройки — но снят он на ослабленной паре (synchronous=NORMAL / synchronous_commit=off), а не на полной долговечности из таблицы выше: там при busy_timeout=0 на восьми писателях busy_errors подскакивает с 0 (штатный таймаут 5000 мс, тот же ослабленный режим) до 18 171 — таймаут действительно маскирует часть блокировок под задержку, а не устраняет их. Это не то же самое, что таблица выше: там на полной долговечности при восьми писателях уже 28 ошибок при штатном таймауте — два прогона на соседних строках фикстуры используют разные гарантии, и сравнивать их напрямую нельзя.
Ослабленная долговечность (SQLite synchronous=NORMAL / Postgres synchronous_commit=off):
| Писателей | SQLite ops/sec | Postgres ops/sec |
|---|---|---|
| 1 | 14 645 | 5 176 |
| 2 | 17 018 | 10 607 |
| 4 | 17 298 | 19 423 |
| 8 | 16 574 | 31 984 |
| 16 | 13 744 | 42 956 |
Здесь SQLite стартует почти втрое быстрее Postgres (14 645 против 5 176 на одном писателе), но Postgres обгоняет его уже на четырёх конкурентных писателях (19 423 против 17 298) и дальше отрывается всё сильнее.
Главный вывод этого раздела не в конкретных числах, а в форме кривой: SQLite не отказывает открыто — он молча превращает конкуренцию в задержку (или, при исчерпании busy_timeout, в ошибку). Мониторинг, настроенный на частоту ошибок, эту границу не увидит: на ослабленной паре ошибок блокировки в фикстурах нет вовсе, при этом пропускная способность уже проигрывает Postgres при четырёх писателях. Сравнивать при этом можно только пары с одинаковой гарантией долговечности: SQLite с ослабленной гарантией против Postgres с полной границу прячет.
Из этого раздела не следует, что запись из нескольких горутин/процессов в SQLite обречена — есть практический паттерн, который убирает большую часть боли, не отменяя саму границу. Один процесс-писатель, которому все остальные передают операции через очередь (канал в приложении, отдельная горутина или сервис), плюс пакетирование нескольких логических записей в одну транзакцию — почти полностью убирают SQLITE_BUSY и заметно поднимают пропускную способность по сравнению с наивной конкурентной записью из N потоков. Это не превращает SQLite в многописательную БД: коммиты по-прежнему идут по одному, просто поток записи больше не соревнуется сам с собой за блокировку файла — паттерн убирает искусственные потери от внутрипроцессной конкуренции, а не поднимает потолок числа одновременных писателей выше одного.
litestream: восстановление, а не обещание
Копия одного файла — бэкап только после штатного закрытия базы с завершённым checkpoint (оговорка выше); для живой базы в WAL-режиме без чекпойнта или Backup API это не бэкап, а риск неполного или рваного снимка. И даже корректно снятая копия на одном диске — это единственная копия. WAL-режим сам по себе не защищает от потери диска или контейнера целиком; для этого стенд гоняет litestream — непрерывный стриминг WAL в S3-совместимое хранилищеСкоро — и проверяет не декларацию «данные в безопасности», а факт: сколько строк реально пережило отказ.
Проверка честная: RPO зависит от типа отказа, а не от того, как настроен litestream. Важная оговорка сразу: сценарий ниже — не гибель хоста целиком. MinIO с уже реплицированными данными в этом стенде живёт в том же Compose-проекте на том же хосте, что и bench с litestream, — реальная гибель хоста унесла бы и хранилище тоже, и восстанавливать данные было бы уже неоткуда. Измерено более узкое, но реалистичное: одновременное убийство писателя и репликатора при сохранном объектном хранилище — это модель отказа приложения или узла при удалённом объектном хранилище (S3 — внешний сервис), а такая топология как раз типична. Три прогона (docker kill одной командой по контейнерам bench и litestream — команда одна, но атомарности между двумя SIGKILL она не гарантирует):
| Прогон | Строк до отказа | Строк после восстановления | Потеряно |
|---|---|---|---|
| 1 | 253 166 | 250 950 | 2 216 |
| 2 | 257 459 | 252 736 | 4 723 |
| 3 | 254 301 | 248 708 | 5 593 |
Диапазон потерь — от 2 216 до 5 593 строк за прогон, не одно фиксированное число: litestream синхронизирует WAL периодически (интервал около секунды), и хвост, не успевший уйти в S3 до момента SIGKILL, пропадает вместе с самим процессом litestream. Это и есть цена одновременной гибели писателя и репликатора при сохранном хранилище — вопрос RPO, а не багов настройки. В трёх прогонах потеряно 2 216–5 593 строки. Временной RPO в этом сценарии не измерялся: темп записи непосредственно перед отказом и время, за которое накопился потерянный хвост, стенд не фиксирует. Для ориентира, и только как условная оценка: если бы писатель шёл с темпом из другого теста — около 14 600 вставок в секунду у одного писателя на synchronous=NORMAL (раздел выше), — эти строки соответствовали бы примерно 150–380 мс записи. Измерением это не является.
Совсем другая картина — если умирает только приложение, а litestream остаётся жив (fixtures/restore-app-only.txt): живой litestream успевает дотянуть хвост WAL сам, без вмешательства, и после восстановления из S3 не теряется ни одной строки. Это пока единственный прогон сценария, а не диапазон по нескольким кругам, как для одновременного убийства обоих контейнеров выше, — формулируем осторожно: в единственном прогоне потерь не было, а не «потерь не бывает». Разница между этими двумя сценариями — и есть практический смысл раздела disaster recovery: RPO SQLite+litestream — это RPO живого процесса-репликатора, а не самой базы данных, и он резко ухудшается, если репликатор умирает вместе с источником.
⚠️ Приём с одновременным убийством контейнеров проверен только на Windows/Git Bash; поведение docker kill с несколькими ID на другой платформе стоит перепроверить, прежде чем опираться на конкретные числа диапазона.
SQLite против DuckDB: разные оси
Дальше — не «кто быстрее», а «на какой оси». SQLite — строковое хранилище (row-store), DuckDB — колоночное (column-store) при том же принципе встраиваемости: обе — библиотека в процессе, без сервера. Стенд засевает обе БД одинаковыми 1 000 000 строк и замеряет два принципиально разных запроса на одних и тех же данных: аналитическую агрегацию по всей таблице и точечное чтение по первичному ключу (fixtures/olap.txt).
Перед числами — план SQLite, снятый EXPLAIN QUERY PLAN дословно:
$ bash scripts/run-olap.sh
# (выдержка: блоки EXPLAIN QUERY PLAN, заголовки сокращены)
== план по умолчанию ==
SCAN events USING INDEX idx_events_user

== NOT INDEXED (индекс запрещён явно) ==
SCAN events
USE TEMP B-TREE FOR GROUP BY
По умолчанию планировщик SQLite действительно идёт через индекс idx_events_user — и это не бесплатно: индекс некроющий (не содержит amount), поэтому за каждой из миллиона строк следует отдельное обращение к таблице по rowid. Результат — три числа (p50, 10 замеров на 1 млн строк):
| Запрос | p50 | ops/sec |
|---|---|---|
| SQLite, агрегация, план по умолчанию (индекс) | 1 448 910 мкс (~1.45 с) | 0.68 |
SQLite, агрегация, NOT INDEXED (полный скан) |
395 264 мкс (~0.40 с) | 2.51 |
| DuckDB, агрегация | 2 578 мкс (~2.6 мс) | 382.38 |
| SQLite, точечное чтение по ключу | 8 мкс | 95 363 |
| DuckDB, точечное чтение по ключу | 636 мкс | 1 545 |
Разрыв раскладывается на два независимых эффекта, и их нельзя перемножать — это не одно измерение, а два разных эффекта на разных выборках, оба оценены по 10 замерам (p95/p99 для агрегации намеренно не публикуются: при n=10 метод nearest-rank даёт один и тот же индекс выборки для обоих перцентилей, различить хвосты на такой выборке нельзя):
- Эффект плана (SQLite с индексом против SQLite без индекса): 1 448 910 / 395 264 — по порядку величины около 3.7 раза. Индекс, созданный ради ускорения точечных чтений, на этом аналитическом запросе не ускоряет агрегацию, а замедляет её почти вчетверо: планировщик всё равно идёт через него и платит миллионом обращений по rowid за каждую строку.
- Разрыв между движками на агрегации (SQLite без индекса, честный full scan, против DuckDB): 395 264 / 2 578 — по порядку величины около 153 раз. На этом запросе и на этом стенде DuckDB быстрее SQLite на два порядка. Колоночная раскладка — вероятная, но не доказанная здесь причина: DuckDB читает только нужные столбцы плотными векторами, тогда как SQLite поднимает всю строку целиком, — но сравниваются два целиком разных движка со своими планировщиками и исполнителями, а не чистый эффект ориентации хранения в отрыве от всего остального; стенд не умеет развести эти вклады порознь.
На точечном чтении по ключу — обратная картина: SQLite около 8 мкс (p95=16, p99=32) против DuckDB около 636 мкс (p95=745, p99=860) — колоночный движок платит за сборку одной строки из отдельно лежащих столбцов там, где row-store просто читает страницу. Значит, тезис «встраиваемость и колоночность — независимые оси» подтверждён числами, а не вкусовым выбором: SQLite и DuckDB одинаково не требуют сервера, но оптимизированы под противоположные профили запроса.
Отдельная оговорка про методику засева, честности ради: SQLite и DuckDB в этом замере засевались по-разному — SQLite пакетными INSERT (идиоматичный способ для встраиваемой row-store БД), DuckDB — через нативный Appender (идиоматичный способ объёмной загрузки для колоночной БД, тот же путь, которым в DuckDB загружают Parquet/CSV). Обе БД засевались одними и теми же данными, и замерялись только SELECT после загрузки — но отдельного замера, который исключил бы влияние способа загрузки на физическую раскладку страниц/векторов на диске, в стенде нет.
Более широкий разбор, когда вообще пора смотреть в сторону колоночного хранения и OLAP-специализированных СУБД (не только DuckDB) — в «ClickHouse и специализированные time-series БД», а общая карта альтернатив хранения и обработки данных — в хабе «Карта данных».
Репликация и встраиваемые KV — обзорно
Две смежные темы стенд не мерил вовсе — честно об этом и говорим, вместо того чтобы утроить объём статьи ради абзаца.
Репликация поверх SQLite. LiteFS и rqlite решают ту же проблему единственной точки записи по-разному: LiteFS реплицирует файл на уровне FUSE-перехвата операций записи и позволяет промотировать реплику в primary, rqlite оборачивает SQLite в Raft-консенсус и превращает его в полноценный распределённый кластер с сетевым протоколом записи. Ни одна из схем не масштабирует конкурентную запись из раздела про границу одного писателя: у LiteFS пишет только primary, остальные узлы — реплики, доступные исключительно на чтение; у rqlite запись сериализует единственный leader через Raft, остальные узлы её лишь применяют. Обе схемы решают доступность и распределённость чтения, добавляя ценой сетевого хопа и координации — но потолок в один писатель остаётся тем же самым, просто теперь он называется primary или leader, а не файлом на диске. Мы их не мерили: цифры выше про сам SQLite, а не про надстройки над ним.
Встраиваемые KV — RocksDB, BadgerDB, LMDB — решают соседнюю, но другую задачу: движок хранения без SQL-слоя поверх него, когда нужен именно движок (LSM или B-tree на диске), а не реляционная модель и запросы. Они ближе к устройству storage-движковСкоро, чем к SQLite как таковому, и заслуживают отдельного замера, а не строчки в этой статье. Пометка та же: не мерили, сравнение с SQLite здесь не приводится.
Чек-лист выбора
- Профиль нагрузки — чтение или точечные операции, один процесс или немного читателей. SQLite реально бьёт сервер по латентности (больше порядка величины на чтении даже без сети — 12.6–19.1 раза по кругам замера — а сетевой хоп в этом разрыве не виден на фоне шума хоста) и по простоте деплоя — файл вместо инфраструктуры.
- Нужна честная долговечность на каждый коммит (
synchronous=FULL). Здесь SQLite не выигрывает у Postgres вовсе — все три плеча сходятся к fsync-стоимости диска, а по пропускной способности SQLite даже немного проигрывает. - Больше одного конкурентного писателя. Уже на двух писателях с полной долговечностью появляются
SQLITE_BUSY; к 16 писателям пропускная способность падает, а p99 растёт на порядок. Многопользовательский write-heavy OLTP — это вопрос моделирования схемы данныхСкоро под клиент-серверную БД, не под SQLite. - Нужна защита не только от падения самого процесса, но и от одновременной гибели писателя и репликатора при живом внешнем хранилище. litestream в единственном прогоне дал RPO, близкий к нулю, если репликатор остаётся жив вместе с приложением, но теряет 2 216–5 593 строки (три прогона; временной RPO не измерялся), если писатель и репликатор гибнут одновременно, а S3-хранилище остаётся доступно — считайте это RPO репликатора, а не самой базы. Это не модель гибели узла целиком вместе с хранилищем: та в этом стенде не измерялась.
- Нагрузка — аналитическая агрегация по большому объёму, а не точечный доступ. Здесь встраиваемость не помогает сама по себе: нужен колоночный движок вроде DuckDB, а не индекс поверх SQLite — некроющий индекс на этом классе запросов не ускоряет, а замедляет.
- Нужен движок без SQL и без сервера. Встраиваемые KV (RocksDB/BadgerDB/LMDB) — отдельный класс решений, не измеренный здесь; для распределённой записи поверх SQLite — LiteFS/rqlite, тоже не измеренные в этом стенде.
Источники
- SQLite — Write-Ahead Logging, File Locking And Concurrency
- litestream — How it works
- LiteFS — How it works
- rqlite — FAQ
- DuckDB — Why DuckDB, Data Import: Appender
- Стенд:
digital-cookbook/databases/sqlite/(SQLite 3.53.4, PostgreSQL 18.6, DuckDB v1.4.1, litestream 0.5.16)

Комментарии