
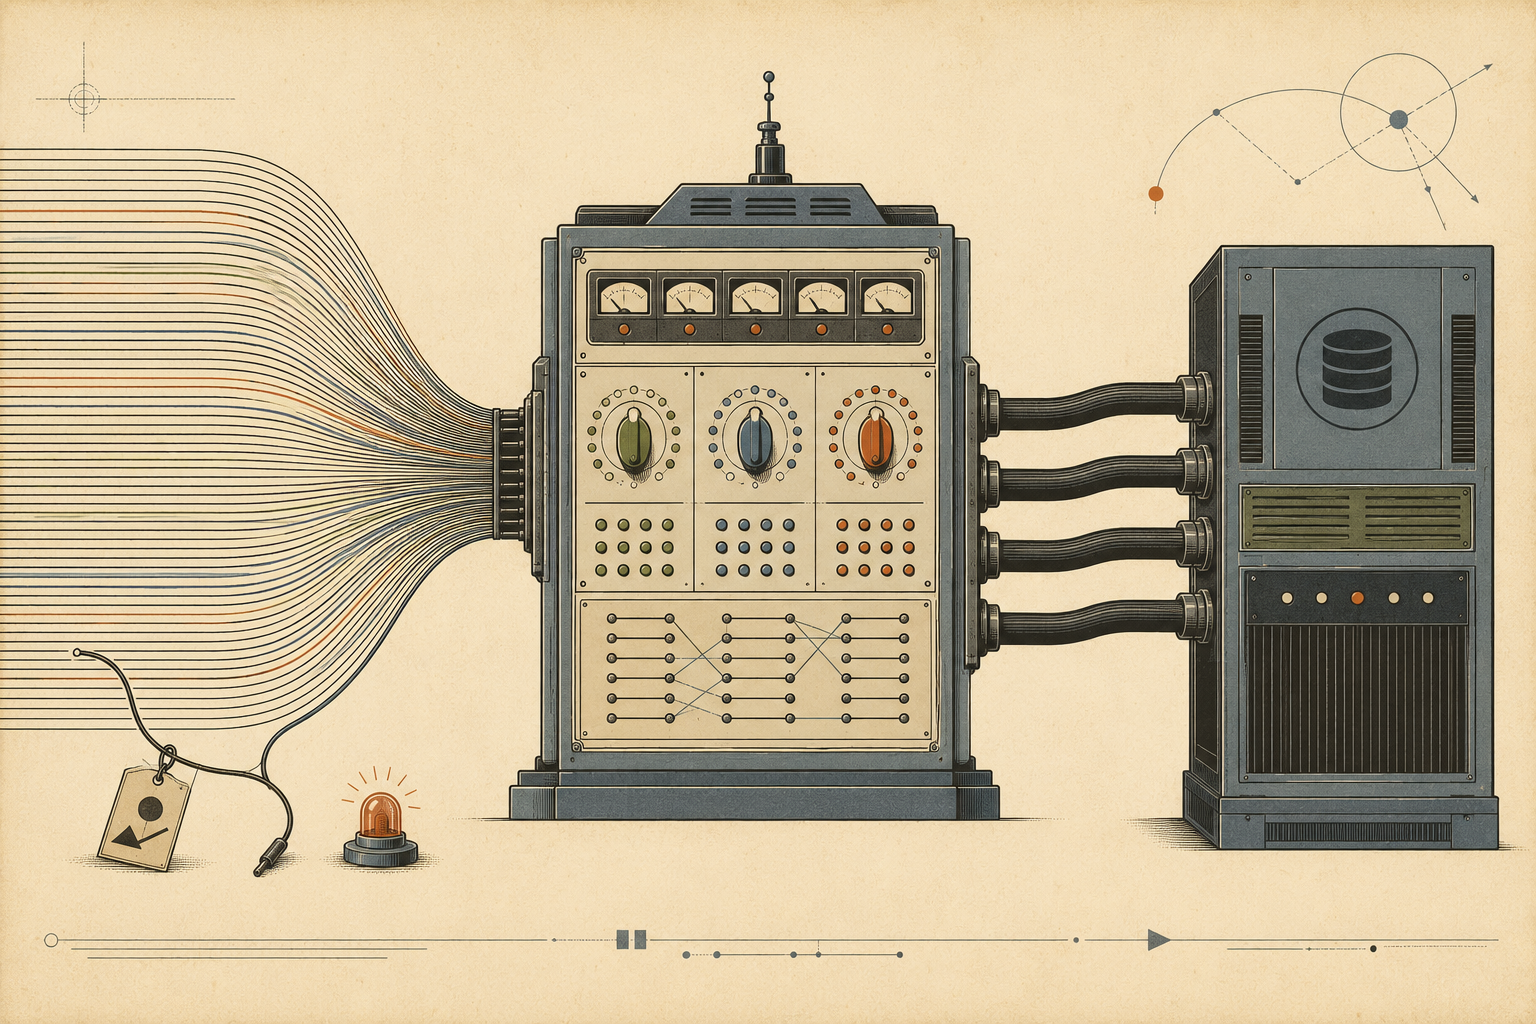
Каждое соединение с PostgreSQL — это отдельный процесс на сервере со своей памятью. Сотня активных приложений с пулом по 20 соединений легко упирается в max_connections, и база начинает захлёбываться на переключениях контекста задолго до исчерпания CPU по полезной работе. Инфраструктурный пулер ставит между приложением и базой узкое горлышко из немногих реальных соединений, мультиплексируя на них тысячи клиентских. Цена — часть привычной семантики сессии перестаёт работать.
Это вторая статья серии «PostgreSQL в проде». Важно не путать пулер перед базой с пулом соединений в приложении: клиентский пул (pgxpool, HikariCP) разобран в «Надёжная работа с PostgreSQL из Go, Java и Rust». Здесь — про отдельный слой инфраструктуры, который стоит перед PostgreSQL и обслуживает много приложений сразу. Все числа ниже — из живого стенда postgres-ops/pooling в публичном репозитории digital-cookbook: PostgreSQL 18.4 с max_connections=100 и три пулера бок о бок — PgBouncer 1.25.2, pgcat 1.2.0, Odyssey 1.5.1, каждый в режиме transaction pooling с pool_size=5.
В статье
- Почему соединение — дорогой ресурс
- Три режима пулинга
- Что ломает transaction pooling
- PgBouncer, pgcat, Odyssey
- Где ставить пулер и пул поверх пула
Почему соединение — дорогой ресурс
Модель PostgreSQL — процесс на соединение. Каждый клиент, подключившийся к базе, получает отдельный серверный процесс-бэкенд со своей памятью: приватные буферы, кеши каталога, рабочая память под сортировки и хеши (work_mem, по умолчанию на стенде 4 МБ, и это на каждый узел плана, а не на запрос). Сотни таких процессов конкурируют за CPU, и планировщик ОС тратит всё больше времени на переключения контекста между ними — база деградирует задолго до того, как исчерпает процессор полезной работой. Жёсткий потолок задаёт max_connections; упереться в него — значит получить отказ новым клиентам.
Инфраструктурный пулер разрывает связь «клиент = процесс». Он держит небольшой пул реальных серверных соединений и мультиплексирует на них множество клиентских. На стенде это видно буквально: 50 клиентов бьют по каждому endpoint, а мы считаем реальные соединения к PostgreSQL:
напрямую (без пулера)          server-бэкендов при 50 клиентах: 50  (всего pgbench-бэкендов в базе: 50)
через PgBouncer (pool=5)        server-бэкендов при 50 клиентах: 5   (всего pgbench-бэкендов в базе: 5)
через pgcat (pool=5)            server-бэкендов при 50 клиентах: 5   (всего pgbench-бэкендов в базе: 10)
через Odyssey (pool=5)          server-бэкендов при 50 клиентах: 5   (всего pgbench-бэкендов в базе: 15)
Напрямую 50 клиентов — это 50 процессов на сервере, по одному на соединение. Через любой пулер те же 50 клиентов обслуживаются горсткой реальных соединений: все три держат ровно pool_size=5. Именно это спасает max_connections, когда перед базой не одно приложение, а десятки, и у каждого свой клиентский пул.
Вторая колонка в выводе — не украшение, и на ней стоит задержаться, потому что первая редакция этого замера читалась иначе. Она считала все pgbench-бэкенды в базе, без привязки к тому, чей это пул, и давала ряд 5 → 10 → 15, из которого напрашивался вывод «у каждого пулера своя политика роста». Вывод был неверный. Пулер после ухода клиентов не закрывает server-соединения, а держит их в пуле до server_idle_timeout — поэтому каждый следующий замер видел свои пять плюс всё, что осталось от предыдущих. Ряд 5 → 10 → 15 был суммой, а не поведением, и колонка «всего» воспроизводит его в точности. Проверяется это одной перестановкой: если запустить пулеры в обратном порядке, «своих» у каждого снова окажется по пять, а росла бы «политика» — она переехала бы вместе с порядком. Теперь замер привязан к client_addr конкретного пулера, а сам пулер перезапускается перед своим замером, чтобы пул стартовал пустым.
Три режима пулинга
Пулеры различаются тем, когда серверное соединение возвращается в пул. Это и определяет и степень экономии, и то, какая семантика ломается.
- Session pooling — серверное соединение закреплено за клиентом на всю его сессию, от подключения до отключения. Полная семантика обычного соединения (всё работает), но мультиплексирование минимально: idle-клиент, ничего не делающий, всё равно держит серверное соединение.
- Transaction pooling — серверное соединение занимается на транзакцию и возвращается в пул сразу после
COMMIT/ROLLBACK. Это боевой режим для веб-нагрузки: между транзакциями клиент не держит серверный ресурс, и мультиплексирование максимально. - Statement pooling — серверное соединение возвращается после каждого оператора. Ещё агрессивнее, но транзакция из нескольких операторов становится невозможной в принципе.
Разница между режимами — не в цифрах, а в семантике, и её видно на границе. В statement pooling простой BEGIN; SELECT; SELECT; COMMIT;, поданный отдельными запросами, падает:
### statement — многооператорная транзакция
FATAL:  transaction blocks not allowed in statement pooling mode
Тот же блок в transaction и session режимах отрабатывает штатно. Логика прямая: statement-режим отдаёт серверное соединение после каждого оператора, поэтому второй оператор транзакции попал бы уже на другой backend, где нет открытого BEGIN. Statement pooling применяют редко и точечно (только автокоммит-запросы, максимум мультиплексирования); transaction pooling — стандартный выбор.
Что ломает transaction pooling
Главный компромисс transaction pooling: нельзя полагаться на состояние, живущее поверх транзакции. Между двумя транзакциями одного клиента серверное соединение может смениться, и всё, что было привязано к прежнему backend, пропадает. Но конкретный список того, что ломается, за последние годы изменился — и это стоит знать, чтобы не переносить в прод устаревшие страхи.
Prepared statements — исторический пример, который сегодня уже не проблема. Классическая беда: сервер готовит именованный prepared statement на одном backend, а следующий запрос уходит на другой, где его нет. На стенде это воспроизводится, но только если отключить современную поддержку (max_prepared_statements=0):
max_prepared_statements=0:  ERROR: prepared statement "P_0" does not exist
                            ERROR: prepared statement "P_0" already exists
А вот с настройкой по умолчанию в PgBouncer 1.25.2 — max_prepared_statements=200 — тот же pgbench -M prepared на 10 клиентах отрабатывает без единой ошибки: 500 транзакций, ~11 000 tps. PgBouncer с версии 1.21 отслеживает prepared statements и переигрывает их на каждый серверный backend. То же подтверждает и Go-клиент на pgx (который по умолчанию кеширует prepared): через дефолтный PgBouncer все запросы проходят. Вывод для 2026 года: транслировать «transaction pooling ломает prepared statements» как актуальную проблему — ошибка; современные пулеры их поддерживают штатно.
LISTEN/NOTIFY — ломается надёжно и не лечится настройкой. Подписка LISTEN живёт, пока держится тот же серверный backend. В transaction pooling он отвязывается после транзакции с LISTEN, и уведомление не доходит. Go-проверка (слушатель и отправитель — разные соединения):
через PgBouncer (transaction)  уведомление ПОТЕРЯНО (за 2 c не пришло)
напрямую к postgres            уведомление ПОЛУЧЕНО
Сессионные SET — работают обманчиво, и это опаснее явной поломки. На стенде SET application_name = 'breaker' с последующим SHOW в другой транзакции вернул breaker — настройка «сохранилась». Но это артефакт малой нагрузки: с одним клиентом PgBouncer держит один серверный backend (sticky), и SET случайно переживает границу транзакции. Под реальной конкуренцией за пул тот же backend достанется другому клиенту, и настройка исчезнет. Это худший класс багов: работает в тесте, ломается в проде под нагрузкой. Тот же принцип касается session-level advisory locks, WITH HOLD курсоров и временных таблиц — всё, что привязано к сессии, а не к транзакции.
Практический вывод один: в transaction pooling приложение не должно держать состояние в соединении между транзакциями. Всё, что нужно транзакции, устанавливается внутри неё (SET LOCAL, а не SET).
PgBouncer, pgcat, Odyssey
Три пулера решают одну задачу, но по-разному. PgBouncer — проверенный временем, лёгкий, однопроцессный; делает пулинг и делает его надёжно, но без шардинга и продвинутой балансировки. pgcat — на Rust, многопоточный; умеет шардинг, балансировку нагрузки, роутинг чтения на реплики и авто-failover пула. Odyssey — тоже многопоточный, от Yandex; актуален для российской инфраструктуры и хорошо масштабируется по ядрам.
Ценность пулера — не в ускорении устойчивой нагрузки (там малый пул наоборот стал бы горлышком), а в защите базы и удешевлении переподключений. Два сценария со стенда, оба read-only.
Перегрузка: 150 клиентов при max_connections=100.
напрямую к postgres   FATAL: sorry, too many clients already   ← база ОТКАЗЫВАЕТ
через PgBouncer       tps = 13550
через pgcat           tps = 21999
через Odyssey         tps =  9195
Это главный аргумент за пулер: 150 клиентов не помещаются в 100 соединений, и напрямую лишние получают отказ. Пулер мультиплексирует их на 5 серверных соединений — работают все.
Переподключение (-C): новое соединение на каждую транзакцию.
напрямую к postgres   tps = 2144   (avg connection 3.68 ms)   ← форк процесса на каждую
через PgBouncer       tps = 4043   (avg connection 1.93 ms)
через pgcat           tps = 4759   (avg connection 1.65 ms)
через Odyssey         tps = 4824   (avg connection 1.13 ms)
Установка соединения к PostgreSQL — это форк серверного процесса, дорого. Пулер держит серверные соединения готовыми и переиспользует их: переподключение выходит примерно вдвое дешевле и быстрее. Различия между пулерами (pgcat лидирует под перегрузкой, Odyssey — на переподключении) — реальная разница реализаций многопоточных пулеров против однопоточного PgBouncer, но все три решают главную задачу. Выбор прост: PgBouncer — когда нужен «просто пулинг»; pgcat или Odyssey — когда нужны шардинг, балансировка и read-роутинг.
Где ставить пулер и пул поверх пула
Топологически пулер ставят либо sidecar’ом рядом с каждым приложением (короткий путь, много инстансов пулера), либо централизованным слоем перед базой (единая точка контроля — но и единая точка отказа, которую надо резервировать). В HA-топологии из первой статьи серии пулер естественно сочетается с Patroni: тот же HAProxy с проверкой Patroni REST направляет пулер на текущего лидера, и после failover пул автоматически переподключается к новому primary.
Отдельная ловушка — пул поверх пула. Клиентский пул в приложении (pgxpool, HikariCP) и инфраструктурный пулер перемножаются: если 20 инстансов приложения держат по 20 клиентских соединений, это 400 соединений к пулеру, и при большом pool_size они превратятся в столько же серверных, сведя пулинг на нет. Рабочая рекомендация — маленький клиентский пул в приложении плюс transaction pooling в PgBouncer с небольшим pool_size, подобранным под число ядер БД. Тогда клиентские соединения дёшевы (они к пулеру, не к базе), а число реальных серверных соединений остаётся под контролем.
Следующая статья серии переходит от слоя перед базой к обслуживанию её хранилища: «Партиционирование, VACUUM и борьба с bloat в PostgreSQL»готовится, с 2 октября — откуда берётся распухание таблиц из-за MVCC и как его убирать без простоя. А чтение планов запросов, которые пулер сам по себе не ускорит, — в статье «Оптимизация запросов PostgreSQL: EXPLAIN на практике»готовится, с 6 октября; замыкает серию боевой кейс «TimescaleDB под Zabbix»готовится, с 14 октября.
Источники
- PostgreSQL Documentation — 20.3. Connections and Authentication (
max_connections) - PgBouncer Documentation — pool modes,
max_prepared_statements· pgcat · Odyssey - Стенд:
postgres-ops/pooling(PostgreSQL 18.4, PgBouncer 1.25.2, pgcat 1.2.0, Odyssey 1.5.1, Go 1.26.3 / pgx v5.10.0)


Комментарии