
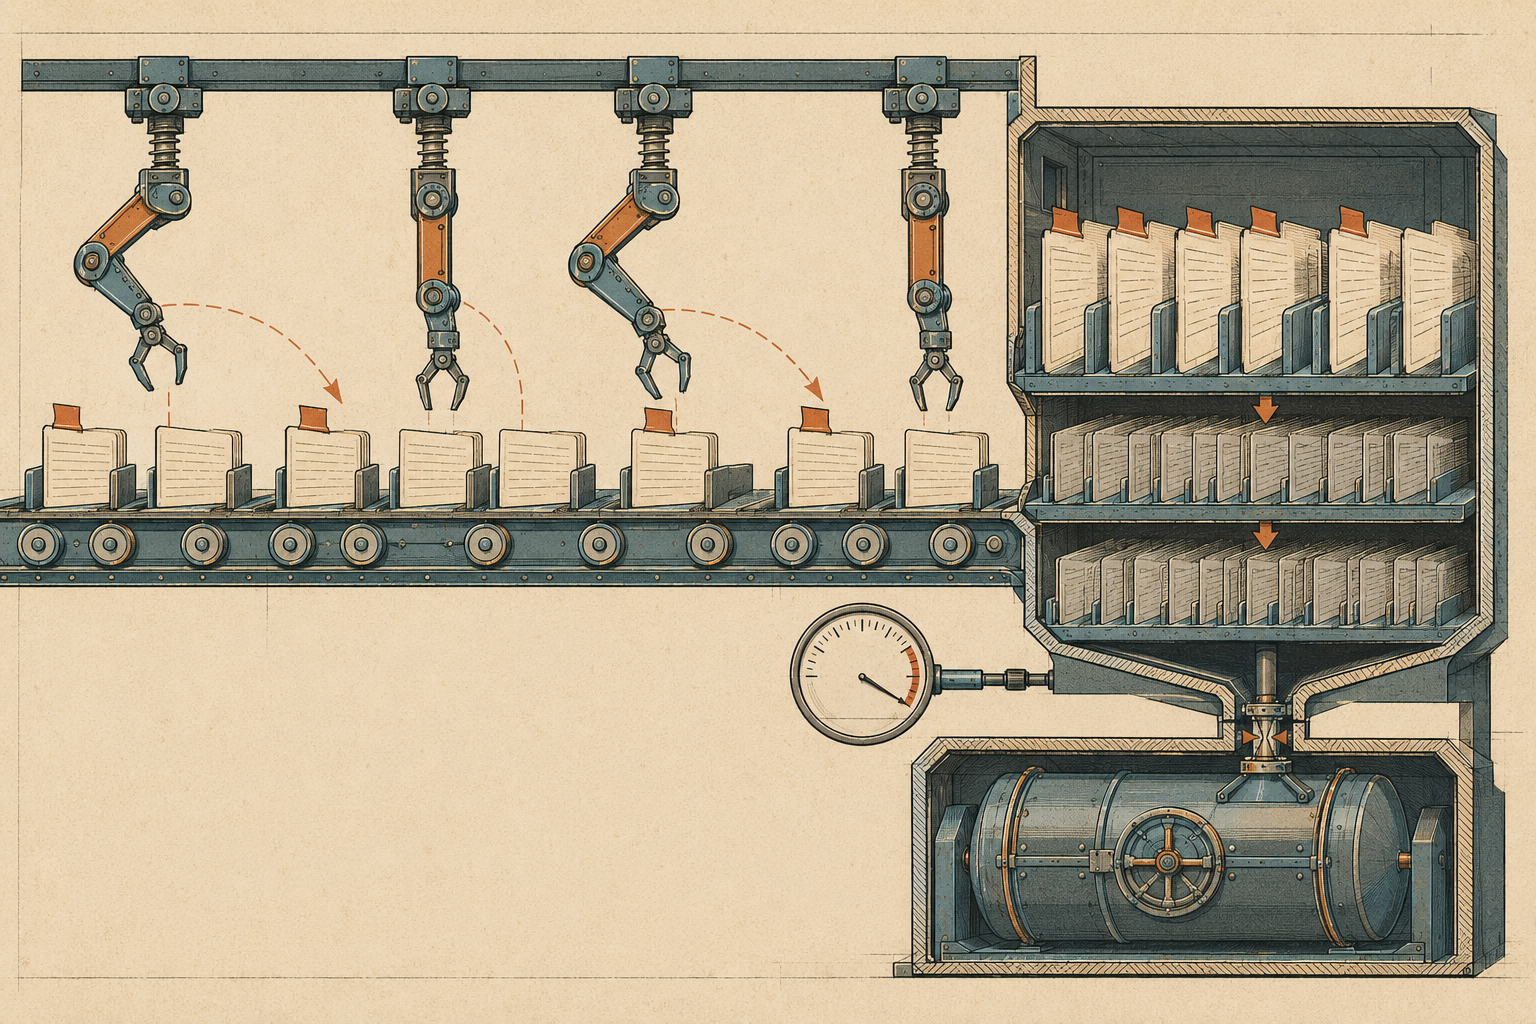
Отдельный брокер ради очереди задач нужен не всегда. Если PostgreSQL у вас уже есть, он умеет быть очередью — и главный аргумент здесь даже не «одной системой меньше», а то, что джоба ставится в той же транзакции, что и бизнес-данные. Заказ создан и письмо поставлено в очередь — либо оба факта, либо ни одного. Ни один брокер этого не даст по построению.
Дальше начинается инженерия. FOR UPDATE SKIP LOCKED покупает не то, что обычно думают. Опрос против LISTEN/NOTIFY — выбор с ценой на обеих сторонах. Очередь — таблица с высочайшим оборотом строк, то есть худший случай для MVCC. И у всей конструкции есть потолок, у которого обнаружилась неожиданная форма.
Эта статья — третья, заключительная в серии «Фоновые задачи и планировщики». Механика владения джобой — аренда, heartbeat, возврат брошенных — разобрана в первой статье и здесь не повторяется: там она подавалась как концепция, применимая к любому хранилищу, здесь речь про то, что даёт и чего стоит именно PostgreSQL.
В статье
- Козырь: джоба и данные в одной транзакции
- Что покупает SKIP LOCKED (и чего не покупает)
- Как воркер узнаёт о джобе: опрос против LISTEN/NOTIFY
- Очередь — худший случай для MVCC
- Потолок пропускной способности
- Форма кривой: насыщение сбросов и группировка коммитов
- Когда всё-таки нужен брокер
- Демо и версии
- Документация
Козырь: джоба и данные в одной транзакции
Начну с единственного преимущества, которое нельзя воспроизвести никаким брокером.
Классическая беда связки «база плюс брокер» — запись в два места без общей транзакции. Сервис создал заказ в PostgreSQL и должен отправить событие в RabbitMQ. Между этими двумя действиями он может упасть: заказ есть, события нет. Или наоборот — событие ушло, а транзакция откатилась, и потребитель обрабатывает заказ, которого не существует. Это dual-write, и лечится он отдельным механизмом — transactional outbox, где событие пишется в ту же базу отдельной таблицей, а в брокер его переносит фоновый процесс.
Очередь в той же базе делает этот механизм ненужным, потому что становится им сама:
BEGIN;
  INSERT INTO orders (customer_id, total) VALUES ($1, $2) RETURNING id;
  INSERT INTO jobs (kind, payload) VALUES ('send_receipt', jsonb_build_object('order_id', $3));
COMMIT;
Атомарность здесь бесплатная и полная: нет заказа без джобы и джобы без заказа. Откат транзакции убирает оба факта, и никакой компенсации писать не нужно.
Это не «ещё один плюс к списку» — это тот случай, когда БД-очередь решает задачу качественно проще, чем связка из двух систем. Всё остальное в статье — цена, которую за это платят.
Что покупает SKIP LOCKED (и чего не покупает)
Запрос захвата джобы выглядит так — и внимание обычно приковано к последней строке подзапроса:
UPDATE jobs SET state = 'running', attempt = attempt + 1,
                leased_by = $1, leased_until = now() + $2::interval,
                updated_at = now()
WHERE id = (SELECT id FROM jobs
            WHERE state = 'queued' AND run_at <= now()
            ORDER BY run_at, id
            FOR UPDATE SKIP LOCKED
            LIMIT 1)
RETURNING id, kind, payload, attempt, max_attempts
Распространённое объяснение: «SKIP LOCKED не даёт двум воркерам взять одну джобу». Это неверно, и проверяется прямо.
В стенде есть тест, который берёт джобу дважды подряд и убеждается, что второй раз она не выдаётся. Он проходит и при полностью убранном SKIP LOCKED — потому что вызовы в нём последовательные, гонки нет, а джобу удерживает переход queued → running, который случился при первом захвате. Тест, который выглядел доказательством, не доказывал ничего.
Настоящая гонка проверяется иначе: восемь воркеров стартуют одновременно, каждый берёт джобу, все идентификаторы обязаны быть различными. Существенная деталь — у этого теста собственный пул на восемь соединений: с пулом по умолчанию горутины ждали бы свободное соединение и выполнялись бы фактически по очереди, гонки не возникло бы, а тест всё равно был бы зелёным.
Этот тест действительно ломается, если разнести выборку и обновление на два запроса: джоба id=1 выдана 2 раз — двойное исполнение. Проверено заменой захвата на неатомарный вариант.
Эксклюзивность захвата даёт атомарность запроса плюс переход состояния. SKIP LOCKED покупает пропускную способность. Разница видна на времени ожидания. Сессия A держит первую по порядку queued-строку четыре секунды, сессия B пытается взять джобу тем же запросом:
=== БЕЗ SKIP LOCKED: вторая сессия ЖДЁТ первую ===
сессия B ждала: 3044 мс (ожидание блокировки первой строки, удерживаемой сессией A)

=== СО SKIP LOCKED: вторая сессия берёт СЛЕДУЮЩУЮ строку сразу ===
сессия B получила строку id=2 за 106 мс — не дожидаясь первой (строка сессии A пропущена)

--- ожидания блокировок в логе PostgreSQL за ТЕКУЩИЙ прогон ---
без SKIP LOCKED: 1 ожидание(й)
со SKIP LOCKED:  0 ожидание(й)
Без SKIP LOCKED вторая сессия ждёт освобождения ровно той строки, которую заняла первая: все воркеры выстраиваются в очередь за одной и той же головой очереди, и параллелизм схлопывается до единицы. С ним каждый пропускает занятое и берёт следующее свободное.
Порядок величины здесь — секунды против сотни миллисекунд; конкретные 3044 и 106 приводить как константы не стоит, они зависят от машины. Устойчива качественная часть: ноль ожиданий блокировок против как минимум одного в журнале PostgreSQL.
Практический вывод: убрать SKIP LOCKED — не значит получить двойное исполнение. Это значит получить очередь, которая обрабатывается по одной джобе за раз, сколько бы воркеров вы ни запустили.
Как воркер узнаёт о джобе: опрос против LISTEN/NOTIFY
Опрос — цикл «спросил, пусто, поспал 100 мс». Просто, надёжно, и задержка подхвата равномерно размазана по интервалу опроса: в среднем половина интервала, в худшем — весь.
LISTEN/NOTIFY — механизм уведомлений PostgreSQL: триггер на таблице шлёт сигнал в канал, подписанный воркер просыпается сразу.
CREATE TRIGGER jobs_notify_ins
    AFTER INSERT ON jobs
    FOR EACH ROW EXECUTE FUNCTION notify_job_enqueued();

CREATE TRIGGER jobs_notify_requeue
    AFTER UPDATE OF state ON jobs
    FOR EACH ROW
    WHEN (NEW.state = 'queued' AND OLD.state IS DISTINCT FROM 'queued')
    EXECUTE FUNCTION notify_job_enqueued();
Второй триггер здесь — не симметрия ради красоты. Джоба становится доступной не только при вставке: возврат брошенной джобы после истечения аренды делает её queued через UPDATE. Если будить воркеров только на INSERT, о возвращённой джобе они узнают лишь следующим опросом — то есть LISTEN/NOTIFY молча деградирует до опроса ровно в том сценарии, ради которого писалась аренда. Замер поэтому идёт по обоим путям отдельно:
=== ЧАСТЬ 1: подхват НОВОЙ джобы (INSERT) — poll против listen ===
poll   (7 попыток): [93 94 72 105 50 102 82] мс -> min=50 avg=85 max=105 мс
listen (7 попыток): [23 20 21 19 20 20 20] мс -> min=19 avg=20 max=23 мс

=== ЧАСТЬ 2: подхват ВОЗВРАЩЁННОЙ джобы (UPDATE после reclaim) — poll против listen ===
poll   (7 попыток): [55 77 42 59 56 33 96] мс -> min=33 avg=59 max=96 мс
listen (7 попыток): [22 22 23 23 21 23 22] мс -> min=21 avg=22 max=23 мс
Разброс здесь важнее средних. У опроса он широкий и заполняет весь интервал (50–105 мс при интервале 100 мс) — это и есть его природа. У LISTEN/NOTIFY разброс узкий, 19–23 мс, и почти целиком состоит из накладных расходов самого замера: открытие соединения и подписка стоят около двадцати миллисекунд, и это пол, ниже которого измерение не опустится. Сам механизм уведомления нижней границы не имеет.
Обобщать стоит порядок величины — десятки-сотня миллисекунд у опроса против единиц-двух десятков у уведомлений, — а не конкретные числа: они сняты на WSL2 с проброшенным портом.
Теперь цена. У LISTEN/NOTIFY их две, и обе неочевидны.
Соединение на воркера. Подписка занимает сессию целиком: пул для этого не годится, потому что LISTEN привязан к конкретному соединению. Держать подписку постоянно — значит держать по соединению на воркера сверх рабочего пула, а на PostgreSQL с его моделью «процесс на соединение» сотня таких соединений уже величина, которую надо считать.
Окно потери уведомления. Альтернатива — подписываться на время ожидания и отпускать соединение между джобами; в стенде сделано именно так. Цена этого выбора — щель в единицы миллисекунд между закрытием старого соединения и LISTEN на новом. Уведомление, пришедшее в эту щель, теряется безвозвратно: PostgreSQL не буферизует NOTIFY для ещё не подписавшихся сессий. Джоба не пропадёт — её подберут по таймауту, — но именно эта джоба подхватится не за двадцать миллисекунд, а за две секунды.
То есть выбирать приходится между постоянно занятым соединением и редкой, но реальной потерей сигнала. В замерах выше в эту щель не попала ни одна из четырнадцати попыток — что говорит о её узости, а не об отсутствии.
Отсюда практическое правило: LISTEN/NOTIFY — ускорение поверх опроса, а не замена ему. Уведомление сокращает типичную задержку, опрос остаётся страховкой на случай потерянного сигнала. Реализация «только уведомления, без опроса» работает ровно до первой потери и отказывает тихо.
Очередь — худший случай для MVCC
В PostgreSQL UPDATE не меняет строку, а создаёт новую её версию, помечая старую мёртвой. Для таблицы, которую читают чаще, чем пишут, это отличный компромисс. Для очереди — худший случай из возможных: каждая джоба за свою короткую жизнь переписывается несколько раз.
Сколько именно — считается точно, а не наблюдается. Захват переводит queued → running, завершение — running → done. Колонка state входит в предикаты обоих частичных индексов (WHERE state = 'queued' и WHERE state = 'running'), поэтому ни одно из этих обновлений не может быть HOT-обновлением: заводится новая версия строки, правятся оба индекса. Две мёртвые версии на джобу — нижняя граница, и это не оценка. Долгая работа добавляет к ним по версии на каждое продление аренды: leased_until — ключевая колонка второго индекса.
Прогон на двух тысячах джоб:
размер пустой:               32 kB
после вставки 2000 джоб:     размер=432 kB статистика: 2000|0|f
после обработки:             размер=472 kB статистика: 2000|4000|f
мёртвых версий на джобу: 4000 / 2000 = 2.0

--- принудительный VACUUM ---
index scan needed: 35 pages from table (100.00% of total) had 4000 dead item identifiers removed
после VACUUM:                размер=480 kB статистика: 2000|0|f
размер в байтах: до VACUUM=483328, после VACUUM=491520
Два числа тут независимы и совпадают: статистика показывает 4000 мёртвых версий, и VACUUM фактически находит и вычищает ровно 4000 «dead item identifiers». Совпадение подтверждает, что статистика не устарела к моменту чтения — обычная опасность при работе со счётчиками pg_stat_user_tables.
И главное, ради чего этот артефакт: размер файла после VACUUM не уменьшился. 483328 байт до, 491520 после — даже слегка вырос за счёт служебной работы. Обычный VACUUM освобождает место внутри файла для повторного использования, а не возвращает его операционной системе. Это не сбой и не недоработка: для очереди такое поведение как раз правильное — освобождённое место немедленно займут новые джобы. Файл, который перестал расти, — это и есть здоровая очередь под VACUUM.
Уменьшает файл VACUUM FULL, но он переписывает таблицу целиком под ACCESS EXCLUSIVE-блокировкой, то есть на живой очереди неприменим.
Абсолютные килобайты в этом артефакте невоспроизводимы дословно — два прогона на одной машине дали 472 kB и 512 kB, разница только в предыстории таблицы: оппортунистический прунинг вычищает часть мёртвых версий ещё до явного VACUUM, в зависимости от порядка трафика. Детерминировано здесь только соотношение 2.0 и качественный факт про размер.
Практический вывод: autovacuum на таблице очереди нужно настраивать отдельно от общесерверных значений, потому что дефолты рассчитаны на таблицы с куда меньшим оборотом строк.
Отсюда же три метрики, которые стоит вывести именно для очереди на PostgreSQL — в дополнение к общим метрикам очереди из первой статьи:
- Мёртвые версии строк в таблице очереди (
n_dead_tup). Ожидаемая величина считается: две версии на каждую обработанную джобу плюс по одной на каждое продление аренды. Заметно больше — значит autovacuum не успевает. - Давность последнего автовакуума по этой таблице. Растёт вместе с
n_dead_tup— верный признак, что пороги autovacuum по умолчанию для этой нагрузки слишком высоки. - Размер таблицы и её индексов. Здоровая очередь под вакуумом перестаёт расти, выходя на плато: освобождённое место переиспользуется. Монотонный рост при стабильном потоке джоб означает, что вакуум проигрывает записи.
Последняя метрика удобна тем, что не требует понимать MVCC: если файл растёт, а очередь по глубине стоит на месте — что-то не так.
Потолок пропускной способности
Вопрос «на сколько хватит PostgreSQL» обычно остаётся без ответа, потому что честный ответ требует замера. Замерил: очередь наполняется заведомо избыточно, N воркеров работают фиксированное окно, считается число доведённых до done джоб. Работа — пустая, поэтому меряется потолок самого механизма очереди, а не скорость полезной нагрузки.
| Воркеров | Джоб/сек (медиана) | Во сколько раз больше, чем при одном |
|---|---|---|
| 1 | 218 | ×1.00 |
| 2 | 294 | ×1.35 |
| 4 | 584 | ×2.68 |
| 8 | 1140 | ×5.23 |
Три прогона подряд дали одну и ту же картину. Рост сублинейный: восемь воркеров дают не ×8, а ×5.2 — примерно в полтора раза меньше линейно ожидаемого.
Важно, чем эти числа не являются. Это не «предел PostgreSQL» и даже не предел вашей установки PostgreSQL — это предел конкретного стенда: одна таблица с двумя частичными индексами, synchronous_commit=on, WSL2 с Docker Desktop и проброшенным портом. На голом железе с NVMe значения будут другими, и переносить стоит характер зависимости, а не сами числа.
С этой оговоркой ориентир такой: на восьми воркерах этот стенд отдаёт больше тысячи джоб в секунду. Для писем, отчётов и пережатия картинок запас огромный — счёт там идёт на десятки в секунду в пике.
И сразу важное: восемь воркеров — потолок замера, а не потолок кривой. Плато по этим числам ещё не видно, последние два удвоения дали почти вдвое каждое. Где рост действительно упрётся, стенд не проверял — поэтому и утверждать, начиная с какого порядка нагрузки очередь в БД перестаёт годиться, я не буду: таких замеров нет.
Форма кривой: насыщение сбросов и группировка коммитов
У этой таблицы есть особенность, которую я сначала принял за дефект замера. Посмотрите на пошаговые множители:
| Шаг | Множитель |
|---|---|
| 1 → 2 | ×1.35 |
| 2 → 4 | ×1.99 |
| 4 → 8 | ×1.95 |
От двух воркеров и дальше масштабирование почти идеальное — каждое удвоение даёт почти вдвое. Весь провал сосредоточен в первом шаге, 1 → 2.
Это противоположно тому, что дал бы упор в общий ресурс. Конкуренция за блокировки или горячие страницы индексов нарастала бы с ростом числа воркеров: чем их больше, тем хуже. Здесь наоборот — хуже всего масштабируется самый маленький шаг.
Режим одного воркера аномально эффективен, а вся плата за конкуренцию вносится разом, на втором воркере: дальше на воркера практически константа. Отключение синхронной записи журнала показывает, что дело в fsync: при synchronous_commit=off переход 1 → 2 становится почти линейным (×1.92 вместо ×1.35), а падение на воркера сокращается с трети до четырёх процентов.
Дальше можно было бы остановиться на правдоподобном объяснении — и я на нём чуть не остановился, причём дважды и в противоположные стороны. Но PostgreSQL 18 позволяет посмотреть напрямую: счётчики сбросов журнала переехали в pg_stat_io. Снимаем дельту fsyncs за окно замера и считаем, сколько коммитов проехало на одном сбросе — джоба это два автокоммитных UPDATE, поэтому коммитов вдвое больше:
| Воркеров | Коммитов/сек | Сбросов/сек | Коммитов на сброс | На воркера |
|---|---|---|---|---|
| 1 | 455 | 438 | 1.02 | 228 |
| 2 | 601 | 585 | 1.03 | 150 |
| 4 | 1197 | 579 | 2.07 | 150 |
| 8 | 2394 | 592 | 4.04 | 150 |
| 16 | 4694 | 566 | 8.30 | 147 |
Это отдельный прогон с другим окном замера, поэтому джобы в секунду здесь на несколько процентов расходятся с таблицей выше — умножать одну таблицу на два и сверять с другой не стоит. Числа устойчивы: пять прогонов для восьми воркеров и три для шестнадцати.
Картина оказалась трёхрежимной, а не «есть группировка или нет».
- Один воркер работает ниже насыщения — 438 сбросов в секунду при потолке около 580. Каждый коммит получает свой сброс без ожидания, отсюда аномально высокая выработка на воркера.
- Второй воркер упирает путь сброса в потолок, но группировки ещё нет — те же 1.03 коммита на сброс, что и при одном. Именно здесь выработка на воркера падает на треть: это разовая плата за вход в насыщенный режим, а не эффект группировки.
- Четыре и больше растут только за счёт группировки: 2.07, 4.04 и 8.30 коммита на сброс, а частота сбросов при этом больше не растёт — держится примерно на одном уровне вместо того, чтобы увеличиваться вслед за числом коммитов.
Наблюдения ложатся на простое правило: коммитов на сброс ≈ max(1, N/2). Оно подогнано на трёх точках, поэтому проверено предсказанием: при шестнадцати воркерах ожидалось около восьми коммитов на сброс и прежние ~150 джоб в секунду на воркера. Измерено 8.30 и 147 — прогноз сошёлся, нового предела до шестнадцати воркеров не появилось. Откуда берётся коэффициент ½, эти замеры не отвечают: это регулярность, а не механизм.
Практический вывод: один воркер — не показательный режим для замера. Соблазн проверить очередь одним воркером и умножить на планируемое число даёт заметно завышенную оценку: 218 × 8 = 1744 против фактических 1140, в полтора раза больше реального. Замерять надо на том числе воркеров, с которым собираетесь работать.
Оговорка к абсолютным числам, и она важнее, чем кажется. На WSL2 с Docker Desktop fdatasync не гарантированно доходит до физического устройства, поэтому частоту сбросов в районе шестисот в секунду не стоит читать как характеристику диска. Сама эта частота к тому же ощутимо плавает между прогонами — независимая проверка на другой машине дала заметно другие значения, — так что «потолок около 580» здесь описывает конкретный стенд, а не величину, на которую можно опереться.
Устойчивее ведёт себя отношение коммитов к сбросам: оно воспроизводится и у меня, и при независимой проверке. Но и его я не стал бы называть независимым от окружения — правильнее сказать, что оно переносится лучше абсолютных чисел, а на своём железе и своей виртуализации его всё равно стоит перемерить. Скрипт для этого в стенде и лежит.
И отдельно, раз уж речь о честности замеров: в одном прогоне из пяти строка для восьми воркеров дала 166 джоб в секунду вместо обычных ~1190 — отклонение на порядок. Два немедленных повтора вернули норму, так что это разовый сбой машины, а не свойство конфигурации. Записываю его здесь, а не прячу в среднем: расхождение двух прогонов одной конфигурации — это системный артефакт, и если он у кого-то воспроизведётся устойчиво, то это уже находка, а не шум.
Когда всё-таки нужен брокер
Граница проходит не по производительности, а по требованиям, которые очередь в БД не закрывает по построению.
Брокер не нужен, если задачи измеряются сотнями в секунду, потребитель один (ваш же бэкенд), и вам ценна транзакционность с бизнес-данными. Это большинство прикладных систем, и здесь очередь в PostgreSQL выигрывает по совокупности: меньше движущихся частей, общий бэкап, общий мониторинг, знакомый язык запросов.
Брокер нужен, когда появляется что-то из этого:
- Нагрузка, для которой путь сброса журнала становится узким местом. Как показано выше, он насыщается уже на двух воркерах, и дальше всё держится на группировке коммитов. Тюнингом это отчасти лечится —
synchronous_commit=offдаёт вчетверо, — но платой становится риск потерять подтверждённые коммиты при падении сервера, то есть для очереди задач молча потерянные джобы. Где именно проходит граница применимости в джобах в секунду, я не мерил и называть не берусь: считайте на своём железе, метод — в стенде. - Несколько независимых потребителей одного события. Очередь задач отдаёт джобу одному воркеру — это её суть. Веерная рассылка одного события нескольким подписчикам — другая модель, и живёт она в брокере: сравнение моделей есть в «RabbitMQ, Kafka, NATS и Redis: как не выбирать messaging layer по моде».
- Хранение потока и повторное чтение. Лог с возможностью перечитать историю с произвольного места — это Kafka, и таблица
jobsэту роль не играет. - Развязка между сервисами разных команд. Общая таблица очереди — это общая схема БД, то есть связанность, которую брокер как раз снимает.
- Ваша БД уже узкое место. Если PostgreSQL едва тянет прикладную нагрузку, добавлять к ней таблицу с высочайшим оборотом строк — плохая идея независимо от абсолютных чисел.
Отдельный ориентир — готовые библиотеки. Писать очередь самому имеет смысл, чтобы понимать механику; в продакшене разумнее взять готовое. Для PostgreSQL и Go это River: тот же FOR UPDATE SKIP LOCKED под капотом, но миграции, пул воркеров, повторы и спасение зависших джоб уже написаны. В стенде он лежит рядом как прямой контраст.
Ретраи с backoff, идемпотентность обработчика и dead-letter в этой статье не разбираются — они не специфичны для PostgreSQL. Ссылки на разборы — в первой статье серии.
Демо и версии
Стенд: digital-cookbook/architecture/background-jobs — очередь на PostgreSQL целиком, все демонстрации этой статьи (skip-locked-demo.sh, notify-demo.sh, bloat-demo.sh, throughput-demo.sh, groupcommit-demo.sh), River для контраста и планировщик на advisory-локе для второй статьи.
Каждая демонстрация печатает падающий вариант — что наблюдалось бы, если бы проверяемый механизм не работал. Это не формальность. Тест на эксклюзивность захвата проходил при полностью вырезанном SKIP LOCKED — то есть выглядел доказательством, ничего не доказывая. А замер задержки уведомлений на одном из этапов показывал контраст, которого не было: накладные расходы самой оснастки оказались того же порядка, что измеряемый сигнал, и обе ветки сошлись, пока подпись продолжала обещать разницу. Оба случая поймал контроль «сломай проверяемое место и убедись, что проверка падает».
Версии на момент прогона (2026-07-18, замер пропускной способности — 2026-07-19): PostgreSQL 18.4, Go 1.26.3, github.com/jackc/pgx/v5 v5.10.0, github.com/riverqueue/river v0.40.0.
Все числа сняты на одной машине: Windows 11 + WSL2 (Ubuntu) + Docker Desktop, порт PostgreSQL проброшен на localhost:5456, контейнер без ограничений по CPU и памяти. Переносить стоит порядки величин и характер зависимостей, а не абсолютные значения.


Комментарии