
Про Picodata удобно думать как про «Tarantool, которому добавили кластер». Это первое, от чего стоит отказаться, потому что из такой модели следуют неверные ожидания — от способа подключения до поведения при отказе.
Ядро действительно форк Tarantool, и оно честно видно в исходниках. Но поверх него стоит собственный планировщик распределённых запросов на Rust, собственный кластер-менеджер, архитектура с привязкой данных к ядрам процессора и — что меняет повседневную работу сильнее всего — PostgreSQL в качестве основного протокола общения. Расширяют её не хранимыми процедурами на Lua, а плагинами на Rust со своим жизненным циклом и версионированием. Оставшийся внутри Tarantool — это фундамент и обратная совместимость, а не то, чем система является.
Первая статья серии. Всё ниже снято на живом кластере из четырёх инстансов — стенд databases/picodata.
В статье
- Что осталось от Tarantool
- Из чего собран кластер
- Почему четыре узла, а не три
- Что происходит при отказе
- Кластер «поднялся» и кластер «готов» — не одно и то же
- Открытое ядро и коммерческая периферия
- Чем платим
- Что дальше
Что осталось от Tarantool
Проще всего увидеть границу по версиям. Инстанс сообщает о себе так:
picodata 26.1.3, static, release
tarantool 2.11.8-356-gbf4844c5c, RelWithDebInfo
Две версии живут отдельно, и по тегу Picodata версия ядра не выводится: образ 26.1.6 несёт внутри 2.11.8-371, а 26.1.3 — 2.11.8-356. При чтении документации Tarantool применительно к Picodata это стоит держать в голове: часть механик оттуда работает, часть заменена, и совпадение версии ни о чём не говорит.
От ядра унаследованы хранение и локальное исполнение: движки memtx и vinyl, устройство спейсов и индексов, виртуальная машина, исполняющая локальную часть запроса. Заменено то, что делает систему распределённой: планирование запросов, управление топологией, протокол общения с клиентом, механизм расширения.
Разделение проявляется в наблюдаемом поведении. Например, лимит на число операций локальной виртуальной машины принадлежит именно ядру — и в него одинаково упирается как запрос снаружи, так и код плагина, работающий внутри кластера. Это не теория, а наблюдение со стенда: сообщение об отказе в обоих случаях дословно совпадает. Подробнее — в статье про распределённый SQL.
Из чего собран кластер
Кластер описывается тремя понятиями, и их стоит развести сразу.
Инстанс — процесс Picodata. У него свой каталог данных, свои сетевые адреса и своя роль в согласовании.
Репликасет — группа инстансов, хранящих одни и те же данные. Размер задаётся фактором репликации при создании кластера.
Тир — логическая группа, к которой привязываются сервисы плагинов. Именно тир, а не узел и не репликасет, отвечает на вопрос «где работает эта логика».
Данные раскладываются не по узлам напрямую, а по бакетам — виртуальным сегментам, которых в кластере фиксированное число (в стенде 3000). Ключ шардирования определяет бакет, бакет закреплён за репликасетом. Такая косвенность и позволяет перебалансировать кластер, не трогая ключи: переезжают бакеты, а не отдельные строки.
Согласованность самой топологии — кто в каком репликасете, какие таблицы существуют, какие плагины включены — держится на Raft. Роль узла в нём видна в метриках, а вот через SQL её не получить; это одна из особенностей, к которой стоит привыкнуть заранее.
Почему четыре узла, а не три
Самая дорогая ошибка на старте — посчитать число узлов отдельно от фактора репликации.
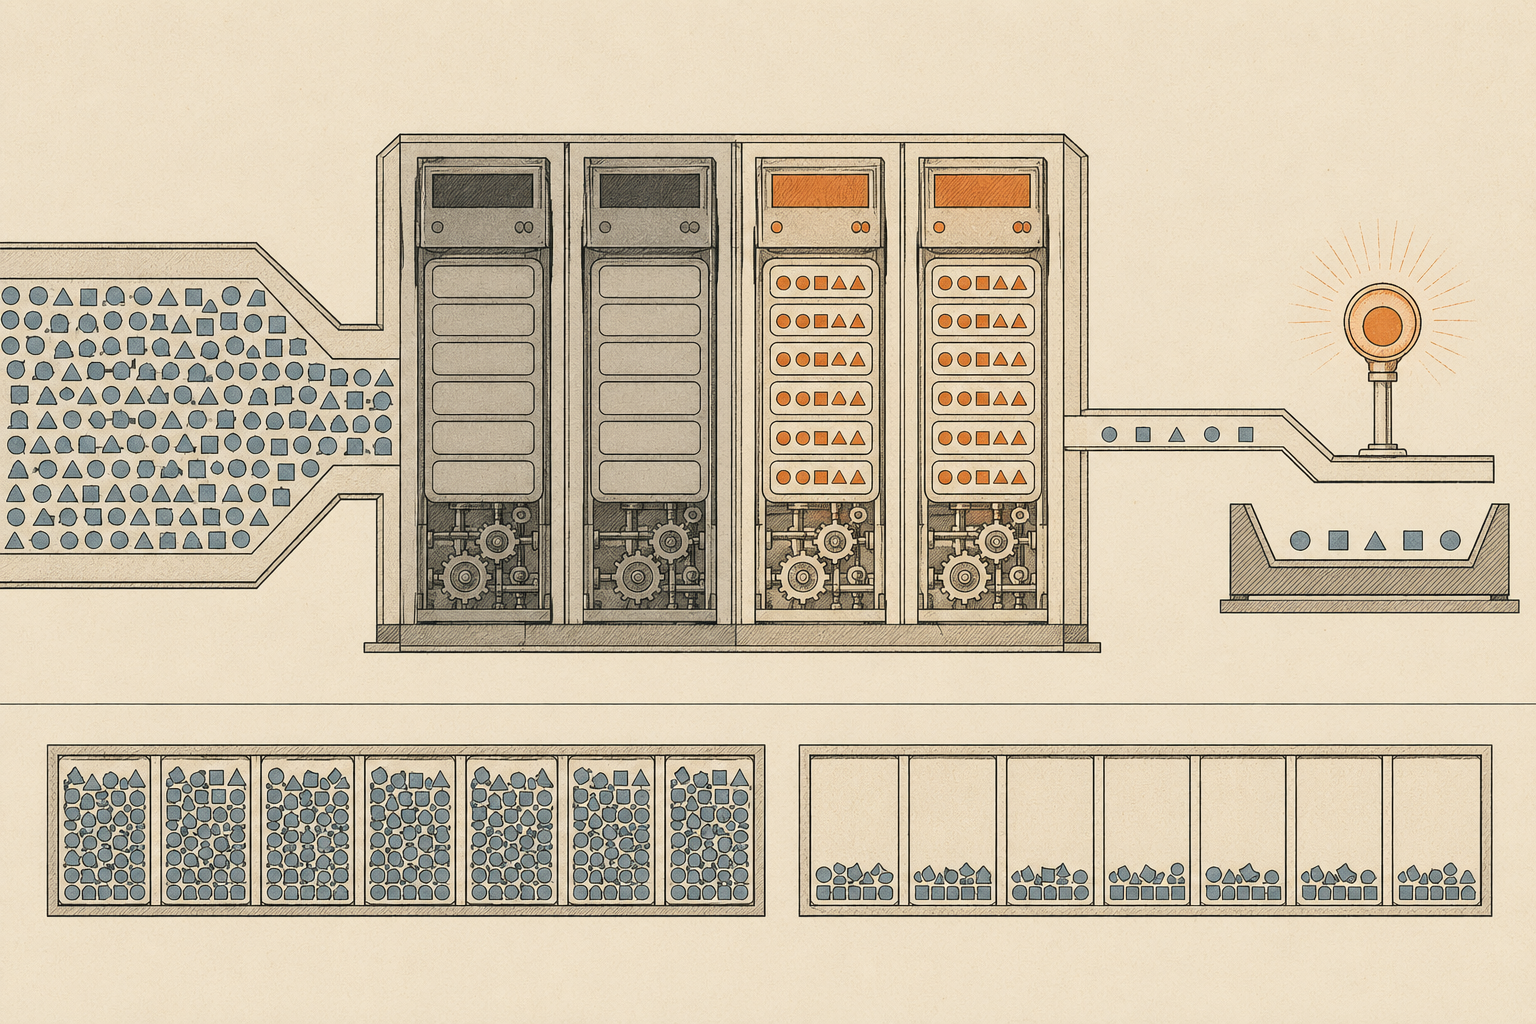
При факторе репликации 2 три инстанса структурно не дают шардирования. Первый репликасет набирает двух членов и получает вес, третий инстанс остаётся один — и его репликасет навсегда остаётся с весом ноль. Механизм распределения не выдаёт бакеты неполному репликасету, и это не задержка ребалансировки, которая пройдёт сама: состояние устойчиво.
Показательная деталь: кластер при этом считает себя исправным и в журнале сообщает, что распределение в порядке. Формально так и есть — все бакеты размещены. То, что половина мощности простаивает без единого бакета, из этого сообщения не следует.
Рабочая конфигурация стенда — четыре инстанса, два репликасета по два:
default_1_1 | default_1 | ["Online",1]
default_1_2 | default_1 | ["Online",1]
default_2_1 | default_2 | ["Online",1]
default_2_2 | default_2 | ["Online",1]
Практический вывод простой: число инстансов должно быть кратно фактору репликации, иначе часть ресурсов не участвует в работе. Проверять это надо до заливки данных.
Ещё деталь, которая экономит время при отладке: номер контейнера не соответствует номеру инстанса. Останавливая pd-3, вы можете обнаружить в состоянии Offline инстанс default_1_2, а привязка меняется от пересоздания к пересозданию. Ориентироваться нужно на имена инстансов, а не на порядок запуска.
Что происходит при отказе
Здесь начинается самое важное в статье.
Потеря одного узла в репликасете проходит штатно. Останавливаем инстанс, ждём, повторяем запрос:
default_1_1 | default_1 | ["Online",1]
default_1_2 | default_1 | ["Offline",1]
…
count(*) = 200000   ← полный набор
Реплика подхватывает, ответ полный. Ровно то, ради чего фактор репликации и нужен.
Потеря обоих узлов репликасета ведёт себя иначе — и не так, как ожидаешь. Условия наблюдения: Picodata 26.1.3, кластер из четырёх инстансов в двух репликасетах по два узла; оба узла одного репликасета остановлены docker stop (второй — через 12 секунд после первого), запрос SELECT count(*) FROM products выполнен через psql на выжившем узле другого репликасета через 15 секунд после остановки второго узла:
default_1_1 | default_1 | ["Offline",1]
default_1_2 | default_1 | ["Offline",1]
default_2_1 | default_2 | ["Online",1]
default_2_2 | default_2 | ["Online",1]

count(*) = 133249   ← в кластере 200000
Конкретное число зависит от того, сколько строк лежало на потерянном репликасете, — про само это распределение речь ниже, оно оказалось отдельной историей. Важно здесь другое.
Запрос не упал. Он вернул неполный результат — без ошибки, без предупреждения, без единого признака, что часть данных недоступна. Агрегация по категориям в этом состоянии тоже отрабатывает и тоже отдаёт заниженные числа по каждой строке.
Неполнота здесь не «какое-то число меньше 200 000»: стенд заранее, до отказа, измеряет, сколько строк лежит на выжившем репликасете, и сверяет ответ именно с ним. В повторном прогоне раскладка была другой — 99 776 / 100 224, — и после потери репликасета запрос вернул count(*) = 100224, ровно строки выжившего. Ответ — это в точности «половина кластера, которая осталась», а не случайный мусор.
Там же стенд записал роли Raft в момент запроса: на выживших узлах наблюдались роли Leader и Follower. Работоспособность управляющей плоскости этим замером не установлена: роль лидера ещё не означает, что он может применять записи — для этого Raft нужен кворум голосующих узлов. Состав голосующих узлов, возможность применения записей Raft, DDL и изменения топологии не проверялись, как и поведение системы спустя минуты, а не секунды после отказа.
Проговорю прямо, потому что это главный практический вывод статьи: отказ, который выглядит как успех, опаснее отказа, который выглядит как отказ. Приложение, получившее 133 249 вместо 200 000, не увидит исключения и не включит запасной путь. Отчёт построится, счётчик обновится, решение примется — на неполных данных.
Отсюда требование к эксплуатации: доступность репликасетов должна отслеживаться мониторингом отдельно, а не выводиться из того, что запросы «проходят». Данные при этом не теряются — после возвращения узлов набор снова полный, они были именно недоступны.
Кластер «поднялся» и кластер «готов» — не одно и то же
Этот раздел появился из ошибки — моей собственной, — и она стоит того, чтобы её описать: тот же класс промаха легко допустить в своём тестовом контуре.
Стенд загружал данные, выждав фиксированную паузу после старта контейнеров и убедившись, что все четыре инстанса Online, Raft-лидер один, а оба репликасета в состоянии ready с ненулевым весом. Выглядит исчерпывающе. Оказалось — нет.
В одном из прогонов картина оказалась предельно явной: все 3000 бакетов лежали на одном репликасете, все 200 000 строк — там же, второй стоял пустым. В журнале нашлась причина: ребалансировщик на момент инициализации увидел ноль активных бакетов и остановился. Кластер при этом отвечал на запросы и по всем перечисленным признакам выглядел исправным.
Стенд получил барьер готовности: перед загрузкой данных он ждёт не только Online, лидера и ready, но и того, что бакеты действительно разложены — у каждого репликасета ненулевая доля, реплики внутри репликасета согласованы, а сумма сходится с общим числом бакетов кластера.
Первый вывод, ради которого раздел и написан: набор признаков «инстансы Online, Raft-лидер есть, репликасеты ready» не означает готовности кластера к работе. Эксперимент или загрузка данных до завершения инициализации измеряет гонку, а не систему, — и результат при этом выглядит совершенно правдоподобно.
Распределение строк: наблюдение без объяснения
А вот дальше начинается то, что барьер не закрыл, и это стоит рассказать честно, потому что соблазн выдать красивую версию был большой.
Даже после барьера число строк на репликасете от прогона к прогону разное. Бакетов при этом всегда поровну — по 1500. Вот исходы, которые наблюдались на чистых пересозданиях:
| Строк на репликасет | Перекос |
|---|---|
| 99 776 / 100 224 | 0,2% |
| 123 103 / 76 897 | ~1,6:1 |
| 124 807 / 75 193 | ~1,7:1 |
| 133 249 / 66 751 | ~2:1 |
Это перечень наблюдавшихся примеров, а не распределение частот: систематической серии прогонов с подсчётом, какой исход насколько вероятен, я не проводил, и говорить «обычно бывает так-то» оснований нет. Каждый из вариантов повторялся в нескольких прогонах подряд, так что это и не разовые выбросы.
Одно про этот разброс известно точно. Строки по диапазонам bucket_id делятся детерминированно: измерение даёт 100 224 строки в бакетах 1–1500 и 99 776 в 1501–3000, и иначе быть не может — номер бакета вычисляется хешем от ключа шардирования. Значит объём данных на репликасете определяется исключительно тем, какие именно бакеты ему достались: непрерывный диапазон, чередование или произвольный набор дают разный итог при одинаковом их количестве.
Почему назначение бакетов от прогона к прогону разное — стенд не установил, и я не стану достраивать правдоподобное объяснение до факта. Практический вывод при этом одинаков для обоих исходов: равное число бакетов не гарантирует равный объём данных, и планировать ёмкость узлов по числу бакетов нельзя. Опираться нужно на фактическую раскладку данных по репликасетам — и не только на число строк, а на байты с учётом индексов и на нагрузку: при одинаковом числе строк репликасет с более широкими строками или более «горячими» ключами потребует больше ресурсов.
Открытое ядро и коммерческая периферия
Граница проходит внятно, и знать её лучше до того, как архитектура выстроена вокруг обещания.
Открыто: ядро, PostgreSQL-протокол, распределённый SQL, механизм плагинов вместе с библиотекой и утилитой разработки, дисковый движок.
Коммерческие плагины: совместимость с Redis и с Cassandra, кросс-кластерная репликация, интеграция с Kafka. Именно они стоят за формулировкой «заместить Redis и Cassandra на одном ядре» — сама по себе платформа этого не делает.
В этой серии проверяется только открытая часть: коммерческие плагины на стенд не ставились, и всё, что о них сказано, — со ссылкой на документацию вендора, а не по результатам измерения.
Чем платим
- Распределённая система вместо одного процесса. Одиночный Tarantool — процесс, который либо работает, либо нет. Здесь — топология, которую надо планировать заранее и наблюдать постоянно.
- Конфигурация связана жёстче, чем кажется. Число узлов должно быть кратно фактору репликации; ключ шардирования определяет не только распределение, но и то, какие запросы вообще выполнимы.
- Отказ репликасета не выглядит отказом. Это требует отдельного контроля доступности, а не доверия к тому, что запросы проходят.
- Готовность кластера проверяется отдельно от его доступности. «Инстансы Online, лидер есть, репликасеты ready» не означает, что распределение бакетов установилось; эксперимент или загрузка данных до этого момента измеряет гонку инициализации.
- Часть привлекательных возможностей — за периметром открытой части.
Что дальше
Что из привычного PostgreSQL здесь работает и где проходит граница совместимости — статья 2. Как исполняется распределённый запрос, откуда берутся лимиты и почему ключ шардирования решает судьбу соединений — статья 3. Как расширять кластер собственным кодом — статья 4. Как разворачивать и наблюдать всё это в проде — статья 5.
Место Picodata среди других подходов к хранению — в хабе «Данные: карта хранилищ и подходов», а сравнение двух моделей вычислений рядом с данными — в статье про Tarantool и Picodata.
Комментарии