
Одиночный PostgreSQL с парой реплик тянет удивительно много — до тех пор, пока запись не упирается в один primary, а данные не перестают влезать на один узел. Классический ответ — ручной шардинг на уровне приложения, и это боль: кросс-шардовые транзакции, ребалансировка, разъезжающиеся схемы. Distributed SQL обещает другое: горизонтальный масштаб записи и хранения, но с привычным SQL и настоящими ACID-транзакциями поверх. За обещание платят латентностью — и разобраться, где эта цена оправдана, важнее, чем выбрать конкретный движок.
Термины, чтобы не путаться. NewSQL — название волны 2010-х: базы, которые пытались совместить горизонтальный масштаб NoSQL с SQL и транзакциями реляционных СУБД. Distributed SQL — более узкое и сегодня более употребимое название того же класса: SQL-база, которая сама режет данные на части, реплицирует их через консенсус и проводит транзакции через несколько узлов. Дальше — второй термин.
Статья рассчитана на читателя, который уверенно знает ACID, MVCC и уровни изоляции, понимает, как устроена репликация primary–replica, и хотя бы в общих чертах представляет консенсус. Если что-то из этого в новинку, начните с обзора протоколов консенсуса и статьи про репликацию PostgreSQL.
Движков в разборе четыре: CockroachDB, YugabyteDB и TiDB — те, что чаще всего попадают в такие сравнения, — плюс OceanBase, который в них обычно не попадает. Он взят не для полноты списка: это единственный из четырёх, кто построен на Paxos, а не на Raft, и единственный, кто заявляет аналитику внутри того же движка, без отдельного колоночного хранилища.
Сравнивать будем не по документации, а по живому стенду databases/distributed-sql в репозитории digital-cookbook. CockroachDB v26.2.5, YugabyteDB 2026.1.2.0 и TiDB v8.5.8 подняты настоящими кластерами по три узла хранения, OceanBase CE 4.4.2.1 — одним observer: кластер из трёх в память стенда не поместился. Рядом для сравнения — одиночные PostgreSQL 17 и MySQL 8.4. На всех гоняются одни и те же замеры одним и тем же инструментом. Всё запущено на одной машине (Docker Desktop под macOS, 10 CPU, 7,7 ГБ памяти), а расстояние между узлами смоделировано назначенной задержкой. Поэтому числа ниже говорят о соотношениях и раунд-трипах, а не о том, какой движок «быстрее» в абсолютных миллисекундах.
В статье
- Зачем distributed SQL вообще
- Диапазоны и консенсус под капотом
- Четыре движка: слои и типы узлов
- Цена: сколько стоит одна операция
- Что обещано по умолчанию: изоляция
- Совместимость: где протекает
- Отказ узла: сколько ждёт приложение
- Повтор транзакции — забота приложения
- Когда оправдано, а когда нет
Зачем distributed SQL вообще
У классического PostgreSQL два потолка, и упираются в них по-разному.
Первый — запись. Все изменения проходят через один primary. Реплики снимают с него чтение, но не запись: сколько их ни добавляй, каждый INSERT и UPDATE по-прежнему выполняет одна машина. Вертикальный рост — больше ядер, быстрее диски — отодвигает потолок, но не убирает его. Как устроена отказоустойчивая пара primary плюс реплики и где у неё границы, разобрано в статье про Patroni и репликацию.
Второй — объём. Данные целиком живут на каждом узле. Когда рабочий набор перестаёт помещаться в память одной машины, а таблицы — на её диски, реплики не помогают: они копируют ту же проблему.
Ручной шардинг снимает оба потолка, но переносит сложность в приложение. Ключ шардирования, маршрутизация запросов, джойны через шарды, перебалансировка при росте, транзакция, задевающая два шарда, — всё это теперь ваш код или ваш прокси. Что именно начинается после «разложили по ключу», подробно разобрано в статье про шардинг в продакшене — там же Citus как промежуточный вариант.
Distributed SQL предлагает отдать эту работу базе. Данные режутся на диапазоны автоматически, каждый диапазон реплицируется через консенсус, а транзакция через несколько диапазонов остаётся одной ACID-транзакцией. Снаружи — обычный SQL и знакомый протокол: PostgreSQL у CockroachDB и YugabyteDB, MySQL у TiDB и OceanBase.
Граница проходит не между «маленькой» и «большой» базой, а между двумя профилями нагрузки. Если упираетесь в чтение, реплики и кэш решают задачу дешевле. Если в запись или объём на одном узле — или запись нужна сразу в нескольких регионах, — вот тогда разговор о distributed SQL становится предметным.
Диапазоны и консенсус под капотом
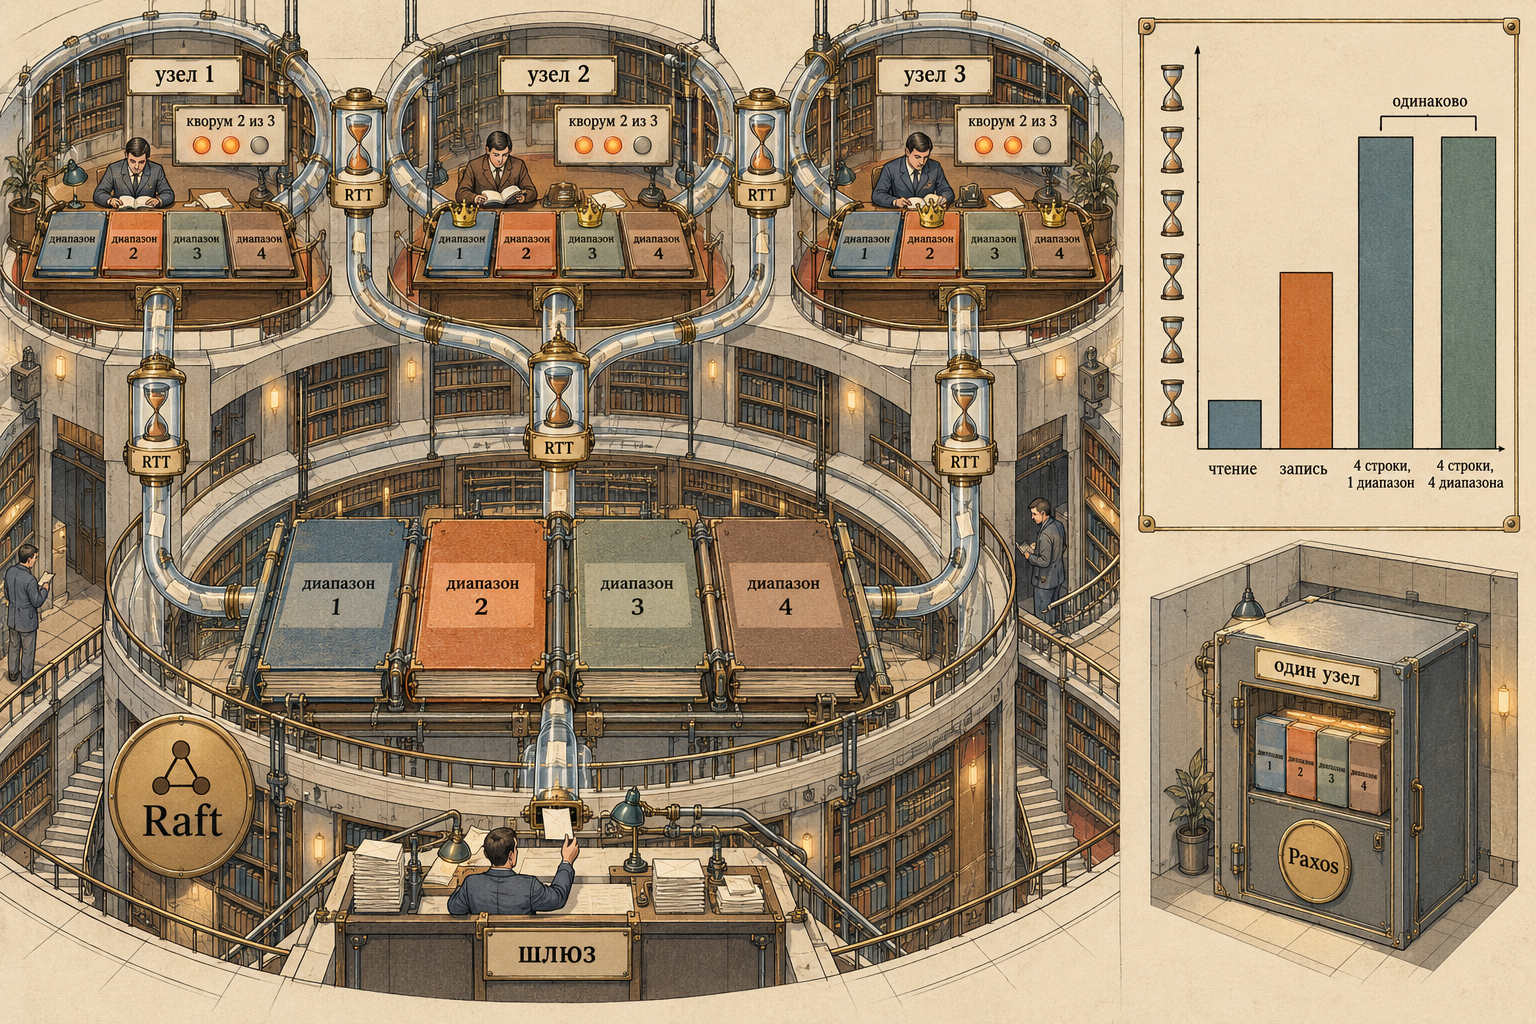
Все четыре движка устроены по одной схеме, хотя называют её части по-разному. Таблица — это отсортированное по первичному ключу пространство «ключ → строка». Оно режется на непрерывные куски, каждый кусок хранится в нескольких копиях на разных узлах, а копии одного куска договариваются между собой через консенсус.
| Движок | Единица распределения | Консенсус | Чем посмотреть |
|---|---|---|---|
| CockroachDB | range (диапазон) | Raft на каждый диапазон | SHOW RANGES FROM TABLE |
| YugabyteDB | tablet (таблетка) | Raft на каждую таблетку | yb-admin list_tablets |
| TiDB | region (регион) | Raft на каждый регион | SHOW TABLE … REGIONS |
| OceanBase | partition → tablet → log stream | Paxos на лог-стрим | DBA_OB_TABLE_LOCATIONS |
Одна таблица — kv из 4000 строк — была заведена во всех четырёх и разрезана по одним и тем же границам: 1 000 000, 2 000 000, 3 000 000. Синтаксис разный: ALTER TABLE … SPLIT AT у CockroachDB, SPLIT AT VALUES в самом CREATE TABLE у YugabyteDB, SPLIT TABLE … BY у TiDB и обычное PARTITION BY RANGE у OceanBase. У YugabyteDB есть ловушка: без ASC в первичном ключе таблица режется по хешу, и соседние ключи разъезжаются по разным таблеткам.
Вот что получилось у CockroachDB — четыре диапазона, у каждого три реплики на узлах {1,2,3}, и у каждого свой leaseholder:
$ docker exec crdb1 cockroach sql --insecure --host=localhost:26257 \
    -e "SELECT range_id, start_key, end_key, lease_holder, replicas FROM [SHOW RANGES FROM TABLE kv WITH DETAILS] ORDER BY start_key;"
range_id	start_key	end_key	lease_holder	replicas
83	…/1/1000000	…/1/2000000	2	{1,2,3}
84	…/1/2000000	…/1/3000000	3	{1,2,3}
85	…/1/3000000	<after:/Max>	2	{1,2,3}
86	…/<TableMin>	…/1/1000000	3	{1,2,3}
Сортировка по строковому представлению ключа ставит первый диапазон (<TableMin>) в конец — это особенность вывода, а не данных. Номера узлов здесь не совпадают с именами контейнеров: node_id раздаётся в порядке присоединения к кластеру, и на этом прогоне узел 2 — это crdb3, а узел 3 — crdb2.
У OceanBase картина другая, и она поправляет распространённое упрощение «единица распределения — партиция»:
$ docker exec ob obclient -h127.0.0.1 -P2881 -uroot@test -A -t \
    -e "SELECT partition_name, tablet_id, ls_id, svr_ip, role FROM oceanbase.DBA_OB_TABLE_LOCATIONS WHERE table_name = 'kv' ORDER BY partition_name;"
+----------------+-----------+-------+------------+--------+
| partition_name | tablet_id | ls_id | svr_ip     | role   |
+----------------+-----------+-------+------------+--------+
| p0             |    200005 |  1001 | 172.18.0.2 | LEADER |
| p1             |    200006 |  1001 | 172.18.0.2 | LEADER |
| p2             |    200007 |  1001 | 172.18.0.2 | LEADER |
| p3             |    200008 |  1001 | 172.18.0.2 | LEADER |
+----------------+-----------+-------+------------+--------+
Четыре партиции — это четыре таблетки, но все они в одном лог-стриме 1001. В OceanBase 4.x консенсус ведётся не на каждую партицию, а на лог-стрим, в который сгруппированы таблетки одного узла. Отсюда следствие, которое не очевидно из документации верхнего уровня: транзакция через несколько партиций, оказавшихся в одном лог-стриме, двухфазного коммита между группами не требует. На одноузловом стенде иначе и быть не могло, и о поведении в кластере стенд ничего не утверждает.
Лидер и кворум. В каждой группе реплик одна — лидер: через неё идут записи, она же обычно отвечает на чтения. Запись считается зафиксированной, когда её подтвердило большинство — две реплики из трёх. Поэтому группа из трёх реплик переживает потерю одного узла, а из пяти — двух. У CockroachDB поверх лидера Raft есть ещё leaseholder — держатель аренды на чтение, и обычно это та же реплика.
Raft против Paxos. CockroachDB, YugabyteDB и TiDB используют Raft, OceanBase — Paxos; об этом прямо сказано в README его репозитория. Спорить, какой протокол «правильнее», бессмысленно. Raft — это, по сути, Multi-Paxos с жёстко зафиксированными решениями: один сильный лидер, журнал без дыр, понятное правило выбора лидера. Ради этих ограничений его и придумали — Paxos в исходном описании оставлял слишком много свободы реализации. Свойства кворума у обоих одинаковые: большинство из N, переживание ⌊(N−1)/2⌋ отказов. Для эксплуатации разница скорее в другом — в диагностируемости, в инструментах и в том, насколько протокол знаком вашей команде. Общий механизм консенсуса и его семейство разобраны в обзоре протоколов консенсуса.
Три разных механизма, которые легко смешать. Под словами «распределённая ACID-транзакция» работают три слоя, и у каждого своя задача:
- консенсус реплик (Raft, Paxos) делает одну группу реплик надёжной: запись в диапазон не потеряется, пока жив кворум. Про транзакции он ничего не знает;
- атомарный коммит между группами — двухфазный коммит поверх консенсуса — делает так, что транзакция, задевшая несколько диапазонов, применится во всех или ни в одном. Каждый участник фиксирует «намерение» через свою группу, затем фиксируется решение;
- управление конкурентностью — MVCC, блокировки, проверка конфликтов — решает, какие транзакции могут выполняться одновременно и что каждая из них видит. Именно оно определяет уровень изоляции.
Отказоустойчивость дают первые два слоя, изоляцию — третий. Поэтому движок может безупречно реплицировать данные и при этом по умолчанию пропускать write skew — что раздел об изоляции и покажет.
Время. Сериализуемость сама по себе не требует часов: ей достаточно, чтобы результат был эквивалентен какому-то последовательному порядку транзакций. Но MVCC в этих движках выбирает версию данных по метке времени, и метки разных узлов должны быть сопоставимы. Отдельный, более сильный вопрос — согласован ли этот порядок с реальным временем: увидит ли транзакция, начатая после коммита другой, её результат. Здесь движки расходятся сильнее, чем в консенсусе:
- CockroachDB и YugabyteDB — гибридные логические часы (HLC): физическое время узла плюс логический счётчик. Центрального сервиса нет, зато есть допуск на расхождение часов. Чтение, наткнувшееся на версию «из будущего» в пределах этого допуска, обязано перезапуститься на более поздней метке. Часто движок делает это сам, и клиент ничего не замечает: CockroachDB повторяет на сервере, пока результат ещё не начал уходить клиенту, а YugabyteDB часть таких read restart разрешает внутренне. Но не всегда, и тогда приложение получает ошибку — класс ошибок, которого в одиночном PostgreSQL не бывает.
- TiDB — timestamp oracle (TSO) в Placement Driver: метку времени выдаёт центральный сервис, каждая транзакция за ней туда ходит. Расхождение часов узлов не важно, но появляется лишний сетевой раунд-трип и критичный компонент. Это модель Percolator из Google.
- OceanBase — тоже централизованная служба меток (GTS) на уровне тенанта.
Детали двухфазного коммита у всех разные, и именно они вместе с метками времени определяют цену, которую мы померим ниже.
Четыре движка: слои и типы узлов
Схема «диапазоны плюс консенсус» у всех одна, а вот разложена по процессам она очень по-разному.
SQL + DistSQL
ranges + Raft
Pebble"] end subgraph YB["YugabyteDB — две роли на узле"] YBM["yb-master
метаданные, своя Raft-группа"] YBT["yb-tserver
YSQL на коде PostgreSQL
DocDB: tablets + Raft"] end subgraph TI["TiDB — три вида процессов"] TID["tidb-server
SQL, без данных"] PD["PD
размещение + TSO"] TKV["TiKV
regions + Raft
RocksDB"] TID --> PD TID --> TKV TKV --> PD end subgraph OB["OceanBase — один процесс"] OBS["observer
SQL + хранение
log streams + Paxos"] end
flowchart TB
  subgraph CR["CockroachDB — один бинарник"]
    CR1["cockroach
SQL + DistSQL
ranges + Raft
Pebble"]
  end
  subgraph YB["YugabyteDB — две роли на узле"]
    YBM["yb-master
метаданные, своя Raft-группа"]
    YBT["yb-tserver
YSQL на коде PostgreSQL
DocDB: tablets + Raft"]
  end
  subgraph TI["TiDB — три вида процессов"]
    TID["tidb-server
SQL, без данных"]
    PD["PD
размещение + TSO"]
    TKV["TiKV
regions + Raft
RocksDB"]
    TID --> PD
    TID --> TKV
    TKV --> PD
  end
  subgraph OB["OceanBase — один процесс"]
    OBS["observer
SQL + хранение
log streams + Paxos"]
  end
| CockroachDB | YugabyteDB | TiDB | OceanBase | |
|---|---|---|---|---|
| Протокол | PostgreSQL | PostgreSQL | MySQL | MySQL (в CE) |
| Видов процессов | 1 | 2 | 3 | 1 |
| Метки времени | HLC | HLC | TSO в PD | GTS |
| Уровень по умолчанию (замер) | serializable | read committed | repeatable read | read committed |
| Лицензия (версии стенда) | своя, с ключом и телеметрией | Apache-2.0 (ядро) | Apache-2.0 | MulanPubL-2.0 (в master — Apache-2.0) |
| Версия на стенде | v26.2.5 | 2026.1.2.0 (PostgreSQL 15.12) | v8.5.8 | 4.4.2.1 CE |
| Узлов на стенде | 3 | 3 | 1 PD + 3 TiKV + 1 tidb | 1 |
Версии сняты с живых кластеров. У OceanBase образ oceanbase-ce:4.4.2-lts — это не последний релиз проекта: на GitHub ветка уже дошла до v4.6.0_CE, но в Docker Hub тег latest по-прежнему указывает на 4.4.2. Номер версии в статьях об OceanBase стоит сверять именно по образу, который запущен.
Крайние точки — TiDB и OceanBase. У TiDB три вида процессов, и SQL-слой отделён от данных совсем: tidb-сервер ничего не хранит, его масштабируют отдельно от TiKV, а PD — критичный компонент, который в проде ставят тройкой. У OceanBase один процесс observer, который совмещает SQL, хранение и консенсус. CockroachDB тоже один бинарник, но с распределённым SQL-исполнением на каждом узле; YugabyteDB — две роли (yb-master для метаданных и yb-tserver для данных и YSQL), которые обычно запускают парой на каждом узле.
Практическое следствие простое. Чем больше видов узлов, тем гибче масштабирование — вычисления отдельно, хранение отдельно, — и тем больше движущихся частей у эксплуатации.
HTAP — одним абзацем, без пересказа маркетинга. TiDB и OceanBase оба обещают аналитику рядом с транзакциями, но архитектурно по-разному. TiDB выносит её в отдельное колоночное хранилище TiFlash. Его реплики получают изменения из TiKV как Raft-learner и в кворуме записи не участвуют, а оптимизатор сам решает, читать строки или колонки. OceanBase заявляет обработку внутри того же движка, без отдельного хранилища. Проверять такие утверждения по документации бессмысленно: имеет смысл только прогон смешанной нагрузки с наблюдением за тем, как аналитический запрос влияет на p99 транзакционного. Стенд этой статьи его не делает — TiFlash добавил бы ещё пару гигабайт к и без того предельной памяти, а OceanBase здесь в одном узле, — поэтому оставляю это отдельной темой.
Цена: сколько стоит одна операция
Главная цена distributed SQL — латентность, и считать её надо не в абсолютных миллисекундах, а в раунд-трипах между узлами. Стенд меряет шесть видов операций над таблицей kv с четырьмя диапазонами:
| Операция | Что делает |
|---|---|
read |
точечное чтение по ключу |
write1 |
UPDATE одной строки, автокоммит |
txn1x2 |
явная транзакция: две строки в одном диапазоне |
txn2 |
явная транзакция: две строки в двух диапазонах |
txn1x4 |
явная транзакция: четыре строки в одном диапазоне |
txn4 |
явная транзакция: четыре строки в четырёх диапазонах |
Пары txn1x2/txn2 и txn1x4/txn4 нужны, чтобы развести две причины роста: «ещё один оператор» и «ещё одна консенсус-группа». Клиент один, соединение одно, операции идут по очереди — меряется цена операции, а не пропускная способность.
Два решения методики определяют, чему можно верить в числах ниже.
Лидеры разнесены явно и не на шлюз. У TiDB шлюз — tidb-сервер — данных не держит вообще, поэтому любая операция идёт по сети к TiKV. У CockroachDB и YugabyteDB лидер может случайно оказаться на том же узле, куда подключён клиент, и тогда чтение обходится без сети. Чтобы путь был одинаковым — клиент → шлюз → лидер на другом узле, — скрипт place-leaders.sh переносит лидеров диапазонов 0 и 2 на второй узел, 1 и 3 — на третий. После каждого замера раскладка снимается ещё раз: ребалансировка её не увела ни на одном из трёх кластеров.
Задержка между узлами назначенная. netem вешает её в сетевом пространстве каждого узла и только на пакеты к соседям по кластеру, а путь клиент → шлюз остаётся чистым. Точки — 0 (как есть, одна машина), 2 мс (узлы в разных зонах одного региона) и 30 мс (в разных регионах). Это модель, а не измерение чьей-то сети, но она даёт главное: показывает, сколько раунд-трипов стоит каждая операция. Вот точка 30 мс у CockroachDB — сначала контроль задержки, потом замер:
$ bash scripts/netem.sh crdb 30
[netem] назначен RTT 30 мс между: crdb1 crdb2 crdb3
crdb1 -> crdb2: rtt min/avg/max/mdev = 30.189/30.408/30.834/0.228 ms
клиент -> crdb1: rtt min/avg/max/mdev = 0.076/0.136/0.215/0.045 ms
$ docker run --rm --network dsql dsql-bench latency -engine crdb -n 300
engine=crdb  n=300 на вид, одно соединение, последовательно
read     n=300  p50=  31.67 p95=  32.95 p99=  34.02 ms  retries=0
write1   n=300  p50=  94.90 p95=  98.67 p99= 100.42 ms  retries=0
txn1x2   n=300  p50= 128.03 p95= 132.83 p99= 135.11 ms  retries=0
txn2     n=300  p50= 128.03 p95= 133.53 p99= 162.35 ms  retries=0
txn1x4   n=300  p50= 191.91 p95= 198.84 p99= 203.59 ms  retries=0
txn4     n=300  p50= 193.15 p95= 199.88 p99= 209.27 ms  retries=0
Сводка по трём кластерам — p50 в миллисекундах:
| RTT между узлами | Движок | read | write1 | txn1x2 | txn2 | txn1x4 | txn4 |
|---|---|---|---|---|---|---|---|
| 0 | CockroachDB | 0,27 | 2,04 | 1,78 | 2,21 | 3,05 | 2,92 |
| 0 | YugabyteDB | 0,44 | 0,92 | 1,67 | 1,75 | 3,01 | 3,04 |
| 0 | TiDB | 0,69 | 1,18 | 1,38 | 1,61 | 2,32 | 2,55 |
| 2 мс | CockroachDB | 2,35 | 7,42 | 9,94 | 10,12 | 14,70 | 15,38 |
| 2 мс | YugabyteDB | 2,77 | 8,48 | 18,88 | 18,78 | 35,18 | 35,30 |
| 2 мс | TiDB | 2,84 | 12,33 | 15,73 | 15,84 | 21,15 | 21,88 |
| 30 мс | CockroachDB | 31,67 | 94,90 | 128,03 | 128,03 | 191,91 | 193,15 |
| 30 мс | YugabyteDB | 31,88 | 154,33 | 252,13 | 251,94 | 441,44 | 445,06 |
| 30 мс | TiDB | 32,23 | 156,93 | 195,74 | 195,78 | 264,53 | 263,49 |
И для сравнения — одиночные серверы на той же машине, без всякой задержки:
| Движок | read | write1 | txn1x2 | txn2 | txn1x4 | txn4 |
|---|---|---|---|---|---|---|
| PostgreSQL 17 | 0,04 | 0,12 | 0,23 | 0,24 | 0,32 | 0,32 |
| MySQL 8.4 | 0,07 | 0,48 | 0,62 | 0,62 | 0,79 | 0,79 |
| OceanBase 4.4, один observer | 0,13 | 0,54 | 0,83 | 0,83 | 1,15 | 1,14 |
Из таблиц следуют четыре вывода — с важной оговоркой о границах. Это один последовательный клиент, маленький набор данных, нет конкуренции и горячих ключей, а все группы живут на одних и тех же трёх узлах. Пропускную способность и поведение под нагрузкой стенд не проверяет.
В этом сценарии число диапазонов почти не влияло на p50, а число операторов — влияло. При назначенных RTT 2 и 30 мс медианы пар txn1x2/txn2 и txn1x4/txn4 близки у всех трёх — расхождение в пределах нескольких процентов. При RTT 0 различия заметнее: у CockroachDB txn2 дороже txn1x2 примерно на четверть, у TiDB — примерно на шестую часть. Насколько это воспроизводимо, по одному прогону сказать нельзя. Когда расстояние между узлами становится основной статьёй расходов, транзакция, задевшая четыре консенсус-группы, стоит практически столько же, сколько транзакция из тех же четырёх операторов в одной группе. Это согласуется с оптимизациями коммита, которые описаны в документации: parallel commits у CockroachDB и async commit у TiDB фиксируют участников параллельно, а не по очереди. Но какой путь коммита реально сработал в каждой транзакции, замер не показывает. Например, включённая tidb_enable_async_commit ещё не гарантирует, что async commit применён к конкретной транзакции. Наблюдение здесь такое: дорого каждое обращение оператора к своему лидеру, а не число групп как таковое.
Чувствительность к расстоянию у движков разная. Удобнее всего смотреть не на полную задержку, а на её прирост между точками 2 и 30 мс, делённый на прирост RTT. Получается, на сколько миллисекунд дорожает операция за каждую миллисекунду расстояния между узлами. Это эквивалент в RTT, а не измеренное число сетевых обменов. Фактический средний RTT отличался от назначенного: в точке 2 мс — до 2,45 мс, в точке 30 мс — до 30,9 мс. Для разности между точками это даёт ошибку в несколько процентов. Числа ниже — оценки, округлённые до десятых, а не установленная с такой точностью величина:
| Прирост задержки на 1 мс RTT (точки 2 → 30 мс) | read | write1 | txn1x2 | txn1x4 | каждый следующий оператор |
|---|---|---|---|---|---|
| CockroachDB | 1,0 | 3,1 | 4,2 | 6,3 | 1,1 |
| YugabyteDB | 1,0 | 5,2 | 8,3 | 14,5 | 3,1 |
| TiDB | 1,0 | 5,2 | 6,4 | 8,7 | 1,1 |
Чтение у всех дорожает ровно на одно расстояние до лидера: лидер отвечает сам, не собирая кворум. С записью картина расходится. У CockroachDB каждый следующий UPDATE в транзакции добавляет около одного RTT — это согласуется с документированной конвейеризацией записей, когда оператор возвращается, не дожидаясь репликации, а кворум собирается к коммиту. У YugabyteDB каждый следующий оператор добавляет около трёх RTT, поэтому длинная транзакция дорожает втрое быстрее. TiDB дорог на старте — эквивалент пяти RTT на одиночную запись, в который входят обращения к PD за метками времени, — зато каждый следующий оператор добавляет около одного. Как задержка раскладывается по фазам протокола, стенд не снимал: для этого нужна трассировка, а здесь меряется только итог, видимый клиенту.
Одиночная операция медленнее одиночного сервера. На стенде даже при нулевой задержке запись у кластеров стоит 0,9–2 мс против 0,12 мс у PostgreSQL. Но это сравнение с одной копией данных без репликации, и гарантии при отказе у них разные: одиночный сервер теряет доступность вместе с узлом. Поэтому не вся разница — цена distributed SQL как такового. Часть её заплатил бы и PostgreSQL с синхронной репликой, тот самый дефолт «PostgreSQL плюс Patroni»: коммит ждал бы подтверждения реплики. Сколько именно, стенд не мерил — такого контроля в нём нет. Таблица одиночных серверов — базовая стоимость операции, а не альтернатива с теми же гарантиями. Абсолютные числа при RTT 0 между движками сравнивать не стоит: урезанные лимиты памяти, одна машина, разные настройки по умолчанию. Смысл имеют соотношения и рост с RTT. Выигрыш distributed SQL ищут в масштабе записи и в переживании отказа узла, а не в латентности одной операции; масштаб записи этот стенд не мерил.
Расстояние между узлами умножает всё. Точка 30 мс на стенде — конкретная модель: три узла в трёх условных регионах, одинаковый RTT между всеми парами, лидер всегда не на шлюзе. В этой модели одиночная запись стоила 95–157 мс, а транзакция из четырёх операторов — 0,19–0,45 секунды. Удалённый раунд-трип неизбежен, когда подтверждающий кворум пересекает регионы, а в этой модели он пересекает их всегда. В других топологиях иначе. Если большинство реплик держать в одном регионе, запись подтверждается внутри него, но переживание потери этого региона уже не гарантировано. Если лидер стоит рядом с клиентом, один межузловой переход уходит с пути запроса. Снижают цену архитектурой данных, а не настройкой. Лидеры размещаются рядом с теми, кто пишет (гео-партиционирование), чтения разрешаются с ближайшей реплики ценой небольшой устарелости (follower reads), а транзакции проектируются короткими — меньше операторов, пакетные UPDATE вместо цикла. Как это устроено у одного движка в деталях — в статье про геораспределение CockroachDBготовится, с 31 октября.
Что обещано по умолчанию: изоляция
«Сериализуемые транзакции» — главный пункт в обещании NewSQL. Проверить его можно на классическом сценарии, который ловит сериализуемость — или явная блокировка прочитанных строк, о ней ниже: write skew, он же «дежурные врачи». Двое на дежурстве, правило — хотя бы один должен остаться. Две транзакции одновременно читают, сколько врачей дежурит, видят двоих, и каждая снимает с дежурства «себя». Строки разные, конфликта записи нет, и уровень, который следит только за конфликтами записи, пропустит обе.
Сценарий одинаковый для всех: шаги идут в фиксированном порядке, а UPDATE выполняется, только если транзакция увидела двух дежурных — как в настоящем приложении. Сначала CockroachDB, уровень по умолчанию:
$ docker run --rm --network dsql dsql-bench skew -engine crdb -iso default
T1  BEGIN                                                -> ok
T2  BEGIN                                                -> ok
T1  SHOW transaction_isolation                           -> serializable
T1  SELECT count(*) FROM oncall WHERE on_call = 1        -> 2
T2  SELECT count(*) FROM oncall WHERE on_call = 1        -> 2
T1  UPDATE oncall SET on_call = 0 WHERE id = 1           -> ok
T2  UPDATE oncall SET on_call = 0 WHERE id = 2           -> ok
T1  COMMIT                                               -> SQLSTATE 40001: restart transaction: TransactionRetryWithProtoRefreshError: TransactionRetryError: retry txn (RETRY_SERIALIZABLE): "sql txn" meta={id=a16e0f19 key=/Table/105...
T2  COMMIT                                               -> ok
итог: на дежурстве 1 — инвариант цел
Здесь обещание выполнено: уровень по умолчанию — SERIALIZABLE, и одна из транзакций получает 40001 на коммите. Теперь тот же сценарий на YugabyteDB:
$ docker run --rm --network dsql dsql-bench skew -engine yb -iso default
T1  BEGIN                                                -> ok
T2  BEGIN                                                -> ok
T1  SHOW transaction_isolation                           -> read committed
T1  SELECT count(*) FROM oncall WHERE on_call = 1        -> 2
T2  SELECT count(*) FROM oncall WHERE on_call = 1        -> 2
T1  UPDATE oncall SET on_call = 0 WHERE id = 1           -> ok
T2  UPDATE oncall SET on_call = 0 WHERE id = 2           -> ok
T1  COMMIT                                               -> ok
T2  COMMIT                                               -> ok
итог: на дежурстве 0 — АНОМАЛИЯ write skew: на дежурстве никого
Обе транзакции закоммитились, на дежурстве никого. Ошибки здесь нет: YugabyteDB по умолчанию работает в READ COMMITTED, как и PostgreSQL, а этот уровень write skew не ловит по определению. Если явно попросить SERIALIZABLE, аномалию YugabyteDB поймает. Самое неожиданное — у OceanBase:
$ docker run --rm --network dsql dsql-bench skew -engine ob -iso serializable
T1  START TRANSACTION                                    -> ok
T2  START TRANSACTION                                    -> ok
T1  SELECT @@transaction_isolation                       -> SERIALIZABLE
T1  SELECT count(*) FROM oncall WHERE on_call = 1        -> 2
T2  SELECT count(*) FROM oncall WHERE on_call = 1        -> 2
T1  UPDATE oncall SET on_call = 0 WHERE id = 1           -> ok
T2  UPDATE oncall SET on_call = 0 WHERE id = 2           -> ok
T1  COMMIT                                               -> ok
T2  COMMIT                                               -> ok
итог: на дежурстве 0 — АНОМАЛИЯ write skew: на дежурстве никого
Уровень SERIALIZABLE принят, переменная сессии его показывает, а аномалия проходит. Документация OceanBase описывает этот уровень через снимок данных на начало транзакции, полученный от GTS. По сути это snapshot isolation, и запуск это подтверждает. Название уровня здесь не гарантирует свойства, которое за ним стоит в стандарте и в PostgreSQL.
Сводка по всем шести, включая одиночные PostgreSQL 17 и MySQL 8.4 как эталоны своих протоколов:
| Движок | Уровень по умолчанию | Write skew по умолчанию | Под SERIALIZABLE | SELECT … FOR UPDATE |
|---|---|---|---|---|
| PostgreSQL 17 | read committed | проходит | ловит: 40001 на коммите |
защищает |
| CockroachDB 26.2 | serializable | ловит: 40001 на коммите |
ловит | защищает |
| YugabyteDB 2026.1 | read committed | проходит | ловит: 40P01 deadlock на UPDATE |
защищает |
| MySQL 8.4 | repeatable read | проходит | ловит: 1213 deadlock на UPDATE |
защищает |
| TiDB 8.5 | repeatable read (пессимистичный режим) | проходит | не поддерживается: ERROR 8048; с skip_isolation_level_check — принят, но пропускает |
защищает |
| OceanBase 4.4 | read committed | проходит | принят, но пропускает | защищает |
Write skew по умолчанию из четырёх движков поймал один — CockroachDB, у которого SERIALIZABLE и есть уровень по умолчанию. YugabyteDB поймал его под явно запрошенным SERIALIZABLE. У TiDB такого уровня нет: уровень SERIALIZABLE отклоняется с ERROR 8048. Текст ошибки сам предлагает обходной путь — флаг tidb_skip_isolation_level_check, и стенд проверил, что он делает:
$ docker run --rm --network dsql dsql-bench skew -engine tidb -iso skipcheck
T1  START TRANSACTION                                    -> ok
T2  START TRANSACTION                                    -> ok
T1  SELECT @@transaction_isolation                       -> SERIALIZABLE
T1  SELECT count(*) FROM oncall WHERE on_call = 1        -> 2
T2  SELECT count(*) FROM oncall WHERE on_call = 1        -> 2
T1  UPDATE oncall SET on_call = 0 WHERE id = 1           -> ok
T2  UPDATE oncall SET on_call = 0 WHERE id = 2           -> ok
T1  COMMIT                                               -> ok
T2  COMMIT                                               -> ok
итог: на дежурстве 0 — АНОМАЛИЯ write skew: на дежурстве никого
Флаг снимает только проверку названия: сессия теперь называет себя SERIALIZABLE, а поведение остаётся прежним. Включать его ради «совместимости» опасно — код, который проверяет уровень изоляции, получит ложное подтверждение. У OceanBase уровень с этим названием есть, но write skew он не ловит.
Последний столбец — практический выход для всех, но с оговоркой. Если инвариант держится на прочитанных строках, их надо заблокировать явно (SELECT … FOR UPDATE): вторая транзакция ждёт первую, после её коммита видит одного дежурного и уходить не может. В этом сценарии это сработало на всех шести. Но защищает ли FOR UPDATE инвариант, который зависит от отсутствия строк — «не больше трёх записей на врача», «нет пересекающихся бронирований», — зависит от движка, уровня изоляции и формы запроса. Это ещё одно место, где «совместим с MySQL» протекает. По документации InnoDB, в MySQL под REPEATABLE READ диапазонное блокирующее чтение ставит next-key и gap locks, и конкурирующая вставка в этот диапазон ждёт. TiDB gap locks не поддерживает, поэтому та же вставка в диапазон проходит. Зато под REPEATABLE READ точечный FOR UPDATE по первичному или уникальному ключу TiDB блокирует даже тогда, когда строки с таким ключом нет; под READ COMMITTED такого поведения нет. В PostgreSQL FOR UPDATE блокирует только найденные строки. На стенде эти варианты не прогонялись — здесь пересказ документации, и перед тем как полагаться на поведение, его стоит проверить на своём движке. Надёжнее, чем блокировки, — ограничения уровня схемы: уникальный индекс, exclusion constraint там, где он есть, блокировка «родительской» строки или настоящая сериализуемость. И это дисциплина в коде, а не свойство базы: забытый FOR UPDATE в одном месте возвращает аномалию.
Границы самого теста тоже стоит назвать. Пропущенная аномалия доказывает, что уровень не сериализуем. Пойманная доказывает меньше: один сценарий write skew — необходимая проверка, а не доказательство сериализуемости. Систематически аномалии ищут инструменты вроде Jepsen и Elle: они гоняют конкурентные истории под сбоями и проверяют каждую на соответствие модели согласованности. Но и они не доказывают корректность: успешный прогон значит, что в собранных историях нарушений не нашлось, а не что их нет во всех возможных выполнениях.
Совместимость: где протекает
«Совместим с PostgreSQL» и «совместим с MySQL» означает прежде всего протокол: штатный драйвер подключается, запросы ходят. Что за протоколом, проверяется только прогоном. Стенд выполняет один и тот же список конструкций штатным драйвером — pgx для PG-wire, go-sql-driver/mysql для MySQL-wire — и записывает дословный ответ. Эталон каждой колонки — оригинал протокола: PostgreSQL 17 и MySQL 8.4.
Проверки здесь разной силы, и это важно для чтения таблиц. Часть из них проверяет результат или поведение: какие id выдал SERIAL, отклонена ли нарушающая строка, что вернула функция, сработал ли триггер, что осталось после ROLLBACK. Другая часть проверяет только, что оператор принят — DDL создал индекс или событие, SKIP LOCKED выполнился. Конкурентная семантика (SKIP LOCKED при занятой строке, CREATE INDEX CONCURRENTLY под нагрузкой, доставка NOTIFY, исполнение EVENT по расписанию) не проверялась нигде. «Принят» — первичный фильтр совместимости, а не доказательство, что конструкция ведёт себя как в оригинале.
Сначала PG-wire:
| Проверка | Что проверено | PostgreSQL 17 | CockroachDB | YugabyteDB |
|---|---|---|---|---|
какие id выдаёт SERIAL |
результат | 1,2,3 |
1215889313195163649,… |
1,2,3 |
последовательность, gen_random_uuid(), функция на PL/pgSQL, триггер BEFORE INSERT |
результат | как ожидалось | как ожидалось | как ожидалось |
| FK и CHECK: нарушающая строка | поведение | отклонена | отклонена | отклонена |
JSONB + GIN, частичный индекс, генерируемая колонка, pg_trgm, процедура + CALL, SKIP LOCKED, CREATE INDEX CONCURRENTLY |
оператор принят | принят | принят | принят |
LISTEN / NOTIFY |
оператор принят | принят | синтаксическая ошибка | 0A000: LISTEN/NOTIFY is disabled |
pg_advisory_lock |
блокировка взята, без конкурента | взята | 42883: unknown function |
взята |
EXCLUDE USING gist |
оператор принят | принят | 0A000: unimplemented |
0A000: EXCLUDE constraint not supported yet |
| DDL откатывается с транзакцией | поведение | да | нет | нет |
INSERT перед DDL откатывается |
поведение | да | нет, строка закоммичена | да |
BEGIN ISOLATION LEVEL REPEATABLE READ даёт |
результат | repeatable read | serializable | repeatable read |
Три строки здесь важнее остальных — отсутствующую функцию видно сразу, а эти протекают молча.
SERIAL у CockroachDB — не последовательность. Колонка получает unique_rowid(): уникальные, растущие во времени, но огромные и с дырами числа. Код, который ждёт 1, 2, 3 или считает max(id) числом строк, сломается тихо. Причина — цена координации: настоящая последовательность в кластере требует общего счётчика, и каждый новый id стоил бы обращения к одной точке. unique_rowid() генерируется на узле без координации — из времени и номера узла.
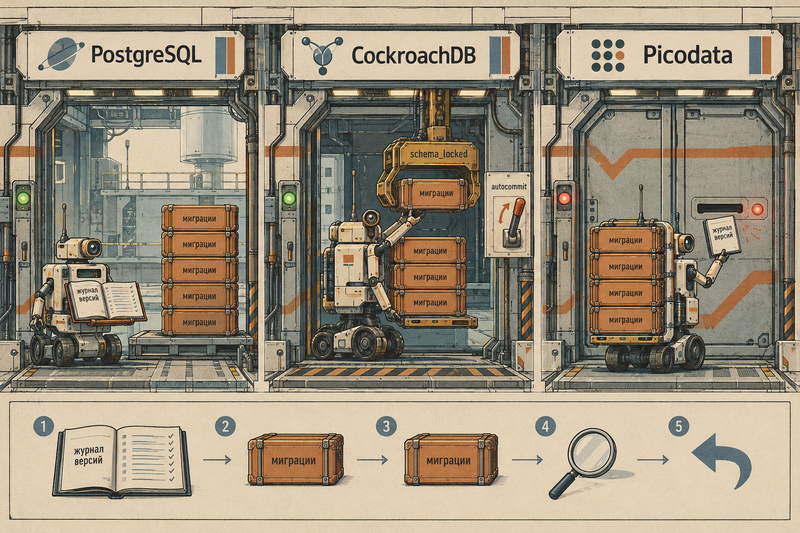
DDL в транзакции. Миграции часто оборачивают в транзакцию в расчёте на атомарность: упала середина — откатилось всё. В PostgreSQL так и есть. В CockroachDB 26.2 по умолчанию включён autocommit_before_ddl: открытая транзакция коммитится перед DDL. Всё, что миграция успела записать до CREATE TABLE, остаётся в базе, а ROLLBACK в конце отвечает предупреждением «no transaction in progress». В YugabyteDB по умолчанию yb_ddl_transaction_block_enabled = off: DDL фиксируется отдельно и не откатывается, но DML вокруг него откатывается. Механика разная, вывод один — инструмент миграций надо проверить на этом движке, прежде чем ему доверять. Как разные мигрировщики ведут себя на разных базах, разобрано в статье про мигрировщики схем.
Уровень изоляции без ошибки. CockroachDB принимает REPEATABLE READ, но тихо выполняет транзакцию как serializable. Безопасно — уровень строже, — но приложение, рассчитанное на поведение REPEATABLE READ, начнёт получать 40001 там, где их не ждали.
Теперь MySQL-wire:
| Проверка | Что проверено | MySQL 8.4 | TiDB 8.5 | OceanBase 4.4 |
|---|---|---|---|---|
какие id выдаёт AUTO_INCREMENT, GET_LOCK, SAVEPOINT / ROLLBACK TO |
результат | как ожидалось | как ожидалось | как ожидалось |
| FK: нарушающая строка | поведение | отклонена | отклонена | отклонена |
| CHECK: нарушающая строка | поведение | отклонена | вставлена молча (предупреждение tidb_enable_check_constraint is off) |
отклонена |
триггер BEFORE INSERT |
результат | сработал | синтаксическая ошибка | сработал |
JSON с функциональным индексом, генерируемая колонка, SKIP LOCKED |
оператор принят | принят | принят | принят |
процедура + CALL, XA-транзакция |
выполнено без ошибки | да | ERROR 8108 / синтаксическая ошибка |
да |
FULLTEXT-индекс |
оператор принят + SHOW WARNINGS |
принят | принят с предупреждением 1214 — индекса нет | принят |
SPATIAL-индекс, CREATE EVENT |
оператор принят | принят | синтаксическая ошибка | принят |
SET … SERIALIZABLE |
результат | принят | ERROR 8048 |
принят (но см. раздел об изоляции) |
INSERT перед DDL откатывается |
поведение | нет | нет | нет |
Последняя строка одинакова у всех троих, и это не дефект: неявный коммит перед DDL — родное поведение MySQL, его повторяют обе совместимые базы.
Ни в одной проверке OceanBase не разошёлся с MySQL. Но это значит ровно то, что сказано в колонке «что проверено»: для половины строк — что оператор принят. Это хороший первичный сигнал, но не подтверждение полной совместимости, а SERIALIZABLE у него, как показано выше, принят и не работает. TiDB протекает в двух направлениях. Отказ с ошибкой на триггерах, процедурах, событиях и XA неприятен, но честен — его увидит первый же прогон миграций. Хуже конструкции, которые принимаются молча: CHECK без включённого флага не проверяется, а FULLTEXT-индекс не создаётся. Без проверки SHOW WARNINGS оба выглядят как успех. У стенда эта проверка появилась ровно потому, что первая версия записала FULLTEXT в «работает».
И оговорка про AUTO_INCREMENT. Здесь у TiDB 1,2,3, потому что tidb-сервер один. По документации TiDB, при нескольких серверах каждый выделяет себе пачку значений, и id перестают быть монотонными по времени вставки. На стенде это не воспроизводилось.
Отказ узла: сколько ждёт приложение
Консенсус обещает, что потеря одного узла из трёх не теряет подтверждённых записей и не останавливает систему насовсем. Но пока оставшиеся реплики не заметят смерть лидера и не выберут нового, запись в его диапазон ждёт. Стенд проверяет обе половины обещания.
Один клиент непрерывно пишет в ключ 1 (UPDATE kv SET v = v + 1), подключившись к шлюзу. Через 10 секунд узел, где живёт лидер диапазона этого ключа, получает docker kill — SIGKILL процессу базы, без корректного завершения. Это внезапная гибель процесса, а не отказ питания: ОС и её дисковые кэши при этом живы, так что потерю данных из незасинхронизированных буферов такой тест не моделирует. Шлюз не трогаем: меряется смена лидера, а не переподключение клиента. Таймаут одной попытки — 30 секунд, чтобы зависший запрос дождался нового лидера, а не оборвался раньше и не подмешал в замер величину таймаута.
Сохранность проверяется арифметикой. Каждый успешный UPDATE прибавляет единицу, поэтому прирост значения за прогон должен быть не меньше числа подтверждённых коммитов — иначе подтверждённая запись потеряна. И не больше этого числа плюс число попыток с неизвестным исходом: такая запись могла и пройти.
$ docker run -d --name dsql-failover --network dsql dsql-bench failover -engine crdb -key 1 -duration 40s >/dev/null; \
    sleep 10; docker kill crdb2 >/dev/null; docker wait dsql-failover >/dev/null; \
    docker logs dsql-failover | grep -E 'пауза|ошибка|сохранность'; docker rm dsql-failover >/dev/null
самая длинная пауза между коммитами: 3.71 с (началась на 10.0 с)
ошибка x1: SQLSTATE 40003: result is ambiguous: error=ba: Put [/Table/104/1/1/0], EndTxn(parallel commit) [/Table/104/1/1/0], [txn: 01346916], [protect-ambiguous-replay] RPC error: EOF...
сохранность: подтверждено 37276, исход неизвестен 1, прирост v 37277 — сходится: подтверждённые записи на месте
$ docker run -d --name dsql-failover --network dsql dsql-bench failover -engine yb -key 1 -duration 40s >/dev/null; \
    sleep 10; docker kill yb2 >/dev/null; docker wait dsql-failover >/dev/null; \
    docker logs dsql-failover | grep -E 'пауза|ошибка|сохранность'; docker rm dsql-failover >/dev/null
самая длинная пауза между коммитами: 15.11 с (началась на 10.0 с)
сохранность: подтверждено 12787, исход неизвестен 0, прирост v 12787 — сходится: подтверждённые записи на месте
| Движок | Пауза записи после гибели лидера (по прогонам) | Ошибки у клиента | Сохранность |
|---|---|---|---|
| CockroachDB | 3,77 · 3,65 · 3,71 с | одна: 40003 result is ambiguous |
сходится; запись с неизвестным исходом прошла |
| YugabyteDB | 15,13 · 15,11 с | нет — запрос висел и дождался | сходится |
| TiDB | 23,34 · 11,74 с | нет — запрос висел и дождался | сходится |
Проверка сохранности добавлена в стенд после первых прогонов, поэтому её результат — только у последнего прогона каждого движка. В нём подтверждённые записи на месте у всех трёх, и после паузы запись пошла дальше на двух оставшихся узлах без ручных действий. Это наблюдение одного сценария — одна строка, один клиент, SIGKILL, — а не доказательство отсутствия потерь при любых отказах. Искать такие потери систематически — работа для инструментов вроде Jepsen, и даже они дают поиск нарушений, а не доказательство их отсутствия.
Длительность паузы — наблюдение для этой конфигурации, а не характеристика движка. В неё входят обнаружение отказа, выборы нового лидера, передача аренды, обновление маршрутов у шлюза и внутренние повторы запроса, и стенд не разделяет эти слагаемые. У TiDB два прогона разошлись вдвое, у остальных повторились с точностью до десятых. Все задействованные таймауты настраиваются ценой ложных перевыборов при сетевых всплесках, поэтому эту колонку стоит сравнивать с SLO своего приложения, а не движки между собой.
Строка CockroachDB важнее чисел. 40003 result is ambiguous означает, что клиент не знает, прошёл ли коммит: запрос ушёл, узел умер, ответа нет. Проверка сохранности показала, что на этот раз он прошёл: прирост на единицу больше числа подтверждённых коммитов. Повтори приложение эту транзакцию вслепую, единица была бы засчитана дважды. В одиночном PostgreSQL та же ситуация возникает при обрыве соединения во время COMMIT, просто реже и без отдельного кода ошибки. В распределённой базе это штатный исход отказа, и повтор после него должен быть идемпотентным. Один надёжный способ такой. У операции есть идентификатор, выданный до первой попытки, например UUID от клиента. Запись этого идентификатора в таблицу применённых операций с уникальным ключом и само изменение бизнес-данных выполняются в одной транзакции. При повторе используется тот же идентификатор: если первая попытка на самом деле закоммитилась, вставка идентификатора упрётся в уникальное ограничение, и транзакция откатится, ничего не применив дважды. Полумеры не работают. UPSERT с заново сгенерированным ключом создаст вторую строку, а проверка «не применено ли уже» отдельным запросом оставляет гонку между проверкой и выполнением. Для инкремента, как в этом тесте, это ровно разница между прибавить единицу один раз или два.
YugabyteDB и TiDB в этих прогонах ошибок не вернули: зависший запрос дождался нового лидера и завершился успешно. Для приложения это удобнее, но означает другое — 12–23 секунды запрос просто висит. Если у HTTP-обработчика над ним таймаут меньше, клиент получит ошибку от вашего же кода — и тот же вопрос «прошло или нет».
Повтор транзакции — забота приложения
В одиночном PostgreSQL под READ COMMITTED приложение может годами не встречать ошибку сериализации. В distributed SQL под SERIALIZABLE это штатный исход конкурентной записи: движок обрывает одну из транзакций и ждёт, что приложение повторит её целиком. Драйвер об этом ничего не знает — повтор пишет приложение.
Цикл на Go, которым пользуется сам стенд, выглядит так. В нём три обязательные для продакшена детали: операция фиксируется до цикла (ключи выбраны один раз — повтор выполняет ту же работу, а не новую), число попыток ограничено, а между попытками — экспоненциальная пауза со случайным джиттером, которую прерывает отмена контекста:
// Пределы повторов: без них конфликт, который не рассасывается, крутил бы
// цикл бесконечно, а повтор без паузы снова столкнул бы те же транзакции.
const (
	maxAttempts = 10
	baseBackoff = 5 * time.Millisecond
	maxBackoff  = 500 * time.Millisecond
)

// backoff — экспоненциальная пауза с полным джиттером, прерываемая контекстом.
func backoff(ctx context.Context, attempt int) error {
	d := baseBackoff << attempt
	if d > maxBackoff || d <= 0 {
		d = maxBackoff
	}
	t := time.NewTimer(time.Duration(rand.Int64N(int64(d)) + 1))
	defer t.Stop()
	select {
	case <-ctx.Done():
		return ctx.Err()
	case <-t.C:
		return nil
	}
}

// txnRows — явная транзакция, обновляющая по одной строке в каждом из shardsList.
// Ключи выбираются ДО цикла повторов: повтор обязан выполнить ту же самую
// операцию, а не новую. Повторяется по retryable-ошибкам не больше
// maxAttempts раз; возвращает число повторов.
func txnRows(ctx context.Context, db *sql.DB, engine string, shardsList []int) (int, error) {
	upd := "UPDATE kv SET v = v + 1 WHERE k = " + ph(engine, 1)
	keys := make([]int64, len(shardsList))
	for i, sh := range shardsList {
		keys[i] = shardKey(sh)
	}
	for attempt := 0; ; attempt++ {
		err := func() error {
			tx, err := db.BeginTx(ctx, nil)
			if err != nil {
				return err
			}
			defer tx.Rollback()
			for _, k := range keys {
				if _, err := tx.ExecContext(ctx, upd, k); err != nil {
					return err
				}
			}
			return tx.Commit()
		}()
		if err == nil || !retryable(err) {
			return attempt, err
		}
		if attempt+1 >= maxAttempts {
			return attempt, fmt.Errorf("сдались после %d попыток: %w", maxAttempts, err)
		}
		if err := backoff(ctx, attempt); err != nil {
			return attempt, err
		}
	}
}
Вся тонкость — в retryable, и её содержимое зависит от движка:
func retryable(err error) bool {
	var pe *pgconn.PgError
	if errors.As(err, &pe) {
		return pe.Code == "40001" || pe.Code == "40P01"
	}
	var me *mysql.MySQLError
	if errors.As(err, &me) {
		switch me.Number {
		case 1213, 9007, 8022:
			return true
		}
	}
	return false
}
40001 — serialization failure, его ждут все. Но YugabyteDB под SERIALIZABLE сообщает о конфликте кодом 40P01 — deadlock detected, — и цикл «только по 40001» на нём падает. Первая версия Java-иллюстрации стенда была написана ровно так и потеряла потоки. На MySQL-стороне коды свои у каждого: 1213 — deadlock в MySQL, 9007 и 8022 — конфликт записи и оборванная транзакция в TiDB. Кодов OceanBase в списке нет: на стенде он ни разу не вернул ретраибельной ошибки, а пополнять список без проверки — значит гадать. Список стоит собирать по документации конкретного движка и проверять нагрузочным тестом, а не переносить из статьи.
Второе правило — повторяется вся транзакция, включая чтения. Если приложение прочитало баланс, посчитало новый и записало, после 40001 нельзя повторить только запись: прочитанное значение устарело. Отсюда и разница в числе повторов, которую показывает Java-иллюстрация стенда — четыре потока, переводы между двумя одними и теми же счетами, SERIALIZABLE, штатный JDBC-драйвер PostgreSQL:
$ docker run --rm --network dsql -v "$PWD/javaretry:/app" -v dsql-m2:/root/.m2 -w /app \
    maven:3.9-eclipse-temurin-21 mvn -q compile exec:java -Dexec.args='crdb rmw 4 25'
engine=crdb режим=rmw потоков=4 переводов=100
заняло=0.3 с
успешно=100  сдались=0  оборваны лимитом (не применены)=0  исход неизвестен=0  упали с ошибкой=0  не начаты=0
повторов всего (включая оборванные)=118  максимум попыток среди успешных=5
ошибки по кодам: {40001=118}
сумма балансов=2000000 (ожидается 2000000)
$ docker run --rm --network dsql -v "$PWD/javaretry:/app" -v dsql-m2:/root/.m2 -w /app \
    maven:3.9-eclipse-temurin-21 mvn -q compile exec:java -Dexec.args='yb rmw 4 25'
engine=yb режим=rmw потоков=4 переводов=100
заняло=10.5 с
успешно=100  сдались=0  оборваны лимитом (не применены)=0  исход неизвестен=0  упали с ошибкой=0  не начаты=0
повторов всего (включая оборванные)=142  максимум попыток среди успешных=18
ошибки по кодам: {40001=1, 40P01=141}
сумма балансов=2000000 (ожидается 2000000)
Режим rmw — read-modify-write: прочитали оба баланса, посчитали в приложении, записали. В режиме update пишется UPDATE … SET balance = balance - ? без предварительного чтения:
| Движок | Режим | Успешно | Сдались после 20 попыток | Оборваны лимитом, не применены / исход неизвестен / не начаты | Повторов | Максимум попыток среди успешных | Заняло |
|---|---|---|---|---|---|---|---|
| CockroachDB | update |
100 | 0 | 0 / 0 / 0 | 0 | 1 | 0,3 с |
| CockroachDB | rmw |
100 | 0 | 0 / 0 / 0 | 118 | 5 | 0,3 с |
| YugabyteDB | update |
41 | 0 | 4 / 0 / 55 — остановлено лимитом 10 мин | 104 | 10 | 600,8 с |
| YugabyteDB | rmw |
100 | 0 | 0 / 0 / 0 | 142 | 18 | 10,5 с |
Графы в каждой строке таблицы складываются ровно в 100 переводов. Прогон останавливают сами рабочие потоки: перед каждым оператором они пересчитывают остаток до общего дедлайна и ставят его таймаутом оператора, а commit() ограничивают сетевым таймаутом соединения. Итоги печатаются только после того, как все потоки завершились. Исходы разведены по тому, известен ли результат фиксации. «Оборваны лимитом, не применены»: коммит либо не отправлялся, либо база явно сообщила об откате транзакции (40001 или 40P01, в том числе на самом commit()). Ошибки с неизвестным результатом фиксации учитываются отдельно, как «исход неизвестен»: ответ мог потеряться после успешной фиксации, ровно как с 40003 выше. В этих прогонах таких не было. Повторы считаются в момент каждой ошибки, так что в них входят и повторы оборванных переводов. Счётчик «ошибки по кодам» в выводе может быть на единицу больше на каждый сдавшийся перевод: его последняя ошибка уже не породила повтора.
Во всех прогонах сохранился инвариант общей суммы балансов — 2 000 000. Это проверка согласованности, но не доказательство, что каждый перевод выполнен ровно один раз: пропущенный перевод сумму не меняет, задвоенный — тоже. Чтобы проверить «ровно один раз», нужны идентификаторы операций и журнал применённых переводов со сверкой по каждому счёту — иллюстрация этого не делает. Из таблицы стоит унести другое.
В этом сценарии чистый UPDATE без предварительного чтения у CockroachDB не дал ни одного клиентского повтора: запись берёт блокировку строки, и конкуренты встают в очередь. Это не общее правило. Другой порядок захвата строк может привести к взаимоблокировке, а часть конфликтов CockroachDB разрешает внутренними повторами, которых клиент не видит. Повторы у клиента появились, как только приложение стало сначала читать, а потом писать, — то есть в обычной бизнес-логике.
У YugabyteDB почти все ошибки пришли с кодом 40P01, а не 40001 — то, о чём шла речь выше.
Режим update у YugabyteDB оказался патологически медленным. В последнем прогоне за 600,8 секунды успешно завершился 41 перевод, 4 оборваны лимитом и не применены, 55 не успели начаться. Каждый успешный перевод в среднем занимал секунды. Предыдущие прогоны давали похожую картину, но сняты измерителем, который ещё не останавливал потоки детерминированно, поэтому их числа здесь не приводятся. Причину на стенде я не раскапывал, и это не повод делать выводы о движке в целом. Но это повод перед запуском прогнать на нём собственный профиль конкурентной записи на горячих строках, а не полагаться на чужие бенчмарки.
Ретрай без паузы опасен: потоки, столкнувшиеся на одной строке, столкнутся снова на следующей же попытке, — отсюда пауза с джиттером и в Go-цикле выше, и в Java-иллюстрации. Повтор после 40003 (неопределённый результат при отказе, см. выше) должен использовать тот же идентификатор операции с атомарной защитой от повторного применения — механизм описан в разделе об отказе узла.
Когда оправдано, а когда нет
Числа выше складываются в довольно жёсткий критерий.
Distributed SQL стоит рассматривать, когда выполняется хотя бы одно:
- запись упирается в один primary, и её можно распределить по ключам — вертикальный рост исчерпан или неприлично дорог, а разделить запись по независимым базам нельзя, потому что транзакции пересекают границы. Условие «по ключам» обязательно: если вся нагрузка бьёт в одну горячую строку, добавление узлов её не ускорит — у строки один лидер;
- данные не помещаются на один узел, и их нельзя разрезать так, чтобы каждый кусок жил своей жизнью;
- запись нужна в нескольких регионах, и требования к ней сформулированы явно: какую согласованность видят читатели в разных регионах, какие RPO и RTO допустимы при потере региона, должна ли запись продолжаться при разделении сети. Если нужны нулевая потеря подтверждённой записи и автоматическое продолжение работы без региона, кворумная репликация между регионами — один из немногих готовых способов это получить. Цену стенд показал: при RTT 30 мс одиночная запись стоила 95–157 мс. Если допустимы асинхронная репликация и ручное переключение, задача решается и без distributed SQL.
Автоматическое переживание отказа узла само по себе основанием не является: PostgreSQL с Patroni тоже переключается автоматически. Различие — в том, что теряется при переключении и сколько оно длится, и это надо сравнивать на своих требованиях.
Преждевременная сложность, если:
- профиль нагрузки — чтение; реплики и кэш обычно закрывают его заметно дешевле и проще;
- объём умеренный, и PostgreSQL на хорошей машине с Patroni его держит — а держит он, как правило, больше, чем кажется;
- критичные пути — длинные интерактивные транзакции из многих операторов: каждый оператор стоит обращения к лидеру, и при любом заметном RTT это видно пользователю;
- команда не готова к ретраям:
40001из CockroachDB,40P01из YugabyteDB, неопределённый результат коммита при отказе — это код в приложении, а не настройка базы.
Ключ распределения решает больше, чем выбор движка. Стенд нарочно разносил ключи по разным диапазонам и лидерам, а в реальной системе раскладку определяет схема. Здесь две разные проблемы, и их легко смешать.
Первая — координация генератора идентификаторов. Общая последовательность — точка, через которую проходит каждая вставка. unique_rowid() у CockroachDB снимает именно её: id генерируется на узле без обращения к счётчику.
Вторая — концентрация вставок в одном диапазоне. Если первичный ключ растёт со временем, а это и автоинкремент, и временная метка, и тот же unique_rowid() со временем в старших битах, — новые строки ложатся в конец ключевого пространства. Их принимает один последний диапазон и его лидер, сколько бы узлов ни было в кластере. Против этого нужен другой инструмент — ключ, рассеивающий вставки. CockroachDB для этого рекомендует случайные UUID (gen_random_uuid()) или hash-sharded индексы. YugabyteDB по умолчанию шардирует первую колонку первичного ключа по хешу: та самая ловушка с ASC из раздела про диапазоны — обратная сторона этого выбора. У TiDB для этого есть AUTO_RANDOM. Горячий диапазон рано или поздно разрежут, но горячую строку разрезать нельзя.
Отдельный вопрос — где живут лидеры и реплики. В модели стенда лидер всегда стоял на другом узле, чем шлюз, и влияние размещения как такового стенд не мерил. Для этого нужен один и тот же запрос при разных положениях лидера. По устройству протоколов ожидаемо, что лидер рядом с пишущими клиентами снимает с пути запроса один межузловой переход.
Что попробовать до прыжка. Партиционирование в одном PostgreSQL снимает часть проблем объёма без распределённых транзакций. Citus даёт шардинг внутри экосистемы PostgreSQL — с оговорками, разобранными в статье про шардинг. Вынос аналитики в колоночное хранилище часто снимает «нагрузку на запись», которая на деле была тяжёлыми отчётами. И наконец, шардинг одной-двух горячих таблиц по ключу клиента, если транзакции через клиентов не пересекаются.
Если выбор сделан — какой движок? Здесь стенд даёт не рейтинг, а набор вопросов:
- нужна сериализуемость по умолчанию — из четырёх так настроен только CockroachDB, но ретраи и идемпотентность остаются заботой приложения;
- нужна совместимость с PostgreSQL глубже протокола — YugabyteDB, построенный на коде PostgreSQL 15, прошёл больше проверок; CockroachDB протекает в
SERIAL,LISTEN/NOTIFY, advisory locks и DDL в транзакциях; - стек на MySQL — TiDB с честным отказом на триггерах и процедурах и с молчаливым отказом на
CHECKиFULLTEXT, либо OceanBase, не разошедшийся с MySQL ни в одной проверке стенда (для половины из них это значит «оператор принят»), но сSERIALIZABLE, который им не является, и с меньшей распространённостью в русскоязычной практике; - важна лицензия — у CockroachDB с версии 24.3 нет свободной редакции: по документации многоузловой кластер без ключа через семь дней начинает троттлиться до пяти одновременных SQL-транзакций, а бесплатный ключ требует отправки телеметрии. TiDB
v8.5.8и ядро YugabyteDB распространяются под Apache-2.0. У OceanBase лицензия зависит от релиза: веткаmaster— Apache-2.0, а сборка 4.4.2.1 со стенда (тегv4.4.2_CE_BP1) — MulanPubL-2.0. Проверять стоитLICENSEименно того тега, который вы запускаете.
Как выглядит такое решение в развёрнутом виде для одного движка, со своим набором вопросов и дефолтом сравнения «PostgreSQL плюс Patroni», — в карте выбора CockroachDBготовится, с 3 ноября.
Комментарии