
Под SQL-слоем CockroachDB лежит распределённое KV-хранилище — диапазоны, Raft и арендаторы. Задача SQL-слоя: превратить обычный запрос в план, который исполняется сразу на нескольких узлах, и сделать это так, чтобы по сети ездило как можно меньше.
PG-совместимость здесь работает почти целиком: тот же синтаксис, тот же EXPLAIN, узнаваемые операторы. Но в выводе появляются строки, которых в PostgreSQL нет и быть не может, — и читать их надо уметь, потому что именно они объясняют, почему запрос стоит столько, сколько стоит.
Датасет: 50 000 покупателей и 500 000 заказов на трёхузловом кластере v26.2.5. Запрос — соединение с фильтром по дате, группировкой по городу и сортировкой.
В статье
- что показывает шапка
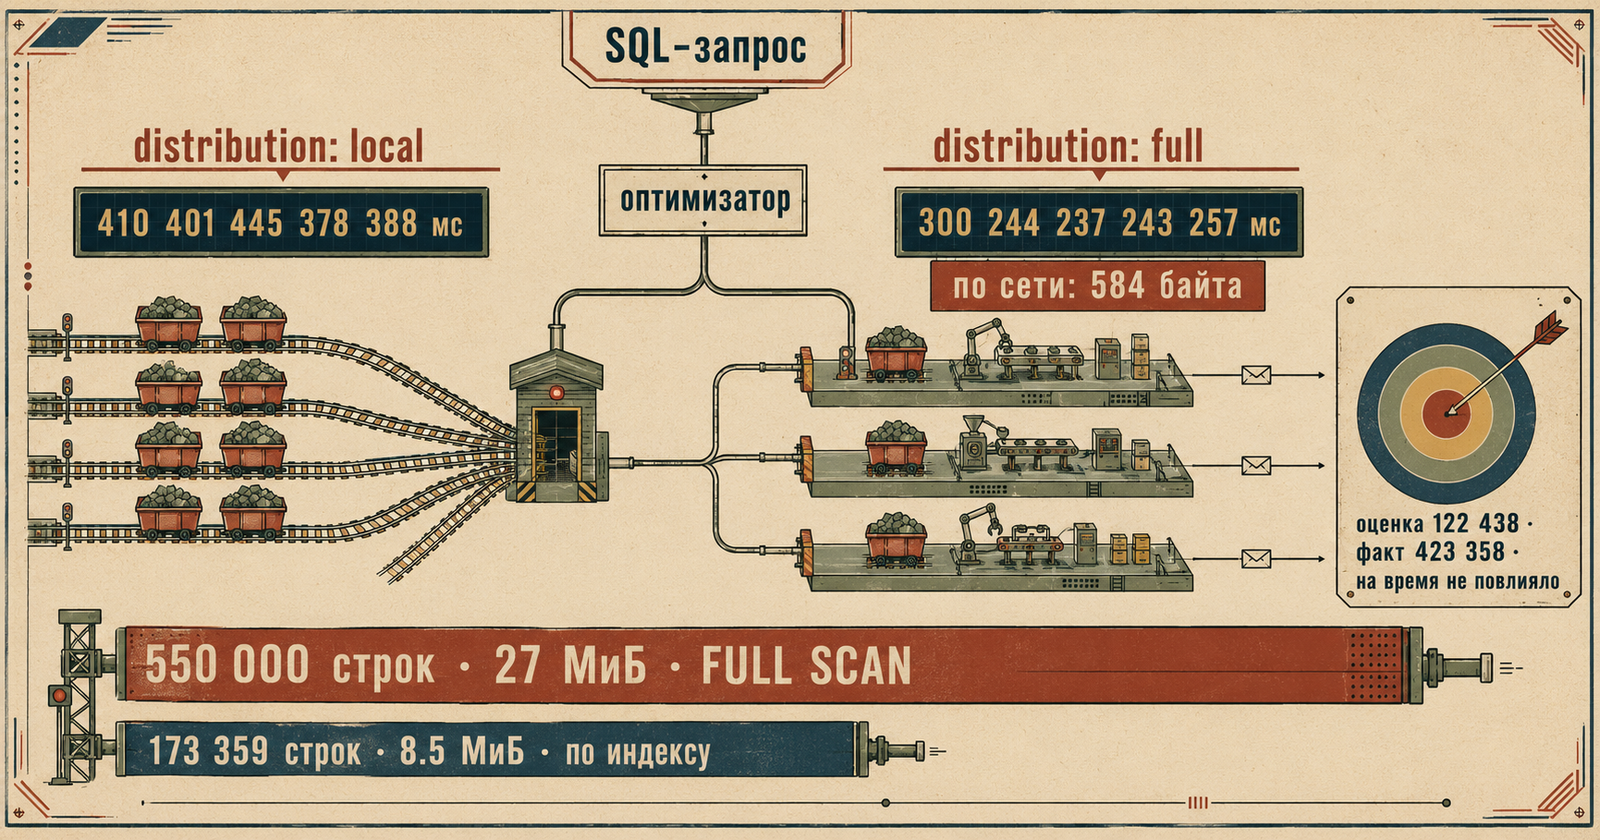
EXPLAIN ANALYZEв распределённом мире и как её читать; - локальный план против распределённого: полтора раза при одинаковом объёме чтения;
- сколько байт на самом деле едет по сети — и почему их так мало;
- индекс: 550 000 прочитанных строк превращаются в 172 862;
- статистика, которая не изменила ничего, — и почему это правильный результат;
- оптимизатор, промахнувшийся в 3.4 раза, и нулевая цена этого промаха.
Шапка EXPLAIN ANALYZE
Первое, что стоит выучить, — верхние шесть строк вывода:
planning time: 1ms
execution time: 343ms
distribution: full
rows decoded from KV: 550,000 (27 MiB, 4 gRPC calls)
DistSQL network usage: 584 B (29 messages)
regions: ru-central
Разбираем по строкам.
distribution — режим исполнения: local (всё считает узел-шлюз) или full (операторы разосланы по узлам). Это не про то, где лежат данные, а про то, где происходит вычисление.
rows decoded from KV — сколько строк реально поднято с нижнего слоя, с объёмом и числом сетевых вызовов. Главная метрика качества плана: прочитанные и выброшенные строки — чистые потери.
DistSQL network usage — сколько байт прошло между узлами при исполнении плана. Величина, которой в одноузловом мире просто нет.
regions — какие регионы были задействованы. На односегментном кластере строка неинформативна, но в многорегиональной топологииготовится, с 31 октября становится главной.
Локальный план против распределённого
Режимом исполнения можно управлять вручную — удобно ровно для того, чтобы увидеть разницу. По пять повторов каждого режима:
повтор 1:  local 392   full 293
повтор 2:  local 403   full 284
повтор 3:  local 396   full 300
повтор 4:  local 626   full 284
повтор 5:  local 396   full 284
Медиана 396 против 284 — распределённый план быстрее примерно в полтора раза.
Режимы здесь чередуются, а не идут блоками по пять. Блоками первый режим прогревает кеши для второго, и часть разницы между ними оказывается разницей между холодным и тёплым прогоном. В первой редакции замер был именно блочным.
При этом объём чтения одинаков: 550,000 (27 MiB, 4 gRPC calls) в обоих режимах. Данные читаются те же самые, разница только в том, где происходит фильтрация и агрегация.
Теперь главное число статьи:
DistSQL network usage: 584 B (29 messages)584 байта — и здесь важно не перепутать, о каком именно трафике речь.
DistSQL network usage считает обмен между процессорами плана: то, что операторы, разложенные по узлам, пересылают друг другу. Полкилобайта означает, что на сборку уехали не строки, а частичные агрегаты, — эта часть механики видна прямо.
Чего эта строка не говорит: что двадцать семь мегабайт не ходили по сети вообще. Чтение с нижнего слоя идёт через KV-запросы, и если диапазон обслуживается арендатором на другом узле, данные приедут к читателю по сети — просто этот трафик учитывается не здесь, а в строке rows decoded from KV: 550,000 (27 MiB, 4 gRPC calls). В локальном режиме та же строка показывает те же 550 000 строк и те же четыре вызова: KV-чтение от режима исполнения не зависит.
То есть корректная формулировка такая: распределённое исполнение убирает пересылку промежуточных строк между операторами, а не обращения к хранилищу. Чтобы утверждать больше — например, что каждый узел читал только свои локальные диапазоны, — нужен физический план с распределением процессоров по узлам (EXPLAIN (DISTSQL)) и карта арендаторов на момент запроса. Здесь этого не измерялось.
В локальном режиме строки DistSQL network usage в выводе нет вовсе: план не разложен на узлы, пересылать между процессорами нечего. Отсюда и разница в полтора раза — фильтрация с агрегацией выполняются в одном месте вместо трёх.
Практический смысл: если вы видите distribution: local на тяжёлом запросе по большой таблице — это повод разобраться. Обратное тоже верно: на мелком точечном запросе распределение только добавит накладных расходов, и оптимизатор правильно выбирает локальный режим сам.
Индекс: две трети чтения исчезают
Исходный план читает таблицу целиком:
table: orders@orders_pkey
spans: FULL SCAN
Добавляем индекс по колонке фильтра, с покрывающими колонками, чтобы не ходить за ними в основную таблицу:
CREATE INDEX orders_created_idx ON orders (created_at)
    STORING (customer_id, total);
Результат:
| Прочитано из KV | gRPC-вызовов | execution time | |
|---|---|---|---|
| Без индекса | 550 000 (27 MiB) | 4 | 289–315 мс |
| С индексом | 172 862 (8.4 MiB) | 2 | 90–116 мс |
Что читается после:
table: orders@orders_created_idx
spans: [/'2026-05-14 14:20:15.41703+00' - ]
Вместо полного сканирования — срез отсортированного ключевого пространства, начинающийся с границы фильтра. Прочитанный объём упал втрое, число сетевых вызовов вдвое, время втрое.
Вторичный индекс в CockroachDB — это отдельный набор диапазонов со своим порядком ключей. Поэтому STORING здесь важнее, чем кажется: без него плану пришлось бы за каждой строкой возвращаться в основную таблицу, то есть в другие диапазоны, возможно на других узлах. Покрывающий индекс превращает две распределённые операции в одну.
Про готовность индекса. «Онлайн» значит, что таблица доступна для чтения и записи, пока индекс строится, а не что команда возвращается раньше времени: обычный CREATE INDEX ждёт завершения своей задачи изменения схемы, и EXPLAIN после успешного возврата уже видит индекс. Стенд перед сравнением дополнительно проверяет, что индекс виден в SHOW INDEXES, — это страховка, а не доказательство, что без неё план был бы другим.
Статистика, которая ничего не изменила
Оптимизатор в CockroachDB стоимостной: он перебирает эквивалентные планы и выбирает дешёвый по оценке. Оценка строится на статистике — гистограммах распределения значений.
На свежем датасете статистики нет, и шапка плана честно сообщает missing stats. Собираем и сравниваем:
до сбора статистики:    299, 306, 291, 289, 315
после сбора статистики: 334, 247, 359, 272, 278
Разброс перекрывает разницу. Оценки после сбора сошлись с фактом почти идеально — estimated 123,619 при actual 122,862, — а план и время остались прежними.
Это не провал замера, но и не доказательство отсутствия альтернатив. Измерено ровно одно: выбранный план не изменился после сбора статистики. Утверждать, что у запроса вовсе нет альтернативных планов, по этим данным нельзя — для этого пришлось бы заставить оптимизатор построить другие варианты и сравнить их стоимость.
Правдоподобное объяснение при этом простое: одна таблица большая, вторая маленькая, соединение по первичному ключу, фильтр по единственной подходящей колонке — пространство выбора узкое. Но это гипотеза, а не результат.
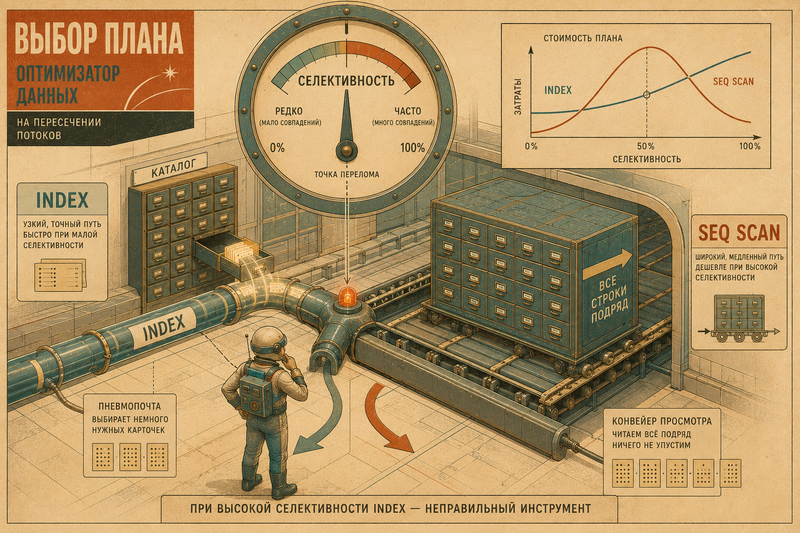
Статистика начинает работать там, где у оптимизатора есть развилка: какую таблицу сделать ведущей в соединении, брать индекс или сканировать, каким методом соединять. Нет развилки — нет и эффекта.
Промах втрое ценой в ноль
Чтобы увидеть расхождение, его надо создать. Доливаем 300 000 заказов, все в окно фильтра. Автосбор статистики при этом отключён — ALTER TABLE orders SET (sql_stats_automatic_collection_enabled = false), иначе фоновый сборщик мог бы обновить её прямо посреди фазы, и «устаревшая» статистика оказалась бы свежей. Скрипт дополнительно сверяет число записей статистики до и после долива: если оно изменилось, замер объявляется недействительным.
| Статистика | Оценка | Факт | Ошибка |
|---|---|---|---|
| Старая | 124 816 | 423 618 | в 3.4 раза |
| Свежая | 421 736 | 423 618 | 0.4 % |
Оптимизатор ожидал сто двадцать тысяч строк, а получил четыреста двадцать три тысячи. Промах в три с половиной раза — ровно то, чем пугают, рассказывая про устаревшую статистику.
А теперь время исполнения:
на старой статистике:  263, 265, 261, 262, 265
на свежей статистике:  264, 250, 245, 252
Одинаково в пределах разброса. Промах втрое не стоил ничего.
Вывод из этой пары чисел важнее их самих. Устаревшая статистика опасна не сама по себе — опасно то, что на её основе оптимизатор выберет неверный план. Если выбирать не из чего, ошибка в оценке остаётся арифметической и на исполнение не влияет. Цена появляется там, где неверная оценка переключает решение: развернуть порядок соединения, сменить метод, отказаться от индекса в пользу сканирования.
Отсюда практическое следствие: паника по поводу missing stats в шапке плана оправдана не всегда. Смотреть надо не на наличие статистики, а на расхождение estimated и actual в узлах плана, где есть выбор. Если расхождение большое там, где план мог пойти иначе, — вот это стоит чинить.
Как читать план в распределённом мире
Свод того, на что смотреть в порядке убывания важности.
rows decoded from KV. Сколько строк подняли с нижнего слоя. Если это число сильно больше, чем строк в ответе, — план читает лишнее.
spans. FULL SCAN на большой таблице — почти всегда повод для индекса. Ограниченный срез — то, к чему стремимся.
distribution. local на тяжёлом запросе — упущенная возможность считать рядом с данными.
DistSQL network usage. Килобайты — нормально. Мегабайты означают, что план тащит строки между узлами вместо того, чтобы агрегировать на месте: обычно это соединение по колонке, которая не является ключом распределения ни у одной из таблиц.
Расхождение estimated и actual. Само по себе не приговор; приговор — расхождение в узле, где план мог пойти иначе.
Что переносится из PostgreSQL, а что вводит в заблуждение
Переносится больше, чем кажется. Идея стоимостного оптимизатора, роль статистики, польза покрывающих индексов, вред полного сканирования большой таблицы — всё это работает так же.
Вводит в заблуждение оценка стоимости в голове. В одноузловом PostgreSQL «прочитать лишние четыреста тысяч строк» — это лишняя работа диска и памяти. Здесь к ней добавляется цена, которой в одном узле не было: строки могут ехать по сети между узлами. Поэтому индекс, экономящий чтение, в распределённой базе экономит больше, чем ожидаешь по опыту с PostgreSQL, — и STORING из необязательной оптимизации становится способом не ходить в чужие диапазоны.
Куда дальше
Мы разобрали, как запрос превращается в план и исполняется на нескольких узлах. Следующая статья — про то, что происходит, когда узлы разъезжаются по регионам: размещение данных, цели выживания и настоящая цена географии.
Демо и версии
Стенд: digital-cookbook/databases/cockroachdb, сценарий scripts/04-sql.sh. Четыре замера: локальный план против распределённого, эффект сбора статистики, эффект индекса и отдельно — устаревшая статистика с искусственно созданным расхождением. Каждый замер по пять повторов: на одиночных прогонах режимы меняются местами от запуска к запуску. Прогон — около десяти минут, большая часть уходит на налив датасета.
Версии: CockroachDB v26.2.5, три узла в docker на одной машине. Датасет — 50 000 покупателей и 500 000 заказов, в разделе про устаревшую статистику доливается ещё 300 000.
Документация
- SQL Layer — путь запроса от парсера до исполнителя.
- EXPLAIN ANALYZE — разбор вывода.
- Table Statistics — сбор и обновление.
- Indexes и STORING — покрывающие индексы.
Обсуждение в Telegram
Присоединиться →