
PG-совместимость CockroachDB — не маркетинговый слоган, а протокол: драйверы PostgreSQL подключаются без единой правки, сервер даже представляется как PostgreSQL 13.0.0. Ровно поэтому миграция кажется вопросом одного вечера, и ровно поэтому она таковым не оказывается.
Совместимость протокола не означает совместимости всего. Часть конструкций отсутствует, часть ведёт себя иначе, а распределённая природа протекает в те места, где в одноузловом PostgreSQL проблем не было вовсе. Эта статья — про то, что именно ломается, с точными текстами ошибок, и про эксплуатационные операции, замеренные на живом кластере.
Отдельный разговор — лицензия. С неё и начнём, потому что она может закрыть вопрос до всякой техники.
В статье
- лицензионная модель: 7 дней без ключа, обязательная телеметрия, порог выручки;
- Regular против Innovation: релиз, который умер через полгода после выхода;
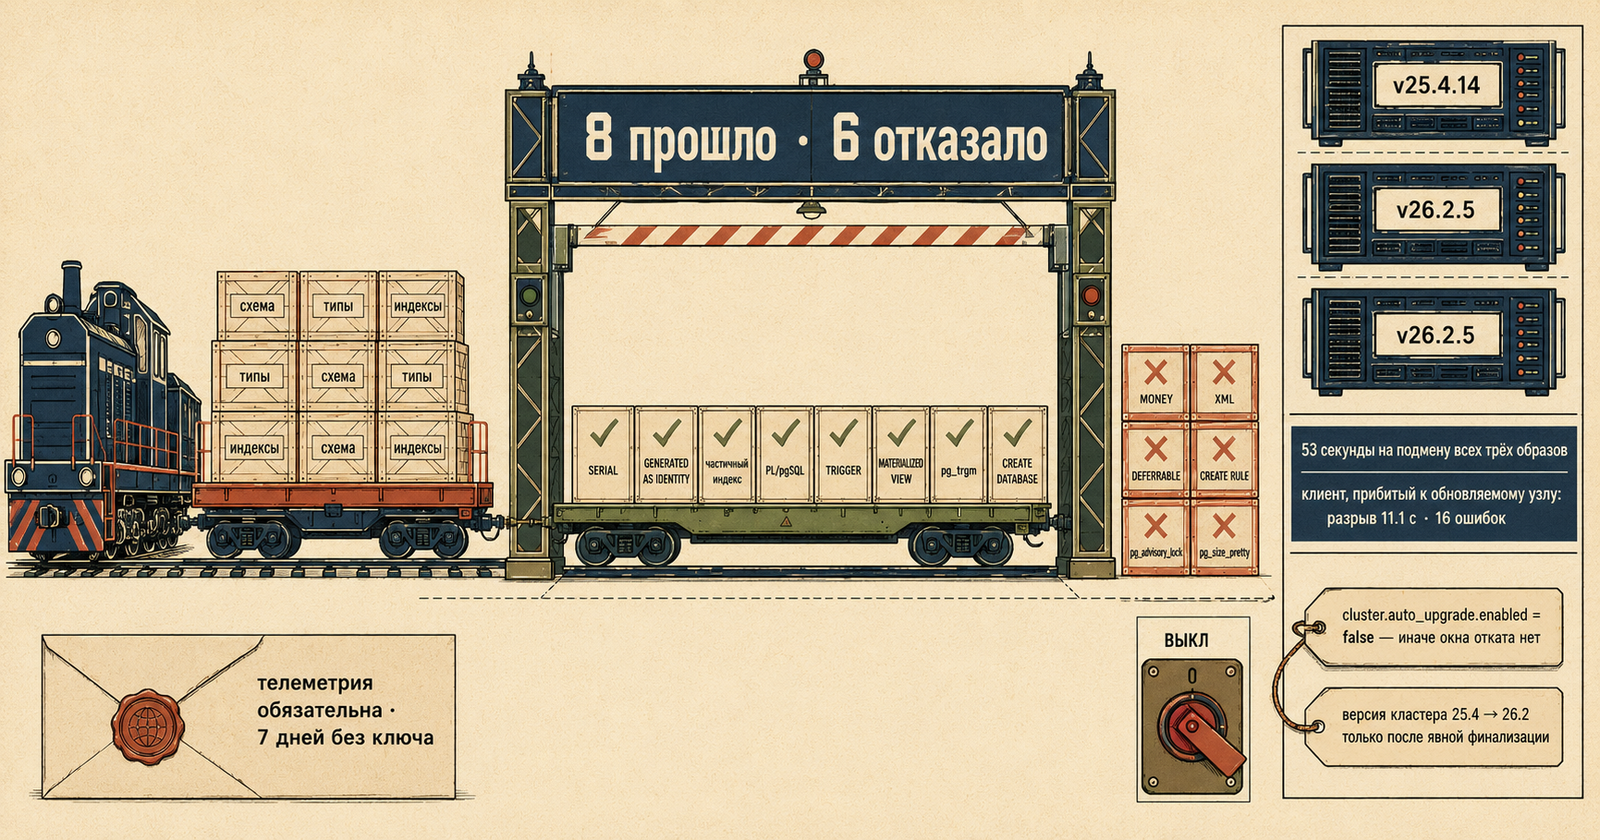
- схема PostgreSQL по одному оператору: 8 прошло, 6 отказало;
- во что превращается
SERIALи почему база сама против него возражает; - JDBC без правок — и retry-цикл, который придётся дописать руками;
- бэкап и восстановление со сверкой до строки;
- обновление кластера: сосуществование версий, непрерывный пробник и ловушка автофинализации.
Лицензия: то, что решается до техники
С версии 24.3 self-hosted Core упразднён. Осталась одна редакция — Enterprise, бесплатная для физлиц, студентов, академических исследователей и компаний с годовой выручкой ниже 10 млн долларов. Условия:
| Что | Как | Что будет |
|---|---|---|
| Многоузловой кластер без ключа | 7 дней грейса | Троттлинг до 5 одновременных SQL-транзакций |
| Одноузловой dev-кластер | Ключ не нужен | — |
| Бесплатная лицензия | Телеметрия обязательна | Без отправки телеметрии — троттлинг через 7 дней |
| Бесплатная лицензия | Годовое продление | Троттлинг через 30 дней после истечения |
Как это выглядит на живом кластере:
cluster.organization             (пусто)
enterprise.license               (пусто)
diagnostics.reporting.enabled    true
diagnostics.reporting.interval   1h0m0s
Пустой enterprise.license означает, что кластер живёт в грейсе. Телеметрия включена и на бесплатной лицензии не отключается — кластер ходит наружу, на эндпоинт вендора, раз в час.
Два практических следствия. Первое: ежегодное продление ключа становится эксплуатационной процедурой со своим сроком и своим ответственным; забытое продление даёт троттлинг до пяти транзакций, то есть фактическую остановку. Второе: обязательная исходящая телеметрия — это то, что придётся согласовать с теми, кто отвечает за периметр, и в закрытом контуре она превращается в отдельную задачу.
Троттлинг после грейса мы не измеряли — для этого пришлось бы ждать неделю. Условия выше взяты из документации и проверены на дату написания; перепроверяйте их сами: модель менялась дважды за два года.
Regular против Innovation
У CockroachDB два типа релизов с разной длиной поддержки, и это прямо влияет на планирование.
| Версия | Тип | GA | Поддержка |
|---|---|---|---|
| 26.2, патчи до 26.2.6 | Regular (GA) | 27.04.2026 | maintenance до 27.04.2027 |
| 26.2, патчи 26.2.7+ | LTS | 23.09.2026 | maintenance до 23.09.2027 |
| 26.1 | Innovation | 02.02.2026 | EOL с 02.08.2026 |
| 25.4, патчи до 25.4.9 | Regular (GA) | 03.11.2025 | maintenance до 03.11.2026 |
| 25.4, патчи 25.4.10+ | LTS | — | maintenance до 03.05.2027 |
Версия 26.1 прожила ровно полгода. Взять Innovation-релиз в прод означает обязательное обновление через шесть месяцев — не «когда дойдут руки», а по календарю. Проверяйте тип релиза до, а не после установки.
LTS назначается по патчам, а не по мажорной версии — и это ловушка. Ветка выходит с обычной поддержкой, а статус LTS получает начиная с конкретного патча, после того как покажет стабильность. У 25.4 граница проходит по 25.4.10: всё, что ниже, — обычная GA-поддержка до ноября 2026; всё, что от 25.4.10 и выше, — LTS до мая 2027, то есть на полгода дольше. У 26.2 то же самое случилось уже после выхода ветки: с 26.2.7 она LTS до сентября 2027, а патчи 26.2.0–26.2.6 остались с прежним сроком.
Практическое следствие: номер мажорной версии не говорит о сроке поддержки. «Стоит 25.4» — недостаточная информация; надо смотреть патч. Наш стенд обновляется с v25.4.14, то есть с LTS-патча, на v26.2.5 — патч обычной GA-поддержки, LTS у этой ветки начинается с 26.2.7. Вполне реальный сценарий, когда переход делают не из-за истечения поддержки, а ради новых возможностей; в проде целиться стоит сразу в LTS-патч ветки.
Схема PostgreSQL по одному оператору
Берём схему, написанную как для обычного PostgreSQL, и накатываем по одному оператору, не прерываясь на первой ошибке. Смысл — получить список отличий, а не зелёный лог.
Результат: 8 прошло, 6 отказало.
Что прошло:
| Конструкция | Комментарий |
|---|---|
CREATE EXTENSION IF NOT EXISTS pg_trgm |
принимается, но это заглушка |
SERIAL PRIMARY KEY |
превращается в другое — см. ниже |
GENERATED ALWAYS AS IDENTITY |
работает |
Частичный индекс WHERE total > 1000 |
работает |
CREATE FUNCTION на PL/pgSQL |
работает |
CREATE TRIGGER |
работает |
CREATE MATERIALIZED VIEW |
работает |
CREATE DATABASE |
работает |
Что отказало, с точными текстами:
MONEY:
  ERROR: at or near "not": syntax error: unimplemented: this syntax

XML:
  ERROR: at or near ")": syntax error: unimplemented: this syntax

REFERENCES ... DEFERRABLE INITIALLY DEFERRED:
  ERROR: at or near "deferrable": syntax error

CREATE RULE:
  ERROR: at or near "orders_no_delete": syntax error: unimplemented: this syntax

SELECT pg_advisory_lock(42):
  ERROR: unknown function: pg_advisory_lock()

SELECT pg_size_pretty(pg_database_size('shop')):
  ERROR: unknown function: pg_size_pretty()
Разбор по группам.
Типы MONEY и XML отсутствуют. Лечится заменой на DECIMAL и STRING/JSONB — правка механическая, но требует ревизии приложения.
Отложенные ограничения (DEFERRABLE INITIALLY DEFERRED) не поддерживаются. Если схема опиралась на них для циклических вставок — понадобится другой порядок операций.
CREATE RULE — механизм, который и в PostgreSQL считается устаревшим. Заменяется триггерами, а они работают.
Консультативные блокировки (pg_advisory_lock) отсутствуют, и это самый неприятный пункт списка. Приложения используют их для распределённых мьютексов — «пусть только один воркер делает эту работу». Замены нет: придётся строить блокировку на таблице через SELECT ... FOR UPDATE или выносить координацию наружу.
Административные функции вроде pg_size_pretty отсутствуют, но у CockroachDB свои. Ломается обычно не приложение, а мониторинг и служебные скрипты.
CREATE EXTENSION pg_trgm прошёл — и это легко прочитать неверно. Расширение не устанавливается: оператор принимается заглушкой. Но триграммный поиск в CockroachDB встроен и без него — триграммные индексы, similarity() и соответствующие операторы есть в самом движке (документация). Проверять поэтому надо не факт выполнения CREATE EXTENSION, а то, работают ли запросы и индексы, на которые рассчитывает приложение.
Отдельно оговорюсь: количество отказов зависит от того, что вы кладёте в схему. Наша написана так, чтобы специально воспроизвести известные проблемы. Смысл не в пропорции 8 к 6, а в том, как проверять: по одному оператору, с чтением текста каждой ошибки.
Во что превращается SERIAL
SERIAL принимается, но означает не то, что в PostgreSQL:
CREATE TABLE public.customers (
    id INT8 NOT NULL DEFAULT unique_rowid(),
    email STRING NOT NULL,
    created TIMESTAMPTZ NOT NULL DEFAULT now():::TIMESTAMPTZ,
    CONSTRAINT customers_pkey PRIMARY KEY (id ASC),
    UNIQUE INDEX customers_email_key (email ASC)
);
Вместо последовательности — функция unique_rowid(), выдающая уникальные, но не последовательные значения. Приложение, полагающееся на монотонность идентификаторов («последняя запись — та, у которой id больше»), сломается тихо.
А сама база при создании такой таблицы возражает:
NOTICE: using sequential values in a primary key does not perform as well as
using random UUIDs.
Цену этого «not as well» я пытался измерить в статье про транзакции — и не нашёл. Монотонный INT8, случайный INT8 и UUID шли вровень и на равных условиях, и на растущей таблице; крупного штрафа за монотонность на ненасыщенном стенде не обнаружилось. Горячая точка в размещении строк при этом видна: монотонный ключ кладёт всё в один диапазон из четырёх.
Течи распределённой природы
Три вещи, которых в одноузловом PostgreSQL не было и которые появятся сразу.
Ретраи. Уровень SERIALIZABLE по умолчанию означает, что транзакция может вернуть ошибку 40001 и потребовать полного повтора. В PostgreSQL с READ COMMITTED по умолчанию этот код приложение не видело никогда. Retry-цикл придётся дописать во все места, где транзакция читает и потом пишет прочитанное.
Форма первичного ключа. Монотонный ключ, безобидный в одном узле, сводит запись в один диапазон — а значит, к одному арендатору. Это не «кластер превращается в один узел»: SQL-шлюзы на остальных узлах продолжают разбирать запросы и координировать транзакции. Упирается в один узел KV-путь конкретного диапазона. Станет ли это узким местом — зависит от нагрузки: на нашем стенде не стало, но проверять это надо на своей.
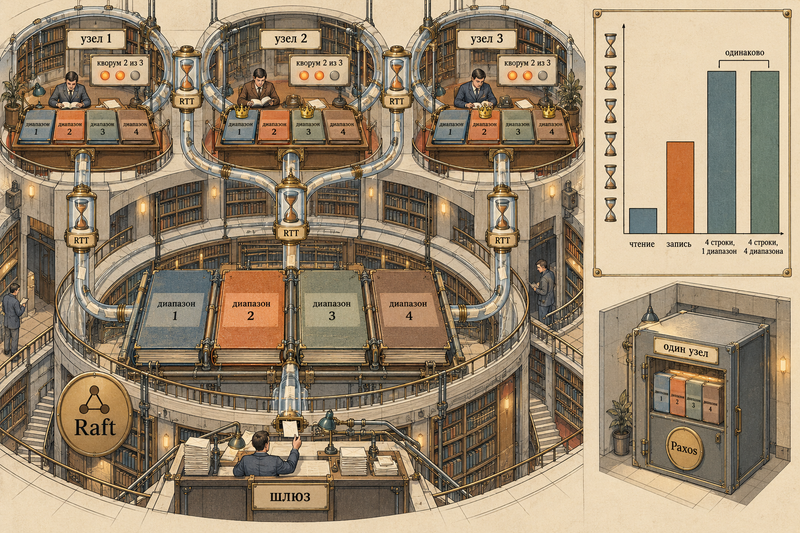
Задержка записи. Запись требует кворума Raft, то есть подтверждения от большинства реплик. Она структурно дороже локальной записи в PostgreSQL, и в SLA это надо закладывать заранее.
JDBC без единой правки
Проверяем совместимость чужим драйвером — тем же org.postgresql, что ходит в PostgreSQL:
драйвер:           PostgreSQL JDBC Driver 42.7.4
сервер назвался:   PostgreSQL 13.0.0
транзакций начато:  200
успешных:           200
не удалось:         0
из них с повтором:  5
всего попыток:      212
Драйвер подключается, метаданные читаются, транзакции идут. Менять в зависимостях нечего.
Обратите внимание на две последние строки. Пять транзакций из двухсот потребовали повтора, всего попыток — 212. Этот retry-цикл написан руками:
private static final String RETRY_SQLSTATE = "40001";

for (int attempt = 1; attempt <= MAX_ATTEMPTS; attempt++) {
    try {
        // …прочитать, посчитать, записать…
        conn.commit();
        return attempt;
    } catch (SQLException e) {
        conn.rollback();
        if (!RETRY_SQLSTATE.equals(e.getSQLState())) {
            throw e;
        }
        // Экспонента + ДЖИТТЕР. Без случайной добавки все конкуренты,
        // отменённые одним конфликтом, проснутся одновременно и
        // воспроизведут его снова.
        long backoff = Math.min(100L, 1L << (attempt - 1));
        Thread.sleep(backoff + ThreadLocalRandom.current().nextLong(0, 5));
    }
}
Ни JDBC, ни пул соединений, ни ORM не сделают этого за вас: с точки зрения драйвера 40001 — обычная ошибка выполнения.
Джиттер здесь не украшение. Голая экспонента синхронизирует конкурентов: все, кого отменил один и тот же конфликт, отсчитают одинаковую паузу, проснутся вместе и создадут его заново. В первой редакции этого примера джиттера не было, хотя в тексте ниже он назван обязательным, — противоречие поймано на ревью.
Отдельно про постановку замера: повторы появились только под параллельной нагрузкой. Однопоточная программа против пустого кластера даёт ноль повторов и ложное впечатление, что на JDBC ретраи не нужны. Поэтому в стенде параллельно бьёт Go-нагрузка в тот же ключ — в этом прогоне она дала 1152 успешные транзакции при 3098 повторах и 287 отвалившихся.
Бэкап и восстановление
pg_dump здесь не работает — бэкап распределённый и делается средствами самой базы:
BACKUP DATABASE bank INTO 'userfile://defaultdb.public.userfiles_root/backup';
SHOW BACKUPS IN 'userfile://defaultdb.public.userfiles_root/backup';
RESTORE TABLE bank.public.accounts_uuid
    FROM LATEST IN 'userfile://defaultdb.public.userfiles_root/backup';
Замер на 5000 строках: бэкап 2 секунды, восстановление 1 секунда, число строк после восстановления совпало с исходным до единицы. Между бэкапом и восстановлением таблица была удалена — и скрипт это проверяет, иначе «восстановление» проверяло бы наличие никуда не девавшихся данных.
userfile кладёт бэкап внутрь самого кластера — для стенда это удобно, для прода бессмысленно: бэкап должен лежать в другом месте, чем данные. В проде это S3-совместимое хранилище.
Обновление кластера
Обновляем v25.4.14 → v26.2.5, по одному узлу, дожидаясь готовности каждого.
после ops1:  ops1 -> v26.2.5   ops2 -> v25.4.14  ops3 -> v25.4.14
после ops2:  ops1 -> v26.2.5   ops2 -> v26.2.5   ops3 -> v25.4.14
после ops3:  ops1 -> v26.2.5   ops2 -> v26.2.5   ops3 -> v26.2.5
53 секунды на подмену всех трёх образов, и кластер всё это время работал с узлами разных версий одновременно.
А теперь про доступность — и здесь придётся сказать неприятное. Проверка «все узлы снова healthy» ничего не доказывает: она смотрит на контейнеры, а не на то, что видел бы клиент. Поэтому сценарий держит непрерывный пробник, который всё время обновления бьёт запросами в кластер:
проб всего: 178 (успешных: 162, неуспешных: 16)
максимальный разрыв между успешными запросами: 11.1 с
проб с явной ошибкой: 16
Одиннадцать секунд без обслуживания и шестнадцать явных ошибок. Никакого «обновление проходит незаметно» тут нет.
Важная оговорка про постановку, без которой число читается неверно. Пробник ходит в ops1 — тот самый узел, который в ходе обновления перезапускается. То есть измерен худший случай: клиент, прибитый к одному адресу без балансировщика, теряет само соединение. Одиннадцать секунд — это в первую очередь про потерю шлюза, а не про недоступность данных: остальные два узла всё это время работали.
Отсюда и разница с разрывом в 1.1–2.2 секунды при отказе арендатора: там клиент ходил через живой узел, и данные к нему приезжали с другой реплики. Сравнивать эти два числа как «обновление дороже отказа» некорректно — у них разная постановка.
Вывод для планирования от этого не мягче. Обновление без простоя — свойство кластера, а не автоматическое свойство вашего приложения: пул соединений должен уметь переподключаться, а retry-логика — переживать разрыв в десяток секунд. С балансировщиком перед кластером разрыв будет меньше; насколько — этот стенд не мерил.
Финализация — то, что легко упустить
Двоичные файлы обновились, но версия кластера меняется отдельно:
SET CLUSTER SETTING version = crdb_internal.node_executable_version();Смысл зазора между «обновили двоичные» и «финализировали» — окно для отката: пока версия кластера прежняя, новые форматы данных не включены, и можно вернуться на старые бинарники. После финализации откат невозможен — остаётся только восстановление из бэкапа.
И вот ловушка, на которую легко наступить, разглядывая SHOW CLUSTER SETTING version после обновления. Автоматическая финализация включена по умолчанию и стартует сразу, как только последний узел вернулся в кластер на новом двоичном файле. Значит, увиденная старая версия — это не окно отката, а промежуточное состояние, которое вот-вот закончится само. Чтобы окно действительно было, автофинализацию надо выключить до обновления:
SET CLUSTER SETTING cluster.auto_upgrade.enabled = false;Эта настройка пришла на смену прежнему cluster.preserve_downgrade_option. Сценарий стенда выставляет её перед обновлением — в первой редакции этого не было, и «старая версия кластера после апгрейда» подавалась как контролируемое окно, хотя было просто ещё не сработавшей автоматикой.
С отключённой автофинализацией окно действительно наступило: после обновления всех трёх узлов SHOW CLUSTER SETTING version показывал 25.4 и не менялся, пока финализацию не выполнили явно — тогда он стал 26.2.
Наблюдаемость
У кластера есть встроенная консоль и Prometheus-совместимый эндпоинт /_status/vars на HTTP-порту каждого узла. Оттуда снимаются в том числе метрики, которыми пользовались все замеры серии:
txn_restarts_writetooold           — ретраи из-за устаревшей записи
txn_restarts_serializable          — конфликты сериализации
txn_restarts_readwithinuncertainty — ретраи по неопределённости времени
Три счётчика ретраев стоит развести на дашборде отдельно: они лечатся по-разному. Рост writetooold — сигнал переписать транзакции, убрав чтение перед записью. Рост readwithinuncertainty — сигнал проверить NTP, потому что этот класс ретраев рождается расхождением часов.
Важная поправка для тех, кто пишет свои скрипты мониторинга. В 26.x доступ к внутренним представлениям закрыт:
ERROR: Access to crdb_internal and system is restricted.Скрипты, читающие crdb_internal напрямую, при обновлении сломаются. Поддерживаемая замена — SHOW CLUSTER RANGES ... WITH DETAILS, SHOW RANGES FROM TABLE ... WITH DETAILS и метрики.
Порядок миграции
Что следует из всего перечисленного, если вы всерьёз собрались переезжать.
Сначала прогон схемы, а не перенос данных. Накатите схему по одному оператору на пустой кластер и соберите список отказов. Это делается за час и определяет объём остальной работы.
Отдельно — инвентаризация ретраев. Найдите в коде все транзакции, которые читают и потом пишут прочитанное. Каждая из них потребует retry-цикла.
Отдельно — ревизия первичных ключей. Монотонный ключ сам по себе не приговор: проверьте под реальной нагрузкой, упирается ли запись в один горячий диапазон и насыщается ли он. Менять ключи стоит там, где это подтвердилось, — и это может оказаться самой дорогой частью переезда.
Отдельно — консультативные блокировки и административные функции. Первые требуют другой архитектуры, вторые ломают мониторинг.
План отката до переключения трафика. Двойная запись с постепенным переключением дороже разового импорта, но оставляет путь назад.
Куда дальше
Остался последний вопрос серии, и он же первый по важности: а нужен ли вам распределённый SQL вообще. Следующая статья — карта выбора: где проходит граница между «хватит PostgreSQL» и «пора», и какие альтернативы стоят рядом с CockroachDB.
Демо и версии
Стенд: digital-cookbook/databases/cockroachdb, сценарий scripts/06-ops.sh. Отдельный кластер стартует на v25.4.14, накатывается PG-схема по одному оператору, запускается JDBC-проверка под параллельной нагрузкой, снимаются бэкап и восстановление, затем кластер обновляется по узлам до v26.2.5 и финализируется. Java запускается в контейнере maven:3-eclipse-temurin-21 — локальный JDK не нужен. Прогон — около двенадцати минут.
Документация
- Licensing FAQs — редакции, грейс, троттлинг, телеметрия.
- Release Support Policy — Regular против Innovation.
- Migrate from PostgreSQL и PostgreSQL Compatibility — официальный список отличий.
- Upgrade a Cluster — порядок и финализация.
- Backup and Restore.
Обсуждение в Telegram
Присоединиться →