
Одноузловой PostgreSQL обслуживает каждое соединение своим процессом, но все они пишут в один общий журнал и координируются через общую разделяемую память. Порядок фиксации задаётся этой единственной точкой сериализации, а видимость чужих изменений — снимком активных транзакций на момент старта. Ни то, ни другое не требует привязки к реальному времени: достаточно внутреннего порядка.
В распределённой системе такой единственной точки нет. Узлы принимают записи независимо, а физические часы у них расходятся — на миллисекунды при хорошем NTP, на секунды при плохом.
Из этого вырастает вся конструкция, разобранная ниже. Google в Spanner решил проблему деньгами: атомные часы и GPS в каждом дата-центре дают строгую границу погрешности, а транзакция явно ждёт, пока эта граница пройдёт. CockroachDB пошёл другим путём — принял допущение об ограниченном расхождении часов и построил на нём гибридные логические часы. Это дешевле, работает на обычном железе и имеет свою цену, которую видно в ошибках приложения.
Все числа сняты с живого трёхузлового кластера v26.2.5. Один из результатов этой статьи — отрицательный, и разбор того, что он значит, а чего не значит, оказался содержательнее самого замера.
В статье
- MVCC поверх KV: почему значение — это не ячейка, а стопка версий с метками времени;
- гибридные логические часы: физическое время, подпёртое логическим счётчиком;
- HLC против TrueTime — что именно покупается спецжелезом;
- окно неопределённости, и почему нулевой результат замера — не доказательство невозможности;
- follower read: отставание ровно 4.2 секунды, и как оно выводится из трёх настроек;
- как доказать, что follower read обслужен репликой, а не арендатором;
- чтение в прошлом: где настоящая граница и почему
gc.ttlseconds— не она.
Версии вместо ячеек
Запись в CockroachDB не затирает предыдущее значение. Она кладёт рядом новую версию с меткой времени, а старые остаются, пока их не соберёт мусорщик. Читающая транзакция получает метку времени и видит срез: для каждого ключа — последнюю версию, чья метка не позже её собственной.
Идея знакома по PostgreSQL, где MVCC устроен концептуально так же. Разница в том, откуда берётся метка времени. В PostgreSQL это внутренний счётчик транзакций, монотонный по построению. В CockroachDB метка привязана к реальному времени — иначе распределённые узлы не смогли бы договориться о порядке. И вот тут начинается интересное.
Гибридные логические часы
Чисто логические часы — те самые, из работы Лэмпорта — дают корректный порядок событий, но не связаны с настоящим временем. По логической метке нельзя спросить «покажи состояние базы час назад»: у логического счётчика нет часа.
Чисто физические часы связаны с реальностью, но между узлами расходятся и могут идти назад при коррекции NTP. Метка, идущая назад, ломает MVCC: транзакция увидит будущее раньше прошлого.
Гибридные логические часы (HLC) складывают оба: метка — это физическое время, подпёртое логическим счётчиком, который не даёт меткам повторяться и идти вспять. Узел, получивший сообщение с меткой из будущего, подтягивает свои часы вперёд. Так метки остаются осмысленными как время и монотонными как счётчик.
HLC против TrueTime: что покупается спецжелезом
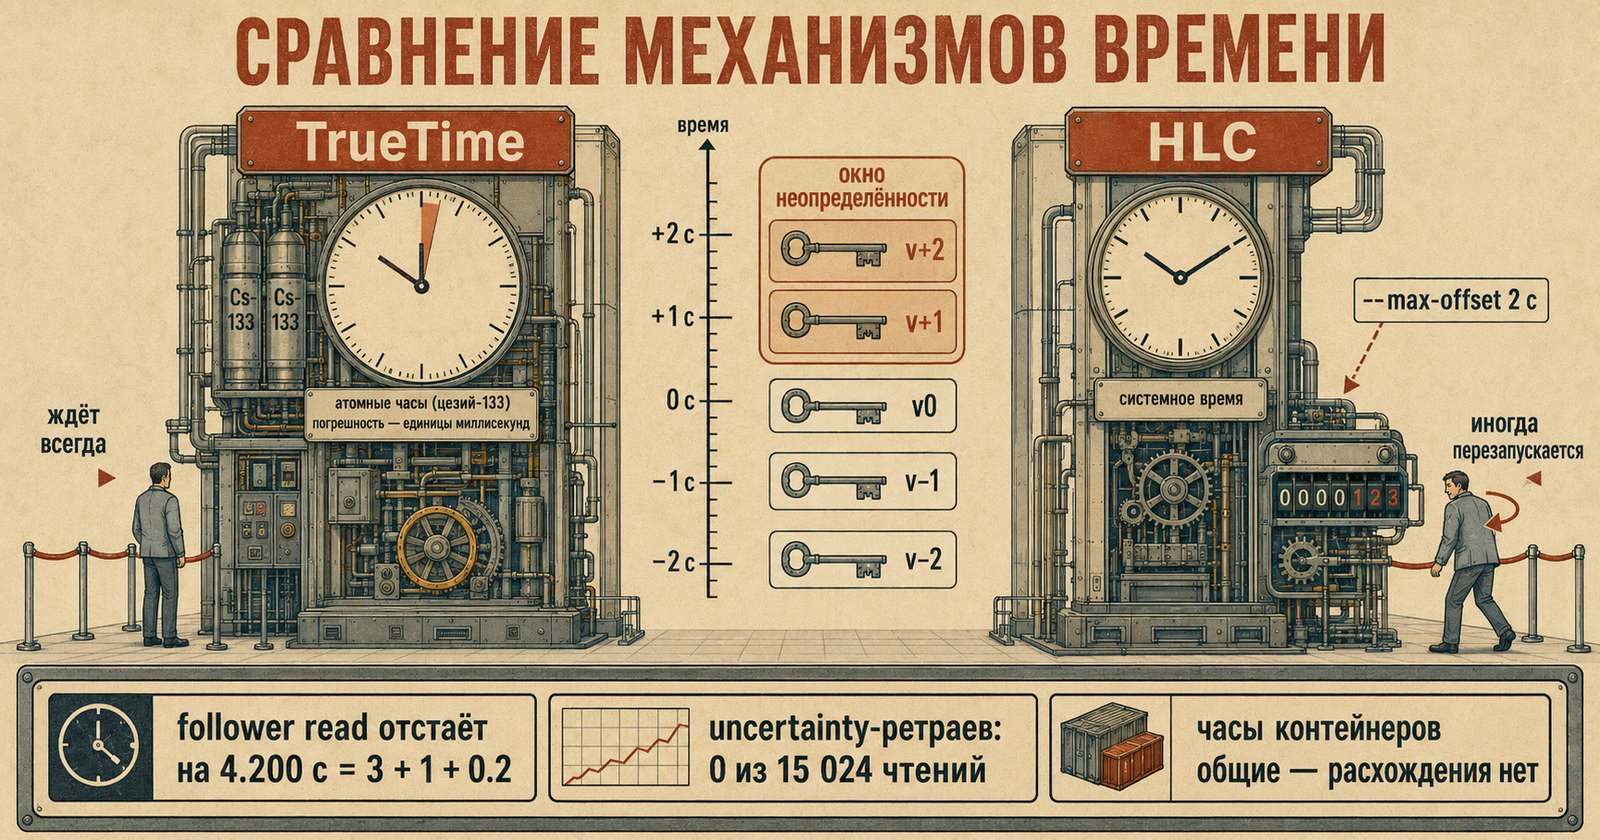
Spanner знает границу погрешности своих часов: API возвращает не «сейчас 12:00:00.000», а «сейчас между 12:00:00.000 и 12:00:00.007». Транзакция коммитится и затем ждёт, пока весь интервал неопределённости не окажется в прошлом. После этого её метка гарантированно упорядочена относительно всех последующих. Цена — атомные часы и приёмники GPS, то есть облако конкретного вендора.
CockroachDB границу не знает, а предполагает. Есть параметр --max-offset, по умолчанию 500 мс: система исходит из того, что часы любых двух узлов расходятся не больше чем на эту величину. Обязанность держать допущение верным ложится на эксплуатацию — NTP-дисциплина здесь не факультатив, а условие корректности.
Разница в том, на кого по умолчанию ложится ожидание. У Spanner это писатель: commit-wait встроен в каждую транзакцию. У CockroachDB обычная транзакция коммитится без такого ожидания, а цена всплывает на стороне читателя — иногда ему приходится перезапуститься, наткнувшись на значение, про которое нельзя решить, раньше оно его или позже.
Сказать, что CockroachDB «не заставляет ждать никого», было бы неверно: для глобальных таблиц и неблокирующих диапазонов он тоже применяет commit-wait — записи фиксируются в будущем, чтобы чтения из любого региона шли без обращения к арендатору. Это осознанный выбор режима, а не умолчание.
Окно неопределённости
Транзакция читает на метке T. Она встречает значение с меткой T + 3 мс. Формально это будущее — значит, значение можно проигнорировать. Но при допустимом расхождении часов в 500 мс метка T + 3 мс могла быть проставлена узлом, чьи часы просто спешат, а само событие произошло раньше нашего чтения. Проигнорировать — значит потерять запись, которая должна была быть видна.
Отсюда правило: значения с метками в интервале (T, T + max_offset] попадают в окно неопределённости, и транзакцию нужно продвинуть на более позднюю метку.
Важная поправка к тому, как это выглядит снаружи. Клиент видит ретрай не всегда: сервер сначала пробует разобраться сам — обновить метку транзакции и перечитать то, что уже прочитано (refresh), — и обращается к приложению только когда без него не обойтись. Поэтому серверные счётчики перезапусков и клиентские ошибки — разные величины, и первое больше второго.
Мы попытались это воспроизвести. Кластер поднят с расширенным окном — --max-offset=2s вместо умолчания в 500 мс, применение подтверждено проверкой аргументов запуска. Писатель непрерывно переписывает один ключ через первый узел, читатель непрерывно читает его через второй:
писатель: ops=2100,  retries=0
читатель: ops=15024, retries=0

txn_restarts_readwithinuncertainty до:    0
txn_restarts_readwithinuncertainty после: 0 (прирост 0)
Пятнадцать тысяч операций чтения через отдельный узел-шлюз — и ни одного ретрая по неопределённости.
Почему ноль — и что из него следует
Ноль в замере обычно означает, что мерили не то. Здесь стоит разобрать по частям: что установлено твёрдо, а что — нет.
Часы на стенде не расходятся. Все узлы — контейнеры на одной машине, а контейнеры делят CLOCK_REALTIME ядра хоста. Расхождение между ними равно нулю по построению, и главный источник попадания в окно неопределённости отсутствует.
Можно ли создать расхождение искусственно? Три способа, и все три закрыты:
Time namespace. Linux умеет виртуализировать часы в пространстве имён (CLONE_NEWTIME), но только монотонные — CLOCK_MONOTONIC и CLOCK_BOOTTIME. Реальное время не виртуализируется, а HLC работает именно с ним.
Подмена системного времени в контейнере. Контейнер делит часы с ядром хоста; менять их означает менять время всей машине.
libfaketime. Классический приём: перехватить обращения к времени через LD_PRELOAD. Проверили прямым опытом в контейнере, а не по памяти:
обычный date:       2026-08-12T06:11:26Z
faketime +10h date: 2026-08-12T16:11:26Z     <- C-программа сдвинулась
обычный Go:         2026-08-12T06:11:26Z
faketime +10h Go:   2026-08-12T06:11:26Z     <- Go-программа не сдвинулась
libfaketime перехватывает вызовы libc, а Go читает часы мимо неё. CockroachDB написан на Go.
Значит, искусственно создать расхождение часов на этом стенде нечем. Это факт про стенд, и он твёрдый.
Чего этот ноль НЕ доказывает
А вот дальше начинается место, где я в первой редакции сделал ровно ту ошибку, против которой писал всю серию: превратил нулевой результат одного сценария в утверждение о невозможности. Там стояло «на одной машине вы их не увидите никогда». Это неверно.
Расхождение часов — главная, но не единственная причина попадания в окно неопределённости. Документация описывает ситуацию шире: две транзакции стартуют на разных узлах-шлюзах и почти одновременно трогают одни и те же данные, причём одна из них пишет. Система не может достоверно упорядочить их — и вопрос упирается не только в разъехавшиеся часы. То есть на идеально синхронных часах такие ретраи возможны.
Почему же их не случилось у нас? Кандидатов несколько, и стенд ни одного не исключил:
- форма нагрузки — читатель бил в один и тот же ключ короткими точечными запросами, а не в широкий скан по свежезаписанным данным;
- observed timestamps — узел запоминает, какое время он уже наблюдал у собеседников, и это сужает окно неопределённости для последующих обращений к тем же узлам;
- размещение аренд — все диапазоны таблицы обслуживал один арендатор, и путь чтения с путём записи расходился меньше, чем мог бы;
- внутренние автоповторы — сервер сначала пробует обновить метку транзакции сам и обращается к клиенту только тогда, когда сделать это без него не может. Часть конфликтов клиент попросту не видит, а наш счётчик считает именно серверные перезапуски.
Корректная формулировка результата такая: в этом сценарии, при этой нагрузке и на синхронных часах, ретраев по неопределённости не возникло. Из этого следует практическое — не рассчитывайте воспроизвести их на одномашинном стенде по заказу, — но не следует, что они невозможны.
Защитной остановки узла при выходе часов за допустимый предел здесь тоже нет: создать расхождение нечем. По документации узел, обнаруживший расхождение больше --max-offset, останавливает сам себя. Это цитата, а не измерение.
Follower read: отставание, выведенное из настроек
Читать всегда у арендатора — значит ходить к нему через полсвета, если он в другом регионе. Альтернатива — follower read: чтение с любой реплики, но не «сейчас», а на слегка отстающей метке, до которой все записи гарантированно закрыты.
Эта метка называется closed timestamp, и её отставание не магическое число, а сумма трёх настроек:
kv.closed_timestamp.target_duration          3s
kv.closed_timestamp.propagation_slack        1s
kv.closed_timestamp.side_transport_interval  200ms
Замеряем фактическое отставание пять раз подряд, SELECT now() - follower_read_timestamp():
4.200
4.200
4.200
4.200
4.200
Ровно 3 + 1 + 0.2. Совпадение до третьего знака, стабильное между замерами: величина не эмпирическая, а вычисляемая.
Роли настроек при этом разные, и путать их не стоит. target_duration задаёт целевое отставание закрытой метки, side_transport_interval — частоту обмена информацией о ней между узлами, propagation_slack — запас на распространение. Хотите читать свежее — уменьшайте target_duration; хотите, чтобы метка распространялась чаще, — это уже side_transport_interval.
Практический смысл: AS OF SYSTEM TIME follower_read_timestamp() даёт согласованное чтение четырёхсекундной давности. Для отчётов, дашбордов и аналитики — обычно всё равно. Для «покажи пользователю то, что он только что сохранил» — категорически нет.
Follower read: проверяем, что читала реплика
Ожидание подсказывает, что чтение с ближайшей реплики быстрее. Проверяем — семь повторов одного и того же запроса в каждом режиме:
с арендатора:  212, 231, 249, 227, 195, 201, 198
follower read: 388, 257, 292, 233, 252, 237, 237
Сначала — главное, чего в первой редакции не было вовсе. Само по себе AS OF SYSTEM TIME follower_read_timestamp() не гарантирует, что запрос обслужит реплика: это лишь метка в прошлом, и ответить на неё может тот же арендатор. Тогда мы сравнивали бы обычное чтение с обычным чтением на старой метке.
Признак фактического обслуживания репликой — счётчик follower_reads_success_count, «reads successfully processed by any replica». Снимаем его вокруг каждого запроса:
повторов, где счётчик вырос: на обычном чтении 0 из 7, на follower 7 из 7
прирост на follower-запрос: +21…+25
Вот теперь можно говорить о follower read: реплика действительно обслуживала запросы, а обычное чтение к ней не обращалось ни разу.
А что с latency? Два прогона дали противоположный порядок:
| Прогон | Обычное, медиана | Follower, медиана |
|---|---|---|
| первый | 212 мс | 252 мс |
| второй | 619 мс | 321 мс |
Во втором прогоне разброс огромен — от 221 мс до 1.7 с на обычном чтении, — потому что машина была занята соседними профилями. Честный вывод: на этом стенде latency двух режимов не различается устойчиво, и утверждать, что follower read медленнее или быстрее, по таким данным нельзя. Первая редакция этой статьи утверждала «медленнее» по одному прогону — это была натяжка.
Что остаётся твёрдым: чтение обслуживается репликой (по счётчику) и отстаёт на 4.2 секунды (по замеру выше).
Настоящая польза follower reads проявляется там, где есть расстояние. Это разбирается в статье про геораспределениеготовится, с 31 октября — где, забегая вперёд, честно сказано, что и там измерить её на одной машине не вышло.
Чтение в прошлом и его настоящая граница
AS OF SYSTEM TIME даёт согласованный снимок на любой момент прошлого — пока версии не собраны мусорщиком. Идём назад, пока запрос не откажет:
-10s:  ЧИТАЕТСЯ
-1m:   ЧИТАЕТСЯ
-10m:  ЧИТАЕТСЯ
-30m:  ЧИТАЕТСЯ
-1h:   ОТКАЗ
Соблазн велик: вот она, граница, полчаса. Соблазну поддаваться нельзя — надо посмотреть на текст ошибки:
ERROR: relation "bulk_rows" does not existЭто не порог сборки мусора. Это возраст таблицы: час назад её ещё не существовало, и снимок того времени честно сообщает, что такого объекта тогда не было. Первая версия замера печатала только «отказ» — и выдала бы возраст стенда за свойство СУБД. Скрипт теперь различает две причины по тексту ошибки и говорит об этом вслух.
Порог сборки мусора — гарантия снизу
Ходовое заблуждение звучит так: gc.ttlseconds = N означает, что глубже N читать нельзя. Проверим на отдельной таблице с порогом, опущенным до тридцати секунд, пятью поколениями версий и ожиданием в пять минут — то есть в десять раз дольше порога:
-30s: ЧИТАЕТСЯ
-1m:  ЧИТАЕТСЯ
-2m:  ЧИТАЕТСЯ
-3m:  ЧИТАЕТСЯ
-5m:  ОТКАЗ — порог GC уехал вперёд
При пороге в полминуты трёхминутный снимок читается. В более раннем прогоне, сразу после понижения порога, читался и пятиминутный.
Сборщик ходит по диапазонам по собственному расписанию и ориентируется на объём мусора, а не на таймер. Двадцать тысяч строк в пяти поколениях — слишком мало, чтобы он торопился.
Практических следствий два, и они противоположны по знаку. Не рассчитывайте, что снимок старше gc.ttlseconds вам откажут: он может прекрасно читаться, и код, полагающийся на отказ, промолчит вместо ошибки. И не рассчитывайте, что он будет доступен: gc.ttlseconds — это гарантия снизу, обещание хранить не меньше, а не обещание не хранить дольше. Если чтение в прошлом нужно как рабочий механизм — поднимайте порог явно, а не надейтесь на инерцию сборщика.
Что это значит на практике
NTP — часть корректности, а не гигиены. Допущение об ограниченном расхождении часов — несущая конструкция. Разъехавшиеся часы дают либо всплеск ретраев, либо остановку узла.
Отсутствие uncertainty-ретраев на стенде ничего не гарантирует. В проверенном сценарии их не возникло, но одномашинное размещение их не исключает: окно неопределённости задаётся настройкой max-offset, а не фактическим расхождением часов, и конфликт чтения с недавней записью внутри этого окна возможен и на синхронных часах. Планируя нагрузочное тестирование, не принимайте их отсутствие на одной машине за свойство нагрузки.
Follower read — инструмент географии и разгрузки, а не ускорения per se. В одном дата-центре выигрыша по latency он не даёт (на нашем стенде разница между режимами тонет в шуме), зато снимает нагрузку с арендатора — этого замера здесь нет.
Чтение в прошлом требует явной настройки. Умолчание — четыре часа, но фактический горизонт плавает в обе стороны.
Куда дальше
Время и версии — фундамент под транзакциями. Следующая статья серии — про то, что происходит, когда за один и тот же ключ дерутся несколько транзакций: write intents, parallel commits и настоящая, измеренная цена уровня SERIALIZABLE.
Демо и версии
Стенд: digital-cookbook/databases/cockroachdb, сценарий scripts/02-time.sh. Профиль перезапускает кластер с оверлеем compose/time.yml (--max-offset=2s), меряет отставание closed timestamp, сравнивает режимы чтения по семь повторов, проходит по глубине AS OF SYSTEM TIME с разбором причин отказа и отдельно проверяет ленивость сборщика. Прогон — около двенадцати минут, из них пять уходит на ожидание сборщика.
Версии: CockroachDB v26.2.5, три узла в docker на одной машине. Опыт с faketime ставился в контейнере almalinux:10 с пакетом libfaketime 0.9.12.
Документация
- Life of a Distributed Transaction и Storage Layer — MVCC и метки времени.
- Follower Reads и AS OF SYSTEM TIME.
- Spanner: Google’s Globally-Distributed Database — первоисточник про TrueTime.
- Logical Physical Clocks and Consistent Snapshots — работа, из которой выросли HLC.

Обсуждение в Telegram
Присоединиться →