
Транзакция в CockroachDB может задеть ключи, лежащие в разных диапазонах на разных узлах. Атомарность при этом обещана полная, а уровень изоляции по умолчанию — SERIALIZABLE, самый строгий из существующих. За такое обещание платят, и статья ровно про счёт.
Счёт состоит из двух частей, и их легко перепутать. Первая — задержка: конкуренты за один ключ выстраиваются в очередь. Вторая — ретраи: транзакцию просят повторить целиком, потому что её снимок устарел. Какая часть счёта придёт вам, зависит не от нагрузки, а от того, как написана транзакция. Ниже — измеренная разница.
Все числа сняты с живого трёхузлового кластера v26.2.5.
В статье
- write intent как «версия со звёздочкой» и transaction record как точка истины;
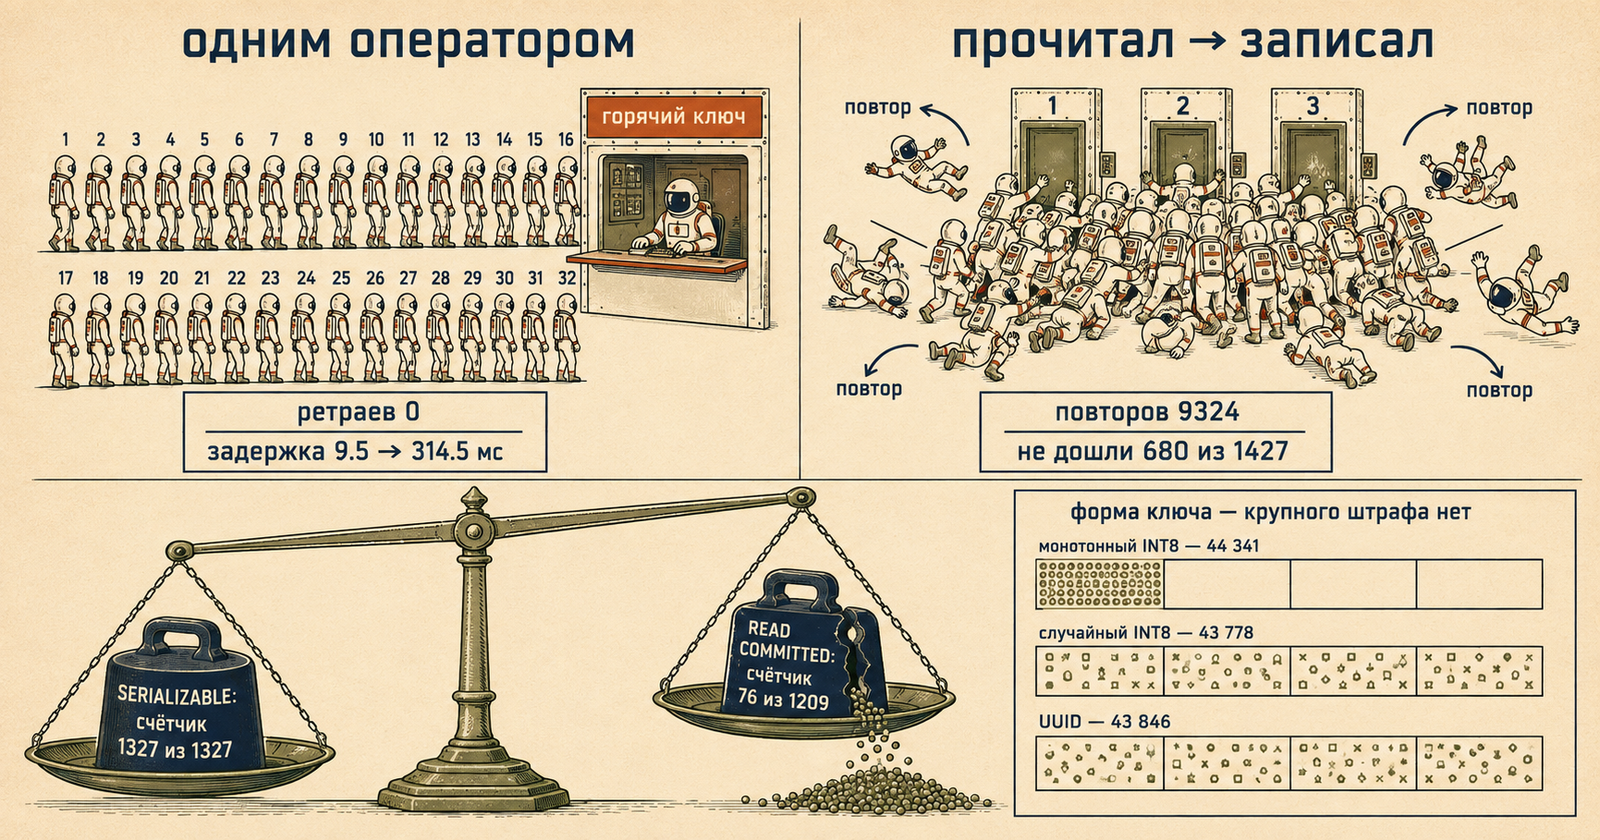
- почему contention на однооператорной записи не дал ни одного ретрая до тридцати двух воркеров;
- откуда ретраи берутся на самом деле: 9324 повтора и 680 отвалившихся транзакций;
- какая у них причина внутри класса конфликтов сериализации и почему это лечится иначе;
- READ COMMITTED в этом эксперименте не дал ни одного ретрая и молча потерял 1133 обновления из 1209;
- расхождение счётчика в бо́льшую сторону — оно совместимо с неоднозначным коммитом, но само по себе его не доказывает;
- форма первичного ключа: три варианта, три неверные постановки замера — и штраф, которого на ненасыщенном стенде не нашлось.
Транзакция поверх нескольких диапазонов
В одноузловом PostgreSQL все транзакции пишут в один общий журнал и координируются через общую разделяемую память. В CockroachDB её записи расходятся по диапазонам, у каждого из которых своя Raft-группа на своих узлах — об этом слое отдельно.
Работает это так. Записывая значение, транзакция кладёт не готовую версию, а write intent — версию, помеченную как незакоммиченную, со ссылкой на запись о транзакции. Отдельно, в своём диапазоне, живёт transaction record — единственная точка истины о том, зафиксирована транзакция или нет.
Чужой читатель, наткнувшийся на intent, не может просто его проигнорировать: он не знает, чем кончится чужая транзакция. Он идёт смотреть transaction record и в зависимости от увиденного ждёт, толкает чужую транзакцию вперёд или откатывает её. Именно этот механизм и порождает то, что приложение видит как «медленно» или как «повторите».
Классический двухфазный коммит требует дождаться подтверждения всех записей, и только потом отметить транзакцию зафиксированной — два последовательных круга по сети. Parallel commits сокращают это: запись о транзакции переводится в состояние, из которого фиксация уже неизбежна, параллельно с самими записями, и клиент получает подтверждение раньше. Если координатор упадёт, статус восстанавливается по intent’ам. Механизм описан в документации; отдельного замера в этой статье нет — вычленить его вклад из общей задержки на нашем стенде не получилось бы честно.
Contention, который не даёт ретраев
Первый эксперимент — самая частая форма конкуренции: все бьют в одну строку одним оператором.
UPDATE hot_counter SET hits = hits + 1 WHERE id = 1;По тридцать секунд на каждую степень параллелизма:
| Воркеров | Успешных транзакций | Ретраев | p50, мс | p99, мс |
|---|---|---|---|---|
| 1 | 2926 | 0 | 9.5 | 19.1 |
| 4 | 3026 | 0 | 37.9 | 55.1 |
| 16 | 2986 | 0 | 156.6 | 211.3 |
| 32 | 3010 | 0 | 314.5 | 393.5 |
Смотрите на два столбца сразу. Пропускная способность упёрлась в потолок и дальше не растёт: 3026, 2986, 3010 при четырёх, шестнадцати и тридцати двух воркерах. Задержка растёт линейно — вчетверо при учетверении воркеров. Ретраев при этом ноль на всех четырёх степенях параллелизма, вплоть до тридцати двух воркеров. Утверждать, что их не будет никогда и ни при какой нагрузке, эти четыре точки не позволяют: проверено то, что проверено.
Так и должно быть: однооператорная запись держит intent на ключе, и конкуренты не отменяются, а ждут своей очереди. Тридцать два воркера, каждый ждёт своей очереди из тридцати двух — отсюда и двести миллисекунд. Никакой транзакции не сообщают, что она должна повториться: её просто обслуживают позже.
Отсюда первый практический вывод. Если ваша нагрузка — это UPDATE ... SET x = x + 1, INSERT, UPSERT по одному оператору, то в этом диапазоне конкуренции роста ретраев вы не увидите. Увидите рост задержки, и лечится он не retry-циклом, а разнесением горячего ключа.
Откуда ретраи берутся на самом деле
Меняем ровно одну вещь: вместо инкремента на стороне сервера транзакция сначала читает значение, а потом записывает прочитанное.
SELECT hits FROM hot_counter WHERE id = 1;
UPDATE hot_counter SET hits = $прочитанное + 1 WHERE id = 1;
Логически результат тот же. Механически — совершенно другой:
| Воркеров | Успешных | Повторов у клиента | Отвалилось | Прирост writetooold на сервере |
p50, мс | p99, мс |
|---|---|---|---|---|---|---|
| 1 | 2559 | 0 | 0 | 0 | 10.2 | 24.0 |
| 4 | 1725 | 1859 | 17 | +1877 | 53.9 | 285.7 |
| 16 | 1255 | 6679 | 244 | +6928 | 176.7 | 756.5 |
| 32 | 747 | 9324 | 680 | +10020 | 288.3 | 947.5 |
«Отвалилось» — транзакции, завершившиеся ошибкой, кроме отдельно учтённых остановленных окончанием прогона. Сюда входят и исчерпавшие предел в десять попыток (девять повторов после первой), и ранние неповторяемые ошибки — генератор их не различает.
При тридцати двух воркерах из 1427 начатых транзакций до конца дошло 747 — чуть больше половины, остальные 680 завершились ошибкой. Пропускная способность просела вчетверо относительно однооператорной формы.
Среднее число повторов на успешную транзакцию отсюда не получить. Поделить все 9324 повтора на 747 успехов нельзя: счётчик общий для трёх исходов — успешных транзакций, отвалившихся и тех, что оборвал конец прогона. Отвалившиеся израсходовали не больше девяти повторов каждая (до 6120 вместе), но часть могла упасть раньше на неповторяемой ошибке, а повторы оборванных генератор тоже складывает в общий счётчик. Вычитанием поэтому получается не оценка для успешных, а смесь исходов. Чтобы её разделить, генератор должен считать повторы по исходу транзакции — этого он не делает.
Последний столбец — прирост серверного счётчика за этот же прогон. Обратите внимание, что он не совпадает с клиентским: 1859 против 1877, 6679 против 6928, 9324 против 10 020. Сервер стабильно насчитывает больше, и это нормально — почему, разбирается сразу ниже.
Разница между двумя таблицами — вся суть темы. Одна и та же бизнес-операция, записанная двумя способами: в первом случае конкуренты стоят в очереди, во втором — дерутся и переигрывают партию заново.
Причина ретраев — не та, о которой принято думать
«Цена SERIALIZABLE» обычно подразумевают в одном узком смысле: две транзакции пересеклись так, что никакой последовательный порядок их не объясняет. Класс конфликтов сериализации на деле шире, и счётчики CockroachDB разводят его по конкретным причинам. У CockroachDB есть счётчики по классам перезапусков, и по ним видно, что происходит на самом деле:
txn.restarts.writetooold            — запись оказалась старше уже существующей версии
txn.restarts.serializable           — собственно конфликт сериализации
txn.restarts.txnpush                — транзакцию вытолкнули вперёд по времени
txn.restarts.txnaborted             — транзакцию откатили
txn.restarts.readwithinuncertainty  — чтение попало в окно неопределённости
Два предостережения, без которых эти счётчики врут.
Первое: они накопительные с момента старта узла. Снять их один раз после прогона и объявить результатом замера нельзя — в них войдут все предыдущие прогоны. Смотреть нужно прирост между снимками до и после.
Второе: серверные перезапуски и клиентские повторы — разные величины, и совпадать они не обязаны. Клиент считает итерации своего retry-цикла; сервер считает перезапуски транзакций, включая внутренние, которые до клиента вовсе не доходят. Расхождение между ними — норма, а не признак ошибки в замере.
С учётом обоих предостережений замер выглядит так: за прогон на тридцати двух воркерах прирост дал только writetooold (+10 020). Остальные четыре счётчика — serializable, txnpush, txnaborted, readwithinuncertainty — не сдвинулись ни на единицу.
Здесь нужна оговорка, без которой вывод получается неверным. RETRY_WRITE_TOO_OLD — тоже конфликт сериализации, официально он относится к тому же классу serialization errors, что и RETRY_SERIALIZABLE. Противопоставлять их как «не конфликт сериализации, а write-too-old» нельзя; в первой редакции этой статьи так и было написано, и это ошибка.
Различаются они конкретной причиной внутри общего класса, и по ней их разводят счётчики. Механика write-too-old такая: транзакция прочитала значение на метке T, пока она думала, кто-то записал новую версию на метке позже T, и её собственная запись оказалась «слишком старой» — писать поверх более свежей версии нельзя. Транзакцию продвигают на более позднюю метку.
Практическая ценность различения в том, что лечится оно иначе. Причина типа RETRY_SERIALIZABLE — повод пересмотреть логику транзакции целиком. RETRY_WRITE_TOO_OLD — повод пересмотреть её форму: сократить окно между чтением и записью, а лучше вовсе избавиться от чтения, переложив вычисление на сервер.
Retry-цикл, который придётся написать
Ретрай в CockroachDB — не аварийная ситуация, а штатный режим. Ошибка приходит с кодом 40001, и ловить нужно именно код: текст сообщения различается для contention и для неопределённости, а SQLSTATE у них общий.
// retryable распознаёт ретраибельные ошибки по SQLSTATE 40001.
func retryable(err error) bool {
	var pgErr *pgconn.PgError
	if errors.As(err, &pgErr) {
		return pgErr.Code == "40001"
	}
	return false
}

for attempt := 1; attempt <= maxRetries; attempt++ {
	err := pgx.BeginTxFunc(ctx, conn, opts, func(tx pgx.Tx) error {
		return statement(ctx, tx, mode, rnd, id)
	})
	if err == nil {
		return attempt, nil
	}
	if !retryable(err) {
		return attempt, err
	}
	// Экспоненциальная пауза с джиттером: без неё воркеры синхронно
	// бьются в один ключ и мерят собственную синхронность.
	back := time.Duration(1<<uint(attempt-1)) * time.Millisecond
	if back > 100*time.Millisecond {
		back = 100 * time.Millisecond
	}
	time.Sleep(back + time.Duration(rnd.Intn(2000))*time.Microsecond)
}
Две детали, которые легко упустить. Первая: воркер держит одно и то же соединение на всю транзакцию, включая повторы, — иначе повтор уйдёт на другое соединение, и вы будете мерить не то, что думаете. Вторая: пауза с джиттером обязательна. Без неё конкуренты синхронизируются и повторяют попытки одновременно, воспроизводя тот же конфликт.
READ COMMITTED: ретраи исчезают, обновления тоже
С версии 24.3 READ COMMITTED в CockroachDB не превью, а рабочий уровень, включённый из коробки:
sql.txn.read_committed_isolation.enabled     true
sql.txn.repeatable_read_isolation.enabled    false
Уровень по умолчанию остался SERIALIZABLE, но переключиться можно одной строкой, и понижения втихую не происходит: BEGIN TRANSACTION ISOLATION LEVEL READ COMMITTED действительно даёт READ COMMITTED.
Соблазн очевиден: если ретраи мешают — смените уровень. Проверяем на той же нагрузке «прочитал — записал», шестнадцать воркеров, тридцать секунд. Счётчик перед каждым замером обнуляется и обязан совпасть с числом подтверждённых транзакций:
| Уровень | Успешных | Повторов | Отвалилось | Счётчик | Расхождение |
|---|---|---|---|---|---|
| SERIALIZABLE | 1327 | 6911 | 236 | 1327 | расхождения нет |
| READ COMMITTED | 1209 | 0 | 0 | 76 | потеряно 1133 |
Ретраи исчезли, а вместе с ними исчезли 94 % инкрементов: 1209 транзакций отчитались об успехе, а счётчик вырос на 76.
Про «ретраев не бывает» стоит сказать точнее: в этом эксперименте их не было ни одного. READ COMMITTED снимает конфликты сериализации, но не делает транзакции неуязвимыми вовсе — под ним возможны, например, аборты по взаимной блокировке, а в отдельных ситуациях и тот же код 40001. Правильная формулировка: он убирает тот класс ретраев, который порождает паттерн «прочитал — записал прочитанное», а не ретраи как явление.
Столбец «отвалилось» тут не менее важен, чем счётчик. Под READ COMMITTED неуспешных транзакций ноль, и список кодов ошибок пуст. Потери происходят полностью молча: приложение не получает ни ошибки, ни предупреждения, ни повода для повтора — оно уверено, что записало 1209 инкрементов.
Это не дефект READ COMMITTED, а его определение. Уровень не обещает, что прочитанное вами значение останется актуальным к моменту записи; он обещает только, что вы не увидите незафиксированного. Паттерн «прочитал — посчитал — записал» под ним теряет обновления по построению, молча и без единой ошибки.
Отсюда честная формулировка выбора. SERIALIZABLE берёт ретраями, но при корректно написанном retry-цикле счёт сходится до единицы. READ COMMITTED ретраев не берёт, но сходимость счёта становится вашей заботой: нужны либо явные блокировки SELECT ... FOR UPDATE, либо атомарные операции на стороне сервера, либо проверка версии при записи. «Просто сменить уровень» — это не оптимизация, а перенос ответственности.
Неоднозначный коммит
В одном из прогонов под SERIALIZABLE счётчик оказался равен 1293 при 1292 транзакциях, подтверждённых клиенту — на единицу больше. В повторном прогоне расхождения не было вовсе: 1327 и 1327.
Соблазн назвать это неоднозначным коммитом велик, и в первой редакции этой статьи я его так и назвал. Правильнее сказать иначе: расхождение в бо́льшую сторону совместимо с неоднозначным коммитом, но само по себе его не доказывает. Ровно тот же результат даёт транзакция, отменённая по истечении времени прогона, и особенности учёта на стороне клиента.
Чтобы отличить одно от другого, нужен код ошибки. У CockroachDB для этого есть SQLSTATE 40003 — statement_completion_unknown: сервер прямо говорит, что судьба транзакции клиенту неизвестна. Генератор нагрузки собирает коды неуспешных транзакций, и неоднозначный коммит объявляется только при наличии 40003; иначе печатается «причина не установлена».
Одна оговорка про сам учёт: транзакции, прерванные по истечении времени прогона, считаются отдельно и в этот список не попадают — иначе в нём оказался бы шум от завершения замера, а не отказы базы.
Само явление при этом реально и от способа его измерения не зависит: между «база зафиксировала» и «клиент узнал» есть зазор, и в нём может оборваться связь. Практический вывод остаётся — операции, которые вы повторяете после ошибки, должны быть идемпотентными. Если повторный запуск «списать 100 рублей» спишет их дважды, однажды это выстрелит.
Чего в стенде нет: управляемой инъекции сбоя — обрыва соединения ровно в момент коммита. Без неё неоднозначный коммит нельзя вызвать по требованию, можно только поймать случайно.
Форма ключа: сначала честный ноль
Ходовой совет — «не берите монотонный первичный ключ» — легко проверить. Первая попытка: две одинаковые таблицы, у одной ключ из unique_rowid(), у другой UUID, одинаковая нагрузка по сорок пять секунд.
Три прогона одного и того же замера дали разное:
| Прогон | Монотонный | UUID | Отношение |
|---|---|---|---|
| первый | 68 697 | 66 869 | 1.03 в пользу монотонного |
| второй | 62 939 | 61 048 | 1.03 в пользу монотонного |
| третий | 41 088 | 69 907 | 1.70 в пользу UUID |
У обеих таблиц во всех трёх прогонах — по одному диапазону.
Вывод отсюда только один, и он методический: этот замер нестабилен и ничего не доказывает. Первые два прогона можно было бы прочитать как «разницы нет», третий — как «UUID быстрее почти вдвое», и обе трактовки были бы натяжкой на одних и тех же трёх точках.
Почему так, замер не отвечает. При одном диапазоне горячий хвост никуда не девается — монотонные вставки по-прежнему бьют в один конец ключевого пространства. Нечего измерить: выигрыш от распределения записи между диапазонами при единственном диапазоне взяться неоткуда. Но внутри одного диапазона у монотонных и случайных ключей всё равно разная локальность записи, и она может давать эффект, который здесь тонет в шуме.
В первой редакции этой статьи стояло категоричное «при одном диапазоне разницы быть не может». Третий прогон это опроверг.
Этот замер оставлен в стенде намеренно. Он ловит распространённую ошибку: нагрузочный тест на маленькой таблице показывает, что с ключом всё в порядке, а прод потом показывает обратное.
Форма ключа: штраф, которого я не нашёл
Самый известный совет про CockroachDB звучит так: не берите монотонный первичный ключ, он создаёт горячий хвост и упирает запись в один узел. Совет разумный, база сама предупреждает о нём при создании таблицы. Проверить его оказалось сложнее, чем кажется, и результат вышел не тот, которого я ждал.
Как пришлось переставить замер
Первая версия этого раздела сообщала о разнице в восемь-девять раз, вторая — в десять-двенадцать. Обе неверны, и обе развалились по одной причине: сравнивались не формы ключа, а нечто вместе с ними.
Смешение первое. «Монотонный» вариант брал значение из серверной последовательности (nextval()), «случайный» — из клиента. Различались место генерации, форма INSERT, число параметров и конкуренция за саму последовательность. Отделить вклад последовательности от вклада порядка ключей тот замер не позволял вовсе — и отдельного эксперимента, который бы это сделал, я не ставил.
Смешение второе. Таблицы не очищались между раундами, поэтому режим, отработавший последним, стартовал на самой большой таблице — а монотонный вариант к тому же копил всё в один диапазон. Падение его пропускной способности от раунда к раунду можно было списать и на форму ключа, и на рост данных.
Исправленная постановка: три варианта, у всех ключ генерируется на клиенте и уходит одним и тем же INSERT с тремя параметрами.
CREATE TABLE acct_mono    (id INT8 PRIMARY KEY, …);  -- атомарный счётчик клиента
CREATE TABLE acct_randint (id INT8 PRIMARY KEY, …);  -- rnd.Int63()
CREATE TABLE acct_rand    (id UUID PRIMARY KEY, …);  -- UUID v4, собран клиентом
Пара «mono против randint» отличается прежде всего порядком ключей, пара «randint против rand» — типом и размером. Слово «изолирует» здесь было бы сильнее правды: mono берёт значение из общего атомарного счётчика, randint — из собственного генератора случайных чисел каждого воркера, rand — из третьего генератора со строковым представлением, и вся эта генерация происходит внутри измеряемой транзакции. Строго говоря, сравниваются три клиентские стратегии целиком, а не одна переменная за раз. Чтобы изолировать её по-настоящему, ключи надо готовить заранее и подавать из массива.
Каждая таблица разрезана на четыре диапазона и очищается перед каждым прогоном, чтобы все стартовали с одинакового состояния.
Результат: крупного штрафа не обнаружено
Три раунда, порядок режимов циклически сдвигается, шестнадцать воркеров, сорок пять секунд:
| Раунд | Монотонный INT8 | Случайный INT8 | UUID |
|---|---|---|---|
| 1 | 60 340 | 54 438 | 60 202 |
| 2 | 43 933 | 43 549 | 44 076 |
| 3 | 44 341 | 43 778 | 43 846 |
Крупного штрафа именно за монотонность не обнаружено. Сказать шире — «крупной разницы между формами ключа нет» — данные не позволяют: в первом раунде разброс достигает 10.8 %, просто он не в ту сторону, о которой предупреждает совет.
Но сказать «знак не держится» было бы неправдой, и в первой редакции этого абзаца я так и написал. Знак держится, только не там, где ожидалось: ниже всех во всех трёх раундах оказывается случайный INT8 — монотонный выше него на 10.8 %, 0.9 % и 1.3 %, UUID выше на 10.6 %, 1.2 % и 0.2 %. А вот между монотонным и UUID знак действительно меняется: +0.2 %, −0.3 %, +1.1 %.
То есть выпадает не монотонный вариант, а контрольный. Отставание маленькое и на трёх раундах причину не установить: это может быть стоимость генератора, случайная раскладка аренд или настоящий небольшой эффект. Ясно одно — это не тот порядок величины, о котором говорит ходовой совет.
Обратите внимание на другое: первый раунд быстрее остальных у всех трёх режимов сразу — 60 340 против 43 933 и 44 341 у монотонного. Причину я не устанавливал, и называть это прогревом было бы неправильно: при прогреве быстрее становятся последующие раунды, а не первый. Это эффект раунда — общий временной дрейф, задевший все три режима одинаково. Ровно поэтому сравнивать между собой можно только числа внутри одного раунда. Предыдущий прогон того же сценария при тех же настройках и на той же машине дал по раундам 65 929 / 65 590 / 67 120. Абсолютные величины отсюда брать нельзя вообще.
Размещение данных при этом ровно такое, как обещает теория:
acct_mono:    60 356       0       0       0
acct_randint: 13 633  13 799  13 580  13 440
acct_rand:    15 046  14 990  15 031  15 145
Монотонный ключ уложил всё в один интервал из четырёх, случайные размазали поровну. Эффект размещения реален и измерен. Просто на этой нагрузке он не превращается в разницу пропускной способности.
И вот здесь проходит граница того, что замер вообще может сказать. Горизонтальный выигрыш случайный ключ даёт только если его диапазоны обслуживают разные арендаторы — иначе записи, разложенные по четырём диапазонам, всё равно приходят на один узел. (Локальные эффекты при этом никуда не деваются: стоимость генерации ключа, его длина, поведение LSM-дерева при последовательной и разбросанной записи проявляются и на одном узле.) А аренды никто не разводил: балансировка по нагрузке работает с интервалом около минуты, прогон длится сорок пять секунд, и нужной раскладки замер не дожидался.
Поэтому формулировать надо так: измерена клиентская пропускная способность при неконтролируемом размещении аренд. Горизонтальное масштабирование форм ключа этим замером не проверено вовсе — для этого аренды пришлось бы развести принудительно и дождаться, пока раскладка устоится. Сценарий теперь печатает арендаторов каждого диапазона до и после каждого прогона, так что состояние хотя бы видно; но проверкой это ещё не является.
При накоплении данных деградации не обнаружено
Второй замер устроен иначе: интервалы идут подряд без очистки, чтобы переменной стал рост таблицы.
Первая его версия гоняла пять интервалов монотонного ключа, потом пять интервалов случайного, и дала внятную картину: монотонный держится ровно, случайный проседает с 67 337 до 48 711. Я едва не написал из этого вывод.
Вывод был бы неверен. Замер не отличал форму ключа от порядка серий: к моменту второй серии кластер отработал уже полчаса, и медленнее могла быть просто вторая половина прогона.
Переделано так: оба режима идут в одном интервале, порядок внутри интервала инвертируется, и серий две — с обратным стартовым режимом.
| Интервал | Серия 1: mono | Серия 1: randint | Серия 2: mono | Серия 2: randint |
|---|---|---|---|---|
| 1 | 44 184 | 44 609 | 45 333 | 43 341 |
| 2 | 45 365 | 44 471 | 45 054 | 43 627 |
| 3 | 44 464 | 44 327 | 44 987 | 43 219 |
| 4 | 44 898 | 43 037 | 43 801 | 43 142 |
| 5 | 44 354 | 43 551 | 44 817 | 43 891 |
Нисходящего тренда нет ни у одного из режимов. К концу первой серии в монотонной таблице 223 345 строк, в случайной — 220 068, а все двадцать чисел укладываются в 5.4 % от минимума (43 037) до максимума (45 365).
И снова аккуратнее с формулировкой. Десять интервалов показывают отсутствие видимого нисходящего тренда — это не то же самое, что доказанное отсутствие деградации вообще: на большем объёме или на другой нагрузке она может и появиться. И отсутствия разницы отсюда тоже не следует: монотонный вариант выше случайного в девяти парах из десяти, а во второй серии — во всех пяти, на 1.5–4.6 %. Отличить здесь стоимость генератора от размещения аренд и от настоящего небольшого эффекта ключа двумя сериями нельзя, а доказать эквивалентность — тем более: для этого нужен заранее заданный порог и заметно больше независимых повторов.
Что показано: на десяти интервалах роста таблицы нисходящего тренда не видно, и крупного штрафа за монотонный ключ в этом сценарии не обнаружено.
То есть предыдущая находка — «случайный ключ теряет четверть на росте» — была артефактом постановки, и её тоже приходится снять. Полезной она оказалась только как напоминание: эффект, измеренный один раз в фиксированном порядке, не отличим от дрейфа.
Что из этого следует, а что нет
Честный вывод узкий: на ненасыщенном стенде при неконтролируемом размещении аренд клиентского штрафа за монотонный ключ не обнаружено. Ни при равных условиях, ни при накоплении данных он не оказался заметно медленнее случайного — а в девяти парах из десяти был на 1.5–4.6 % быстрее, причины чего замер не устанавливает.
Это не то же самое, что «разницы нет». Доказать эквивалентность двумя сериями нельзя: для этого нужен заранее заданный порог и заметно больше независимых повторов. Крупный эффект, к которому отсылает совет, в этом сценарии не наблюдался — вот и всё утверждение. Заодно уточню и сам совет: документация описывает горячую точку монотонного ключа как структурное ограничение — потолком становится производительность одного диапазона — и никакого конкретного размера просадки не обещает. Приписывать ей число было бы моей выдумкой.
Столь же честная оговорка: это не опровержение совета, а указание на режим. Горячий хвост становится узким местом, когда единственный арендатор упирается в потолок. Наша нагрузка до этого потолка не дошла — 44 184 операции за 45 секунд, то есть 982 в секунду на таблицу, три узла на одной машине.
Один аргумент отсюда пришлось убрать, и он поучителен. В черновике я написал, что за время замера монотонная таблица разделилась с четырёх диапазонов до шестнадцати — «то есть разделение растаскивало горячий хвост». Это неверно, и документация говорит прямо противоположное: при последовательном ключе разделение хвост не устраняет, а перемещает. Старые диапазоны отделяются и разъезжаются по узлам, но новые записи всё равно идут в единственный крайний диапазон, и горячая точка едет вместе с ним — от диапазона к диапазону и от узла к узлу. Так что число диапазонов ничего здесь не объясняет.
Штатное средство против такого хвоста — не надежда на разделение, а hash-sharded индексы: они режут хвост на несколько шардов, сохраняя порядок внутри каждого, и записи идут сразу в несколько концов вместо одного. Ими мы не пользовались: раз разницы не нашлось, лечить было нечего.
Практический вывод не переворачивается, но становится точнее. Форма ключа — не та ручка, которую надо крутить первой. Сначала убедитесь, что запись действительно упирается в одного арендатора: посмотрите на распределение аренд и на rebalancing_writespersecond по узлам. Если упирается — монотонный ключ виноват, и лечится это hash-sharded индексом. Если не упирается — смена формы ключа не даст ничего.
И отдельно — про предупреждение самой базы:
NOTICE: using sequential values in a primary key does not perform as well as
using random UUIDs.
В наших замерах разницы в обещанную сторону не обнаружилось: UUID и монотонный INT8 шли вровень и на равных условиях, и на растущей таблице. Предупреждение описывает реальный режим — ограничение горизонтального масштаба одним диапазоном, — просто до этого режима стенд не дотянулся.
Чему этот раздел научил меня самого
Три редакции подряд приписывали наблюдавшуюся разницу неверной причине или неверному масштабу: сначала восьми-девятикратную, потом десяти-двенадцатикратную, потом «случайный ключ теряет четверть на росте». Каждый раз числа были настоящими, и каждый раз замер мерил не то, что я думал:
- монотонный вариант брал ключ из серверной последовательности, случайный — с клиента: вклад последовательности отделить от вклада порядка ключей было нельзя;
- таблицы не очищались между раундами, и режим, шедший последним, работал на самой большой;
- серии интервалов шли подряд, а не вперемешку, и «деградация» оказалась дрейфом второй половины прогона.
Общее у всех трёх — не арифметика, а постановка. Числа не врали ни разу; врало то, чем я их объяснял.
Что делать с этим на практике
Считайте на сервере, а не в приложении. UPDATE ... SET x = x + 1 вместо «прочитал, прибавил, записал» в нашем опыте устранил клиентские ретраи этого паттерна на всех четырёх уровнях параллелизма — общей гарантии это не даёт. Там, где без чтения не обойтись, — SELECT ... FOR UPDATE берёт блокировку сразу, превращая драку в очередь.
Retry-цикл обязателен, и он ваш. Ни pgx, ни JDBC его за вас не напишут. Код 40001, ограниченное число попыток, экспоненциальная пауза с джиттером, одно соединение на все попытки.
Идемпотентность — не роскошь. Неоднозначный коммит случается, и повтор после ошибки должен быть безопасен.
Смена уровня изоляции — это перенос ответственности. READ COMMITTED снял конфликты сериализации в нашем эксперименте — и молча потерял обновления в паттерне «прочитал — записал».
Форму ключа проверяйте, а не выбирайте по совету. Монотонный ключ сводит запись в один диапазон — это измерено и бесспорно. Превратится ли это в потерю пропускной способности, зависит от того, насыщен ли арендатор: у нас не насытился, и штрафа не нашлось. Штатное средство, когда насытится, — hash-sharded индекс.
Не верьте нагрузочному тесту, не посмотрев на число диапазонов и на раскладку аренд. Пока таблица в одном диапазоне, вся нагрузка идёт на одного арендатора. Но и четырёх диапазонов мало: если их аренды не разъехались по узлам, горизонтального эффекта не будет — а балансировка занимает около минуты.
Куда дальше
Мы разобрали, что происходит при конфликте за ключи. Следующая статья — про то, как один SQL-запрос превращается в план, исполняемый на нескольких узлах сразу: DistSQL, статистика и цена полного сканирования в распределённом мире.
Демо и версии
Стенд: digital-cookbook/databases/cockroachdb, сценарий scripts/03-txn.sh. Четыре замера: contention на однооператорной записи, он же на «прочитал — записал», сравнение двух уровней изоляции с точной сверкой счётчика и форма ключа в двух вариантах — на цельной таблице и на разрезанной. Генератор нагрузки — Go с pgx/v5. Полный прогон — около пятнадцати минут.
Версии: CockroachDB v26.2.5, три узла в docker на одной машине под Windows 11 + WSL2. Абсолютные величины зависят от железа; воспроизводимы именно соотношения — 94 % потерянных обновлений под READ COMMITTED и отсутствие разницы между формами ключа на равных условиях.
Документация
- Transaction Layer — write intents, transaction record, parallel commits.
- Transaction Retry Error Reference — классы ретраев и что с каждым делать.
- Read Committed Transactions — что уровень гарантирует, а что нет.
- Selection of Primary Key — рекомендации по форме ключа.
Обсуждение в Telegram
Присоединиться →