
CockroachDB снаружи выглядит как PostgreSQL: тот же wire protocol, тот же SQL, знакомые psql и драйверы. Драйвер pgx подключается без единой правки, JDBC тоже — сервер даже представляется как PostgreSQL 13.0.0. Но внутри это не PostgreSQL вообще: это распределённое отсортированное KV-хранилище, поверх которого натянут SQL-слой.
Разница вылезает не сразу. Она вылезает тогда, когда ходовой совет про монотонный первичный ключ на замере не подтверждается ожидаемым штрафом, когда транзакция возвращает ошибку с требованием повторить её целиком, когда запрос читает 550 000 строк вместо ожидаемых ста семидесяти тысяч. Все эти случаи разбираются дальше в серии, и все они объясняются одним и тем же слоем — тем, что под SQL. С него и начнём.
Эта статья открывает серию «CockroachDB: глубокое погружение». Все числа здесь сняты с живого трёхузлового кластера версии v26.2.5, а не пересказаны по документации.
В статье
- как таблицы, индексы и системные данные живут в одном отсортированном ключевом пространстве;
- почему единицей распределения выбран диапазон, а не строка и не таблица, и почему нижнюю границу его размера нельзя опустить ниже 64 МиБ;
- Raft-группа на каждый диапазон: что реплицируется и как переживается отказ узла;
- арендатор и Raft-лидер: почему с v25.2 это одна и та же реплика;
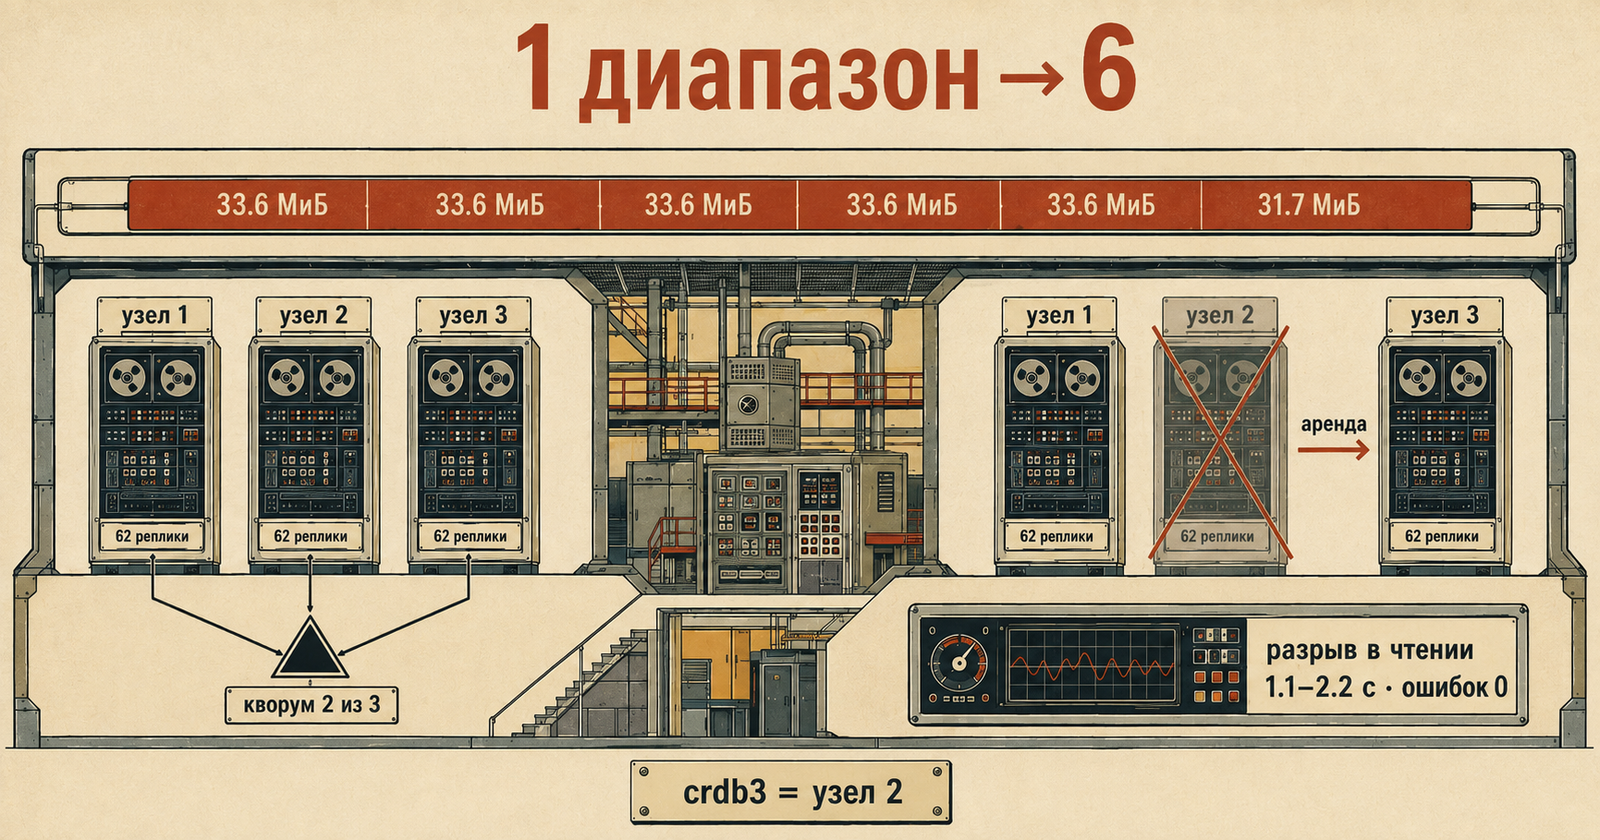
- деление диапазонов вживую: 700 000 строк превращают один диапазон в шесть;
- что видит клиент через живой шлюз, когда гаснет арендатор его данных: разрыв 1.1–2.2 секунды без ошибок;
- чего этот стенд не показывает и почему об этом честнее сказать прямо.
Одно отсортированное ключевое пространство
Первое, что стоит принять: в CockroachDB нет отдельных файлов таблиц, отдельных файлов индексов и отдельного системного каталога где-то сбоку. Есть одно монолитное отсортированное отображение «ключ → значение», и в нём лежит вообще всё: пользовательские строки, вторичные индексы, метаданные схемы, служебные структуры самой СУБД.
Строка таблицы кодируется в ключ, который начинается с идентификатора таблицы и индекса, продолжается значениями первичного ключа и заканчивается идентификатором семейства колонок (column family). По умолчанию все колонки строки попадают в одно семейство, поэтому обычная строка — это одна пара «ключ → значение», а не пара на каждую колонку; разбивать колонки по семействам можно вручную, когда часть из них обновляется отдельно от остальных. Вторичный индекс — такой же диапазон ключей, только с другим префиксом и другим порядком. Именно поэтому «просканировать таблицу» и «просканировать индекс» — с точки зрения нижнего слоя одна и та же операция: пройти по отсортированному отрезку.
Сортировка здесь — не деталь реализации, а несущая конструкция. Из неё следует всё остальное: диапазонный скан дёшев, потому что нужные ключи лежат подряд; соседние по первичному ключу строки физически рядом; и — оборотная сторона — строки с монотонно растущим ключом ложатся в один и тот же конец пространства, создавая горячую точку. К этому вернёмся в статье про транзакции: горячая точка там измерена и видна в размещении строк, но в потерю пропускной способности на нашей нагрузке она не превратилась.
парсер, оптимизатор, DistSQL"] --> TXN["транзакционный слой
MVCC, write intents, HLC"] TXN --> DIST["слой распределения
единое отсортированное KV-пространство"] DIST --> R1["диапазон 163
33.6 МиБ"] DIST --> R2["диапазон 164
33.6 МиБ"] DIST --> RN["… ещё 60 диапазонов"] R1 --> RAFT["Raft-группа диапазона 163
кворум 2 из 3"] RAFT --> N1["реплика на узле 1"] RAFT --> N2["реплика на узле 2
АРЕНДАТОР: чтения и координация записи"] RAFT --> N3["реплика на узле 3"] N2 -.->|"узел погас"| MOVE["аренду перехватывает живая реплика
разрыв в чтении 1.1–2.2 с, ошибок нет"]
flowchart TD
  SQL["SQL-слой
парсер, оптимизатор, DistSQL"] --> TXN["транзакционный слой
MVCC, write intents, HLC"]
  TXN --> DIST["слой распределения
единое отсортированное KV-пространство"]
  DIST --> R1["диапазон 163
33.6 МиБ"]
  DIST --> R2["диапазон 164
33.6 МиБ"]
  DIST --> RN["… ещё 60 диапазонов"]
  R1 --> RAFT["Raft-группа диапазона 163
кворум 2 из 3"]
  RAFT --> N1["реплика на узле 1"]
  RAFT --> N2["реплика на узле 2
АРЕНДАТОР: чтения и координация записи"]
  RAFT --> N3["реплика на узле 3"]
  N2 -.->|"узел погас"| MOVE["аренду перехватывает живая реплика
разрыв в чтении 1.1–2.2 с, ошибок нет"]
Диапазон как единица распределения
Ключевое пространство режется на диапазоны (ranges) — непрерывные отрезки. Диапазон и есть та единица, которую система реплицирует, перемещает между узлами и делит при росте.
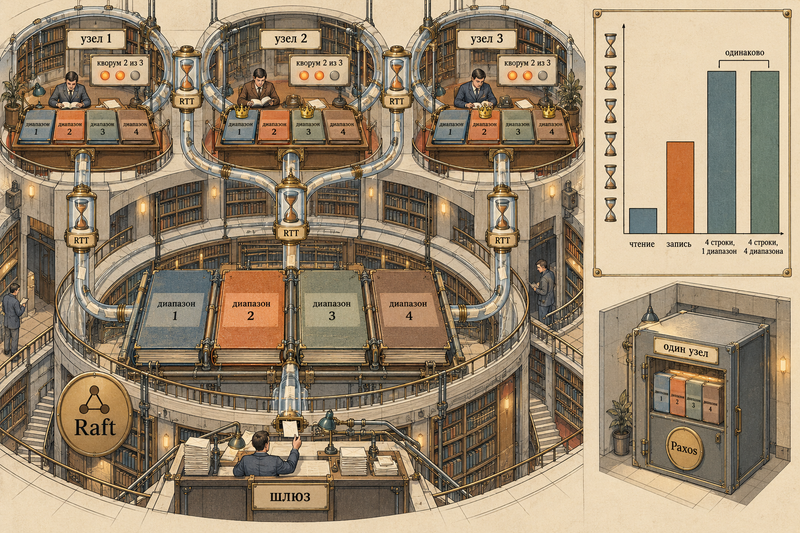
Почему не строка? Координировать репликацию каждой строки отдельно означало бы утонуть в накладных расходах: на каждую строку — своя группа консенсуса, свои сердцебиения, свои метаданные. Почему не таблица целиком? Тогда таблица никогда не смогла бы вырасти больше одного узла, и весь смысл распределённости исчез бы.
Размер диапазона задаётся конфигурацией зоны. Умолчания на v26.2.5:
range_min_bytes = 134217728,   -- 128 МиБ
range_max_bytes = 536870912,   -- 512 МиБ
gc.ttlseconds = 14400,         -- 4 часа
num_replicas = 3
Опустить верхнюю границу ниже 64 МиБ система не даёт — и говорит об этом прямым текстом:
ERROR: could not validate zone config: RangeMaxBytes 8388608 less than minimum allowed 67108864Из этого ограничения легко сделать вывод сильнее, чем оно позволяет. «Меньше 64 МиБ — значит один диапазон» неверно: кроме деления по размеру есть деление по нагрузке. Диапазон становится кандидатом на split, когда превышает kv.range_split.load_qps_threshold (по умолчанию 2500 запросов в секунду), и размер тут ни при чём.
Корректная формулировка такая: по размеру таблица меньше 64 МиБ не разделится. Разделится ли она по нагрузке — зависит от того, набирает ли она соответствующий QPS. В наших коротких замерах на сорока тысячах строк автоматического деления не случилось ни разу, и таблица оставалась в одном диапазоне — но это наблюдение конкретного прогона, а не свойство порога.
И ещё одно уточнение, чтобы не сложилось лишнего. Один диапазон не означает «данные на одном узле»: он по-прежнему реплицирован на три. Единственен только арендатор — а значит, весь KV-путь этой таблицы, чтения и записи на уровне хранилища, приходит на один узел. Остальные узлы при этом не простаивают: SQL-шлюз, через который пришёл запрос, разбирает его и координирует транзакцию у себя. Но судить по такой таблице ни о распределении записи, ни об эффекте формы ключа нельзя.
Raft-группа на каждый диапазон
Каждый диапазон реплицируется своей собственной Raft-группой. Не кластер целиком, не таблица, не узел — именно диапазон. При факторе репликации по умолчанию у диапазона три реплики на трёх разных узлах, и они договариваются между собой независимо от всех остальных диапазонов.
Из этого следует, что на кластере из трёх узлов с шестью десятками диапазонов одновременно работают шесть десятков независимых Raft-групп. Вот распределение на нашем стенде:
node_id  replicas
1        62
2        62
3        62
Шестьдесят два диапазона, у каждого три реплики, три узла — по 62 реплики на узел. Раскладка идеально ровная, и это не совпадение: балансировщик выравнивает именно число реплик и занятое место.
Сам механизм Raft — выборы лидера, репликация журнала, кворум — здесь не разбираю: это отдельная тема, и общий разбор консенсуса живёт в материале «consensus-landscape». Для этой статьи достаточно одного свойства: запись считается зафиксированной, когда её приняло большинство реплик. Из трёх — две. Значит, отказ одного узла из трёх переживается без потери данных и без потери доступности; отказ двух — уже нет.
Арендатор и Raft-лидер: с v25.2 это одна реплика
Вот место, где интуиция, принесённая из PostgreSQL, ломается первый раз — и где легко наткнуться на устаревшее описание.
Арендатор (leaseholder) — реплика, держащая аренду на диапазон. Она принимает чтения и координирует записи, и она единственная может ответить на чтение, не спрашивая остальных: раз аренда у неё, более свежих подтверждённых данных ни у кого нет. Raft-лидер, в свою очередь, отвечает за репликацию журнала.
Исторически это были две независимые роли: система стремилась их совмещать, потому что разнесение добавляет лишний сетевой переход на каждую запись, но расходиться они могли надолго. Многие статьи и доклады описывают именно эту модель.
В актуальных версиях она уже не такая. CockroachDB перешёл на leader leases — они доступны начиная с v25.2, а в v26.2 включены по умолчанию. Документация формулирует жёстко: аренда всегда совмещена с лидерством Raft, за исключением короткого промежутка при передаче аренды. То есть «арендатор не тот же, что лидер» — теперь не штатное состояние, а переходное, длиной в передачу.
Практическое следствие простое, и оно важнее самой смены механики: отказ узла-арендатора сводится к выборам Raft. Сначала механизм живучести замечает, что узел не отвечает, затем проходят выборы нового лидера, и новый лидер берёт аренду. Именно эту последовательность мы и увидим ниже как паузу в чтении.
Распределение аренд, в отличие от реплик, ровным не бывает:
lease_holder  leases
1             26
2             15
3             21
Реплики — 62/62/62, аренды — 26/15/21. Причина в том, что аренда привязана к лидерству, а лидер выбирается по мере надобности: реплика получает и то и другое, когда в диапазон приходит запрос. Дальше аренда за ней и остаётся — но не навсегда: балансировщик периодически перераспределяет и реплики, и аренды, выравнивая нагрузку между узлами. Так что «висит за одним узлом, пока в него не постучат» — верно на коротком интервале, а не как постоянное свойство.
Номер узла не равен номеру в имени контейнера. Идентификаторы раздаются в порядке присоединения к кластеру, и совпадение с именами — чистая случайность. На нашем стенде контейнер crdb3 оказался узлом node_id = 2, а crdb2 — узлом 3. Первая версия эксперимента с отказом гасила crdb3, считая аренды на node_id = 3, то есть на живом узле, — и «доказывала», что аренды никуда не переезжают. Прежде чем что-то гасить, спросите соответствие у кластера: cockroach node status показывает id рядом с адресом.
Деление вживую: один диапазон превращается в шесть
Диапазон, доросший до верхней границы, делится. Проверим.
Берём таблицу с широкой строкой — иначе минимальные 64 МиБ придётся набирать миллионами записей:
CREATE TABLE bulk_rows (id INT8 PRIMARY KEY, payload STRING NOT NULL);
ALTER TABLE bulk_rows CONFIGURE ZONE USING
    range_min_bytes = 33554432, range_max_bytes = 67108864;

-- 700 000 строк по 256 байт, батчами по 50 000
INSERT INTO bulk_rows (id, payload)
SELECT g, repeat('x', 256) FROM generate_series(1, 50000) AS g;
Батчи здесь не украшение: одна транзакция на 700 000 строк упёрлась бы в предел на размер транзакции.
До налива — один диапазон. После налива и минуты ожидания:
range_id  size_mb  lease_holder  replicas
163       33.6     2             {1,2,3}
164       33.6     2             {1,2,3}
165       33.6     2             {1,2,3}
166       33.6     2             {1,2,3}
167       33.6     2             {1,2,3}
168       31.7     2             {1,2,3}
Один диапазон стал шестью. Размер каждого — около 33.6 МиБ, примерно половина заданного предела в 64 МиБ: диапазон делится пополам, и обе половины остаются с запасом до следующего деления.
Минута ожидания в этом эксперименте обязательна. Деление асинхронно, и если посмотреть сразу после последней вставки, увидишь промежуточное состояние. В более раннем прогоне на тех же 700 000 строках диапазонов вышло пять, причём последний дорос до 65.2 МиБ — деление ещё не закончилось. Число диапазонов здесь не константа, а моментальный снимок процесса.
Гасим арендатора
Теперь главное: что видит клиент, когда узел, державший аренду на его данные, исчезает.
Наивная версия этого эксперимента — «погасить узел и посмотреть» — ничего не доказывает: с вероятностью две трети погашенный узел вообще не имел отношения к читаемым данным. Поэтому аренду нужного диапазона сначала переносим на тот узел, который будем гасить:
-- диапазон, содержащий id = 1
ALTER RANGE 163 RELOCATE LEASE TO 2;
Дальше запускаем пробник, который в цикле читает ровно один ключ из этого диапазона, десять секунд снимаем базовую линию, гасим контейнер и наблюдаем ещё минуту. Результат:
проб всего: 268 (успешных: 268, неуспешных: 0)
максимальный разрыв между успешными чтениями: 2.2 с
проб с явной ошибкой: 0
По четырём прогонам разрыв составил 1.1, 1.7, 1.7 и 2.2 секунды. Ни одна проба не вернула ошибку — клиент просто подождал. После восстановления аренда целевого диапазона обнаружилась на живом узле: её перехватила одна из оставшихся реплик, и та же самая пауза — это время, за которое перехват состоялся.
Отсюда практический вывод для таймаутов — с важной оговоркой о том, что именно проверено. Клиент в этом опыте ходил через живой узел-шлюз, а гасили другой узел, державший аренду. В такой постановке отказ выглядит как задержка в единицы секунд, а не как ошибка.
Если же гаснет сам узел-шлюз, к которому прибит клиент, картина другая: соединение рвётся, и приложение получит ошибку — в статье про эксплуатациюготовится, с 2 ноября это видно на обновлении кластера, где пробник ходил именно в перезапускаемый узел. Так что «отказ узла — всегда задержка» было бы обобщением сверх опыта: всё зависит от того, куда подключён клиент.
Чего этот стенд не показывает
Два ограничения, о которых честнее сказать прямо.
Скорость переезда аренд с мёртвого узла измерить не удалось. Счётчик аренд на погашенном узле обнуляется мгновенно — ноль на первом же опросе. Но это не скорость миграции: недоступный узел просто перестаёт фигурировать в выводе SHOW CLUSTER RANGES, и ноль означает отсутствие данных, а не завершённый переезд. Инструмент на этот вопрос не отвечает.
Внутренние представления в 26.x закрыты. Привычный способ заглянуть в потроха больше не работает:
ERROR: Access to crdb_internal and system is restricted.
HINT: These interfaces are unsupported in production. To proceed, set the session
variable allow_unsafe_internals = true (not recommended)
Все замеры пришлось перевести на поддерживаемые SHOW CLUSTER RANGES ... WITH DETAILS, SHOW RANGES FROM TABLE ... WITH DETAILS и метрики с эндпоинта /_status/vars. Если вы наткнётесь на статью или скрипт, читающий crdb_internal напрямую, — он написан до этой версии.
Что из этого следует для схемы
Слой диапазонов — не абстракция, о которой можно не думать. Он протекает в проектные решения, и вот куда именно.
Форма первичного ключа определяет, будет ли у вас распределение вообще. Монотонный ключ отправляет все новые записи в последний диапазон — то есть на одного арендатора, на один узел. Сам CockroachDB предупреждает об этом при создании таблицы с SERIAL:
NOTICE: using sequential values in a primary key does not perform as well as
using random UUIDs.
Насколько «not as well» — измерено в статье про распределённые транзакцииготовится, с 29 октября, и результат вышел неожиданным: крупного штрафа не нашлось. Монотонный INT8, случайный INT8 и UUID шли вровень и на равных условиях, и на растущей таблице. Предупреждение описывает ограничение горизонтального масштаба одним диапазоном — режим, до которого наш ненасыщенный стенд не дотянулся.
Мелкая таблица может не распределиться. По размеру она не разделится, пока не перевалит за 64 МиБ; по нагрузке — может, если наберёт нужный QPS. В наших коротких прогонах не разделилась, и вся нагрузка шла на одного арендатора. Отсюда практическое: нагрузочный тест на маленькой таблице может ничего не сказать о поведении в проде — проверяйте число диапазонов, а не предполагайте его.
Таймауты клиента должны переживать перевыборы. Единицы секунд — нормальная пауза при отказе узла.
Куда дальше
Мы разобрали нижний слой: ключевое пространство, диапазоны, репликацию и аренды. Над ним лежит транзакционный слой, а над ним — SQL. Следующая статья серии — про то, откуда распределённая система берёт согласованное время: гибридные логические часы, окно неопределённости и чтение из прошлого.
Демо и версии
Стенд: digital-cookbook/databases/cockroachdb — трёхузловой кластер в compose, шесть профилей по числу измеряющих статей серии. Сценарий этой статьи — scripts/01-ranges.sh: распределение реплик и аренд, деление диапазонов под наливом, перенос аренды и гашение узла с замером разрыва в обслуживании. Полный прогон — около десяти минут, большая часть уходит на налив 700 000 строк.
Версии: CockroachDB v26.2.5 (сборка от 28.07.2026, Go 1.25.5), Docker 29.6.2, всё на одной машине под Windows 11 + WSL2. Абсолютные величины зависят от железа — смысл имеют соотношения.
Про лицензию. С версии 24.3 self-hosted Core упразднён: осталась одна редакция, бесплатная для физлиц и компаний с выручкой ниже 10 млн долларов, но требующая ключа. Многоузловой кластер без ключа работает 7 дней, дальше троттлится до пяти одновременных транзакций; телеметрия на бесплатной лицензии обязательна. Эфемерный стенд в грейс укладывается, ключ ему не нужен. Подробный разбор — в статье про эксплуатацию.
Документация
- CockroachDB — Architecture Overview, Replication Layer, Distribution Layer.
- Raft — In Search of an Understandable Consensus Algorithm — первоисточник алгоритма.
- Licensing FAQs — действующая лицензионная модель.
Комментарии