Базы данных

Архитектура CockroachDB: ranges, Raft и leaseholder

Архитектура CockroachDB: ranges, Raft и leaseholder

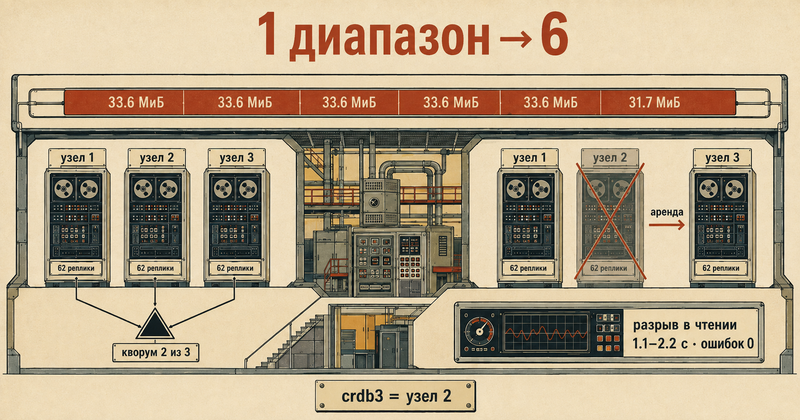
CockroachDB говорит на протоколе PostgreSQL, но внутри устроен иначе: единое отсортированное KV-пространство, нарезанное на диапазоны, у каждого своя Raft-группа и свой арендатор. Разбираем слой за слоем на живом кластере: как 700 000 строк превращают один диапазон в шесть, чем арендатор отличается от Raft-лидера и что видит клиент, когда арендатор его данных внезапно гаснет.
Picodata: наблюдаемость и расширение кластера

Picodata: наблюдаемость и расширение кластера

Две стороны эксплуатации Picodata, проверенные на стенде: встроенный веб-интерфейс и экспорт метрик Prometheus включаются одним флагом, но кластерная в них только часть — остальное принадлежит опрошенному инстансу; и что происходит с кластером при добавлении узлов

TimescaleDB под Zabbix: как перестать вручную бороться с bloat

TimescaleDB под Zabbix: как перестать вручную бороться с bloat

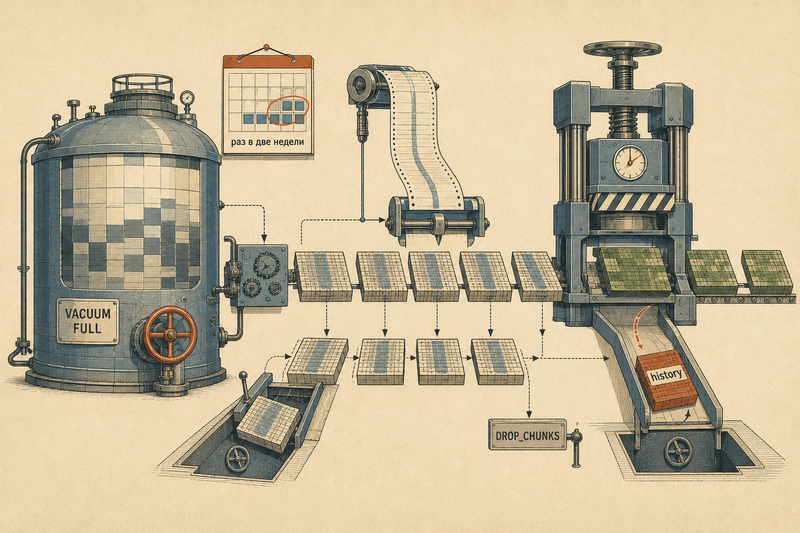
История с прода: мониторинговая БД Zabbix распухала так, что VACUUM FULL приходилось гонять раз в две недели. Перевод history/trends на гипертаблицы TimescaleDB меняет саму модель удаления — построчный DELETE становится drop_chunks, — а нативная компрессия отдаёт место. Плюс неочевидная ловушка: когда порог сжатия совпадает с окном ретеншна, самая большая таблица не сжимается никогда.

Distributed SQL и NewSQL: CockroachDB, YugabyteDB, TiDB и OceanBase

Distributed SQL и NewSQL: CockroachDB, YugabyteDB, TiDB и OceanBase

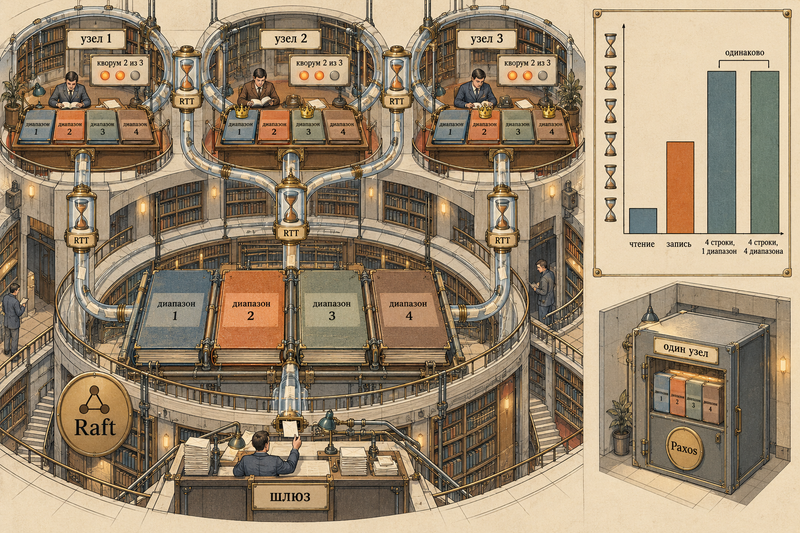
Зачем нужен distributed SQL — горизонтальный масштаб с сохранением SQL и ACID-транзакций, как под капотом работают шардинг и консенсус (Raft у трёх движков, Paxos у OceanBase), чем платим латентностью распределённых транзакций и когда это оправдано против одиночного PostgreSQL с репликами. Все числа сняты на одном стенде: четыре движка, одинаковые замеры, назначенная задержка между узлами

Плагины Picodata на Rust: pike, миграции и blue-green

Плагины Picodata на Rust: pike, миграции и blue-green

Когда SQL не хватает, Picodata расширяют плагином на Rust: сервис внутри кластера со своим жизненным циклом, миграциями схемы и обновлением версий без остановки. Разбор на рабочем плагине — от скелета через pike до blue-green, включая места, где всё это ведёт себя не так, как ожидаешь

Time-series БД: TimescaleDB и VictoriaMetrics

Time-series БД: TimescaleDB и VictoriaMetrics

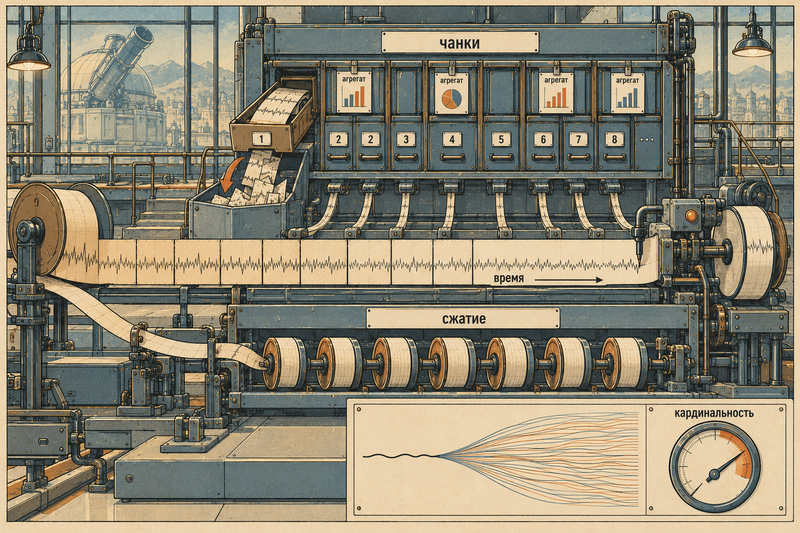
Две школы хранения временных рядов — PostgreSQL с гипертаблицами TimescaleDB и метрические движки Prometheus и VictoriaMetrics — на одном стенде: как continuous aggregate отстаёт от свежих и опоздавших данных и стирает историю после ретеншна, во что обходятся точка и ряд в каждой системе и почему increase() в Prometheus и VictoriaMetrics отвечает по-разному

Распределённый SQL Picodata: планы, motion и цена ключа шардирования

Распределённый SQL Picodata: планы, motion и цена ключа шардирования

Как Picodata исполняет SQL на кластере: план, адресация к бакетам, двухфазная агрегация и motion — перенос данных между узлами. Почему соединение по ключу шардирования обходится без переноса, а обычное на объёме просто не выполняется, и откуда берутся два лимита, в которые упирается всё

SQLite и встраиваемые БД: когда файл бьёт сервер

SQLite и встраиваемые БД: когда файл бьёт сервер

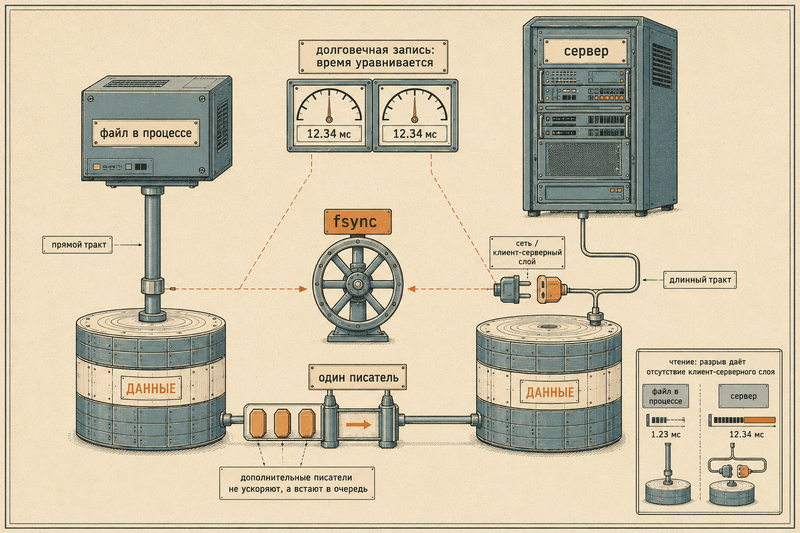
SQLite — не игрушка и не «база для мобилок»: это самая распространённая БД в мире, которая всё чаще стоит в проде на бэкенде. На стенде с тремя плечами — где single-file БД в процессе бьёт отдельный Postgres по латентности (больше порядка величины даже без сети — 12.6–19.1 раза по кругам замера) и простоте деплоя, а где нет: на честной, полностью долговечной записи fsync выравнивает всех, и SQLite на ней слегка проигрывает, а один писатель на файл — жёсткий потолок конкурентной записи. Плюс как не потерять данные (WAL-режим, litestream, репликация) и чем embedded-семейство отличается — SQLite, DuckDB для аналитики, встраиваемые KV (RocksDB/BadgerDB)

Picodata и PostgreSQL: где кончается совместимость

Picodata и PostgreSQL: где кончается совместимость

PostgreSQL-протокол — основной способ работы с Picodata: psql, pgx и psycopg подключаются к ней тем же кодом, что к PostgreSQL. Но совместимость частичная, и граница проходит не там, где ожидаешь. Живая матрица пяти клиентов против 59 SQL-конструкций, поведение pg_dump и мигратора, и почему у Picodata собственный JDBC-драйвер

В работе

Ближайшие материалы, которые продолжают этот раздел.

Базы данных

Redis: где он помогает, где создаёт проблемы и почему "просто поставим кэш" — плохой план

Вводный материал про Redis как класс решений: паттерны, анти-паттерны, ограничения и подходы к надёжности.

Базы данных

PostgreSQL в Docker: что можно, что нельзя и как не потерять данные

Практический baseline для PostgreSQL в контейнерах: volume, backup, healthcheck и границы допустимого production.

Базы данных

ClickHouse в контейнерах: когда это удобно, а когда лучше не надо

Разбор dev- и lab-сценариев для ClickHouse и того, где контейнеризация уже начинает мешать эксплуатации.