
От корутин естественно ждать такого: блокировка внутри обработчика занимает рабочую единицу, а ожидание, ушедшее в базу, не занимает ни одной. Первая половина на стенде подтверждается. Вторая — нет.
Это и есть содержание статьи. Корутины C++20 поверх Asio дают настоящую приостановку — но приостановить можно только то, что умеет сообщить о готовности. Клиент базы, которым ходит этот сервис, сообщать о ней не умеет. Вызов libpqxx внутри корутины блокирует выполняющий её поток: он возвращается только с готовым результатом. Находка от этого не слабее исходного ожидания, а сильнее: она про то, что модель конкурентности в сервисе задаётся не самым верхним слоем, а самым нижним блокирующим.
digital-cookbook/cpp/service-and-postgres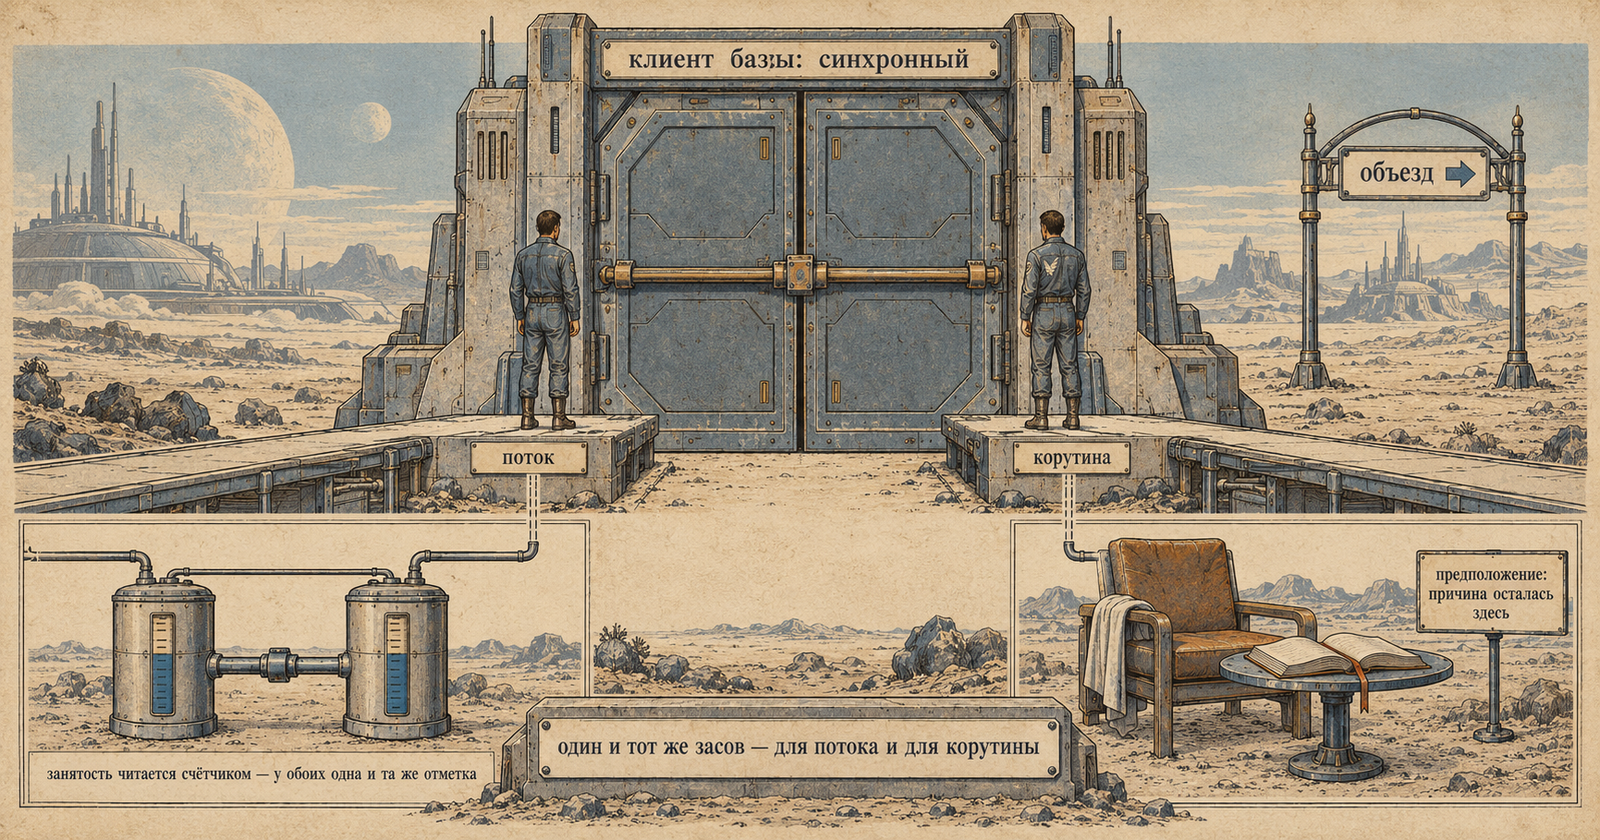
В статье
- какое ожидание от корутин естественно и чем именно оно опровергнуто;
- что читает счётчик обработчиков в полёте и почему занятость снимается счётом, а не временем ответа;
- сколько обработчиков корутинный вариант держит в полёте при одной, двух и трёх рабочих единицах — и где это число разобрано подробно;
- что делает с рабочей единицей ожидание, ушедшее в PostgreSQL, и каким контролем это подтверждено у корутинного варианта;
- где кончается наблюдение и начинается объяснение — на примере синхронного клиента базы, причины правдоподобной, но не замеренной;
- что видно в базе после того, как клиент жёстко оборвал соединение, и почему «отмена не доходит» здесь сказать нельзя;
- как выглядит ожидание, которое поток действительно отпускает;
- чего эти числа не значат.
Стенд: один сервис, три варианта HTTP-слоя
Сервис написан один. Общая логика — маршруты, работа с базой, пул
соединений — лежит в одном файле, и к ней по очереди пристёгиваются три
разных слоя HTTP: Boost.Beast на корутинах C++20, Drogon и Crow. Дальше я
называю их вариантами: слой — единственное, чем они отличаются. Главный
здесь — beast, потому что именно он собран на co_spawn и
awaitable<T>, а два других нужны как фон: без них любое наблюдение о
корутинном варианте было бы наблюдением об одном сервисе.
Маршрутов три. /q уводит ожидание в базу параметризованным
SELECT pg_sleep($1), /block ждёт в самом обработчике и в базу не
ходит вовсе, /healthz отдаёт текущую занятость. Ответ — строка
контракта с именем варианта, исходом и занятостью на момент входа.
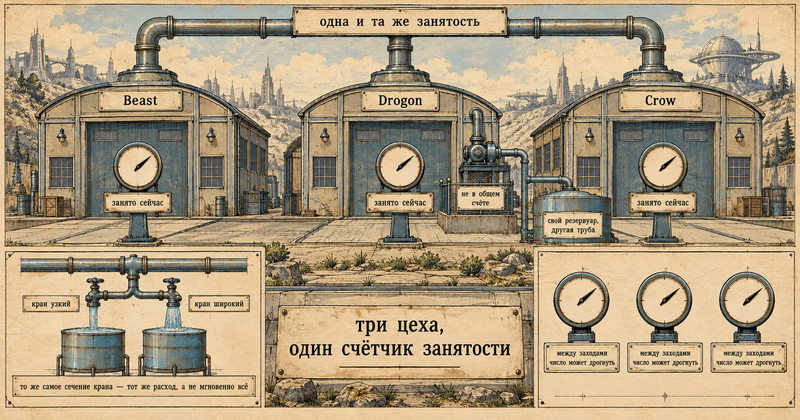
Занятость читается, а не выводится из длительностей ответов: сервис
ведёт счётчик обработчиков в полёте, который растёт на входе, падает на
выходе и кладёт своё значение на момент входа в строку ответа; вторым,
независимым источником служит счёт активных запросов варианта в самой
базе. Маршрут /healthz при этом себя не считает — им занятость
спрашивают, и наблюдатель, попавший в наблюдаемое, завышал бы ответ. У
счётчика три контроля снаружи, и без всех трёх ось объявляется
недействительной; метод разобран подробно в
статье про три HTTP-слоя.
Счёт из базы всегда идёт по application_name варианта — иначе соседние
варианты и служебные сессии смешивались бы в одну кучу молча.
Ожидание, которое замер опроверг
Ожидание. При трёх рабочих единицах блокировка в обработчике занимает ровно три, а ожидание в базе не занимает ни одной, потому что корутина на время запроса к базе приостанавливается и освобождает рабочую единицу. Стенд записывает это до прогона, чтобы результат нельзя было подогнать задним числом.
Чем оно опровергнуто. Две одновременные /q?sleep_ms=1000 показывают
обратное у всех трёх вариантов, включая корутинный; замер ниже это
подтверждает.
Объяснение (не замер): libpqxx синхронен, и приостановить
co_await на нём не на чем — корутина остаётся внутри сетевого вызова
драйвера ровно так же, как остался бы обычный поток. Это правдоподобная
причина, но стенд её не проверял: он снял следствие — прочитанную
занятость, — а не то, что происходит внутри клиента базы.
Ловушка здесь шире одного стенда. Асинхронная модель верхнего слоя не делает асинхронным всё, что под ней: она ровно настолько асинхронна, насколько асинхронен самый нижний вызов в цепочке. Проверяется это не чтением документации слоя, а счётом занятости на своём сервисе.
Что делает с рабочей единицей ожидание в базе
Постановка. Две одновременные пробы /q?sleep_ms=1000, 5 залпов на
настройку, две настройки — 1 рабочая единица и 3. Занятость читается
счётчиком на момент входа, вторым источником идёт счёт активных запросов
варианта в базе.
Результат у корутинного варианта: при 1 рабочей единице занятость читалась единицей в каждом из 5 залпов — двоих в полёте не было ни разу. У crow и drogon при той же настройке вышло то же самое: по всем трём вариантам это 15 залпов, и ни в одном из них при 1 рабочей единице в полёте не было двоих.
Контроль оси у корутинного варианта подтвердился. Чтобы сказать «занята именно рабочая единица, а не сервис целиком», нужно показать, что при 3 рабочих единицах пробы перекрываются: иначе то же наблюдение объяснялось бы тем, что сервис обслуживает по одному запросу в принципе. У beast при 3 рабочих единицах занятость читалась двойкой во всех 5 залпах, то есть пробы перекрылись в каждом; запас контроля — 1, и строка оси помечена публикуемой. У двух других вариантов контроль подтвердился не везде, и их строки помечены непубликуемыми — таблица контроля целиком разобрана в статье про три HTTP-слоя.
Два источника занятости сошлись. Счётчик внутри сервиса и счёт
активных запросов в самой базе дали одно и то же число во всех 10 залпах
маршрута /q у корутинного варианта и во всех 30 по трём вариантам —
ни одного расхождения и ни одного пропущенного момента. Это существенно
именно здесь: утверждение «ожидание в базе рабочую единицу занимает»
опирается на счётчик, живущий внутри предмета, и подтверждено оно
счётом снаружи, из самой PostgreSQL.
Сборка у осей одна. Фикстура этой оси сверяет контрольную сумму собранного бинарника с суммой из фикстуры соседней оси: иначе две фикстуры, снятые с разных сборок, сходились бы согласованно и неверно.
Блокировка в обработчике: где корутинный вариант всё-таки отличается
Для контраста — вторая половина ожидания, которая подтверждается. Маршрут /block ждёт в самом обработчике и в базу не ходит
вовсе.
Постановка. 4 одновременных запроса /block в залпе, 3 залпа на
настройку, ожидание в обработчике — секунда. Публикуется наименьшее по
залпам.
| вариант | 1 рабочая единица | 2 рабочие единицы | 3 рабочие единицы |
|---|---|---|---|
| beast | 1 | 2 | 3 |
| crow | 1 | 1 | 2 |
| drogon | 1 | 2 | 1 (по залпам 2, 1, 3) |
У корутинного варианта число совпало с числом рабочих единиц на всех трёх настройках: 1, 2 и 3. У crow при 3 рабочих единицах в полёте оказалось 2, а у drogon число не воспроизвелось даже внутри одного прогона — по залпам вышло 2, 1 и 3, и публикуется наименьшее наблюдённое. Разбор этой таблицы, её контролей и неустойчивости drogon — в статье про три HTTP-слоя; здесь она нужна ради одного сопоставления.
Сопоставление узкое, и границу у него стоит назвать. При одной рабочей
единице ни ожидание в обработчике, ни ожидание в базе у корутинного
варианта перекрытия не дали: оба маршрута прочитали единицу. Ожидаемой
разницы при одной единице нет. Больше
отсюда не следует: при трёх единицах /block проверялся четырьмя
запросами в залпе, а /q — двумя, и их числа говорят о размере залпа,
а не о разнице маршрутов. Равенство двух маршрутов при нескольких
единицах стенд не проверял.
Обрыв клиента: что видно и что объяснено
Вторая ось статьи — про событие, которое в эксплуатации происходит постоянно: клиент ушёл, не дождавшись ответа. Для корутинного слоя это вопрос с подвохом, потому что у Asio есть собственная отмена, и соблазн объявить её действующей велик.
Постановка. Проба шлёт /q?sleep_ms=3000, через секунду жёстко
закрывает свой сокет — SO_LINGER в ноль, то есть RST, — и ещё через
секунду счёт активных запросов варианта снимается из pg_stat_activity
по имени приложения. Сервис ради этой оси не тронут вовсе: обрыв делает
проба своим сокетом, маршрута «оборвать» у сервиса нет.
| вариант | после ответа (контроль) | до обрыва | после обрыва | через всё окно |
|---|---|---|---|---|
| beast | 0 | 1 | 1 | 0 |
| crow | 0 | 1 | 1 | 0 |
| drogon | 0 | 1 | 1 | 0 |
Запрос переживает уход клиента у всех трёх вариантов, и корутинный не исключение: через секунду после обрыва он всё ещё виден активным. И он кончается сам — через полное окно ожидания активных ноль, то есть речь не о застрявшей навсегда сессии.
Контроль — отдельное измерение, а не оговорка. Клиент, дождавшийся ответа, даёт ноль активных запросов у всех трёх вариантов: счёт видит свои запросы, а не чужие. Плюс три условия, без которых наблюдение наблюдением не является:
- запрос был виден активным до обрыва — иначе «остался активным» читалось бы из пустых данных, а проверка отсутствия на пустых данных проходит всегда;
- байт от сервиса до обрыва пришло 0 — то есть клиент действительно ушёл раньше ответа, а не после него;
- счёт снят по имени приложения именно этого варианта.
Где здесь кончается наблюдение
Это то самое место, где проще всего соскользнуть, и потому его стоит проговорить буквально.
Наблюдение: запрос остался активным в базе после того, как клиент
жёстко закрыл сокет. Это снято счётом из pg_stat_activity, у трёх
вариантов, с контролем и тремя условиями выше.
Объяснение (не замер): обработчик корутинного варианта ждёт ответа базы блокирующим вызовом, и пока этот вызов идёт, за разрывом соединения никто не следит — сокет клиента не читается, а запроса отмены в libpq, по этому объяснению из чтения кода, никто не передаёт. Точнее всего сказать так: в этой реализации RST не остановил запрос в наблюдаемом окне. Остановила бы его реализация, которая следит за разрывом, — стенд не проверял. Снято следствие, механизм не снят.
В стенде это разделение механическое: разбор не печатает слов про libpq и про доходящую отмену без пометки «объяснение, не замер». Проверено подменой: если снять пометку или убрать запрет, проверка краснеет.
Практический вывод от объяснения не зависит и держится на наблюдении. Не рассчитывайте, что клиентский таймаут автоматически отменит запрос в базе: в нашей пробе RST его не остановил. Если нужно, чтобы запрос прекращался, этого придётся добиваться отдельно — средствами самой базы или клиента, — и проверять замером, а не ожиданием.
Как выглядит ожидание, которое поток действительно отпускает
Чтобы находка не читалась как «корутины бесполезны», стоит показать противоположный случай. Стенд его не мерил: это иллюстрация того, где проходит граница, а не замер.
Маршрут /block ждёт так:
// Поток стоит, пока идёт ожидание: корутина здесь ничего не меняет.
std::this_thread::sleep_for(std::chrono::milliseconds(ms));
То же ожидание, отданное циклу событий, выглядит так:
// Корутина приостанавливается, поток уходит обслуживать другие запросы.
asio::steady_timer timer(co_await asio::this_coro::executor);
timer.expires_after(std::chrono::milliseconds(ms));
co_await timer.async_wait(asio::use_awaitable);
Разница не в слове co_await, а в том, что стоит за ним: таймер Asio
умеет сообщить циклу событий, когда ожидание кончится, а sleep_for
не умеет. С базой так же. Чтобы запрос к PostgreSQL отпускал поток,
ждать нужно не вызова, возвращающего готовый результат, а событий на
сокете соединения.
У libpq для этого есть асинхронный интерфейс, но стенд этот путь не проверял, и пример кода здесь сознательно не приведён. Корректная реализация длиннее, чем кажется. Вот что она обязана учесть — это объяснение по документации libpq, а не проверенный рецепт:
- соединение переводится в неблокирующий режим, запрос уходит через
PQsendQueryParams, и результат каждого из этих вызовов проверяется; - пока
PQflushвозвращает единицу, нужно следить за обеими готовностями сокета — к записи и к чтению — и реагировать на любую из них: сервер может не принимать данные, пока клиент не прочитает его сообщения, и тогда при готовности к чтению вызываетсяPQconsumeInput. Ожидание одной только записи может зависнуть; PQflush, вернувший −1, иPQconsumeInput, вернувший ноль, — это отказ, а не конец ожидания;- дальше ждать готовности к чтению, звать
PQconsumeInputи проверятьPQisBusy, пока ответ не соберётся целиком, а у каждого результатаPQgetResultпроверять статус, а не только то, что он пришёл; - сокет из
PQsocketпринадлежит клиентской библиотеке. Обёртка Asio, которой его отдали, закроет его при уничтожении, в том числе при выходе по исключению, — владение нужно явно вернуть, иначе соединение останется с закрытым сокетом.
Ради этого придётся спуститься ниже libpqxx, которой пользуется стенд, — и именно поэтому в стенде этого пути нет.
Чего эти числа не значат
Названо явно, чтобы умолчание не читалось как результат.
Ничего про пропускную способность и задержку. Ни числом, ни словом, ни намёком на направление. Стенд считает обработчиков в полёте и активные запросы в базе — и не мерит ни пропускной способности, ни задержки, которых обычно ждут от статьи про асинхронность.
Что какой-то вариант лучше другого — из этих чисел не следует. Одно и то же число рабочих единиц значит у трёх слоёв разное, и стенд это записывает, а не усредняет.
Почему ожидание в базе занимает рабочую единицу. Синхронность клиента базы — правдоподобное объяснение, но замером оно не является: снято следствие.
Что корутины C++20 или Asio чего-то не умеют. Замерен один сервис с одним клиентом базы, вызываемым одним способом. Про корутины вообще и про Asio вообще отсюда не следует ничего: с клиентом, умеющим сообщать о готовности, числа были бы другими, и такого замера здесь нет.
Что ёмкость drogon воспроизводима. Она плавает и между залпами одного прогона, и между сессиями; публикуется наименьшее наблюдённое, а не типичное и не ожидаемое.
Что контроль оси ожидания в базе подтверждён у всех. У корутинного варианта подтверждён, у двух других — нет, и их строки помечены непубликуемыми.
Что запрос переживает любой уход клиента. Замерен один способ: жёсткое закрытие сокета, то есть RST. Про вежливое закрытие, про таймаут промежуточного узла и про обрыв сети отсюда не следует ничего — это разные события и для сокета, и для слоя HTTP.
Что «через секунду» — граница. Интервалы обрыва и счёта выбраны с запасом внутри трёхсекундного ожидания. Сколько именно запрос живёт после обрыва, стенд не мерил: он мерил, что через секунду тот ещё жив, а к концу окна его уже нет.
Ничего про другую машину. Обе сессии сравнения сняты в одном окружении. Сводка прогонов отвечает на вопрос «держатся ли числа между прогонами», а не «держатся ли они у другого читателя».
Выводы
Ожидание в базе занимает рабочую единицу и у корутин. Естественное ожидание, что не занимает, замер опровергает: при 1 рабочей единице двоих в полёте не было ни в одном из 15 залпов по трём вариантам.
Асинхронность сервиса задаёт самый нижний блокирующий вызов, а не самый верхний слой. Корутинный вариант держит в полёте столько обработчиков, сколько ему дано рабочих единиц, — 1, 2 и 3 на трёх настройках, — но ожидание, ушедшее в базу, единицу у него не освобождает, как не освобождает и у остальных. Объяснение (не замер) здесь одно — синхронный клиент базы, которому нечего сообщить планировщику корутин.
Проверять это нужно счётом, а не доверием к слою. Занятость читается
счётчиком обработчиков в полёте и подтверждается вторым источником — счётом
активных запросов в самой базе; у корутинного варианта два источника
сошлись во всех 10 залпах маршрута /q, а по трём вариантам — во всех 30.
В этой реализации уход клиента запрос не прекратил. У всех трёх вариантов через секунду после жёсткого обрыва запрос виден активным, а к концу окна кончается сам. Сервис за разрывом не следит, пока ждёт базу; что изменила бы реализация, которая следит, стенд не проверял — объяснение помечено объяснением.
Числа выше читаются из фикстур стенда автоматической сверкой, а не из моей памяти о них.
Ссылки
- Стенд: digital-cookbook/cpp/service-and-postgres —
bash bench/run-all.shснимает все оси,python3 scripts/analyze-cancel.pyпечатает разбор оси ухода клиента вместе с контролями. - Соседи по стенду: Drogon, Crow и Boost.Beast: сколько обработчиков держит в полёте один и тот же сервис, PostgreSQL из C++: что видно про libpqxx со стороны базыготовится, с 23 ноября.
- Рамка серии: C++ в 2026: где он по-прежнему незаменим.
- Первоисточники: Boost.Beast, Asio, cppreference: Coroutines, pg_stat_activity.
Обсуждение в Telegram
Присоединиться →