
Rolling-деплой и blue-green красиво выкатывают новый код без простоя — ровно до первой несовместимой миграции. Стоит переименовать колонку или добавить NOT NULL, и во время выкатки старые и новые поды видят разную схему: кто-то падает, кто-то пишет не туда. Проблема zero-downtime не в стратегии деплоя, а в том, что схема БД и код меняются не атомарно и должны какое-то время быть совместимы одновременно. Ключ — expand-contract: разбить изменение на обратно-совместимые шаги. Эта статья — про то, как менять схему под живым трафиком.
Вторая статья серии «CI/CD на практике». Опирается на стратегии деплоя из GitOps/ArgoCD и совместимость из версионирования APIСкоро.
В статье
- Ломается схема, а не деплой
- Окно, где живут две версии кода
- Наивное переименование под нагрузкой
- Expand-contract: то же без единой ошибки
- Как вернуть NOT NULL, не устроив простой
- Двойная запись: код или триггер
- Порядок: аддитивное до кода, деструктивное после
- Блокирующий DDL и как его избегать
- То же на живом кластере: rolling update
- Rollback: одной схемы мало
- Демо и версии
- Документация
Ломается схема, а не деплой
Rolling-деплой и blue-green решают одну задачу: выкатить новый код, не оставив момента, когда не отвечает никто. Они делают это хорошо — и создают ровно ту ситуацию, в которой ломается миграция схемы.
Механика проста. Rolling-деплой заменяет экземпляры приложения по одному: поднял новый, дождался готовности, погасил старый, повторил. Пока это идёт, старые и новые экземпляры работают одновременно — минуты, иногда дольше. И оба ходят в одну базу. Если новый код требует изменённую схему, а старый — прежнюю, то любое несовместимое изменение схемы во время выката бьёт по тем, кто ещё не заменён.
Отсюда контринтуитивный вывод, вокруг которого построена вся статья: zero-downtime ломается не в стратегии деплоя, а в базе. Деплой отработал штатно — по одному, без простоя. Уронила его миграция, выполненная не в том порядке. Дальше — про то, как менять схему так, чтобы под живым трафиком её видели совместимой сразу все версии кода.
Окно, где живут две версии кода
Ключевое понятие — окно сосуществования: промежуток, в течение которого старая и новая версии кода работают параллельно. Оно возникает в любой прогрессивной стратегии выката (подробнее про сами стратегии — в статье про GitOps и ArgoCD) и закрывается только когда последний старый экземпляр погашен.
Внутри этого окна схема БД обязана быть совместима с обеими версиями сразу. Не «сначала старая, потом новая» — одновременно с обеими. Это и есть суть проблемы: код можно выкатывать постепенно, а ALTER TABLE применяется мгновенно и для всех. Схема переключается в один момент, код — растянуто во времени. Совместить эти два темпа и есть задача.
Классический ломающий пример — переименование колонки. amount_cents стало total_cents. Одна короткая команда ALTER TABLE ... RENAME COLUMN — и с этого мгновения весь старый код, обращающийся к amount_cents, обращается к колонке, которой больше нет.
Наивное переименование под нагрузкой
Насколько это ломает — вопрос измеримый. В digital-cookbook/infrastructure/cicd есть стенд: PostgreSQL и загрузчик, который непрерывно читает и пишет через «старую» схему (amount_cents). В середине окна выполняется наивное переименование:
ALTER TABLE orders RENAME COLUMN amount_cents TO total_cents;Результат двух прогонов — сотни ошибок клиента за те секунды, что старый код продолжал работать после команды:
Прогон 1: выполнено=618 ошибок=582
Прогон 2: выполнено=623 ошибок=576
первая ошибка: ERROR: column "amount_cents" does not exist (SQLSTATE 42703)
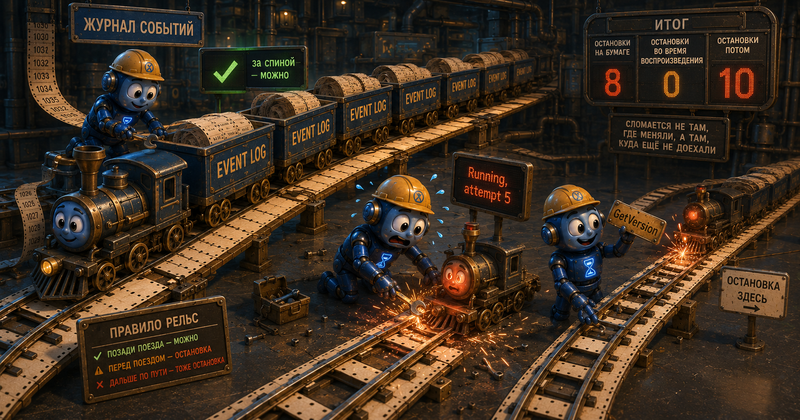
Почти шестьсот запросов упали за несколько секунд под умеренной нагрузкой. Не деплой их уронил — деплой мог ещё даже не начаться. Уронило переименование, применённое, пока старый код жив. Число (576–582) host-зависимо, но качественная картина неизменна: несовместимое изменение схемы под живым старым кодом даёт поток ошибок, а не паузу.
Expand-contract: то же без единой ошибки
Тот же результат — переименование amount_cents в total_cents — достигается без единой ошибки, если разбить его на обратно-совместимые шаги. Приём называется expand-contract: сначала схему расширяют (совместимо со всеми), и только в конце, когда старого кода не осталось, сужают.
Шесть шагов, каждый совместим с работающими в этот момент версиями кода:
снять NOT NULL с amount_cents"] --> B["2. DUAL-WRITE: код пишет обе колонки"] B --> C["3. BACKFILL: перелить старые строки батчами"] C --> D["4. переключить чтение на total_cents"] D --> E["5. CONTRACT: DROP COLUMN amount_cents"] E --> F["6. вернуть NOT NULL на total_cents"]
flowchart TD
    A["1. EXPAND: ADD COLUMN total_cents nullable,
снять NOT NULL с amount_cents"] --> B["2. DUAL-WRITE: код пишет обе колонки"]
    B --> C["3. BACKFILL: перелить старые строки батчами"]
    C --> D["4. переключить чтение на total_cents"]
    D --> E["5. CONTRACT: DROP COLUMN amount_cents"]
    E --> F["6. вернуть NOT NULL на total_cents"]
Шестой шаг легко забыть, и его отсутствие — тихая ловушка. Исходная колонка была NOT NULL, а расширение добавляет nullable: без восстановления инварианта вы получите работающий переход, но ослабленную схему — не то же самое, к чему приводит прямой RENAME. Ниже отдельно разобрано, как вернуть NOT NULL, не устроив тот самый простой, которого мы избегали.
В стенде этот переход прогоняется под той же нагрузкой, что и наивный, но код выкатывается тремя версиями — old (пишет amount_cents), dual (пишет обе колонки), new (пишет total_cents), — каждая поверх работающей предыдущей. Итог:
old:  выполнено≈800 ошибок=0
dual: выполнено≈800 ошибок=0
new:  выполнено≈600 ошибок=0
ИТОГ: ошибок old=0, dual=0, new=0, всего=0
backfill: 6 батчей
итоговая схема: total_cents:NO
Ноль ошибок против почти шестисот. Единственная разница между этим прогоном и наивным — способ перехода: нагрузка, таблица и конечная схема совпадают. Расширяющее изменение (ADD COLUMN ... nullable) совместимо со старым кодом, потому что ничего не отнимает; сужающее (DROP COLUMN) выполняется последним, когда отнимать уже не у кого.
Последняя строка вывода — не украшение, а условие честности сравнения. total_cents:NO означает «колонка есть и она NOT NULL» — ровно то состояние, к которому приводит прямой RENAME. Скрипт проверяет это автоматически и падает при расхождении. В первой редакции стенда такой проверки не было, и демо приходило к nullable-колонке: переход выглядел бесшовным, но результаты двух способов различались, а значит и сравнивать их было нельзя.
Как вернуть NOT NULL, не устроив простой
Прямой путь — ALTER TABLE ... SET NOT NULL — на большой таблице делает ровно то, чего мы избегали: берёт ACCESS EXCLUSIVE и сканирует таблицу целиком, блокируя и чтение, и запись. Безопасная последовательность разносит проверку и блокировку:
-- 1. Ограничение добавляется как NOT VALID: существующие строки не
--    проверяются, но новые уже обязаны ему соответствовать. Скана нет —
--    однако это по-прежнему ALTER TABLE, и блокировку он берёт тяжёлую.
ALTER TABLE orders ADD CONSTRAINT total_cents_not_null
      CHECK (total_cents IS NOT NULL) NOT VALID;

-- 2. Проверка старых строк — под SHARE UPDATE EXCLUSIVE: сканирует таблицу,
--    но НЕ блокирует ни чтение, ни запись. Здесь тяжёлой блокировки нет.
ALTER TABLE orders VALIDATE CONSTRAINT total_cents_not_null;

-- 3. Теперь SET NOT NULL: PostgreSQL 12+ видит валидный CHECK и таблицу
--    заново НЕ сканирует.
ALTER TABLE orders ALTER COLUMN total_cents SET NOT NULL;

-- 4. CHECK больше не нужен — инвариант теперь в самой колонке.
ALTER TABLE orders DROP CONSTRAINT total_cents_not_null;
Три из этих четырёх шагов берут ACCESS EXCLUSIVE — все, кроме VALIDATE. Значит lock_timeout нужен не на одном «самом страшном» шаге, а на каждом из них; иначе защищённым окажется ровно тот шаг, о котором вы подумали, а очередь соберёт соседний. В стенде поэтому нет голых ALTER TABLE — каждый идёт через общую обёртку:
psql_ddl() {
    local sql="$1" attempts="${2:-3}" i out
    for ((i = 1; i <= attempts; i++)); do
        # Присваивание с подстановкой команды ОБЯЗАНО стоять в условном
        # контексте (см. про set -e ниже).
        if out="$(psql_c -v ON_ERROR_STOP=1 -c "SET lock_timeout = '2s'; $sql" 2>&1)"; then
            return 0
        fi
        # Повторять осмысленно ТОЛЬКО таймаут блокировки: синтаксическая ошибка
        # или нарушение ограничения от повтора не исчезнут.
        if printf '%s' "$out" | grep -qiE 'lock timeout|55P03'; then
            echo "  попытка ${i}/${attempts}: блокировка не взята за 2с" >&2
            sleep 2
            continue
        fi
        echo "ОШИБКА PostgreSQL (не таймаут блокировки) — повтор бессмыслен:" >&2
        printf '%s\n' "$out" >&2
        return 1
    done
    return 1   # fail-closed: миграция НЕ состоялась
}
Три детали, которые стоит перенести к себе.
Fail-closed. Если блокировку взять не удалось, шаг считается несостоявшимся и миграция останавливается — молча продолжать нельзя, иначе получите половину применённой последовательности.
Повторять только таймаут блокировки. Синтаксическая ошибка или нарушение ограничения от повтора не исчезнут, и три одинаковых сообщения «блокировка не взята» вместо настоящей причины лишь запутают того, кто будет разбирать инцидент.
И тонкость bash, на которой этот helper у меня сначала не работал. Естественная запись — out="$(psql ...)" отдельной строкой, а следом rc=$? — под set -e не доживает до второй строки: статусом присваивания становится статус команды, и оболочка завершает скрипт прямо на нём. В результате ни классификации ошибки, ни печати $out не происходит — виден только код возврата. Лечится тем, что присваивание ставится в условный контекст (if out="$(...)"; then), где set -e не срабатывает. Ловушка тем коварнее, что проверять её надо именно под set -e: без него код ведёт себя правильно, и дефект не воспроизводится.
Приём тот же по духу, что и весь expand-contract: дорогую работу выполняем под лёгкой блокировкой заранее, а под тяжёлой оставляем операцию без сканирования.
Но «без сканирования» — не то же самое, что «без простоя», и на этом легко обмануться. Третий шаг всё равно берёт ACCESS EXCLUSIVE, а значит: ждёт завершения всех текущих транзакций по таблице — включая долгий отчётный SELECT и забытый сеанс в состоянии «idle in transaction», — и, пока ждёт сам, копит за собой очередь новых запросов, которые не могут взять даже совместимую блокировку. То есть отсутствие скана убирает предсказуемо долгую работу под блокировкой, но не гарантирует, что блокировка возьмётся быстро. PostgreSQL обещает первое и не обещает второго, и стенд время удержания не измерял.
Отсюда практика для боевой базы: ставить lock_timeout в единицы секунд и повторять попытку, а не ждать бесконечно. Тогда неудачная попытка стоит секунды и не создаёт очередь, а перед повтором есть смысл посмотреть pg_stat_activity на предмет долгих транзакций. В стенде это ветка страховки (он однопользовательский), в проде — основной режим работы.
Двойная запись: код или триггер
Шаг 2 — двойная запись — можно сделать двумя способами, и выбор между ними стоит сделать осознанно.
Способ первый: код. Между «только старая схема» и «только новая» выкатывается промежуточная версия приложения, которая пишет обе колонки:
INSERT INTO orders (customer, amount_cents, total_cents) VALUES ($1, $2, $2)Способ второй: триггер БД. BEFORE INSERT OR UPDATE, который синхронизирует колонки, — и код трогать не нужно вовсе.
Частая форма такого триггера — «заполнить пустую колонку из заполненной» — годится только для вставок, где задана одна колонка. При UPDATE обе колонки уже заполнены, и правило ничего не делает: строка 100/100, старая версия приложения пишет amount_cents = 200, total_cents остаётся 100, и новая версия читает устаревшее значение. Поэтому обновление разбирают по тому, какую колонку изменил запрос, а расхождение обеих — и при обновлении, и при вставке — считают ошибкой, а не выбирают победителя молча:
CREATE OR REPLACE FUNCTION sync_amount_total() RETURNS trigger AS $fn$
BEGIN
  IF TG_OP = 'INSERT' THEN
    IF NEW.total_cents IS NULL THEN
      NEW.total_cents := NEW.amount_cents;
    ELSIF NEW.amount_cents IS NULL THEN
      NEW.amount_cents := NEW.total_cents;
    ELSIF NEW.amount_cents <> NEW.total_cents THEN
      RAISE EXCEPTION 'двойная запись: при вставке колонки расходятся';
    END IF;
  ELSIF NEW.amount_cents IS DISTINCT FROM OLD.amount_cents
        AND NEW.total_cents IS NOT DISTINCT FROM OLD.total_cents THEN
    NEW.total_cents := NEW.amount_cents;      -- писал старый код
  ELSIF NEW.total_cents IS DISTINCT FROM OLD.total_cents
        AND NEW.amount_cents IS NOT DISTINCT FROM OLD.amount_cents THEN
    NEW.amount_cents := NEW.total_cents;      -- писал новый код
  ELSIF NEW.amount_cents IS DISTINCT FROM NEW.total_cents THEN
    RAISE EXCEPTION 'двойная запись: обе колонки изменены и расходятся';
  END IF;
  RETURN NEW;
END; $fn$ LANGUAGE plpgsql;

CREATE TRIGGER trg_sync BEFORE INSERT OR UPDATE ON orders
  FOR EACH ROW EXECUTE FUNCTION sync_amount_total();
Стенд прогоняет одни и те же обновления на обеих функциях — наивной и этой:
$ ./scripts/trigger-update-demo.sh
=== наивная функция (только IS NULL) ===
  ok    INSERT старым кодом: 100/100
  UPDATE старым кодом, amount_cents = 200: 200/100
  ok    наивная функция показывает расхождение: 200/100

=== рекомендуемая функция (sql/sync-trigger.sql) ===
  ok    INSERT старым кодом: 100/100
  ok    UPDATE старым кодом, amount_cents = 200: 200/200
  ok    UPDATE новым кодом, total_cents = 300: 300/300
  ok    UPDATE обеих колонок одним значением: 400/400
  ok    UPDATE обеих колонок разными значениями: отвергнут
  ok    строка после отвергнутого UPDATE: 400/400
  ok    INSERT новым кодом (только total_cents): 700/700
  ok    INSERT обеих колонок одним значением: 800/800
  ok    INSERT обеих колонок разными значениями: отвергнут
  ok    строк 'conflict' после отвергнутого INSERT: 0
Приоритета у колонок здесь нет: побеждает та, которую запрос изменил. Если ваш переход допускает запись обеих колонок одним запросом с разными значениями, правило разрешения конфликта придётся выбрать явно — но выбрать, а не получить случайно.
Про триггер ходит правдоподобное возражение: «он же создаётся под работающими соединениями, а те подхватят его не сразу — часть записей проскочит мимо». Звучит убедительно и неверно. PostgreSQL инвалидирует кэш системного каталога для всех сессий: после COMMIT команды CREATE TRIGGER применимый row-level триггер срабатывает для каждой следующей изменяемой строки независимо от того, когда открыто соединение.
В стенде это проверяется прямым замером. Триггер создаётся на 2-й секунде шестисекундной нагрузки, под уже открытыми соединениями пула.
Тут важно, как именно проводится граница — этот замер пришлось переделывать дважды, и оба раза причина была одна: граница определялась неточно.
Сначала я делил вставки по метке clock_timestamp(), снятой той же командой, что создаёт триггер. Это не момент коммита: оператор выполняется внутри транзакции, а коммит происходит после него. Потом — по max(id), и это тоже не строго: значения последовательности выдаются вне MVCC (nextval не ждёт коммита и не откатывается), а SELECT max(id) видит только закоммиченные строки. Строка могла получить идентификатор до коммита DDL, а стать видимой после — и попасть не в ту половину.
Надёжный барьер здесь не в данных, а в порядке выполнения программы. Отдельный probe держит восемь соединений, у каждого своё, и работает в две фазы:
- фаза A — воркеры пишут под старой схемой; в это время выполняется
CREATE TRIGGER; - барьер — probe ждёт сигнала, и скрипт подаёт его только после того, как команда
CREATE TRIGGERвернула управление, то есть после коммита; - фаза B — те же самые соединения делают фиксированное число вставок.
$ ./scripts/trigger-timing-demo.sh
# (сведено к итогу по фазам)
пул открыт: 8 соединений
фаза A (до барьера):    всего=3484  из них total_cents IS NULL=3460
фаза B (после барьера): всего=200  из них total_cents IS NULL=0
В фазе B мимо триггера не прошла ни одна вставка — при том, что писали их восемь соединений, открытых до создания триггера, и писали конкурентно.
Обратите внимание на фазу A: из 3484 строк двадцать четыре уже заполнены. Это вставки, попавшие в промежуток между коммитом и снятием барьера, — прямое свидетельство, что триггер начал применяться сразу после коммита, ещё до того, как probe перешёл во вторую фазу.
Заодно видно, откуда берётся правдоподобная ошибка. Наивный замер — посчитать все NULL за окно нагрузки, не разделяя фазами, — даёт «3460 записей мимо триггера» и прямо подталкивает к выводу про задержку подхвата. Число при этом настоящее; неверен вывод. Именно так эта ошибка и попала в первую редакцию статьи.
Что из этого следует практически. Триггер срабатывает надёжно, но не закрывает окно между началом expand и своим появлением — эти строки остаются пустыми, и подбирает их backfill (шаг 3). То же верно и для кода: промежуточная версия выкатывается не мгновенно. Так что backfill нужен при любом способе, а выбор между кодом и триггером решается другим: триггер не требует лишней выкатки, но прячет логику перехода в БД, где её труднее выкатывать постепенно, версионировать и откатывать вместе с кодом. В стенде выбран код — потому что он показывает реальную последовательность деплоев; для разовой миграции триггер бывает практичнее.
Порядок: аддитивное до кода, деструктивное после
Из expand-contract вытаскивается правило, применимое к любой миграции под трафиком: аддитивное изменение едет до кода, деструктивное — после.
Аддитивное (добавить nullable-колонку, добавить таблицу, добавить индекс) ничего не отнимает у старого кода — его можно применять заранее, старый код его просто не замечает. Деструктивное (удалить колонку, переименовать, добавить NOT NULL на существующую колонку) отнимает — его нельзя применять, пока жив код, который на отнимаемое рассчитывает. Отсюда и порядок: расширяющая часть миграции опережает выкат кода, сужающая — отстаёт от него, дожидаясь, пока последний старый экземпляр погашен.
Именно поэтому DROP COLUMN amount_cents в стенде выполняется последним шагом и одной транзакцией: к этому моменту ни old, ни dual уже не работают, отнимать колонку не у кого. Снять NOT NULL с amount_cents пришлось, наоборот, на шаге expand — заранее: иначе новый код, не пишущий эту колонку, упал бы на ограничении, пока колонка ещё существует.
Блокирующий DDL и как его избегать
Даже аддитивное изменение способно устроить простой — если само его применение берёт тяжёлую блокировку. Классический случай — построение индекса. CREATE INDEX берёт на таблицу блокировку, конфликтующую с записью: пока индекс строится, все INSERT/UPDATE ждут.
На большой таблице это измеримо. Стенд строит индекс на таблице в 800 000 строк под нагрузкой — обычным CREATE INDEX и вариантом CONCURRENTLY:
Чтобы отделить задержку от индекса от накладных расходов самого замера, скрипт сначала делает контрольные INSERT вообще без DDL — это пол измерения:
запись ждала   ожиданий в логе   сверх контроля
контроль (без DDL)             116 мс             —                —
CREATE INDEX (блокирующий)     860 мс             1            +744 мс
CREATE INDEX CONCURRENTLY      123 мс             0              +7 мс
Под блокирующим CREATE INDEX запись простаивает всё время построения, и PostgreSQL фиксирует ожидание блокировки в логе. У CONCURRENTLY задержка неотличима от контрольной — +7 мс к полу оснастки, ноль ожиданий. (В более ранних прогонах блокирующий вариант давал 760–761 мс — абсолютное время построения зависит от загрузки машины, качественная картина не меняется.)
Но «не блокирует запись» не значит «бесплатен». CONCURRENTLY делает два прохода по таблице вместо одного, дожидается завершения транзакций, начатых до него, дольше нагружает систему, не может выполняться внутри транзакционного блока — и при сбое оставляет индекс в состоянии INVALID, который придётся найти, удалить и построить заново. Это компромисс, а не бесплатный вариант: вы меняете простой записи на более долгую и более хрупкую операцию.
Общая механика тяжёлых DDL и обслуживания таблиц под нагрузкой — в статье про эксплуатацию PostgreSQL.
То же на живом кластере: rolling update
Локальный стенд показывает механику — почему схема, а не деплой. Но окно сосуществования версий во всей полноте видно только на настоящем выкате. Второй уровень стенда прогоняется на живом Kubernetes-кластере: приложение в трёх репликах, три образа — v1 (код старой схемы), dual (промежуточная версия: пишет обе колонки, читает переходным COALESCE(новая, старая)) и v2 (только новая), — и RollingUpdate, заменяющий реплики по одной. Выкат идёт в две ступени: v1 → dual → v2, и регрессия проверяется на каждой по своей уходящей версии.
Сигнал — регрессия уходящей версии, и на каждой ступени она своя: в первом выкате это v1-поды, во втором — dual. readiness-проба каждого пода читает бизнес-значение через свою колонку; если оно недоступно или пусто, проба падает, под уходит в NotReady и выбывает из endpoints сервиса. Считается максимум одновременно живых подов уходящей версии, потерявших готовность: штатно завершающиеся (Terminating) и стартующие новые из счёта исключены — их транзиторная неготовность нормальна для любого rolling update.
Замеры двух ступеней раздельные. Это не формальность: если считать регрессию только по первому образу, то на второй ступени его подов уже нет, счётчик неизбежно даёт ноль — и «проверка» ничего не проверяет.
Что именно измеряется — и чего этот замер не показывает. Метрика здесь — готовность подов, а не клиентский трафик. Под в NotReady исключается из endpoints сервиса, то есть обслуживать остаётся меньше реплик; но сколько ошибок получил бы реальный клиент, зависит от числа оставшихся реплик, таймингов ретраев и запаса по нагрузке — и в этом эксперименте не замерялось. Ошибки клиента под нагрузкой меряет уровень A, на локальном PostgreSQL. Эти два уровня дополняют друг друга: один показывает, что запросы падают, другой — что реплики теряют готовность в окне выката.
Наивный выкат — миграция RENAME плюс переключение образа на v2:
максимум регрессировавших v1-подов за окно выката: 2–3 (несколько прогонов)После RENAME живые v1-поды обращаются к пропавшей amount_cents, их readiness падает — до 3 из 3 реплик одновременно теряют готовность прямо в окне выката. Разброс 2–3 между прогонами — от тайминга опроса (раз в 0.3 с) относительно скорости, с которой rolling заменяет упавшие реплики: часть регрессий наблюдатель может и не застать. Воспроизводимо здесь то, что регрессия уходящих подов наблюдается, а не её точная величина.
Expand-contract выкат — расширяющая миграция и backfill до выката, две ступени переключения образа под совместимой схемой, сужение после. Числа обоих замеров приведены ниже, в таблице по двум прогонам.
Обе колонки на месте весь переход, поэтому readiness проходят все три версии: v1 читает старую колонку, dual — переходный COALESCE(новая, старая), v2 — новую. Уходящие поды остаются готовы до штатного завершения на обеих ступенях, и это подтверждено раздельными замерами, а не одним общим. Против наивного варианта здесь отличаются две вещи: порядок «схема↔выкат» и наличие промежуточной версии — сам факт rolling update ни при чём.
Две находки этого сценария стоят отдельного разбора — обе про данные, а не про readiness.
Первая. Когда в сценарий добавили проверку итоговой схемы, он немедленно упал: VALIDATE CONSTRAINT ответил «check constraint … is violated by some row». Дело оказалось не в схеме, а в данных: всё, что старые поды записали во время выката, осталось с пустой новой колонкой — 276 строк в том прогоне, — и DROP COLUMN потерял бы эти значения безвозвратно. До появления проверки сценарий молча заканчивался «успехом». Отсюда правило: окно выката само по себе производит строки в старом формате, поэтому финальный backfill перед сужением схемы обязателен — и проверять его надо постусловием, а не доверием к тому, что данные залили заранее.
Вторая — про обещание безопасного отката, и она заставила переделать сам сценарий. Пока образов было два (v1 пишет старую колонку, v2 — новую), откат на предыдущую версию оставался структурно возможным, но бессмысленным: строки, записанные v2, не имеют старой колонки, и вернувшийся v1 их просто не увидит. Поэтому в выкат добавлена промежуточная версия — образ, который пишет обе колонки, а читает переходным COALESCE(новая, старая), и лестница стала трёхступенчатой: v1 → dual → v2.
прогон 1   прогон 2
строк с total_cents IS NULL после выката dual     250        229   (их добирает backfill)
строк без amount_cents во время работы dual         0          0   ← откат безопасен
строк без amount_cents после выката v2            310        361   ← граница обещания
регрессировавших v1-подов   (выкат v1->dual)        0          0
регрессировавших dual-подов (выкат dual->v2)        0          0
итоговая схема                          total_cents:NO  total_cents:NO
Ключевая строка — ноль строк без старой колонки, пока работает промежуточная версия. Это и есть проверенное числом обещание: в тот момент откат не потерял бы ни одной записи, и скрипт падает, если там окажется не ноль. Строка ниже показывает границу: как только промежуточная версия ушла, откат «через ступень» данные бы уже потерял.
Отсюда честная формулировка вместо общего «откат безопасен»: безопасен откат на одну ступень назад и только до contract. После DROP COLUMN возврат к версии, читающей старую колонку, — это восстановление из резервной копии, а не откат.
Rollback: одной схемы мало
У экспандо-контрактного порядка есть следствие, которое окупается в худший момент — при откате. Код откатывается сравнительно просто: вернули предыдущий образ, rolling update развернул старую версию — это минуты и штатная операция (хотя и она не бесплатна: пока откат едет, часть трафика обслуживает сломанная версия). Со схемой хуже: откатить её так же быстро обычно нельзя, а деструктивную миграцию — часто нельзя вообще, потому что удалённую колонку не вернуть вместе с данными.
Отсюда практическое правило: схему держат на шаг совместимее кода. Пока идёт expand-contract, старая колонка ещё жива (contract не выполнен), и откат кода на предыдущую версию возможен — она найдёт amount_cents на месте. Именно поэтому contract не торопят: чем дольше старая колонка существует после выката, тем дольше открыто окно отката.
Но одного наличия колонки мало, и это тонкость, на которой легко успокоиться раньше времени. Колонка должна быть не только на месте, но и заполнена — а заполняет её версия кода, которая в неё пишет. Если новая версия старую колонку уже не пишет, то её строки для откатившегося кода невидимы: формально откат прошёл, фактически часть данных потеряна. Поэтому окно безопасного отката держит не схема сама по себе, а промежуточная версия с двойной записью, и безопасен он ровно на одну ступень назад — пока эта версия ещё работает. Числа, подтверждающие это на живом кластере, приведены выше. Развязать выкат кода и включение нового поведения ещё сильнее помогают feature flagsСкоро — код уже в проде, но поведение включается флагом, отдельно от деплоя.
И отдельно про «обратные» миграции. Для аддитивных шагов откат осмыслен и дёшев: добавленную колонку можно снять. Для деструктивных он вводит в заблуждение — DROP COLUMN не возвращается симметричным ADD COLUMN: структура восстановится, данные нет. Восстановление здесь — это резервная копия или PITR, а «down-миграция» в таком случае лишь создаёт иллюзию обратимости. Совместимость версий записи и чтения (какая версия что понимает) — соседний сюжет, разобранный в статье про версионирование APIСкоро.
Демо и версии
Рабочий пример — digital-cookbook/infrastructure/cicd, раздел zero-downtime. Два уровня: локальный (compose + Go-загрузчик — механика наивного и экспандо-контрактного перехода, момент срабатывания триггера, блокирующий DDL) и кластерный (k8s — двухступенчатый rolling update с тремя образами на живом Kubernetes). Все числа этой статьи — в FIXTURES.md стенда, включая разбор ошибочной интерпретации замера с триггером, которая была в первой редакции.
Версии на момент замеров: PostgreSQL 18.4 (локально) и 18-alpine (в кластере), Kubernetes 1.36.2, Go 1.26.5, pgx/v5 5.10.0.
Документация
- PostgreSQL:
ALTER TABLEиCREATE INDEX CONCURRENTLY— в том числе про два прохода, ожидание транзакций иINVALID-индекс при сбое. - PostgreSQL:
CREATE TRIGGER— когда начинает применяться созданный триггер. - Kubernetes: rolling update и
maxUnavailable/maxSurge. - Readiness-пробы — сигнал готовности пода обслуживать трафик.
- Expand-contract как паттерн описан у Мартина Фаулера (parallel change).
Дальше по серии — release engineering и метрики DORAготовится, с 26 октября: код собран пайплайном и выкачен без простоя, остаётся навести порядок в версиях и честно измерить, здорова ли доставка.
Комментарии