
Из детерминизма вытекает следствие, которое обычно осознают уже в проде: код workflow нельзя просто взять и поменять, если у него есть запущенные экземпляры. Долгий процесс мог стартовать неделю назад на старой версии; когда воркер перезапустится и начнёт проигрывать его историю новой логикой, пути разойдутся.
Эта статья — про то, как менять workflow безопасно. И начинается она с того, что граница ломающего изменения проходит не там, где кажется: первая версия стенда к этой статье не смогла воспроизвести ни одного расхождения, хотя код менялся по-настоящему.
В статье
- Почему нельзя просто поменять код
- Где на самом деле проходит граница
- Что происходит при расхождении
- Починка: GetVersion
- Второй контрпример: патч сняли слишком рано
- Worker versioning
- Как встроить в деплой
Почему нельзя просто поменять код
Запущенный процесс хранит историю, записанную старой логикой. Проигрывание новым кодом должно выдать ту же последовательность команд, что уже записана. Если код выдаёт другую — рантайм останавливает продвижение.
Это не баг, а защита целостности. Альтернатива — молча продолжить с рассогласованным состоянием, что гораздо хуже.
Где на самом деле проходит граница
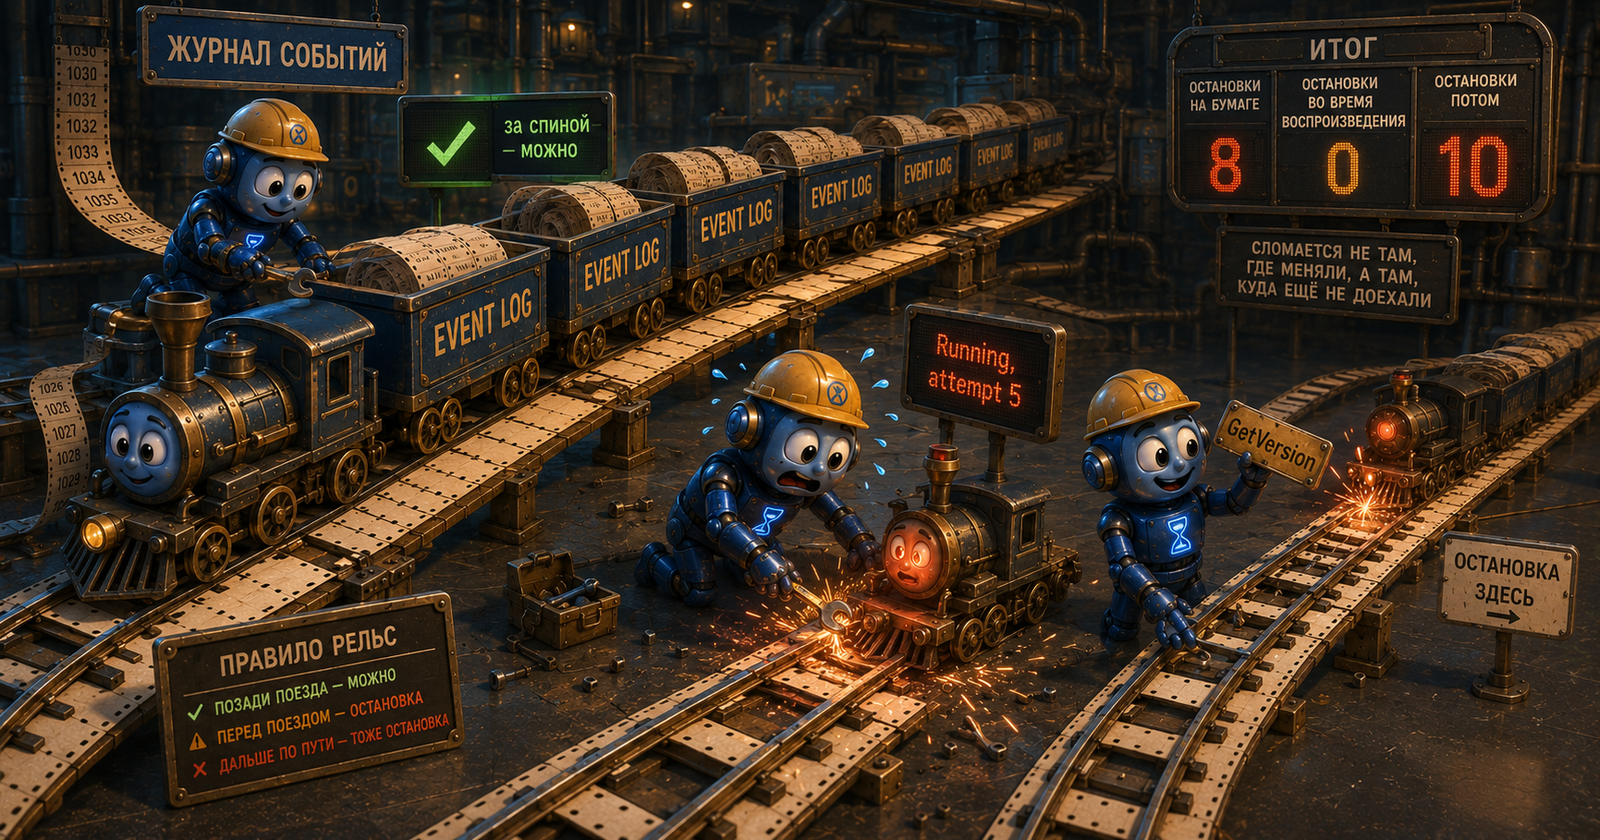
Интуиция подсказывает: «изменил код workflow — сломал запущенные экземпляры». Это неверно, и проверяется это легко.
В первой версии стенда новый шаг добавлялся после длинной паузы, во время которой подменялся воркер. Все три сценария завершились штатно, без единой ошибки. Изменение было настоящим — добавлялся реальный вызов activity, — а расхождения не возникло.
Причина в том, что расхождение возникает только там, где новая последовательность команд противоречит уже записанной. Пока изменение находится за текущей точкой прогресса, сверять его не с чем: история в этом месте пуста, и рантайм просто исполняет новый код как обычно.
Когда новый шаг перенесли до паузы — то есть в участок, который у запущенных экземпляров уже записан, — расхождение начало воспроизводиться стабильно.
Отсюда практический вывод: безопасность изменения определяется не самим изменением, а положением каждого живого экземпляра относительно него.
Экземпляр, который до изменённого места ещё не дошёл, спокойно исполнит там новый код — и никогда из-за этого не сломается: сверять было не с чем, история в этом месте пуста. Экземпляр, который это место уже прошёл, при следующем восстановлении упрётся в расхождение.
Из этого следует практическая классификация:
| Изменение | Ломает запущенные |
|---|---|
| добавлен, убран или переставлен вызов activity в участке, который экземпляр уже прошёл | да |
| изменён порядок таймеров или запусков дочерних процессов в пройденном участке | да |
| то же изменение, но экземпляр до него ещё не дошёл | нет — новый код исполнится там впервые |
| изменена логика внутри activity (не workflow) | нет |
| добавлен новый обработчик сигнала | нет |
Третья строка — та, из-за которой выкатка выглядит успешной. Опасность не в том, что «сломается позже»: этот экземпляр не сломается вовсе. Опасность в том, что одно и то же изменение по-разному действует на экземпляры, находящиеся в разных точках, и зелёный результат на молодых процессах ничего не говорит про долгие, ушедшие дальше.
Отсюда правило проверки: смотреть не на то, «прошла ли выкатка», а на то, есть ли открытые исполнения, уже прошедшие изменённый участок. Это запрос к visibility, а не наблюдение за дашбордом.
Что происходит при расхождении
Три сценария со стенда, во всех подменяется воркер во время паузы:
| Сценарий | Статус процесса | Попытка задачи | Упоминаний расхождения в логе |
|---|---|---|---|
| правка без патча | Running | 4 | 8 |
та же правка под GetVersion |
Completed | 0 | 0 |
| патч снят слишком рано | Running | 5 | 10 |
Первое, что здесь стоит заметить, — колонка статуса. Расхождение не завершает процесс: он остаётся в состоянии Running, а workflow task падает по кругу с растущим номером попытки.
Это принципиально отличается от «упало и умерло». Процесс жив, состояние цело, и он будет ждать сколько угодно долго, пока не появится код, совместимый с его историей. То есть починка возможна выкаткой — данные при этом не теряются.
Обратная сторона: без мониторинга это состояние легко не заметить. Процесс формально работает, метрики старта в порядке, а прогресса нет. Что за этим следить, разбирается в статье про эксплуатациюготовится, с 26 октября.
Починка: GetVersion
GetVersion ставит в код именованный маркер и решает, какой веткой идти, по истории в этой самой точке:
- если исполнение проигрывает историю и маркера в ней нет — значит, этот участок записан кодом без патча, и возвращается
DefaultVersion, то есть старая ветка; - если точка достигнута впервые, вживую, — возвращается новая версия, и в историю записывается маркер.
if workflow.GetVersion(ctx, "extra-check-v2",
        workflow.DefaultVersion, 1) != workflow.DefaultVersion {
    // новая ветка — для тех, кто дошёл до этой точки впервые уже с патчем
    if err := workflow.ExecuteActivity(ctx, acts.CheckAvailability, resource).Get(ctx, &extra); err != nil {
        return "", err
    }
}
Момент времени, когда экземпляр стартовал, здесь ни при чём. Долгий процесс, запущенный до патча, но не успевший дойти до этой точки, получит новую версию и пойдёт новой веткой — он ничем не отличается от свежего. Старую ветку получит только тот, у кого этот участок в истории уже записан.
На стенде тот же сценарий, что ломался без патча, под GetVersion доходит до конца: Completed, ноль упоминаний расхождения.
Существенно, что маркер сам по себе — событие в истории. Добавление GetVersion к запущенному процессу безопасно именно потому, что рантайм умеет вставлять этот маркер в проигрывание, не считая его расхождением.
Второй контрпример: патч сняли слишком рано
Жизненный цикл патча часто пересказывают в три шага: ввести маркер, дождаться завершения старых экземпляров, удалить старую ветку вместе с маркером. Последний шаг, слитый из двух разных, и есть место, где всё ломается заново.
На стенде это третий сценарий: Running, попытка 5, десять упоминаний расхождения. Код при этом выглядит безупречно — одна ветка, никаких маркеров, ничего лишнего. Именно так и должен выглядеть корректно снятый патч.
Почему это ломает не всех
Тонкость, из-за которой сценарий пришлось строить из трёх версий подряд, а не из двух.
Экземпляр, прошедший точку GetVersion уже с патчем, записал в историю новую версию и пошёл новой веткой. Для него удаление кода без изменения поведения безобидно: код делает ровно то же самое, что записано.
Ломается тот, чья история содержит старую ветку. Код после снятия патча знает только новую — и расходится с записанным. Поэтому цепочка на стенде выглядит как v1 → v3 → v4: экземпляр проходит участок на версии без патча, затем встречает версию с патчем, и только после этого — версию, где патча уже нет.
Что здесь на самом деле проверяется
Правило «снимать патч можно, когда старых не осталось» выглядит как проверка. Но и правило, и код опираются на одно и то же допущение — что старых больше нет. Если допущение неверно, ошибутся оба: и разработчик, решивший, что пора, и код, написанный исходя из этого решения.
Одно допущение, проверенное дважды, не даёт двух проверок. Настоящая проверка должна быть независимой: список открытых исполнений старше даты введения патча — запрос к visibility, а не рассуждение. Плюс replay-тест против сохранённой истории старого экземпляра — он ловит именно этот случай и разбирается в статье про детерминизм.
Worker versioning
Альтернативный подход: воркеры помечаются build ID, и Temporal маршрутизирует задачи исполнения к совместимой версии воркера. Ветвления внутри кода не требуется — версия живёт на уровне пула воркеров.
Компромисс простой:
- patching — тонкий контроль в коде, но код обрастает ветками, и их надо снимать (см. выше, чем это чревато);
- worker versioning — код чище, но нужно управлять пулами воркеров, их жизненным циклом и совместимостью версий.
Worker versioning заметно менялся между версиями сервера и SDK, поэтому здесь особенно важно смотреть документацию под свою версию, а не общие статьи.
Как встроить в деплой
Дисциплина та же, что в zero-downtime деплое и миграциях — expand-contract, но в четыре шага, а не в три:
-
Expand. Ввести патч:
GetVersion(ctx, id, workflow.DefaultVersion, 1), обе ветки в коде. Выкатить. -
Ждать закрытия. Пока не завершатся все открытые исполнения, записанные до патча. Это снимает риск для живых процессов — но ещё не разрешает трогать код.
-
Ждать retention и отказаться от старой ветки. Пока истории этих исполнений не выйдут за срок хранения. Только после этого старую ветку удаляют, а вызов сужают:
// допустимо ТОЛЬКО когда историй без маркера больше не существует
workflow.GetVersion(ctx, "extra-check-v2", 1, 1)
Суженный вызов — уже не ветвление, а защитная проверка. Если история без маркера всё-таки встретится — при
reset, в забытом replay-тесте, — код упадёт с явной ошибкой «эта версия больше не поддерживается», а не с безликим расхождением команд. -
Убрать вызов целиком — когда защитная проверка больше не нужна. Условие то же, что на шаге 3: историй без маркера не осталось. Истории с маркером удалению не мешают: SDK пропускает маркер версии, которому в коде нет вызова, если остальная последовательность команд совпадает. В стенде это контрольный сценарий: экземпляр, прошедший точку на v3 с маркером, после подмены на v4 без вызова доходит до конца без единого расхождения. В самом Go SDK этот случай закрыт тестом
TestReplayWorkflowHistory_GetVersionRemoved.
Два ожидания на шагах 2 и 3 — разные, и их постоянно сливают в одно. Это и есть самая дорогая ошибка в теме.
Обратная ошибка тоже встречается: ждать, пока за retention выйдут истории с маркером. Это ожидание не кончается — каждое новое исполнение проходит через GetVersion и записывает маркер заново, и срок отодвигается вместе с ним.
Почему закрытия исполнений недостаточно. Форма GetVersion(ctx, id, 1, 1) объявляет: «версии по умолчанию для этого изменения больше не существует». История, записанная до патча, маркера не содержит, то есть соответствует именно DefaultVersion — и такой код её отвергнет. Живым процессам это уже безразлично, они закрыты. Но закрытая история никуда не делась: её проигрывают replay-тесты в CI, её проигрывает сервер при сбросе исполнения (reset), к ней обращаются при разборе инцидентов. Пока такая история лежит в пределах retention, код обязан уметь её проиграть.
Отсюда практическое следствие: срок ожидания на шаге 3 задаётся настройкой retention вашего namespace, а не ощущением «прошло достаточно». Если retention — тридцать суток, значит от завершения последнего pre-patch исполнения до сужения вызова должно пройти тридцать суток.
И отдельное ограничение, о котором легко забыть: идентификатор изменения нельзя переиспользовать. Даже после полного удаления вызова тот же changeID для нового патча брать нельзя — в старых историях он может означать совсем другое ветвление.
Между шагами стоит держать replay-тест против исторических данных в CI. Стоит он доли секунды и не требует сервера.
И общий совет, который в этой теме стоит дороже остальных: стратегию версионирования лучше выбрать до первого долгого процесса в проде. После — придётся вводить патчи в код, который писался без расчёта на них.
Демо и версии
Стенд: digital-cookbook/architecture/temporal, профиль 05-versioning — четыре версии одного процесса, три сценария подмены воркера, включая цепочку из трёх версий для снятого патча, и контрольный сценарий v3 → v4 для истории с маркером.
Версии прогона: Temporal Server 1.29.7, Go SDK v1.46.0. Worker versioning менял API и статус между версиями — проверяйте под свою.
Документация и первоисточники
- Канон: Temporal — Versioning, Patching, Worker Versioning.
- Смежное на сайте: Temporal — обзор, детерминизм workflow, Signals и child workflows, эксплуатация Temporalготовится, с 26 октября, zero-downtime деплой и миграции, контракты и schema evolution.
Комментарии