
Детерминированный workflow, выполняющий activity, — замкнутый процесс. Реальные сценарии почти всегда требуют связи с внешним миром на ходу: дождаться подтверждения оператора, принять внешнее событие, отдать наружу текущий статус, разбить большой процесс на части. За это отвечают Signal, Query, Update и child workflows — плюс Continue-As-New, без которого долгие процессы упираются в размер истории.
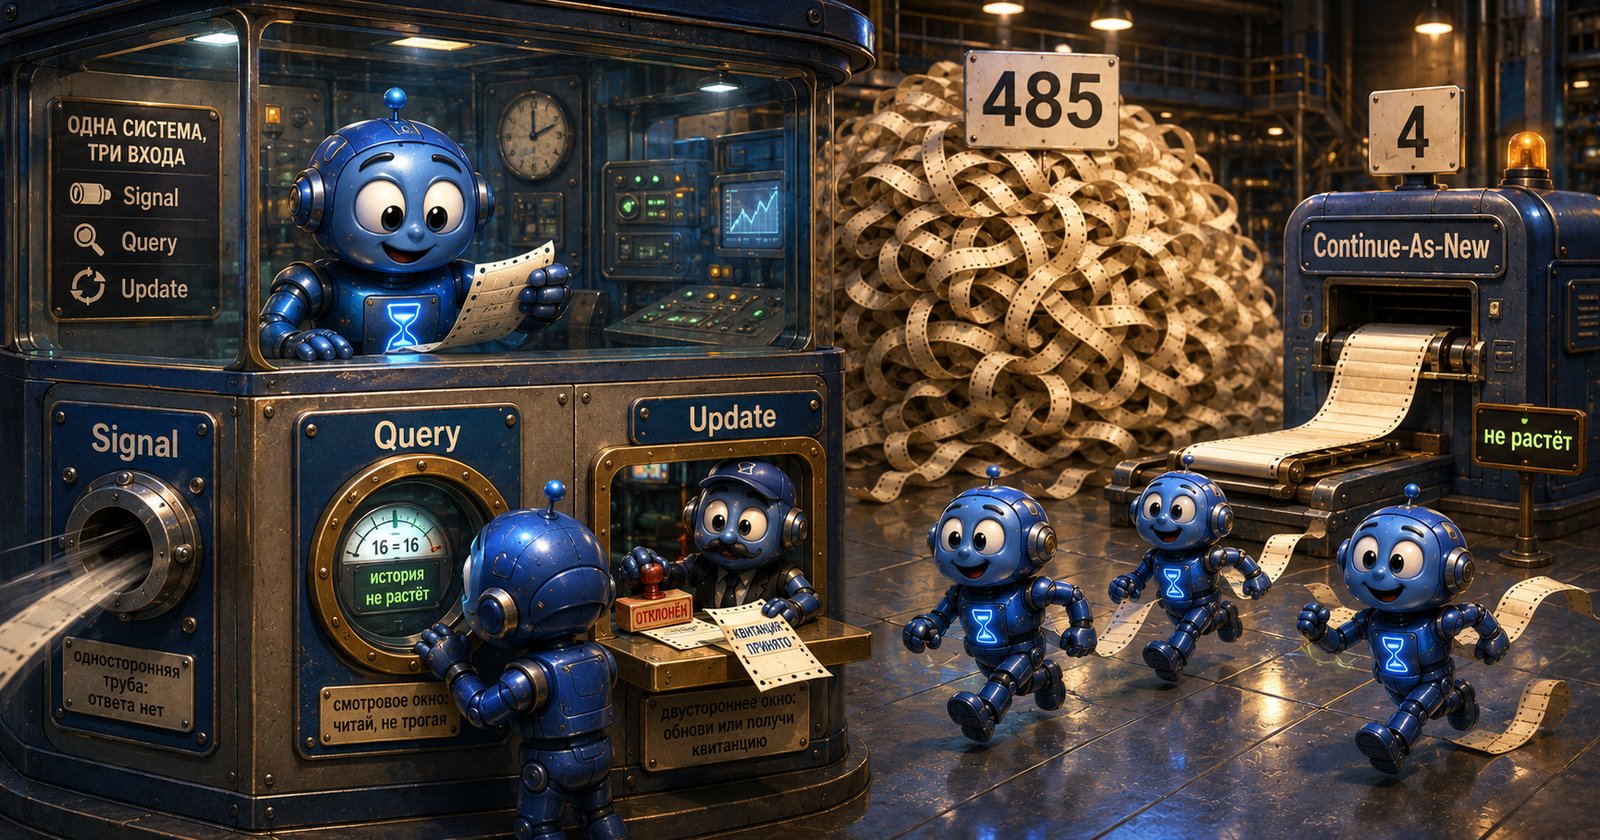
Три первых механизма легко перепутать, потому что все три «приходят снаружи». Различать их проще всего по трём вопросам: возвращается ли ответ, есть ли валидация, пишется ли что-то в историю.
В статье
- Три механизма в одной таблице
- Signal: событие без ответа
- Query: чтение, не оставляющее следа
- Update: мутация с валидацией и ответом
- Child workflows
- Continue-As-New и что показывают числа
Три механизма в одной таблице
| Возвращает ответ | Может валидироваться до записи | Пишет в историю | |
|---|---|---|---|
| Signal | нет | нет | да |
| Query | да | нет | нет |
| Update | да | да | да |
Отсюда и области применения: Signal — «сообщи о событии», Query — «покажи состояние», Update — «измени и скажи, что получилось».
Уточнение к средней колонке: валидатор у Update опционален. Update без валидатора — это просто синхронная мутация с ответом, и она вполне осмысленна. Особенность в том, что только у Update есть возможность отклонить запрос до того, как он попадёт в историю; Signal такой возможности не имеет в принципе — он уже записан к моменту, когда обработчик о нём узнаёт.
Signal: событие без ответа
Signal доставляется в конкретное запущенное исполнение и попадает в историю как событие. Вызывающий не узнаёт, что с ним стало: обработчик мог отклонить значение по бизнес-правилу, а отправитель об этом не услышит.
Классический сценарий — «человек в цикле»: процесс ждёт подтверждения оператора, ожидание с таймаутом реализуется селектором из канала сигнала и таймера. И ожидание, и таймер живут на сервере, а не в памяти воркера, поэтому переживают его падение — это то же свойство, что показано в первой статье серии.
Отсутствие ответа — не недостаток, а свойство: именно поэтому Signal дёшев и не требует, чтобы отправитель ждал.
Query: чтение, не оставляющее следа
Query исполняет обработчик на текущем состоянии и возвращает результат. В историю он ничего не пишет и состояние менять не имеет права.
На стенде это проверено прямо: до пяти последовательных Query в истории было 16 событий, после — те же 16.
Практическое следствие: частые Query не раздувают историю — это их главное отличие от Signal, и оно важное.
Но «не растит историю» не равно «бесплатно». Query исполняется на воркере: сервер доставляет query task, воркер поднимает состояние исполнения (при промахе sticky-кэша — проигрывая историю заново, со всеми последствиями из статьи про детерминизм) и отвечает. Если живого воркера нет, отвечать некому — Query не выполнится.
Отсюда две практические оговорки. Query — плохой кандидат для бесконтрольного healthcheck: он расходует ту же ёмкость воркеров, что и полезная работа, и частый опрос по расписанию конкурирует с ней за поллеры. И Query — не замена внешнему хранилищу статуса: если статус нужен дашборду каждую секунду и по тысяче исполнений, дешевле проецировать его наружу, чем опрашивать каждое.
Ограничение обратной стороны: обработчик не имеет права менять состояние исполнения и вызывать блокирующие операции workflow — activity, таймеры, ожидание канала. Детерминированным он быть не обязан: ответ Query не записывается в историю, и при replay сверять его не с чем.
Update: мутация с валидацией и ответом
Update — единственный из трёх, где вызывающий получает и валидацию, и результат. Валидатор выполняется до записи в историю: отклонённый Update историю не засоряет.
Со стенда, оба вызова к одному исполнению:
$ go run ./04-messaging update -address temporal-frontend:7233 \
    -workflow cart-basic-$RUN_ID -new-cap -5
$ go run ./04-messaging update -address temporal-frontend:7233 \
    -workflow cart-basic-$RUN_ID -new-cap 500
UPDATE new_cap=-5  ОТКЛОНЁН: cap должен быть положительным
UPDATE new_cap=500 ПРИНЯТ, прежнее значение=100
Первая строка — то, чего Signal дать не может в принципе: отказ пришёл вызывающему синхронно, с текстом причины. Вторая — то, чего не может Query: состояние изменено, и вернулось прежнее значение.
Выбор между Signal и Update сводится к одному вопросу: нужен ли отправителю ответ. Если решение о валидности принимается внутри процесса, а отправитель должен узнать результат — это Update. Если событие просто произошло и его надо доставить — Signal.
Child workflows
Дочерний workflow — отдельное исполнение со своей историей, запущенное из родителя. На стенде родитель запускает пятерых и дожидается всех.
Что это даёт помимо декомпозиции:
- Своя история у каждого. Крупный процесс не наращивает одну гигантскую историю, а распределяет её.
- Независимое версионирование. Дочерний процесс можно менять отдельно от родителя — важное свойство в свете версионированияготовится, с 23 октября.
- Изоляция сбоев. Падение одного дочернего не обязано валить остальных.
Цена — политики отношений родитель–потомок: что происходит с дочерними при завершении родителя, ждёт ли родитель их завершения. Это решение принимается явно, и умолчание здесь редко бывает тем, что нужно.
Как это ложится на общую картину оркестрации — в статье про хореографию и оркестрацию.
Continue-As-New и что показывают числа
История исполнения не может расти бесконечно: цена проигрывания растёт линейно с числом событий. Долгие и циклические процессы решают это через Continue-As-New: исполнение завершается и тут же начинается заново с чистой историей, перенося только нужное состояние. Логически это тот же процесс, физически — новый запуск.
Замер на стенде: два исполнения, каждому доставлено 120 сигналов.
| Конфигурация | Событий в истории текущего запуска | Байт |
|---|---|---|
| без Continue-As-New | 485 | 48 368 |
| с Continue-As-New | 4 | 719 |
Байты здесь — proto.Size, фактический размер сериализованных событий. Уточнение не педантичное: первая версия замера считала длину текстового представления и завышала величину примерно втрое. Событий это не касается — их число от способа измерения не зависит, и потому в выводах ниже опора именно на них.
Как это читать — и как не надо
Соблазнительно записать «в 121 раз меньше». Так делать не стоит, и вот почему.
Число 4 — снимок, сделанный сразу после смены поколения. Если бы срез пришёлся на момент перед следующей ротацией, там было бы около восьмидесяти событий: двадцать сигналов, по четыре события на каждый. Отношение зависит от того, в какой момент цикла посмотреть, и потому отношением не является.
Честная формулировка другая: без Continue-As-New история растёт неограниченно, с ним — ограничена одной итерацией. Первая конфигурация набрала 485 событий на 120 сигналах и продолжала бы расти линейно и дальше; вторая никогда не выйдет за размер одной итерации, сколько бы сигналов ни пришло.
Именно это свойство и нужно: не «меньше в N раз», а «не растёт».
Почему конфигурации нельзя было уравнять
Лимит итерации у двух конфигураций в замере разный, и это вынужденно. Без Continue-As-New процесс по достижении лимита просто завершается, и остаток сигналов уходит в уже закрытое исполнение — первая версия замера на этом и упала, с ошибкой «workflow execution already completed».
Общим держится то, что сравнивается: одинаковое число доставленных сигналов и один и тот же код процесса. Уравнивать лимит «для чистоты эксперимента» здесь означало бы сравнивать процесс, обработавший 120 сигналов, с процессом, обработавшим двадцать.
Где ставить точку ротации
Континуация посреди незавершённой работы теряет контекст, поэтому точку выбирают там, где процесс находится в согласованном состоянии: цикл дошёл до конца итерации, все дочерние завершены, отложенных ожиданий нет. Переносить наружу стоит минимум состояния — всё, что переносится, придётся сериализовать при каждой ротации.
И отдельный пункт этого списка — буфер сигналов. Сигналы, которые уже доставлены в текущий запуск, но ещё не прочитаны из канала, новый запуск не получит: Continue-As-New переносит только аргументы. Поэтому перед ротацией канал осушают неблокирующим чтением и разбирают остаток:
for {
    var amount int
    if !ch.ReceiveAsync(&amount) {
        break
    }
    apply(amount) // та же обработка, что и в основном цикле
}
// только теперь: next := state, сброс счётчика итерации
// и workflow.NewContinueAsNewError(ctx, CartWorkflow, next)
В стенде после 120 сигналов и шести ротаций итог равен 120: каждый сигнал добавляет единицу, а предел заведомо не достигается, так что потерянный на ротации сигнал проверка поймала бы как недостачу. Доказательством необходимости осушения этот замер не служит: сигналы здесь идут по одному, каждый из отдельного контейнера, и гонка с ротацией маловероятна. Осушение — правило корректности кода, а не вывод из чисел.
Демо и версии
Стенд: digital-cookbook/architecture/temporal, профиль 04-messaging — Signal с ожиданием по таймауту, Query без роста истории, Update с валидатором, пятеро дочерних, замер Continue-As-New на 120 сигналах.
Версии прогона: Temporal Server 1.29.7, Go SDK v1.46.0. API сообщений зависит от версии SDK: Update стабилизировался не сразу.
Документация и первоисточники
- Канон: Signals, Queries, Updates, Child Workflows, Continue-As-New.
- Смежное на сайте: Temporal — обзор, детерминизм workflow, Activities вглубь, хореография vs оркестрация, saga на практике.
Комментарии